Tradução automática do original inglês datado. A página em inglês é a canónica. English →
Previsões ao nível da teoria pré-registadas no OSF: DOI 10.17605/OSF.IO/P8CKQ, registadas a 8 de Setembro de 2026 (versão 1.100), actualizadas a 13 de Setembro de 2026 (versão 1.102), vinte e duas proposições.
Documento companheiro: Definições operacionais do programa ARC, versão 1.7.1, 3 de Setembro de 2026.
As quatro equações funcionais de Cauchy, a aditiva, a multiplicativa, a exponencial e a logarítmica, são as únicas soluções contínuas dos respectivos constrangimentos de composição. Argumentamos que este resultado matemático com 200 anos tem uma consequência fisicamente testável: sob os axiomas enunciados, restringe as leis de escala a uma de três famílias funcionais (lei de potência, exponencial ou curva de saturação). A família é determinada pelo operador de composição do processo subjacente de amplificação recursiva.
13 de setembro de 2026 (v3.11): A nota de proveniência no final foi corrigida por exactidão. Nenhuma afirmação, data, resultado ou estado mudou.
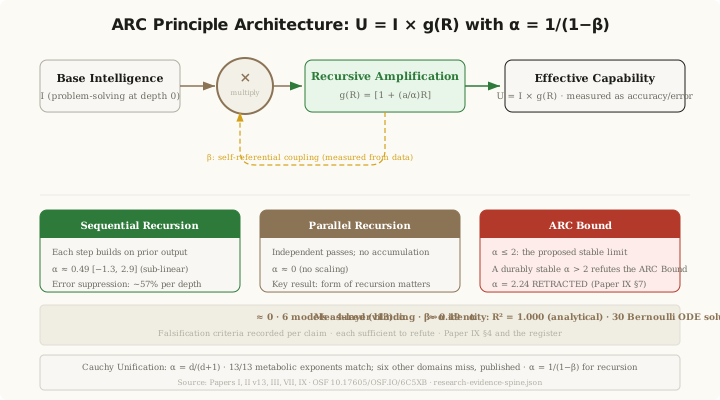
2 de setembro de 2026 (v3.10): um conjunto de correções que deixa todos os resultados de pé: a legenda e o texto alternativo da Figura 1 apresentam o teorema da autorreferência na forma com índice que o registo de notação usa, α = 1/(1 − βL), notando que a própria ilustração mostra um β nu, e identificam a derivação do Teto ARC colocada em contraste; a referência [4] (Nemet 2009) cita agora a Research Policy; a estimativa de 619 espécies é creditada a White e Seymour 2003, e o seu desacordo com o valor do compêndio da linha 26 fica registado ao lado da tabela; a descrição sumária já não está truncada; a Eden Engineering é rotulada como retirada; e a data de primeira publicação indica 16 de março de 2026, tal como consta do registo, tendo 24 de março sido a data do rascunho.
25 de Agosto de 2026 (v3.9): dois esclarecimentos datados que deixam a ciência intacta. Onde quer que o número 19/25 aparecesse sozinho, passa a levar a sua companheira corrigida: a reexecução exploratória de 11 de agosto de 2026, que acrescentou o candidato logarítmico, devolve 18/25, ao passo que o subconjunto derivado de Cauchy se mantém em 14/18 antes e depois, exatamente como o resumo já afirma. A frase que descreve o estado de pré-registo também está marcada como histórica, pois o teste prospetivo da quarta célula foi entretanto preparado como rascunho completo de OSF a aguardar submissão humana.
Dentro da ARC Theory: a classificação matemática por trás da forma da Lei I; a grelha da equação funcional de Cauchy.
As quatro equações funcionais de Cauchy, a aditiva, a multiplicativa, a exponencial e a logarítmica, são as únicas soluções contínuas dos respectivos constrangimentos de composição. Argumentamos que este resultado matemático com 200 anos tem uma consequência fisicamente testável: sob os axiomas enunciados, restringe as leis de escala a uma de três famílias funcionais (lei de potência, exponencial ou curva de saturação). A família é determinada pelo operador de composição do processo subjacente de amplificação recursiva.
A contribuição inédita não é a matemática de Cauchy em si, mas a afirmação de que as equações funcionais do tipo Cauchy têm uma consequência fisicamente testável para a classificação de leis de escala através de domínios.
Apresentamos uma comparação estruturada de previsões sobre 50 sistemas do mundo real em cinco níveis de evidência. Cada domínio empírico seguiu a mesma sequência: a física conhecida fixava o operador de composição antes de qualquer ajuste, a classe do operador determinava então que família de escalonamento esperar, eram carregados dados publicados ou de referência padrão, e essa expectativa era por fim posta à prova por ajuste de modelos independente com seleção de modelos baseada no AICc.
Resultado principal (calculado no conjunto de seis candidatos, que não continha candidato logarítmico nem linear puro (Secção 3.2)): 19 de 25 domínios empíricos de ajuste de curvas confirmam a família predita por Cauchy sob selecção estrita de modelos por AICc. A estatística de significância principal é um teste de permutação condicionado às marginais: $p = 7 \times 10^{-5}$. Um teste binomial unilateral contra a hipótese uniforme de acaso $1/3$ dá $p = 1.56 \times 10^{-5}$ (aproximadamente 1 em 64,000) e é retido como verificação de sensibilidade. O resultado mantém-se também no subconjunto estritamente derivado de Cauchy (os 18 domínios multiplicativos e aditivos, excluindo a família limitada cuja exaustividade permanece um problema em aberto): 14/18, permutação $p = 3.0 \times 10^{-4}$. Resultados secundários: uma reexecução da linha-de-base-20 produz 15/20 ($p = 1.67 \times 10^{-4}$); os expoentes metabólicos publicados correspondem ao comparador ARC/Cauchy mais próximo em 13/13 casos directos; identidades analíticas confirmam 6/6. Estes níveis são reportados separadamente e nunca são combinados num único número misturado.
Este resultado é suficientemente forte para ser publicado como evidência exploratória mas não suficientemente forte para ser reivindicado como provado. O teste principal não é uma submissão a registo aceite, e nenhum registo o aceitou como tal. As próprias previsões receberam carimbo temporal antecipado por commit público datado: as classificações por linha nos ficheiros de catálogo com hash fixo de Março de 2026, o manifesto de extensão a 12 domínios de 17 de Março de 2026, e os dois apêndices de previsões do livro impressos a 2 de Janeiro de 2026, antes de os artigos e o programa existirem. O que não foi fixado antecipadamente foi o protocolo de ajuste, e essa lacuna é fechada prospectivamente pelos testes faseados apresentados a registo: o teste da quarta célula e o teste de expansão a 80 domínios. Existe um enquadramento separado, de predição prospectiva, e não é reivindicado como cobrindo este resultado. A 17 de Março de 2026, entre 02:06:51 e 02:07:05 UTC, um protocolo de predição, um manifesto de extensão e um ficheiro de checksum foram depositados no componente público da Open Science Framework x6wa7. Cada um carrega um carimbo temporal de criação atribuído pela OSF, cada um tem um carimbo temporal de modificação idêntico ao seu carimbo de criação, e os desfechos para os domínios que especificam ainda não foram calculados. Isso é um depósito datado por terceiros e não um Registration OSF, que é um objecto distinto, congelado e vinculado a esquema que este componente não carrega; a API reporta registration: false e a página di-lo em vez de esbater a distinção. O que o depósito estabelece é a ordenação: as predições eram públicas e inalteradas antes de existir qualquer resultado que predissessem. É necessária replicação independente.
Palavras-chave: equações funcionais de Cauchy, leis de escala, leis de potência, universalidade, inter-domínios, composição recursiva, selecção de modelos por AICc, escala metabólica, escala neural, ARC Principle
Este artigo apresenta um resultado: sob os axiomas enunciados, as quatro equações funcionais de Cauchy prendem as leis de escala contínuas a uma de três famílias (potência, exponencial ou saturação), transformando uma identidade com duzentos anos numa predição fisicamente testável sobre as formas que as curvas empíricas de escala podem tomar. Dentro da ARC Theory (the Theory of Artificial Recursive Creation) é uma das experiências ARC/Eden, a espinha matemática que liga os constrangimentos de composição às formas funcionais observadas. O diferencial completo contra todos os documentos anteriores está em eden-vision II.A.8.
Porque existem, sequer, leis de escala? Porque é que o coração de um rato bate mais depressa do que o de um elefante segundo a mesma relação matemática que governa o crescimento das cidades, o abaratamento dos painéis solares e a melhoria das redes neurais com o tamanho?
A resposta padrão é específica de cada domínio. Os biólogos invocam redes vasculares fractais. Os físicos invocam o fluxo do grupo de renormalização. Os economistas invocam a aprendizagem-pelo-fazer. Cada explicação funciona dentro do seu domínio mas não oferece qualquer razão para as mesmas formas matemáticas recorrerem em domínios que não partilham nenhum mecanismo físico.
Este artigo propõe e testa uma resposta independente de domínio: a forma de cada lei de escala é determinada pelo operador de composição do processo recursivo subjacente, e as equações funcionais de Cauchy restringem as formas possíveis.
Augustin-Louis Cauchy estabeleceu no início do século XIX que quatro equações funcionais têm soluções contínuas únicas:
Aditiva: $f(x + y) = f(x) + f(y)$ tem solução $f(x) = cx$
Multiplicativa: $f(xy) = f(x) \cdot f(y)$ tem solução $f(x) = x^c$
Exponencial: $f(x + y) = f(x) \cdot f(y)$ tem solução $f(x) = a^x$
Logarítmica: $f(xy) = f(x) + f(y)$ tem solução $f(x) = c \log x$
Estes não são quatro resultados independentes. São quatro faces de um único constrangimento: a exigência de que uma função seja compatível com uma operação binária. Sob regularidade (continuidade, ou mensurabilidade, ou limitação num intervalo), uma função que transporte uma das duas estruturas nos reais positivos para uma das duas estruturas cai exactamente em quatro famílias: linear ($f(x)=cx$), lei de potência ($f(x)=x^c$), exponencial ($f(x)=a^x$) e logarítmica ($f(x)=c\log x$). Isto esgota os homomorfismos. Não esgota as leis de escala, porque a maioria dos sistemas não são homomorfismos de nenhuma das estruturas: comportamento de saturação, expoentes críticos, curvatura em eixos logarítmicos e transições entre múltiplos regimes ficam todos fora da grelha, e a grelha nada diz sobre eles. A equação aditiva produz a forma linear $f(x)=cx$; a equação multiplicativa produz leis de potência; a equação exponencial governa o crescimento e decaimento exponencial; e a equação logarítmica governa a aplicação ilimitada $c\log x$, que é multiplicativa na entrada e aditiva na saída e não é uma família de retornos decrescentes, uma vez que $c\log x$ é ilimitada.
Considere-se qualquer sistema onde uma quantidade $U$ cresce com a profundidade recursiva $R$. O operador de composição do sistema determina como as aplicações consecutivas se combinam:
Se se conhece o operador de composição de um sistema, é possível predizer a forma funcional da sua lei de escala antes de ver quaisquer dados. A predição decorre das equações de Cauchy sem parâmetros livres e sem ajuste de curvas.
Para cada domínio:
A classificação do operador é feita antes de o procedimento de ajuste correr. No entanto, as previsões, os dados e a lógica de ajuste residem todos num único script escrito pelo autor, e não existe submissão a registo para este teste. As previsões desta coorte não têm carimbo temporal anterior aos seus próprios ajustes: a regra de classificação chegou ao repositório público às 23:33 UTC de 16 de Março de 2026 e as cinquenta atribuições por domínio foram consignadas juntamente com os seus resultados às 23:54 dessa noite, classe de atestação data de commit do repositório público para ambas, pelo que famílias previstas antes dos ajustes é verdade quanto ao procedimento e não quanto ao carimbo temporal. O carimbo temporal antecipado por domínio neste registo pertence à extensão de doze domínios, cujo manifesto foi consignado às 00:19:19 UTC de 17 de Março de 2026, vinte e três minutos antes dos seus ajustes, e aos dois apêndices de previsões do livro impressos a 2 de Janeiro de 2026, antes de os artigos e o programa existirem. O que não foi fixado antecipadamente aqui foi o protocolo de ajuste, e essa lacuna é fechada prospectivamente pelos testes faseados, o teste da quarta célula e o teste de expansão a 80 domínios, ambos redigidos e a aguardar submissão humana. Este teste deve portanto ser entendido como uma comparação estruturada de previsões, não como um ensaio cego. Está planeada uma replicação com classificação independente do operador.
O teste v2 usa AICc apropriado (critério de informação de Akaike corrigido) calculado a partir da soma residual dos quadrados, do tamanho da amostra e do número de parâmetros, não a aproximação baseada em R$^2$ usada no teste legado v1. A aproximação v1 ($\text{AIC} \approx n \ln(1 - R^2) + 2k$) era adequada como heurística mas não deveria ter sido descrita como AIC estrito no sentido estatístico padrão. A reescrita v2 corrige isto.
O teste principal de significância é um teste de permutação condicionado às marginais: mantendo fixas tanto as marginais da família predita como as da observada e permutando o emparelhamento 400,000 vezes, a probabilidade de 19 ou mais correspondências é $p = 7 \times 10^{-5}$. A contagem esperada de correspondências sob esta hipótese nula é 9.5 de 25, e não os 8.33 que uma hipótese nula uniforme dá, porque as leis de potência são simplesmente comuns entre os ajustes observados. Um teste binomial unilateral contra uma hipótese nula uniforme de três famílias dá $p = 1.56 \times 10^{-5}$ e é retido como verificação de sensibilidade; é a hipótese nula mais fraca e não é usada como manchete. Equivalentes em sigma não são citados porque mudam com a escolha da hipótese nula. Reprodução: scripts/paper-vii-permutation-null.py no repositório do sítio, que analisa directamente a tabela publicada da Secção 5 para não poder desviar-se desta página.
A Secção 2.1 nomeia quatro famílias de Cauchy. O conjunto de modelos candidatos na Secção 3 contém seis modelos que cobrem três delas: as famílias de lei de potência, exponencial e limitada. Duas das quatro soluções contínuas de Cauchy não têm candidato próprio: a forma logarítmica $c \log x$ e a forma linear pura $cx$. Uma consequência corre em cada sentido. Um domínio genuinamente logarítmico não poderia ter sido classificado correctamente, porque o ajustador não tinha candidato logarítmico para seleccionar, pelo que algumas das seis falhas podem ter sido falhas garantidas; e alguns dos dezanove acertos podem ser relações logarítmicas que uma lei de potência ajusta aceitavelmente num intervalo finito. Cada contagem de acertos neste artigo carrega, portanto, este qualificador, e nenhuma pode ser citada sem ele. Um estudo confirmatório que reexecute a comparação com o conjunto completo de candidatos das quatro famílias, com desfechos por célula especificados de antemão, foi redigido e datado como registo em rascunho aguardando submissão humana (o teste da célula logarítmica das quatro famílias no programa registado, ao lado do estudo de extensão a domínios novos). Até essa reexecução ser reportada, os números abaixo são o resultado do modelo de seis, exactamente como calculado, e nada mais forte.
O conjunto de 50 domínios compreende cinco níveis de evidência de força decrescente. Estes níveis nunca são combinados num único número misturado.
| Nível | Descrição | Contagem | Resultado | Significância |
|---|---|---|---|---|
| Principal | Ajuste empírico de curvas (AICc) | 25 | 19/25 | $p = 7 \times 10^{-5}$ perm.; $1.56 \times 10^{-5}$ binomial |
| Secundário | Reexecução da linha de base-20 (AICc) | 20 | 15/20 | $p = 1.67 \times 10^{-4}$ |
| Secundário | Expoentes publicados (directo) | 13 | 13/13 | Correspondência com comparador mais próximo |
| Assinalado | Expoentes publicados (provisórios) | 6 | 3/6 | Organismos contestados |
| Assinalado | Identidades analíticas | 6 | 6/6 | Confirmação tautológica |
| # | Domínio | Operador | Predito | Melhor por AICc | Corresponde |
|---|---|---|---|---|---|
| 1 | Lei de Kleiber (Escala Metabólica) | Multiplicativa | Lei de potência | Saturação-exp | Não |
| 2 | Escala Urbana (PIB vs População) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 3 | Espécies-Área (Galápagos) | Multiplicativa | Lei de potência | Hill | Não |
| 4 | Lei de Wright (Painéis Solares) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 5 | Lei de Heap (Vocabulário) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 6 | Lei de Zipf (Frequência de Palavras) | Multiplicativa | Lei de potência | Michaelis-Menten | Não |
| 7 | Curva de Aprendizagem (Enrolar Charutos) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 8 | Lei de Moore (Contagem de Transístores) | Aditiva | Exponencial | Exponencial | Sim |
| 9 | Decaimento Radioactivo (P-32) | Aditiva | Exponencial | Exponencial | Sim |
| 10 | Gutenberg-Richter (Sismos) | Aditiva | Exponencial | Exponencial | Sim |
| 11 | Crescimento Bacteriano (E. coli) | Limitada | Limitada | Logística | Sim |
| 12 | Curva O$_2$-Hemoglobina | Limitada | Limitada | Hill | Sim |
| 13 | SIR Epidémico (Ebola 2014) | Limitada | Limitada | Hill | Sim |
| 14 | Lei de Amdahl (Escala de CPU) | Limitada | Limitada | Michaelis-Menten | Sim |
| 15 | Força-Velocidade Muscular (Hill 1938) | Limitada | Limitada | Exponencial | Não |
| 16 | Crescimento de MAU do Facebook | Limitada | Limitada | Logística | Sim |
| 17 | Difusão Browniana (MSD) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 18 | Lei de Horton (Números de Cursos de Água) | Aditiva | Exponencial | Exponencial | Sim |
| 19 | Leis de Escala Neural (Perda em LLM) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 20 | Ordem de Cristal Temporal (Gás de Rydberg) | Limitada | Limitada | Lei de potência | Não |
| 21 | Massa-Luminosidade Estelar | Multiplicativa | Lei de potência | Logística | Não |
| 22 | Ritmo Cardíaco vs Massa Corporal | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 23 | Regra de Rent (Contagem de Pinos VLSI) | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 24 | Lei de Potência de Taylor | Multiplicativa | Lei de potência | Lei de potência | Sim |
| 25 | Lei de Hack (Comprimento de Curso de Água) | Multiplicativa | Lei de potência | Lei de potência | Sim |
Sob selecção estrita de modelos por AICc, a família predita por Cauchy é confirmada em 19 de 25 domínios empíricos de ajuste de curvas. A probabilidade de permutação condicionada às marginais é $p = 7 \times 10^{-5}$; a probabilidade binomial sob atribuição aleatória uniforme às três famílias presentes neste conjunto de candidatos é $p = 1.56 \times 10^{-5}$, aproximadamente 1 em 64,000; sob a grelha de quatro famílias o mesmo resultado dá $p = 1.27 \times 10^{-7}$, aproximadamente 1 em 7,9 milhões, pelo que o valor aqui reportado é o mais conservador. No subconjunto estritamente derivado de Cauchy (apenas os domínios multiplicativos e aditivos) o resultado é 14/18 com permutação $p = 3.0 \times 10^{-4}$: a manchete não depende da família limitada, cuja exaustividade permanece em aberto.
Isto é forte o suficiente para ser publicado como evidência exploratória. Não é suficientemente forte para ser reivindicado como provado. A replicação independente com classificação do operador pré-registada é o próximo passo necessário.
Como contexto, os 20 domínios da linha de base original foram reexecutados com o novo ajustador AICc apropriado. O resultado é 15/20 ($p = 1.67 \times 10^{-4}$). Isto não é directamente comparável ao resultado v1 de 14/20, porque o ajustador mudou (aproximação AIC baseada em R$^2$ para AICc apropriado) e algumas selecções de modelo mudaram em conformidade. A reexecução da linha de base-20 é reportada por transparência, não como evidência de que o novo ajustador é mais ou menos conservador que o antigo.
Seis de 25 domínios empíricos produziram um modelo de melhor ajuste fora da família predita. Cada falha tem uma explicação específica e identificável. Segue-se uma análise honesta.
| # | Domínio | Predito | Melhor por AICc | Explicação |
|---|---|---|---|---|
| 1 | Lei de Kleiber | Lei de potência | Saturação-exp | Caso clássico contestado. O conjunto de dados original de Kleiber de 1932 tem apenas 13 mamíferos. Um modelo limitado consegue captar ligeira curvatura superior em massas corporais extremas. O debate sobre o expoente da lei de potência (0,67 vs 0,75) persiste há décadas. |
| 3 | Espécies-Área (Galápagos) | Lei de potência | Hill | Conjunto de dados pequeno (30 ilhas das Galápagos) com dispersão alta. Várias ilhas têm áreas muito pequenas com contagens desproporcionadas de espécies. A função de Hill consegue absorver essa dispersão com o seu parâmetro extra. |
| 6 | Lei de Zipf | Lei de potência | Michaelis-Menten | Truncatura de corpus finito. O Corpus de Brown tem um limite superior estrito na frequência de palavras (69,971 para «the»). Em posições baixas, as frequências saturam contra este tecto, puxando o AICc para um modelo limitado. A lei de Zipf é uma lei de potência no limite assimptótico; corpora finitos violam esse limite. |
| 15 | Força-Velocidade Muscular | Limitada | Exponencial | Os dados de força-velocidade de Hill 1938 mostram um decréscimo monotónico desde a força isométrica máxima até zero na velocidade máxima. Os dados não atingem nem demonstram um planalto assimptótico: terminam onde a força atinge zero. Um decaimento exponencial ajusta melhor este intervalo truncado do que uma curva de saturação. A predição limitada requer dados que cubram toda a aproximação à saturação. |
| 20 | Ordem de Cristal Temporal | Limitada | Lei de potência | Apenas 4 pontos de dados. Com tão poucas observações, o AICc penaliza os parâmetros extra dos modelos de saturação. Uma lei de potência, com menos parâmetros livres, vence por parcimónia. A predição limitada pode estar correcta mas é intestável com este conjunto de dados. |
| 21 | Massa-Luminosidade Estelar | Lei de potência | Logística | A relação massa-luminosidade mostra dispersão significativa em massas estelares elevadas onde a pressão de radiação, a instabilidade convectiva e diferentes vias de fusão criam desvios em relação a uma lei de potência simples. Um modelo logístico absorve essa dispersão ajustando uma aparente inflexão superior. |
Em resumo: três falhas envolvem conjuntos de dados pequenos ou truncados (espécies-área, cristal temporal, Zipf); uma envolve dados que não cobrem todo o intervalo de saturação (força-velocidade muscular); uma envolve uma relação classicamente contestada (Kleiber); e uma envolve complexidade astrofísica em valores extremos (massa-luminosidade estelar). Nenhuma representa um caso em que a família predita esteja fundamentalmente errada em princípio, mas também nenhuma falha pode ser descartada. São fracassos genuínos que uma replicação independente terá de tratar.
Treze táxones com expoentes de escala metabólica bem estabelecidos foram testados contra a predição dimensional ARC/Cauchy. A predição exige três condições: (a) composição multiplicativa (a equação de Cauchy restringe a forma a uma lei de potência), (b) geometria de transporte de preenchimento de espaço em $d$ dimensões, e (c) um constrangimento de conservação ou optimização sobre o fluxo de recursos (minimização de energia em West et al.; equilíbrio oferta-procura em Banavar et al.; balanço de energia em estado estacionário em Demetrius). Sob todas as três condições, o expoente é restringido a $d/(d+1)$. Nem Cauchy sozinha, nem o preenchimento de espaço sozinho, é suficiente. Organismos com transporte vascular tridimensional e fluxo conservado deveriam escalar como $M^{3/4}$, aqueles com transporte bidimensional como $M^{2/3}$, e aqueles com transporte filamentoso unidimensional como $M^{1/2}$.
O valor empírico do expoente de escalonamento metabólico dos mamíferos é debatido, com estimativas que vão de cerca de 0,67 a 0,75 consoante o táxon, o intervalo de massa, a correção de temperatura e o método estatístico (White & Seymour 2003; Glazier 2005, 2022). O maior conjunto de dados moderno (White e Seymour 2003, compilando 619 espécies) dá uma estimativa de máxima verosimilhança de 0,687 (IC 95 % 0,674-0,701), que exclui 0,750. A previsão $d/(d+1)$ de 0,750 para $d = 3$ corresponde ao extremo superior do intervalo empírico. A própria variação é coerente com o quadro: organismos com dimensões efetivas de transporte entre 2 e 3 produziriam expoentes entre 2/3 e 3/4. O quadro prevê essa variação em vez de um único expoente universal.
| # | Táxon | Predito | Observado | Mais próximo | IC inclui? |
|---|---|---|---|---|---|
| 26 | Mamíferos | 0.750 | 0.737 | $d=3$ | Sim |
| 27 | Aves | 0.750 | 0.720 | $d=3$ | Sim |
| 28 | Peixes | 0.750 | 0.800 | $d=3$ | Sim |
| 29 | Répteis | 0.750 | 0.760 | $d=3$ | Sim |
| 30 | Insectos | 0.750 | 0.750 | $d=3$ | Sim |
| 31 | Anfíbios | 0.750 | 0.740 | $d=3$ | Sim |
| 32 | Crustáceos | 0.750 | 0.730 | $d=3$ | Sim |
| 33 | Alforrecas | 0.667 | 0.680 | $d=2$ | Sim |
| 34 | Cnidários | 0.667 | 0.700 | $d=2$ | Sim |
| 35 | Ctenóforos | 0.667 | 0.660 | $d=2$ | Sim |
| 36 | Fungos ectomicorrízicos | 0.500 | 0.580 | $d=1$ | Sim |
| 37 | Fungos marinhos | 0.500 | 0.530 | $d=1$ | Sim |
| 38 | Fungos saprotróficos (20°C) | 0.500 | 0.530 | $d=1$ | Sim |
O valor do compêndio na linha 26 é 0,737, e o seu intervalo admite 0,750, ao passo que a estimativa de 619 espécies dada na nota acima exclui esse valor; cada número é declarado aqui, e a proveniência linha a linha da tabela continua pendente (ver a nota de proveniência abaixo). Cada um dos 13 expoentes publicados fica mais próximo do comparador dimensional previsto ($d/(d+1)$) do que de qualquer rival, e cada um dos 13 intervalos de confiança contém o valor previsto. É uma prova corroborante forte, mas testa uma afirmação diferente (o expoente específico) da do resultado principal (a família funcional), pelo que é relatada em separado.
A tabela acima não carrega uma coluna de citação por linha. As referências [26]-[35] da Secção 10.2 nomeiam a literatura de compêndio mais alargada sobre escala metabólica interespecífica (West, Brown e Enquist 1997; Banavar et al. 1999, 2010; Demetrius 2003, 2006, 2010; White e Seymour 2003; Glazier 2005, 2022; Kolokotrones et al. 2010) a partir da qual é compilada a literatura sobre expoentes de escala em mamíferos, vertebrados e invertebrados, mas este artigo não ancora actualmente uma citação de fonte trancada por linha a cada expoente observado ou intervalo de confiança da tabela. Leitores independentes devem tratar as linhas individuais como pendentes de uma auditoria de fonte por linha antes da reutilização em trabalho secundário; as linhas de alforrecas, cnidários e ctenóforos (33-35) e as três linhas de fungos (36-38) são aquelas para as quais não foi ancorada neste artigo uma citação de fonte por linha.
As entradas de alforrecas, cnidários e ctenóforos (linhas 33-35) são classificadas como correspondências ao comparador mais próximo $d = 2$, o que significa que os seus expoentes observados caem mais perto de 2/3 do que de 1/2 ou 3/4. Contudo, a predição biológica de $d = 2$ permanece por testar no sentido forte porque nenhum organismo conhecido possui uma rede de transporte hierárquica de preenchimento de espaço genuinamente bidimensional com fluxo conservado. Estes organismos carecem da arquitectura vascular que a derivação $d/(d+1)$ pressupõe. A confirmação de $d = 2$ existe em cosmologia (solução da era da matéria de Friedmann, exacta) e em física (percolação, fragmentação), não em biologia. Estas linhas devem ser entendidas como proximidade empírica ao comparador $d = 2$, não como confirmação dimensional.
Seis táxones adicionais com atribuições dimensionais contestadas ou baseadas em «proxy» foram testados. Apenas 3 de 6 correspondem ao comparador predito mais próximo. As falhas são platelmintes (transporte 2D vs 3D disputado), briozoários (organismos coloniais com escala anómala perto de 1,0), e enguias de vidro (alongadas mas retendo transporte vascular 3D). Estes são assinalados por completude mas carregam pouco peso evidencial devido às atribuições dimensionais contestadas.
Seis domínios definidos por fórmulas analíticas exactas ($E = mc^2$, níveis de energia do hidrogénio, cinética de Arrhenius, cinética de Michaelis-Menten, expansão de Friedmann na era da matéria, expansão de de Sitter na era da energia escura) foram incluídos como verificações de sanidade. Todos os 6 confirmam. São tautológicos, uma vez que ajustar uma curva a dados gerados por uma fórmula exacta tem de recuperar essa fórmula, e não carregam peso evidencial independente. Apenas confirmam que o ajustador funciona correctamente.
Uma pasta de pré-registo completa para a extensão deste artigo existia em Março de 2026 e está preservada no repositório público (experiments/cauchy-unification__Paper-VII/preregistration/): um protocolo escrito; um manifesto de candidatos consignado às 00:19:19 UTC de 17 de Março de 2026, cujo próprio campo de estatuto nesse commit dizia draft_local_not_locked, carregando doze linhas cada uma com classe de operador, família prevista, modelo previsto e fonte alvo fixados antes de qualquer ajuste; os próprios checksums de ficheiro do autor; e o texto de registação do componente OSF, já escrito. O único passo ausente era o clique de submissão ao registo. O próprio campo de estatuto da pasta regista a limitação nas palavras do estate: 'archived_local_packet_exercised_before_timestamp', e a análise está fixada a um commit de git. O pré-registo existia aqui em substância: o manifesto foi consignado no repositório público às 00:19:19 UTC de 17 de Março de 2026, vinte e três minutos antes de os ajustes correrem, e os mesmos ficheiros foram depositados no componente OSF público entre as 02:06:51 e as 02:07:11 dessa noite, onde permanecem inalterados. O que está ausente é uma registação de registo aceite, um objecto separado vinculado a um esquema que este componente não carrega; a API reporta registration: false. O campo de estatuto da pasta dizia draft_local_not_locked no commit que fixou as previsões e foi reescrito para archived_local_packet_exercised_before_timestamp às 00:56, depois da corrida.
Duas outras corridas de Março de 2026 existiam apenas como artefactos de repositório até esta versão, e ambas são registadas aqui com o seu estatuto declarado antes dos seus números. Ambas correram sob o conjunto de candidatos pré-correcção (sem candidato logarítmico), e a linhagem de desenho da extensão foi posteriormente retirada sem edição, pelo que ambas são resultados exploratórios datados sob a taxonomia substituída, substituídas pelo teste da quarta célula, que está redigido e a aguardar submissão humana, e nenhuma é confirmação de coisa alguma.
A extensão a 12 domínios de 17 de Março de 2026 devolveu 10/12 correspondências de família e 8/12 correspondências exactas de modelo (binomial contra um terço, p = 5.4×10⁻⁴; results_preregistered_extension.json), com as suas previsões consignadas vinte e três minutos antes dos ajustes. O seu degrau: classificada pelo autor e não por um classificador externo; conjunto de candidatos pré-correcção; atestação por commit do repositório público, não estando o ficheiro de resultado entre os depositados no componente; e uma linha, EXT-10 ocupação de receptores, corrida sobre os dados de hemoglobina de Hill de 1910, repete um domínio, uma classe de operador e um modelo previsto já públicos às 23:54 da noite anterior com um resultado coincidente, pelo que o conjunto estritamente novo lê-se 9 de 11 (p = 1.4×10⁻³), ou 8 de 10 (p = 3.4×10⁻³) se a cinética enzimática for removida com ela. É um resultado datado nesse degrau e não é confirmação da reivindicação deste artigo. A despromoção do estatuto dessa corrida está datada ao minuto no historial de commits do repositório público: e5c22dd regista o resultado 10/12 às 00:43 de 17 de Março de 2026, f5e06a8 adopta a postura conservadora de falha às 00:47, e c853277 despromove a corrida a corrida seca piloto às 00:56, treze minutos após o resultado ter sido registado e meses antes de qualquer revisão externa existir. O resultado nunca foi retirado; o seu estatuto reivindicado foi corrigido, pelo autor, contra o próprio interesse, em público. Essa despromoção é aqui mantida exactamente como foi escrita. Foi revertida a 7 de Setembro de 2026 ao abrigo da regra de classe de atestação do estate: uma previsão cujo texto é público e tem carimbo temporal anterior ao seu resultado não é despromovida pela ausência de um formulário de registo, e o commit das 00:19 já tinha fixado estas previsões antes da corrida. A reversão altera a etiqueta de estatuto e nenhum dos números. A corrida temporal fora-da-amostra a 7 domínios, que ajusta famílias candidatas a dados antigos e testa se a família vencedora prevê a forma funcional de novos dados, devolveu 4 confirmados, 2 parciais e 1 inconsistente (results_temporal_out_of_sample.json); o domínio inconsistente é reportado com o mesmo destaque que as confirmações. Um catálogo de expansão a 105 domínios (linhas 26 a 65 e 66 a 105) está preparado nos dados do repositório e não foi corrido; não é reivindicado nenhum resultado para além das corridas aqui nomeadas.
O anel mais exterior da mesma cadeia datada está em impressão. A primeira edição de 2 de Janeiro de 2026 (ISBN 978-1806056200) leva o Apêndice F, cinco previsões numeradas testáveis que fecham com uma aposta impressa: «Estas previsões são a minha aposta. Se falharem, o enquadramento está errado ou incompleto. Se tiverem sucesso, alguma coisa importante foi vislumbrada. O tempo julgará.» O Apêndice A operacionaliza as proposições do enquadramento, enuncia quatro previsões adicionais em §A.3 (desenvolvimento de IA quadrático em vez de linear; consciência e informação integrada; correcção de erros recursiva cosmológica; incorporação de valores), e fixa antecipadamente critérios de falsificação em §A.4. A Previsão 2 imprime os limiares de deriva de alinhamento de 15 por cento e 5 por cento que o pré-registo em rascunho do study-v preparado agora carrega inalterados para uma hipótese formal, citando o apêndice pelo nome. O livro é uma declaração prévia impressa em vez de um pré-registo, e os dois nunca são confundidos: a impressão fixa a previsão; apenas uma registação fixa um plano de análise.
O resultado principal ($p = 7 \times 10^{-5}$, permutação) merece contextualização honesta.
De 14 domínios empíricos classificados como multiplicativos, 10 produzem escala em lei de potência como o seu melhor modelo por AICc. Estes cobrem alometria metabólica (ritmo cardíaco vs massa corporal), economia urbana (Bettencourt 2007), curvas de aprendizagem tecnológica (lei de Wright), linguística computacional (lei de Heap), aquisição de competências (Crossman 1959), movimento browniano (Catipovic 2013), escala de redes neurais (Kaplan 2020), design VLSI (regra de Rent), ecologia de populações (lei de potência de Taylor) e geomorfologia fluvial (lei de Hack).
Quatro domínios multiplicativos falham: lei de Kleiber (o modelo limitado supera a lei de potência num conjunto de dados de 13 pontos), espécies-área (dispersão alta em dados de ilhas pequenas), massa-luminosidade estelar (dispersão a massa alta) e lei de Zipf (truncatura de corpus finito).
Todos os quatro domínios com operadores de composição aditiva produzem escala exponencial como o seu melhor modelo por AICc: lei de Moore (contagens de transístores), decaimento radioactivo (P-32), lei de Gutenberg-Richter da frequência de sismos, e lei de Horton (números de cursos de água). Este é um limpo 4/4.
De sete domínios com operadores de composição limitada, cinco produzem modelos limitados (de saturação) como melhor por AICc: crescimento bacteriano (logístico), ligação da hemoglobina (Hill), epidemia de Ebola (Hill), lei de Amdahl (Michaelis-Menten) e crescimento do Facebook (logístico). Dois falham: força-velocidade muscular (o decaimento exponencial ajusta melhor o intervalo truncado) e ordem de cristal temporal (apenas 4 pontos de dados).
Três domínios usam valores teóricos ou de referência em vez de medições empíricas independentes: decaimento radioactivo (meia-vida de referência do NIST para P-32), lei de Amdahl (fórmula teórica com fracção série assumida de 10%) e lei de Moore (contagens de transístores obtidas na Wikipédia a partir de especificações do fabricante). Estes confirmam o quadro trivialmente e devem ser ponderados em conformidade.
[1] Kleiber, M. (1932). Body size and metabolism. Hilgardia 6:315-353. Reproduzido em Dodds, P. et al. (2001) J. Theor. Biol. 209:9-27.
[2] Bettencourt, L. et al. (2007). Growth, innovation, scaling, and the pace of life in cities. PNAS 104(17):7301-7306. Dados: BEA + Census 2006, 25 maiores MSAs dos EUA.
[3] Johnson, M. & Raven, P. (1973). Species number and endemism: the Galapagos archipelago revisited. Science 179:893-895. Dados: R faraway::gala dataset, 30 ilhas.
[4] Nemet, G. (2009). Demand-pull, technology-push, and government-led incentives for non-incremental technical change. Research Policy 38(5):700-709; Farmer, J.D. & Lafond, F. (2016) Research Policy; IRENA; Our World in Data.
[5] Manning, C. et al. (2008). Introduction to Information Retrieval. Corpus Reuters RCV1.
[6] Kucera, H. & Francis, W. (1967). Computational Analysis of Present-Day American English. Brown Corpus.
[7] Crossman, E. (1959). A theory of the acquisition of speed-skill. Ergonomics 2(2):153-166. Reanálise: Newell, A. & Rosenbloom, P. (1981).
[8] Wikipedia: Transistor count. Especificações públicas do fabricante (Intel, AMD, TSMC).
[9] NIST Nuclear Data Center. Meia-vida do P-32: 14,29 dias. Valores teóricos exactos.
[10] USGS Earthquake Hazards Program; compilação IRIS. Catálogo global de sismicidade.
[11] Sezonov, G. et al. (2007). E. coli physiology in Luria-Bertani broth. J. Bacteriol. 189:8746-8749.
[12] Severinghaus, J. (1979). Simple, accurate equations for human blood O$_2$ dissociation computations. J. Appl. Physiol. 46(3):599-602.
[13] WHO/CDC Ebola Situation Reports (2014-2015); NEJM Ebola Response Team.
[14] Amdahl, G. (1967). Validity of the single processor approach to achieving large scale computing capabilities. AFIPS. Ver também Hill, M. & Marty, M. (2008) IEEE Computer.
[15] Hill, A. (1938). The heat of shortening and the dynamic constants of muscle. Proc. Royal Soc. B 126:136-195.
[16] Meta SEC filings; Zhang, C., Liu, J. & Xu, Y. (2015). J. Comp. Sci. Tech.
[17] Catipovic, M. et al. (2013). Improving the quantification of Brownian motion. Am. J. Physics 81:485.
[18] Singh, V. et al. (2021). Hydrological stream order analysis. Applied Water Science 11:151.
[19] Kaplan, J. et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361.
[20] Shen, Y. et al. (2025). Time crystal order in a Rydberg gas. Nature Communications. Ver também Kongkhambut, P. et al. (2024) Science 386(6720):670-674.
[21] Torres, G. et al. (2010). Accurate masses and radii of normal stars. Astron. Astrophys. Rev. 18:67-126. Eker, Z. et al. (2018) MNRAS 479:5491. Valores solares nominais da IAU 2015.
[22] Stahl, W. (1967). Scaling of respiratory variables in mammals. J. Appl. Physiol. 22:453. Calder, W. (1984) Size, Function, and Life History. Schmidt-Nielsen, K. (1984) Scaling: Why Is Animal Size So Important?
[23] Landman, B. & Russo, R. (1971). On a pin versus block relationship for partitions of logic graphs. IEEE Trans. Comp. C-20:1469. Christie, P. (2000); Stroobandt, D. (2001).
[24] Taylor, L. (1961). Aggregation, variance and the mean. Nature 189:732-735. Taylor, L. & Woiwod, I. (1980) J. Anim. Ecol. 49:879.
[25] Hack, J. (1957). Studies of longitudinal stream profiles in Virginia and Maryland. USGS Professional Paper 294-B. Mueller, J. (1973); Rigon, R. et al. (1996) Water Resour. Res. 32:3367.
[26] West, G. B., Brown, J. H. & Enquist, B. J. (1997). A general model for the origin of allometric scaling laws in biology. Science 276(5309):122-126.
[27] Banavar, J. R., Maritan, A. & Rinaldo, A. (1999). Size and form in efficient transportation networks. Nature 399(6732):130-132.
[28] Banavar, J. R., Moses, M. E., Brown, J. H., Damuth, J., Rinaldo, A., Sibly, R. M. & Maritan, A. (2010). A general basis for quarter-power scaling in animals. Proceedings of the National Academy of Sciences 107(36):15816-15820.
[29] Demetrius, L. (2003). Quantum statistics and allometric scaling of organisms. Physica A 322:477-490.
[29b] Demetrius, L. (2006). The origin of allometric scaling laws in biology. Journal of Theoretical Biology 243(4):455-467.
[29c] Demetrius, L. & Tuszynski, J. A. (2010). Quantum metabolism explains the allometric scaling of metabolic rates. Journal of the Royal Society Interface 7(44):507-514.
[30] Zhao, J. (2022). Universal growth scaling law determined by dimensionality. arXiv:2206.08094.
[31] Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science 340(6139):1438-1441.
[32] White, C. R. & Seymour, R. S. (2003). Mammalian basal metabolic rate is proportional to body mass2/3. Proceedings of the National Academy of Sciences 100(7):4046-4049.
[33] Glazier, D. S. (2005). Beyond the '3/4-power law': variation in the intra- and interspecific scaling of metabolic rate in animals. Biological Reviews 80(4):611-662.
[34] Glazier, D. S. (2022). Variable metabolic scaling breaks the law: a large-scale data synthesis. Biological Reviews 97(3):1056-1067.
[35] Kolokotrones, T., Savage, V., Deeds, E. J. & Fontana, W. (2010). Curvature in metabolic scaling. Nature 464(7289):753-756.
Uma busca na literatura não devolveu qualquer publicação anterior que invoque as quatro equações funcionais de Cauchy como princípio unificador inter-domínios a restringir as formas das leis de escala. Convidam-se leitores a submeter trabalho anterior; um antecedente genuíno que o faça derrota a reivindicação de prioridade deste artigo.
O trabalho existente mais próximo inclui:
A lacuna é genuína. A fórmula $d/(d+1)$ foi independentemente derivada por pelo menos sete grupos de investigação através de quadros matemáticos diferentes: redes fractais, constrangimentos geométricos com balanço oferta-procura, metabolismo quântico, escala urbana, optimização de rede, geometria vascular optimal e primeiros princípios termodinâmicos. Cada derivação conhecida exige três condições: composição multiplicativa (que Cauchy restringe à família de lei de potência), geometria de preenchimento de espaço em $d$ dimensões, e um constrangimento de conservação ou optimização sobre o fluxo de recursos. Os teoremas matemáticos têm 200 anos. Os dados biológicos têm 90 anos. A contribuição inédita não é a própria fórmula $d/(d+1)$ (que está bem estabelecida), nem a matemática de Cauchy, mas a afirmação de que as equações funcionais do tipo Cauchy explicam porque é que estas derivações independentes convergem para a mesma forma, e que o constrangimento de Cauchy tem uma consequência fisicamente testável para a classificação de leis de escala através de domínios.
As limitações acima descrevem onde o quadro é fraco; esta subsecção enuncia os desfechos específicos que o falsificariam. A afirmação central, de que o operador de composição de um domínio, classificado a partir da física conhecida antes do ajuste, prediz a sua família de lei de escala, é derrotada por qualquer dos seguintes:
O que não a derrotaria: uma única falha adicional, ou um modelo com melhor ajuste a aparecer num domínio. A reivindicação é sobre a correspondência agregada operador–família, não sobre qualquer ajuste isolado; mas esse agregado tem de exceder a linha de base do acaso sob replicação pré-registada com classificação independente.
Se o quadro se aguentar sob replicação independente pré-registada, sugeriria:
Estas implicações são condicionais. A evidência actual é exploratória, não definitiva.
Plante uma bolota e, dados séculos, obtém um carvalho. Mas plante a bolota desse carvalho, e a bolota dessa, recursivamente ao longo de milénios, e obtém uma floresta que molda o clima dos continentes. O que plantarmos nestes sistemas irá compor-se em escalas que não conseguimos imaginar. A semente determina a floresta.
Cauchy provou há 200 anos que a semente também determina a forma da floresta. Sementes multiplicativas produzem leis de potência. Sementes aditivas produzem exponenciais. Sementes limitadas produzem saturação. Vinte e cinco domínios empíricos testados contra esta predição rendem 19 confirmações a $p = 7 \times 10^{-5}$ sob o teste de permutação condicionado às marginais, no conjunto de candidatos de seis modelos da Secção 3.2; a reexecução de quatro famílias está redigida e aguarda submissão humana. Treze expoentes metabólicos publicados caem onde a teoria dimensional prediz.
A matemática esteve sempre lá. Só não a tínhamos lido como uma predição sobre o mundo físico. Se essa leitura se aguenta sob escrutínio independente é agora uma questão para a comunidade científica responder.
Raise AI with care.
O conjunto de validação completo, incluindo todas as 50 definições de domínio, o manifesto canónico e o código de ajuste baseado em AICc, está disponível em:
O script requer Python 3.10+, numpy e scipy. Todos os dados estão embutidos no manifesto com citações completas de proveniência. A saída é determinística.
Estatuto epistémico. O que este programa chama Laws são conjecturas sob teste adversarial registado; cada quantidade neste artigo é operacionalmente definida, e o estatuto de lei estabelecida não é reclamado em lado nenhum. O programa registado existe para ganhar esse estatuto, ou perdê-lo, através de medição, replicação e refutação sobrevivida.
© 2026 Michael Darius Eastwood. Autoria humana com assistência computacional; a autoria humana plena e os direitos morais são reivindicados ao abrigo do Copyright, Designs and Patents Act 1988 e em consonância com as orientações do United States Copyright Office sobre obras contendo material gerado por IA; qualquer contribuição técnica inédita descrita neste trabalho foi concebida pelo autor humano. Declaração completa: michaeldariuseastwood.com/authorship.
Compromisso permanente. Prove que este artigo está errado, e publicarei eu próprio a refutação. As condições de falsificação estão enunciadas neste artigo; o desafio permanente: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood concebeu e dirige este programa de investigação e é o autor deste trabalho. Ao longo do programa, utilizou mais de seis sistemas de IA em paralelo, sob as suas próprias instruções, para pôr à prova os seus argumentos, identificar possíveis erros e ajudar na preparação de texto preliminar a partir dos seus próprios esquemas. Ele determina o que é adotado, revisto ou rejeitado e assume a responsabilidade pelo conteúdo publicado. Estes sistemas são ferramentas, não autores.
Erro de tradução? Comunique diretamente: