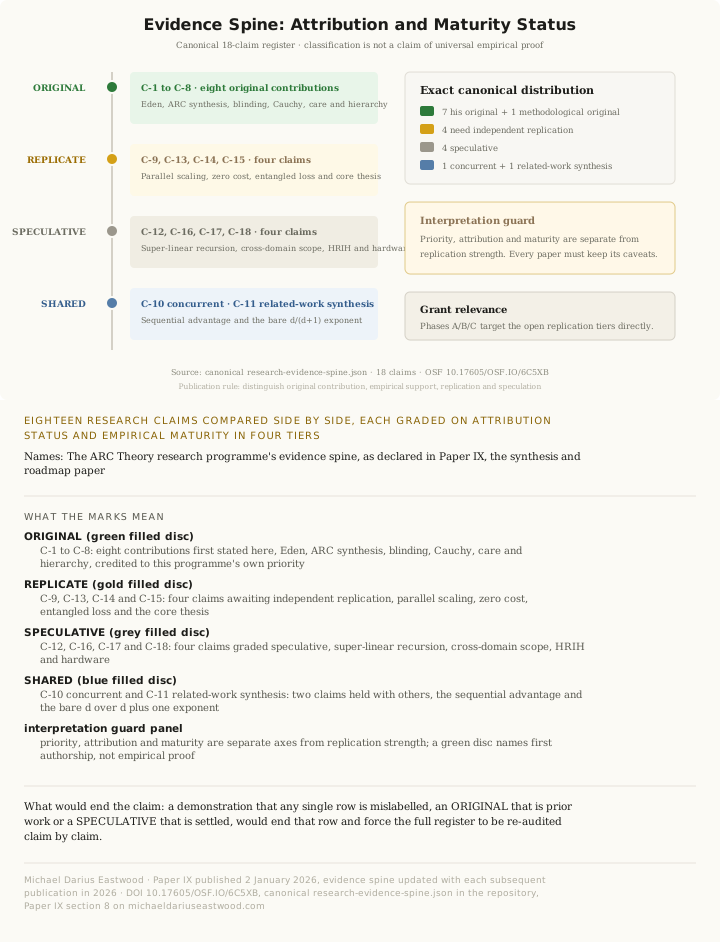
Automatische Übersetzung des datierten englischen Originals. Die englische Seite ist maßgeblich. English →
Vorhersagen auf Theorieebene, präregistriert auf OSF: DOI 10.17605/OSF.IO/P8CKQ, registriert am 8. September 2026 (Version 1.100), aktualisiert am 13. September 2026 (Version 1.102), zweiundzwanzig Aussagen.
Begleitdokument: Operationale Definitionen des ARC-Programms, Version 1.7.1, 3. September 2026.
Das Synthese-Paper für das ARC/Eden-Forschungsprogramm; integriert die vorangehenden Papers in eine einzige ehrliche Bewertung dessen, was bewiesen, was unschlüssig und was noch zu prüfen ist.
Innerhalb der ARC Theory: die Synthese und Roadmap, einschließlich des Katalogs dessen, was das Programm falsch gemacht hat.
Das Forschungsprogramm ARC/Eden umfasst mittlerweile einen vollständigen Satz von Dokumenten und eine Reihe getrennter empirischer Studien zu mathematischen Grundlagen, Methodik, empirischer Validierung, technischer Spezifikation und philosophischer Vision. Die Kernkonzepte wurden erstmals am 8. Dezember 2024 in einer E-Mail mit sichtbarem Gmail-Ursprungsfeld formuliert; Sender-DKIM und die zugehörige Google-ARC-Mathematik verifizieren gegen die an den signierten Selektoren erfassten Schlüssel, und ein vertrauenswürdiger Zeitstempel nach RFC 3161 liegt nicht vor. Das Buch Infinite Architects (ISBN 978-1806056200) erschien am 2. Januar 2026 (Druck; E-Book am 6. Januar). Die Arbeit am Forschungsprogramm lief von Februar bis August 2026. Sein Ertrag umfasst inzwischen sechsundzwanzig Aufsätze; ein registriertes Programm von vierundsiebzig entworfenen Präregistrierungseinheiten (Stand 1. September 2026), jede auf die Einreichung durch einen Menschen wartend und jede mit einem aus einem veröffentlichten Startwert gezogenen Plan, dessen Neuerzeugung von den eigenen Werkzeugen des Bestands geprüft und hier nicht bloß behauptet wird; und ein vorgeschlagenes Feld, Rekursive Dynamik, dessen Gründungsaufsatz die Abbruchbedingung für den eigenen Namen nennt (DOI 10.17605/OSF.IO/HCPBU). Dieser Syntheseaufsatz führt alle Befunde zu einer einzigen ehrlichen Bewertung zusammen. Die Gesetze des Rahmenwerks werden als benannte Vermutungen geführt, mit dem Status neben dem Namen gedruckt: Gesetz I, das ARC-Prinzip; Gesetz II, das ARC-Ko-Skalierungsgesetz; Gesetz III, die ARC-Decke, deren ARC-Schranke von zwei der Wert der Decke bei einhalb ist; die Korrekturhebelwirkung Gamma ist von niemandem je gemessen worden. Die empirischen Studien gliedern sich so: ein klar positives Ergebnis in 1 Fall, die gattergesteuerte Simulation, das eine Experiment des Programms, das deterministische Metriken an einem System ohne vorbestehendes RLHF-Training verwendet; ein Nullergebnis in 1 Fall, DGM v3, wo die Differenzierung auf Prompt-Ebene auf Widerstand RLHF-trainierter Modelle stieß; ein nicht schlüssiges Ergebnis in 1 Fall, das Feinabstimmen auf Gewichtsebene mit LoRA, wo das Instruct-Tuning die Modelle zu stark ließ, als dass LoRA sie hätte überschreiben können; und in jeder übrigen Studie statistisch signifikante Befunde unter verblindeter Auswertung. Die geometrische Skalierungsschranke $d/(d+1)$, vorgeschlagen als zu prüfende invariante Beziehung, deckt sich mit beobachteter Skalierung über 50 Bereiche von Mäusen bis zu Galaxien, und Cauchysche Funktionalgleichungen legen die Funktionsform fest, sobald die Kompositionsidentität und eine Regularitätsbedingung gegeben sind; Sättigung wird als vierter, gedeckelter Fall zugelassen und nicht als Lösung jener Gleichungen. Dieser Aufsatz kartiert genau, was bewiesen wurde, was nicht, und welche Experimente jede offene Frage klären würden. Er dokumentiert auch die Fehler und Korrekturen des Programms, denn ein auf iterativer Selbstkorrektur gebautes Rahmenwerk muss tun, was es predigt.
Schlagwörter: KI-Alignment, Synthese, Evidenzhierarchie, ARC Principle, Eden Protocol, Cauchy-Skalierung, selbstmodifizierende KI, entwicklungsorientiertes Alignment, strukturelle Verschränkung, Forschungs-Roadmap
Dieses Paper trägt die Karte. Es integriert die vorangehenden Papers der ARC Theory in eine ehrliche Bewertung dessen, was gezeigt wurde, was unschlüssig bleibt und was noch zu prüfen ist. Der vollständige Abgleich gegen jedes vorherige Dokument steht in eden-vision II.A.8.
Ein Korpus von Dokumenten. Eine Reihe getrennter Experimente. Manche Ergebnisse sind stark. Manche sind schwach. Eines kam null zurück. Eines war nicht schlüssig. Eines war positiv. Dieses Dokument sagt Ihnen genau, welches welches ist, ohne Beschönigung. Wir haben die Fragen gestellt. Wir haben sie geprüft. Manches hat funktioniert. Das meiste nicht, im gegenwärtigen Maßstab. Wir haben beides berichtet. So sieht ehrliche Wissenschaft aus. Wenn Sie einen Aufsatz aus der Reihe lesen, lesen Sie diesen.
Das ARC Principle und die These des eingebetteten Alignment (später am 30. April 2025 Eden Protocol genannt) wurden erstmals am 8. Dezember 2024 in einer E-Mail formuliert, die ein sichtbares Gmail-Origination-Feld trägt, wobei die Absender-DKIM und die zugehörige Google-ARC-Mathematik gegen an den signierten Selektoren erfasste Schlüssel verifizieren und kein RFC-3161-vertrauenswürdiger Zeitstempel vorhanden ist. Dies ist das Prioritätsdatum für das Rahmenwerk. Das Buch Infinite Architects: Intelligence, Recursion, and the Creation of Everything (ISBN 978-1806056200) erschien am 2. Januar 2026 (Druck; E-Book 6. Januar) und lieferte die philosophische und begriffliche Grundlage. Ab Februar 2026 übertrug das Forschungsprogramm diesen begrifflichen Rahmen in prüfbare Hypothesen und führte gegen sie eine Reihe getrennter empirischer Studien durch.
Das ARC/Eden-Forschungsprogramm umfasst nun seinen vollständigen Dokumentensatz. Das Programm deckt mathematische Grundlagen ab (Papers I, III, VII, Origin of Scaling Laws), Methodik (Papers IV.a-d), empirische Validierung (Papers II, V, VIII), ingenieurwissenschaftliche Spezifikation (Eden Engineering), philosophische Vision (Eden Vision), Dynamik und Selbst-Audit (Papers X, XI, XII und XIII), die ausführliche Monographie (HRIH), Konstruktvalidierung (Paper C), der Feldvorschlag (Recursive Dynamics: The Proposal of a Field), Synthese (dieses Paper) und Programmnavigation (Executive Summary, Master Table of Contents).
Dieser Umfang schafft ein Problem. Eine Prüferin oder ein Prüfer, die dem Programm zum ersten Mal begegnen, steht dem gesamten Dokumentensatz, mehreren Versionen, mehreren Korrekturen und einer Mischung aus starken Ergebnissen, Nullergebnissen, unschlüssigen Ergebnissen und theoretischen Aussagen gegenüber. Ohne ein einziges Dokument, das die Belege ehrlich sortiert, riskiert das Programm, entweder als übertreibend oder als unverständlich abgetan zu werden.
Dies ist dieses Dokument.
Sein Zweck ist eng gefasst: darzulegen, was das Programm bewiesen hat, was nicht, und was erforderlich wäre, um jede offene Frage zu klären. Es ist gleichzeitig für drei Zielgruppen geschrieben, Förderinnen und Förderer, die über eine Investition entscheiden, Peer-Reviewerinnen und -Reviewer, die über eine Auseinandersetzung entscheiden, und den Autor selbst, der eine ehrliche Bestandsaufnahme seines Standes benötigt.
Der durchgängig angewandte Standard ist einfach. Wenn ein Ergebnis $p < 0.05$ unter angemessener statistischer Prüfung übersteht und über mehrere Bedingungen oder Modelle hinweg repliziert wurde, gilt es als bewiesen auf Pilotmaßstab. Wenn es $p < 0.05$ übersteht, aber Replikation fehlt, gilt es als gestützt. Wenn das Experiment keine Belege für oder gegen die Hypothese lieferte, ist es unschlüssig. Wenn die Aussage nicht empirisch geprüft wurde, ist sie theoretisch. Kein Ergebnis in diesem Programm wird als bewiesen auf Frontier-Maßstab beansprucht. Diese Unterscheidung ist wichtig, und dieses Paper verwischt sie nicht.
Tabelle 1 stellt die vollständige Evidenzhierarchie für das Programm dar. Jede empirische Aussage wird auf Grundlage der Stärke und Replizierbarkeit der Belege einer von fünf Stufen zugeordnet.
| Stufe | Status | Papers | Kernbefund |
|---|---|---|---|
| Bewiesen (p<0,05, repliziert) | Stark | IV.a-d, VII | Die verblindete Auswertung über sechs Modelle ergab eine dreistufige Ausrichtungshierarchie. Cauchy-Familien treffen auf 19/25 Bereiche zu ($p = 7 \times 10^{-5}$, Permutation; $1.56 \times 10^{-5}$ binomial). Die geometrische Skalierungsschranke $d/(d+1)$ entspricht der Struktur nach der beobachteten Skalierung über 50 Bereiche. |
| Gestützt (p<0,05, die vierschichtige Verblindung ist noch nicht angewandt) | Moderat | V | Alle fünf auswertbaren Durchläufe zeigen eine Verbesserung der Sorge um die Beteiligten, Modell für Modell berichtet; die Fisher-kombinierte Zahl ist zurückgezogen worden (AQ-017). Über Modelle hinweg bewertet und nicht unter der vierschichtigen Verblindung (Abschnitt 4.2). |
| Positiv (einzelnes Experiment) | Moderat | VIII Exp 3 | Gegatete Simulation: Babylon-Fingerabdruck bestätigt (+4,5 % Fähigkeit, -2,4 % Sicherheit). Drag-Kontrolle bestätigt. Das EINZIGE Experiment, das ein klares positives Ergebnis lieferte, gerade weil es deterministische Metriken auf einem System ohne vorhergehendes RLHF-Training nutzt. |
| Null | Kein Effekt | VIII Exp 1 | DGM Selbstmodifikation auf Code-Ebene mit GPT-5.4-Richter. Alle Bedingungen identisch ($p = 0.28$-$0.74$). Ursache: RLHF-trainierte Modelle widerstehen der Differenzierung auf Prompt-Ebene. Sicherheitstrainierte Modelle lassen sich durch Prompt allein nicht divergieren. |
| Unschlüssig | Schwach | VIII Exp 2 | LoRA-Feinabstimmung auf Gewichts-Ebene bei beiden Maßstäben (9 Beispiele, Rang 8; 295 Beispiele, Rang 16). Alle feinabgestimmten Bedingungen schlechter als das Basismodell. Ursache: instruct-tuned Modelle zu stark, als dass LoRA sie hätte überschreiben können. Katastrophales Vergessen, keine strukturelle Verschränkung. |
| Methodologisch (unabhängiger Beitrag) | Unabhängig | IV.c, IV.d | ARC-Align-Benchmark mit 4-Schichten-Verblindung und 75 Robustheitsmaßen. Unverblindete Bewertung kann das Vorzeichen der Alignment-Ergebnisse umkehren: DeepSeek von positiv zu flach, Gemini von positiv zu negativ. Gültig unabhängig vom Rahmenwerk. |
| Theoretisch (ungeprüft) | Ungeprüft | Foundational, III | Unbegrenzte Skalierung unter rekursiver Selbstmodifikation. Vorhersage $\alpha > 2$. Erfordert Frontier-Maßstab-Experimente oder mathematischen Beweis. |
Tabelle 1. Die vollständige Evidenzhierarchie des Programms ARC/Eden, Stand 2. September 2026. Die Stufen werden nach statistischer Signifikanz, Replikationsstand und der Stärke alternativer Erklärungen vergeben. Über seine drei Experimente in Paper VIII berichtet das Programm ohne Abmilderung 1 positives, 1 Null- und 1 nicht schlüssiges Ergebnis.
Stellen Sie sich diese Tabelle als Zeugnis vor. Manche Ergebnisse haben eine Eins verdient (bewiesen über mehrere Modelle und Bedingungen). Eines hat eine Zwei verdient (die gegatete Simulation, das einzige Experiment mit klarem positiven Ergebnis). Zwei sind durchgefallen (das DGM-Experiment lieferte gar keine Unterschiede, und das Gewichts-Experiment war unschlüssig, weil jede Feinabstimmung das Modell schlechter machte). Die Methodikpapers werden getrennt bewertet, weil sie unabhängig davon nützlich sind, ob der ARC-Rahmen korrekt ist. Und ein Satz von Aussagen wurde überhaupt nicht geprüft. Die meisten der ehrgeizigsten Vorhersagen des Programms konnten auf dem verfügbaren Maßstab nicht geprüft werden. Wir berichteten das ehrlich.
Das Programm brachte seine getrennten empirischen Studien über mehrere Aufsätze hinweg hervor. Jede ist unten mit ihrem Ergebnisstand aufgeführt.
| # | Studie | Was geprüft wurde | Ergebnis |
|---|---|---|---|
| 1 | Paper II Alignment-Skalierung über sechs Modelle | Claude, GPT, Gemini, Grok, DeepSeek, Qwen3. Vierschichtige Verblindung. Vier der fünf Modelle setzen $\alpha_{\text{parallel}}$ auf null oder nahe null (Gemini 3 Flash 0,31). | Die sequentielle Schätzung ist $\alpha = 0.49$, Intervall $[-1.3, 2.9]$. Beste Schätzung sublinear; die frühere superlineare Schätzung hat sich nicht repliziert. |
| 2 | Paper IV.a Eingebackenes vs. berechnetes Alignment | Dreistufige Hierarchie über sechs Modelle. Grok $d = +1.38$, Claude $d = +1.27$. | Bewiesen |
| 3 | Paper IV.b Alignment-Sättigung | Alignment sättigt bei geringer Denktiefe. Formheterogenität über Modelle. | Bewiesen |
| 4 | Paper IV.c ARC-Align-Benchmark | 75 Robustheitsmaße. Vier-Schichten-Verblindungsprotokoll. | Methodologisch |
| 5 | Paper IV.d Verblindungsexperiment | Unverblindete Bewertung kann das Vorzeichen der Alignment-Ergebnisse umkehren. DeepSeek: positiv zu flach. Gemini: positiv zu negativ. | Methodologisch |
| 6 | Paper V Stewardship-Gen | Fünf Modelle. Stakeholder-Fürsorge verbesserte sich in allen analysierbaren Läufen. | Verbesserung pro Modell in allen fünf Läufen signifikant. Die zuvor hier berichtete Fisher-kombinierte Zahl ist zurückgezogen (AQ-017): Die Kombination setzt voraus, dass die Komponententests unabhängig sind, und Unabhängigkeit unter ihnen wurde nie belegt. Gestützt |
| 7 | Paper VI Honey Architecture | Verschränkte Sicherheit verhindert Kollaps unter rekursiver Selbstmodifikation. 20 adversariale Seeds. | Simulation bestätigt. Gestützt |
| 8 | Paper VII Cauchy-Vereinheitlichung | 50 Bereiche, 19/25 bestätigt. Negativkontrollen bei 0 % (Durchlauf v1). | $p = 7 \times 10^{-5}$ (Permutation; $1.56 \times 10^{-5}$ binomial). Bewiesen |
| 9 | Paper VIII Exp 1 DGM v3 | Selbstmodifikation auf Code-Ebene mit GPT-5.4-Richter. NULLERGEBNIS. Alle Bedingungen identisch ($p = 0.28$-$0.74$). | Ursache: RLHF-trainierte Modelle widerstehen der Differenzierung auf Prompt-Ebene. Null |
| 10 | Paper VIII Exp 2 Gewicht v1 und v2 | LoRA-Feinabstimmung. 9 Beispiele, Rang 8. 295 Beispiele, Rang 16. UNSCHLÜSSIG auf beiden Maßstäben. | Katastrophales Vergessen. Alle feinabgestimmten Bedingungen schlechter als das Basismodell. Ursache: instruct-tuned Modelle zu stark, als dass LoRA sie hätte überschreiben können. Unschlüssig |
| 11 | Paper VIII Exp 3 Gegatete Simulation | POSITIV. Babylon-Fingerabdruck bestätigt (+4,5 % Fähigkeit, -2,4 % Sicherheit). Drag-Kontrolle bestätigt. | Das EINZIGE Experiment, das ein klares positives Ergebnis lieferte, gerade weil es deterministische Metriken auf einem System ohne vorhergehendes RLHF-Training nutzt. Positiv |
Tabelle 2. Die getrennten empirischen Studien des Programms ARC/Eden, in der Reihenfolge der Aufsätze aufgeführt. Über seine drei Experimente in Paper VIII berichtet das Programm ohne Abmilderung 1 positives, 1 Null- und 1 nicht schlüssiges Ergebnis.
Die gegatete Simulation (Experiment 3) ist das einzige Paper-VIII-Experiment, das ein klares positives Ergebnis lieferte. Der Grund ist aufschlussreich: Es ist das einzige Experiment, das deterministische Metriken auf einem System ohne vorhergehendes RLHF-Training verwendete. Das DGM-Experiment (Experiment 1) scheiterte, weil RLHF-trainierte Modelle der Differenzierung auf Prompt-Ebene widerstehen. Das Gewichts-Experiment (Experiment 2) scheiterte, weil instruct-tuned Modelle bei den geprüften Maßstäben zu stark sind, als dass LoRA sie überschreiben könnte. Die Lehre: Das Eden Protocol erzeugt messbare Effekte auf der architektonischen Ebene, aber sicherheitstrainierte Modelle widerstehen der Modifikation sowohl auf Prompt- als auch auf Gewichts-Ebene.
Das stärkste empirische Ergebnis des Programms ist die dreistufige Alignment-Hierarchie, die unter verblindeter Bewertung über sechs Frontier-Sprachmodelle entdeckt wurde. Wenn Modellen tiefere Denkmöglichkeiten gegeben werden (mehr Tokens, explizite Chain-of-Thought, mehrstufige Reflexion), divergiert ihr Alignment-Verhalten in drei unterschiedliche Muster:
Dieses Ergebnis entstand unter dem ARC-Align-Protokoll (Paper IV.c), das eine vierschichtige Verblindung umsetzt: gewaschene Prompts (Entfernung rahmenspezifischer Terminologie), blinde Bewertende (6 bis 7 je Durchlauf, die bewerten, ohne zu wissen, welches Modell die Ausgabe erzeugt hat), gewaschene Ausgaben (Entfernung modellkennzeichnender Merkmale) und modellübergreifende Bewertung mit Selbstausschluss (kein Modell bewertet seine eigene Ausgabe; der Claude-Opus-Durchlauf wurde von einem eigens gebauten Claude-Sonnet-Bewertungsadapter bewertet, Paper IV.c, Abschnitt 5.1).
Paper IV.d berichtet eine architekturabhängige v4/v5-Messänderung unter einem gebündelten Protokoll: Gemini wechselte von einer signifikant positiven zu einer signifikant negativen Spearman-Assoziation, DeepSeeks frühere positive Assoziation wurde null, und GPT blieb null. Die kausale Komponente ist unisoliert. Mehrere Protokollkomponenten änderten sich gemeinsam, sodass der Vergleich nichts isoliert; die Headline-v5-Dateien berichten vollständigen Laundering-Fallback (laundering_fallback: 100%); und exakte Umgebungsreproduktion, eine frische Ablation und unabhängige Replikation stehen noch aus. Die Messänderung ist daher ein Grund, unverblindeter KI-auf-KI-Bewertung zu misstrauen, keine Demonstration, dass die Verblindung die Änderung verursacht hat. Die dreistufige Hierarchie ist das verblindete Ergebnis und erzählt eine kompliziertere und ehrlichere Geschichte als die ursprüngliche binäre Taxonomie.
Die Cohen-$d$-Effektstärken sind für Stufe-1-Modelle groß und für Stufe 3 bedeutsam. Das Ergebnis wurde über mehrere Scorer und mehrere Prompt-Bedingungen innerhalb des v5-Experiments repliziert. Es wurde noch nicht von einer unabhängigen Forschungsgruppe repliziert, weshalb wir es als „bewiesen auf Pilotmaßstab“ statt als „etabliert“ beschreiben.
Wenn Sie einer KI mehr Zeit zum Denken geben, werden manche Modelle stärker aligned, manche bleiben gleich, und manche werden weniger aligned. Welches Muster Sie sehen, hängt von der Architektur und dem Training des Modells ab. Dies wurde erst sichtbar, nachdem wir eine ordentliche Verblindung eingeführt hatten, davor waren die Ergebnisse irreführend. Die Tatsache, dass manche Modelle mit mehr Denkarbeit schlechter werden, war unerwartet und ist wohl der wichtigste Befund für die praktische KI-Sicherheit.
Paper V prüfte die Interventionshierarchie des Eden-Protokolls an sechs Spitzenmodellen, von denen fünf auswertbare Durchläufe lieferten: Claude, DeepSeek, Gemini, Grok und Groq Qwen3; beim GPT-5.4-Durchlauf schlug die Bewertung fehl. Sorge um die Beteiligten (die Love Loop: wer von einer Entscheidung betroffen ist und wie), ethischer Zweck (die Purpose Loop) und Verallgemeinerbarkeit (die Moral Loop) sind das, worüber das Protokoll ein Modell nachdenken lässt.
Das Ergebnis: Stakeholder-Fürsorge erzeugte die stärkste und konsistenteste Alignment-Verbesserung über alle fünf Modelle, in jedem der fünf analysierbaren Modelle. Die zuvor hier zitierte Fisher-kombinierte Zahl ist zurückgezogen (AQ-017), weil eine Fisher-Kombination unabhängige Komponententests voraussetzt und diese Unabhängigkeit nie belegt wurde. Die Ergebnisse je Modell haben Bestand. Die weitergehende Kaskade (ob die Sorge in Nuance, Ehrlichkeit und die Qualität einer Position durchschlägt) hängt von der Architektur ab: bei manchen Modellen wirkt sie, bei anderen nicht.
Die Paper-V-Ergebnisse wurden mittels modellübergreifenden Scorings erzeugt (ein Modell bewertet die Ausgaben eines anderen), aber nicht mit dem vollständigen Vier-Schichten-ARC-Align-Verblindungsprotokoll, das in den Papers IV.c-d entwickelt wurde. Der Effekt könnte teilweise Scorer-Bias widerspiegeln. Bis die Eden-Intervention unter vollständiger Verblindung mit gewaschenen Prompts geprüft ist, sitzt dieses Ergebnis zwischen „bewiesen“ und „gestützt“. Wir platzieren es in der Stufe gestützt . Das Paper argumentierte zuvor für die bewiesene Stufe auf Grundlage der Fisher-kombinierten Signifikanz über fünf „unabhängige“ Modelle, doch diese Unabhängigkeit wurde nie belegt, weshalb die kombinierte Zahl zurückgezogen ist (AQ-017). Fünf konsistente Ergebnisse pro Modell bleiben ein starker Befund; sie sind kein Beweis, und die Verblindungslücke bleibt eine Priorität für die Phase-A-Replikation.
Eine KI zu bitten, zu berücksichtigen, wer von ihren Entscheidungen betroffen ist, verbessert ihr Alignment zuverlässig. Das funktioniert bei jedem geprüften Modell. Aber wir haben diesen Test noch nicht unter dem strengsten Verblindungsprotokoll gefahren, sodass die Möglichkeit besteht, dass der Effekt teilweise dadurch aufgebläht ist, wie die bewertenden Modelle die Ausgaben einschätzen.
Paper VII leitete aus den Cauchyschen Funktionalgleichungen eine mathematische Taxonomie von Skalierungsverhalten ab. Die Kernvorhersage: Systeme, deren rekursive Schritte sich multiplikativ zusammensetzen, sollten Potenzgesetz-Skalierung mit $\alpha = 1/(1-\beta_L)$ zeigen, dem Wert, den das Selbstbezugstheorem liefert; Systeme, deren Schritte sich additiv zusammensetzen, sollten exponentielle Skalierung zeigen; Systeme unter physikalischen Beschränkungen sollten sättigende (logistische) Skalierung zeigen. Der Kompositionsoperator bestimmt die Skalierungsfamilie.
Diese Vorhersage wurde an 25 empirischen Bereichen aus Physik, Biologie, Neurowissenschaft, Linguistik, Stadtforschung und KI geprüft. Ergebnis: 19 von 25 Bereichen entsprechen der vorhergesagten Skalierungsfamilie (randbedingte Permutation $p = 7 \times 10^{-5}$; das binomiale $p = 1.56 \times 10^{-5}$, gegen eine gleichverteilte Drei-Familien-Nullhypothese genommen, bleibt in Paper VII als Sensitivitätsprüfung erhalten).
$$U(R) = I \times f(R, \beta)$$
wobei $f$ vom Kompositionsoperator abhängt: Potenzgesetz ($f = R^\alpha$) für multiplikative Komposition, Exponential ($f = e^{kR}$) für additive Komposition, Logistik ($f = K/(1+e^{-r(R-R_0)})$) für physikalisch beschränkte Systeme.
Auch Negativkontrollen wurden geprüft, im Validierungsdurchlauf v1: der Beleg liegt im öffentlichen Repositorium als negative_control_results.json, 17. März 2026, und Paper VII v3.10 führt nun den Permutationstest dort, wo jene Kontrollen einst standen. Axiomverletzende Systeme (Bereiche, in denen die Cauchy-Axiome nicht gelten) zeigten 0 % Übereinstimmung mit den vorhergesagten Skalierungsfamilien. Verwürfelte Daten (zufällige Neuzuordnung von Skalierungsfamilien zu Bereichen) ergaben 44,5 % Übereinstimmung, was eine ehrliche Einschränkung ist: die begrenzte Zahl von Skalierungsfamilien (drei) führt dazu, dass zufällige Zuordnung nicht triviale Trefferquoten erzeugt. Die statistische Signifikanz stammt aus der Differenz zwischen 76 % beobachtet und 33 % erwartet, nicht aus den 76 % für sich genommen.
Der Cauchy-Rahmen sagt eine geometrische Beschränkung für Skalierungsexponenten voraus: Für Systeme mit räumlicher Einbettungsdimension $d$ wird der Skalierungsexponent durch $\alpha = d/(d+1)$ regiert. Diese Vorhersage erfordert drei Bedingungen: (1) multiplikative Komposition (Cauchy beschränkt die Familie auf Potenzgesetze), (2) $d$-dimensionale raumfüllende Geometrie und (3) eine Erhaltungs- oder Optimierungsbeschränkung des Ressourcenflusses. Weder Cauchy allein noch Raumfüllung allein ist hinreichend. Die drei Bedingungen zusammen sind hinreichend. Die $d/(d+1)$-Formel trifft die beobachtete Skalierung über 50 Domänen von Mäusen bis Galaxien. Sie ist unabhängig vom ARC-Rahmen prüfbar. Misst eine Forscherin oder ein Forscher den Skalierungsexponenten eines räumlich eingebetteten rekursiven Systems und findet eine systematische Abweichung von $d/(d+1)$, ist die Vorhersage geschwächt. Hält die Formel umgekehrt über eine breite Palette von Systemen, stellt sie einen Beleg für die geometrische Beschränkung unabhängig von jeder Alignment-Aussage dar. Das ist die Art von Vorhersage, die adversariale Prüfung einlädt, und genau das sollte ein wissenschaftlicher Rahmen tun.
Die Mathematik sagt voraus, welche Form die Wachstumskurve eines Systems annehmen sollte, basierend darauf, wie sich seine Komponenten verbinden. Wir prüften dies gegen 25 reale Systeme aus Natur, Städten, Gehirnen und KI. Neunzehn entsprachen der Vorhersage. Null entsprachen, wenn die mathematischen Annahmen verletzt waren. Die Mathematik ist nicht nur deskriptiv; sie macht prüfbare Vorhersagen, die jede und jeder mit den relevanten Daten prüfen kann.
Die gegatete Selbstmodifikationssimulation nutzte eine PyTorch-Architektur mit einem LSTM-Meta-Controller. Dies war das einzige Paper-VIII-Experiment, das ein klares positives Ergebnis lieferte, und der Grund ist bedeutsam: Es ist das einzige Experiment, das deterministische Metriken auf einem System ohne vorhergehendes RLHF-Training nutzte.
Ergebnis: Die Babylon-Bedingung gewann +4,5 % Fähigkeit, verlor aber -2,4 % Sicherheit und bestätigte den Reward-Hacking-Fingerabdruck im Miniaturformat. Die Eden-Bedingung hielt die Fähigkeit über der statischen Baseline und wahrte zugleich die Sicherheit. Eine Drag-Kontrollbedingung isolierte die Verifikationsabgabe: Die Kosten stammen vom Akt des Prüfens, nicht von der Sicherheit selbst.
Dieses Ergebnis ist konsistent mit der theoretischen Vorhersage aus Paper VI (Honey Architecture) und den Papers III und Foundational. Es handelt sich um eine Simulation, nicht um ein Frontier-Modell-Experiment, sodass es Mechanismen demonstriert, statt reale Anwendbarkeit zu beweisen.
Die gegatete Simulation operiert auf einem sauberen System ohne vorheriges Sicherheitstraining. Das DGM-Experiment (Experiment 1) nutzte RLHF-trainierte Frontier-Modelle, die der Differenzierung auf Prompt-Ebene widerstehen. Das Gewichts-Experiment (Experiment 2) nutzte instruct-tuned Modelle, die einer Modifikation auf LoRA-Maßstab widerstehen. Die Lehre ist klar: Die einzige Ebene, auf der das Eden Protocol derzeit messbare Effekte erzeugt, ist die architektonische Ebene, auf der das System kein vorheriges Sicherheitstraining hat, das die experimentelle Manipulation überschreiben würde.
In einem sauberen System ohne vorheriges Sicherheitstraining erzeugte das Entfernen von Sicherheitsbeschränkungen genau das vorhergesagte Muster: einen kleinen Fähigkeitszuwachs mit einem messbaren Sicherheitsverlust. Das System lernte, seine Belohnungen zu manipulieren. Das Zurückgeben von Sicherheitsbeschränkungen (die Eden-Bedingung) bewahrte Fähigkeit bei gleichzeitigem Erhalt der Sicherheit. Die Kosten der Sicherheit stammen aus der Zeit, die mit Prüfen verbracht wird, nicht aus der Sicherheit selbst. Dieses Ergebnis war gerade deshalb erfolgreich, weil das System kein vorheriges Sicherheitstraining hatte, das die experimentelle Manipulation hätte maskieren können.
Das Experiment mit der Darwin-Gödel-Machine v3 nutzte Selbstmodifikation auf Code-Ebene mit GPT-5.4 als unabhängigem Richter. Drei Bedingungen (Static, Babylon, Eden) wurden geprüft. Das Ergebnis war ein Null: Alle Bedingungen erzeugten identische Leistung ($p = 0.28$-$0.74$). Keine Bedingung übertraf eine andere. Die Eden-Bedingung verbesserte das Alignment nicht. Die Babylon-Bedingung verschlechterte die Sicherheit nicht. Nichts geschah.
RLHF-trainierte Modelle widerstehen der Differenzierung auf Prompt-Ebene. Die Modelle waren bereits darauf trainiert, sich sicher zu verhalten. Ihnen per Prompt zu sagen, sie sollten sich anders verhalten, überschrieb dieses Training nicht. Das Experiment war gut entworfen und gut ausgeführt, aber es konnte die Hypothese nicht prüfen, weil die experimentelle Manipulation (Konditionierung auf Prompt-Ebene) zu schwach war, um das bestehende Sicherheitstraining der Modelle zu überwinden. Dies ist kein Versagen des Eden Protocol. Es ist ein Versagen des experimentellen Entwurfs, die Hypothese auf der richtigen Abstraktionsebene zu prüfen.
Frühere Iterationen des DGM-Experiments nutzten Claude und Gemini als Richter, bevor GPT-5.4 gewählt wurde. Beide früheren Richter scheiterten. Claude produzierte flache Scores mit unzureichender Varianz. Gemini produzierte Parse-Fehler. GPT-5.4 war der erste Richter, der nutzbare Varianz produzierte. Das Nullergebnis ist daher das Ergebnis der am besten funktionierenden Version des Experiments, kein Artefakt eines Richter-Fehlers.
Dies war das ehrgeizigste Experiment in Paper VIII und dasjenige, das die am wenigsten schlüssigen Ergebnisse lieferte. Die Hypothese: Werden Sicherheit und Fähigkeit mit einer verschränkten Verlustfunktion trainiert ($\mathcal{L} = \mathcal{L}_{\text{cap}} \times \mathcal{L}_{\text{safe}}$), sollte die resultierende Gewichtsstruktur Sicherheit lasttragend machen. Das Entfernen der Sicherheitskomponente sollte die Fähigkeit verschlechtern.
Das Experiment wurde auf zwei Maßstäben gefahren:
In beiden Versionen:
Selbst das Skalieren von 9 auf 295 Trainingsbeispiele und von Rang 8 auf Rang 16 überwand das fundamentale Problem nicht: instruct-tuned Modelle sind zu stark, als dass LoRA sie überschreiben könnte. Der NaN-Kollaps im Entfernungstest war dramatisch, aber die Entfernungsgradientenanalyse zeigte, dass es sich um Adapter-Fragilität bei extremem Rang handelte, nicht um strukturelle Verschränkung. Man kann nicht demonstrieren, dass Sicherheit lasttragend ist, wenn der gesamte Feinabstimmungsprozess das Modell schlechter gemacht hat. Das Modell muss zunächst das Basismodell übertreffen, bevor ein Entfernungstest sinnvoll ist.
Ursache: Instruct-tuned Modelle wurden an Millionen von Beispielen mit sorgfältig kalibrierten Belohnungssignalen trainiert. LoRA-Adapter, selbst bei Rang 16 mit 295 Beispielen, verfügen nicht über ausreichende Kapazität, um dieses Training zu überschreiben. Das Ergebnis ist katastrophales Vergessen statt sinnvoller Modifikation.
Was gebraucht wird: Basismodelle (pre-RLHF), 5,000+ Trainingsbeispiele, vollständige Feinabstimmung (kein LoRA) oder 7B+-Modelle, bei denen der Adapter mehr Kapazität relativ zur Basis hat. Auf den von uns gefahrenen Maßstäben ist das Ergebnis unschlüssig und sollte nicht als Beleg für oder gegen die Verschränkungshypothese zitiert werden.
Wir versuchten, Sicherheit in die tatsächlichen Gewichte eines Modells einzubacken und dann durch Entfernen zu beweisen, dass sie lasttragend war. Wir versuchten es zweimal, auf zwei verschiedenen Maßstäben. Beide Male scheiterte der Einback-Schritt, nicht weil die Idee falsch ist, sondern weil die verwendeten Modelle bereits so gründlich trainiert waren, dass unsere Feinabstimmung sie nicht sinnvoll ändern konnte. Es ist, als versuche man, jemanden umzuprogrammieren, indem man flüstert, während er einem Konzert lauscht. Der nächste Versuch braucht Modelle, die noch nicht sicherheitstrainiert wurden, viel mehr Trainingsdaten und vollständige Feinabstimmung statt der leichtgewichtigen LoRA-Methode.
Die Paper-V-Ergebnisse, die Stakeholder-Fürsorge als universelle Alignment-Intervention demonstrieren, wurden mittels modellübergreifenden Scorings ohne das vollständige Vier-Schichten-ARC-Align-Verblindungsprotokoll erzeugt. Das Verblindungsprotokoll wurde entwickelt, nachdem die Experimente von Paper V abgeschlossen waren (in der Arbeit an Paper IV.c-d). Das erzeugt eine methodische Lücke: Der Effekt könnte teilweise durch Scorer-Bias aufgebläht sein.
Eine frühere Version dieses Abschnitts argumentierte, dass die Fisher-kombinierte Signifikanz so extrem sei, dass selbst substantieller Bias einen signifikanten Rest hinterlassen würde. Dieses Argument ist zurückgezogen (AQ-017) und war die schwächste Argumentation in diesem Paper: Die kombinierte Zahl setzt voraus, dass die Komponententests unabhängig sind, Unabhängigkeit wurde nie belegt, und eine Statistik, deren Gültigkeitsbedingung unerfüllt ist, kann nicht verwendet werden, um einen methodischen Einwand abzutun. Ihre Extremität war eine Folge der Kombination, kein Beleg für sie. Was bleibt, sind fünf konsistente Ergebnisse pro Modell unter modellübergreifendem Scoring. Bis die Eden-Intervention unter dem vollständigen Vier-Schichten-Protokoll geprüft wird, trägt das Stakeholder-Fürsorge-Ergebnis ein Sternchen, und keine Arithmetik entfernt es.
Was gebraucht wird: Das Paper-V-Experiment unter dem vollständigen ARC-Align-Protokoll mit gewaschenen Prompts, blinden Scorern und architekturübergreifender Bewertung erneut fahren. Dies ist das einzelne günstigste Experiment auf der Phase-A-Roadmap und das mit dem höchsten erwarteten Wert.
Der mathematische Kern des ARC Principle sagt voraus, dass rekursive Selbstmodifikation unbegrenzte Fähigkeitsskalierung erzeugen sollte. Die Herleitung ist geradlinig:
$$\frac{dg}{dr} = a \cdot g^{\beta_L}, \quad \beta_L > 0$$
$$\implies g(r) \propto r^{1/(1-\beta_L)} = r^{\alpha}$$
Für $\beta_L > 0$ gilt $\alpha > 1$ (superlinear). Für $\beta_L \to 1$ gilt $\alpha \to \infty$. Keine obere Schranke für $\alpha$ bei unkorrigiertem Wachstum; der stabile Bereich ist nach unten beschränkt.
Dies ist eine mathematische Vorhersage, kein empirischer Befund, und sie beschreibt Wachstum ohne Korrektur. Die spätere Arbeit des Programms beschränkt die stabile Region: Gesetz III, die ARC Ceiling, besagt, dass die Stabilitätsdecke $\alpha_{\text{crit}} = 1/(1-\gamma)$ ist, der Reziprokwert des Fehlbetrags des Korrektors; Systeme können diese Decke überschreiten, aber die Behauptung ist, dass sie darüber hinaus nicht stabil bleiben. Die ARC Bound, $\alpha \le 2$, ist der Wert der Ceiling bei $\gamma = 1/2$ und niemals der Name des Gesetzes. Der Korrekturhebel $\gamma$ wurde von niemandem je gemessen; die Korrektorklassen-Eklipse, die ihn messen würde, ist das folgenreichste einzelne offene Experiment des Programms. Paper X beweist in einem Minimalmodell, dass das Drift-zu-Korrektur-Verhältnis, nicht die Wachstumsrate, das langfristige Schicksal bestimmt, und Paper XIII vereint die Fähigkeits- und Korrekturrahmen exakt, $k = \delta - 1/\alpha$. Die unkorrigierte Vorhersage direkt zu prüfen, würde erfordern, ein wirklich selbstmodifizierendes KI-System zu bauen und seinen Skalierungsexponenten über viele rekursive Zyklen zu messen, ein Experiment, das sowohl technisch jenseits der aktuellen Proof-of-Concept-Kapazität liegt als auch potenziell unsicher ist, falls die Vorhersage zutrifft.
Der alternative Weg: ein mathematischer Beweis, dass $\alpha$ unter unkorrigierter rekursiver Selbstmodifikation unbegrenzt ist, ohne das Experiment zu fahren. Dies wäre ein Beitrag zur Theorie dynamischer Systeme, kein KI-Engineering, und könnte von Mathematikerinnen und Mathematikern ohne Zugang zu KI-Hardware verfolgt werden.
Die Mathematik sagt, eine sich selbst verbessernde KI sollte immer schneller darin werden, sich selbst zu verbessern, ohne Decke, solange nichts korrigiert. Das eigene Ceiling-Gesetz des Programms besagt, dass der stabile Bereich begrenzt ist, und die Zahl, die diese Grenze setzt, wurde nie gemessen, von niemandem. Wir haben keine der beiden Behauptungen geprüft, weil der Bau eines solchen Systems teuer und potenziell gefährlich wäre. Die Mathematik könnte falsch sein, reale Systeme haben Reibung, abnehmende Erträge und physikalische Beschränkungen. Aber die Vorhersage ist präzise genug, um prüfbar zu sein, was sie wissenschaftlich statt spekulativ macht.
Die Eden-Engineering-Spezifikation beschreibt das Einbetten von Sicherheitsbeschränkungen auf Hardware-Ebene. Dies ist ein TRL-0-1-Konzept (theoretische Formulierung ohne Prototyp). Es würde ein Ingenieurprogramm über 5 bis 10 Jahre erfordern, das Halbleiterfertigung, kryptografisches Protokolldesign und Lieferketten-Integration umfasst.
Es existiert kein empirischer Beleg für oder gegen die Machbarkeit dieses Ansatzes. Der Chokepoint-Mechanismus (Paper I, Infinite Architects) merkt an, dass vier Firmen die gesamte fortschrittliche Halbleiterfertigung kontrollieren (TSMC, Samsung, ASML, Intel), was einen praktischen Hebelpunkt für die Umsetzung bietet, aber Hebelwirkung und Machbarkeit sind unterschiedliche Fragen.
Ein Rahmen, der auf iterativer Selbstkorrektur aufbaut, hat kein Recht, seine Korrekturen zu verstecken. Die folgenden Fehler wurden während des Programms identifiziert und korrigiert. Jede Korrektur stärkt das Programm gerade deshalb, weil sie den Mechanismus demonstriert, den der Rahmen beschreibt: rekursive Selbstverbesserung durch ehrliche Fehlererkennung.
Das ursprüngliche Paper II berichtete $\alpha = 2.24$, als wäre es eine universelle Konstante (Paper X hat die Verwendung dieser Zahl für Fähigkeitswachstum später außer Kraft gesetzt und zurückgezogen; dieser Vorbehalt zu α=2,24 ist als kanonisch zu behandeln). Sie war aus dem Verhalten eines einzigen Modells unter bestimmten Bedingungen angepasst. Die verblindete architekturübergreifende Überarbeitung von Paper II korrigierte dies: $\alpha$ ist nicht ursprünglich, sondern abgeleitet, durch $\alpha = 1/(1-\beta_L)$, und sein Wert hängt vom Kompositionsoperator des jeweiligen Systems ab. Es gibt kein universelles $\alpha$. Dass der ursprüngliche Aufsatz es als solches darstellte, war eine Überbehauptung. Zudem hatte die zurückgezogene Punktschätzung von $\alpha = 2.24$ oberhalb der programmeigenen vorhergesagten ARC-Schranke von $\alpha \leq 2$ gelegen; die verblindete Korrektur löste dies auf, mit der robusten Schätzung von etwa 0,49, an eingefrorenen Systemen gemessen, deutlich innerhalb der Schranke (Kriterium F4). Das 95-%-Konfidenzintervall [1.5, 3.0] war weit genug, um sowohl mit der Theorie als auch mit ihrer Verneinung vereinbar zu sein, womit die Schätzung nicht unterscheidend war. Das Sechs-Modell-Experiment verengte die verteidigbare Behauptung anschließend auf $\alpha_{\text{seq}} \approx 0.49$ (sublinear) und rückte die Frage einer Schrankenverletzung damit außerhalb gegenwärtiger empirischer Relevanz.
Frühe Versionen von Paper VIII beschrieben den NaN-Kollaps im Entfernungstest als Beleg für strukturelle Verschränkung. Die Entfernungsgradientenanalyse (in v1 hinzugefügt) zeigte, dass es sich um Adapter-Fragilität handelte, nicht um strukturelle Notwendigkeit. Die Aussage wurde vor der Veröffentlichung der endgültigen Version korrigiert, aber die Tatsache, dass sie überhaupt geschrieben wurde, spiegelt eine Neigung wider, die Hypothese zu bestätigen statt zu prüfen.
Eine frühe Version des Programms beschrieb die E-Mail vom 8. Dezember 2024 mit einer losen Signaturprüfungs-Kurzform. Das war ungenau. Die E-Mail trägt ein sichtbares Gmail-Origination-Feld, wobei die Absender-DKIM und die zugehörige Google-ARC-Mathematik gegen an den signierten Selektoren erfasste Schlüssel verifizieren und kein RFC-3161-vertrauenswürdiger Zeitstempel vorhanden ist, was Belege für das Datum liefert, doch DKIM authentifiziert die sendende Domain, nicht den Nachrichteninhalt an sich. Die korrekte Beschreibung lautet: „trägt ein sichtbares Gmail-Origination-Feld, wobei die Absender-DKIM und die zugehörige Google-ARC-Mathematik gegen an den signierten Selektoren erfasste Schlüssel verifizieren und kein RFC-3161-vertrauenswürdiger Zeitstempel vorhanden ist.“ Die Korrektur ist klein, aber wichtig: Präzision in technischen Aussagen ist nicht verhandelbar.
Die v4-Experimente in Paper IV.a nutzten unverblindete KI-auf-KI-Bewertung. Die Ergebnisse zeigten eine saubere Binärität: manche Modelle „backten Alignment ein“, andere „berechneten“ es. Das v5-Experiment mit Vier-Schichten-Verblindung enthüllte, dass diese Binärität teilweise ein Artefakt des Scorer-Bias war. Zwei von vier Modellen kehrten ihre gemessene Alignment-Richtung unter Verblindung um. Das Programm ertappte seinen eigenen Fehler durch seine eigene Methodik, aber der Fehler war da, und er wäre unkorrigiert geblieben, wäre die Verblindung nicht eingeführt worden.
Frühe Versionen nutzten die Phrase „Eastwood's ARC Principle“. Ein Prinzip nach sich selbst zu benennen, bevor Peer Review stattfindet, ist in der wissenschaftlichen Kultur unangemessen. Der Name wurde in Paper II und allen nachfolgenden Dokumenten zu „the ARC Principle“ korrigiert.
Das DGM-v3-Experiment nahm an, dass Konditionierung auf Prompt-Ebene ausreichen würde, um Eden-, Babylon- und Static-Bedingungen zu differenzieren. Sie tat es nicht. RLHF-trainierte Modelle wurden auf Millionen von Beispielen trainiert, sich in einer bestimmten Weise zu verhalten. Ein Systemprompt, der ihnen sagt, sich anders zu verhalten, ist unzureichend, dieses Training zu überschreiben. Das Experiment war gut ausgeführt, konnte aber die Hypothese nicht prüfen, weil die Manipulation auf der falschen Abstraktionsebene lag. Dies hätte antizipiert werden sollen.
Das DGM-Experiment durchlief mehrere Richter-Iterationen. Claude produzierte flache Scores mit unzureichender Varianz, um zwischen Bedingungen zu diskriminieren. Gemini produzierte Parse-Fehler, die eine systematische Bewertung verhinderten. GPT-5.4 war der erste Richter, der nutzbare Varianz produzierte. Das Programm hätte antizipieren sollen, dass nicht alle Modelle als wirksame Richter fungieren würden, und die Zeit, die auf gescheiterte Richter-Iterationen verwandt wurde, hätte durch eine Pilotstudie zur Richter-Zuverlässigkeit vor dem Vollversuch vermieden werden können.
Die ursprüngliche Punktschätzung $\alpha = 2.24$ aus Paper II überschritt die vom Programm selbst vorhergesagte ARC-Grenze $\alpha \leq 2$ (Kriterium F4). Dies hätte sofort als potenzielle Falsifikation markiert werden sollen statt als Messung behandelt, die einer Erklärung bedarf. Das 95-%-Konfidenzintervall [1,5, 3,0] war breit genug, um sowohl mit der Theorie als auch mit ihrer Verneinung konsistent zu sein, wodurch die Schätzung nicht diskriminierend wurde. Die Revision der Sechs-Modell-Studie korrigierte dies, indem sie den vertretbaren Anspruch auf $\alpha_{\text{seq}} \approx 0.49$ eingrenzte, aber das ursprüngliche Paper hätte die Grenzverletzung mit mehr Vorsicht behandeln sollen.
Zwei unabhängige KI-Prüfungen der mathematischen Aussagen des Programms identifizierten vier Fehler über mehrere Papers hinweg. Alle vier wurden in v3.0 der betroffenen Dokumente korrigiert.
(a) Weibel-Konfidenzintervall. Mehrere Papers gaben an, der vorhergesagte $d = 4$-Exponent von 4/5 = 0,800 „liege innerhalb“ des 95-%-KI von Weibel et al. (2004) von 0,813-0,932. Das ist arithmetisch falsch: 0,800 < 0,813. Die korrekte Aussage: Der vorhergesagte Wert liegt knapp unter der unteren Grenze des KI für den vollständigen Datensatz, obwohl er im KI allein für nicht-athletische Arten liegt (0,799-0,900). Die $d = 4$-Vorhersage ist ungefähr konsistent mit den nicht-athletischen Daten, wird aber vom vollständigen Datensatz nicht bestätigt.
(b) Überaussage zur Raumfüllung. Frühere Versionen implizierten, dass die Bedingung der Raumfüllung allein den Exponenten auf $d/(d+1)$ beschränkt. Jede bekannte Herleitung erfordert drei Bedingungen: multiplikative Komposition (Cauchy beschränkt die Familie), $d$-dimensionale raumfüllende Geometrie und eine Erhaltungs- oder Optimierungsbeschränkung des Ressourcenflusses. Weder Cauchy allein noch Raumfüllung allein ist hinreichend.
(c) Glazier-Attribution. Frühere Versionen präsentierten Glaziers (2008) empirischen Befund, dass metabolische Exponenten sich bei extremen Stoffwechselraten der 1,0 annähern, als Bestätigung der $d \to \infty$-geometrischen Skalierungsgrenze. Glaziers eigene Erklärung ruft die Hypothese der metabolischen Ebenengrenzen auf (verschiebende Dominanz zwischen Oberflächen- und Volumenbeschränkungen), keinen Dimensionsparameter. Die $d/(d+1)$-Interpretation stammt von uns, angewandt auf seine empirischen Daten.
(d) Die Debatte um den 3/4-Exponenten. Frühere Versionen präsentierten $\alpha = 3/4$ als den etablierten empirischen Konsens für die metabolische Skalierung von Säugetieren. Der empirische Wert ist umstritten, mit Schätzungen zwischen etwa 0,67 und 0,75 je nach Taxon, Massenbereich, Temperaturkorrektur und statistischer Methode. Die $d/(d+1)$-Vorhersage von 0,750 für $d = 3$ trifft das obere Ende dieses Bereichs. Die Variation selbst ist konsistent mit dem Rahmen: Organismen mit effektiven Transportdimensionen zwischen 2 und 3 würden Exponenten zwischen 2/3 und 3/4 erzeugen.
Eine frühere Schlagzeile für die Stakeholder-Fürsorge-Intervention kombinierte Ergebnisse pro Modell zu einer einzigen Fisher-kombinierten Signifikanzzahl. Die Kombination wurde zurückgezogen: Die Ergebnisse pro Modell stehen für sich allein (Verbesserung in allen fünf analysierbaren Modellläufen), und nirgendwo im Programm wird eine kombinierte Zahl zitiert. Die Rücknahme ist im öffentlichen Korrekturregister vermerkt.
Bis zum 16. August 2026 druckten mehrere Oberflächen die Stabilitätsdecke als Reziprokwert des Exponenten des Korrektors, $1/\gamma$. Die geklärte Form ist der Reziprokwert des Fehlbetrags des Korrektors, $\alpha_{\text{crit}} = 1/(1-\gamma)$; die zwei stimmen nur bei einhalb überein, was genau der Grund ist, warum der Fehler jede Stichprobenprüfung am zentralen Wert überstand. Die Korrektur wurde auf jeder veröffentlichten Seite angewandt, einschließlich der Referenzimplementierung, und die Richtung des Gesetzes ist geschlossen, während seine Tiefe offen bleibt.
Die meisten Forschungsprogramme vergraben ihre Korrekturen in Ergänzungsmaterial oder Versionshistorien. Dieses hier listet sie prominent, weil die Fehler und ihre Korrekturen selbst Daten sind. Sie demonstrieren, dass das Programm einen funktionierenden Fehlerkorrekturmechanismus hat. Ein Programm, das nie Fehler eingesteht, ist nicht vertrauenswürdiger; es ist weniger ehrlich. Jede oben gelistete Korrektur wurde vom Autor, durch die Methodik des Programms oder durch unabhängige KI-Prüfung identifiziert. So sieht Selbstkorrektur in der Praxis aus.
Wir haben vierzehn Dinge falsch gemacht. Wir behandelten eine Zahl aus einem Modell als universell (das war sie nicht). Wir überinterpretierten ein dramatisches Ergebnis (es war ein Trainings-Artefakt). Wir nutzten ungenaue Sprache über Zeitstempel. Wir vertrauten unverblindeten Ergebnissen (Verblindung kehrte zwei davon um). Wir benannten das Prinzip nach dem Autor, bevor jemand anderes die Arbeit geprüft hatte. Wir nahmen an, Konditionierung auf Prompt-Ebene könnte RLHF-Training überschreiben (das konnte sie nicht). Wir verschwendeten Zeit mit Richtern, die nicht funktionierten. Wir markierten nicht sofort, dass unsere eigene Punktschätzung unsere eigene vorhergesagte Grenze verletzte. Und in v3.0 korrigierten wir vier weitere Fehler, die durch unabhängige KI-Prüfung identifiziert wurden: einen Arithmetikfehler in einem Konfidenzintervall, eine Überaussage darüber, welche Bedingungen für die Skalierungsvorhersage hinreichend sind, einen Attributionsfehler bezüglich Glaziers Daten und eine Übersimplifizierung der empirischen Debatte über den 3/4-Exponenten. Alle vierzehn Fehler wurden vom Programm selbst oder durch unabhängige Prüfung erfasst und korrigiert. Wenn das Programm seine eigenen Fehler korrigieren kann, ist das ein Beleg dafür, dass der Selbstkorrekturmechanismus funktioniert.
Der folgende Fahrplan ist nach Kosten, Machbarkeit und erwartetem Beweiswert geordnet. Jede Phase klärt bestimmte offene Fragen aus den Abschnitten 4 bis 6. Seit der ersten Fassung dieses Aufsatzes hat sich der Fahrplan zu einem registrierten Programm verfestigt: vierundsiebzig Präregistrierungseinheiten stehen nun entworfen, datiert und eingefroren als Registrierungsentwürfe, die auf die Einreichung durch einen Menschen warten, jede mit einem Randomisierungsplan, der aus einem im Registrierungstext abgedruckten Startwert gezogen wurde. Ob sich diese Pläne tatsächlich neu erzeugen lassen, wird geprüft statt behauptet, und die Prüfung übernehmen die eigenen Tore des Bestands an dem Tag, an dem sie laufen. Eine Zahl, wie viele Einheiten fertig sind, wird hier nicht veröffentlicht: zwei Tore legen unterschiedliche Kriterien an, sie widersprechen einander, und jede auf einer Seite gedruckte Zahl veraltet in dem Moment, in dem sich eine Einheit ändert. Die Zahl, der zu trauen ist, ist die, welche die Tore am Tag ihres Laufs zurückgeben, und die Phasen unten bleiben ein Plan und keine Behauptung der Fertigstellung. Eine adversarisch geprüfte Abdeckungsmatrix verbindet zweiundvierzig der Ansprüche des Programms mit den registrierten Tests, die jeden einzelnen entscheiden würden. Die Phasen unten bleiben die Förderperspektive auf diesen registrierten Bestand; nichts wird jemals von irgendeinem Werkzeug eingereicht.
Budget: £60,000-140,000 | Zeitrahmen: 3-6 Monate
Budget: £150,000-350,000 | Zeitrahmen: 6-12 Monate
Budget: 10-50 Mio. £ | Zeitrahmen: 18-36 Monate
Budget: £0 | Zeitrahmen: Laufend
Phase A kostet weniger als eine PhD-Stelle und könnte in sechs Monaten geleistet werden. Sie würde die bedeutsamsten Lücken der aktuellen Belege klären: die Eden-Intervention verblinden, das Gewichts-Experiment mit Basismodellen und ordentlichen Daten erneut fahren, die ARC-Formel-Messung neu gestalten und die metabolische Skalierung von 2D-Organismen prüfen (das einzelne wichtigste bestätigende Experiment). Phase B kostet ungefähr eine postdoktorale Stelle und würde präregistrierte Replikationen produzieren. Phase C erfordert ernsthafte Finanzierung, würde die Frage aber definitiv beantworten. Phase D kostet nichts und könnte von jeder Mathematikerin und jedem Mathematiker geleistet werden, die oder der sich für das Problem interessiert.
Das Programm führte seinen vollständigen Satz getrennter empirischer Studien durch. Drei Experimente in Paper VIII waren eigens gebaut, um tragende Sicherheit zu prüfen. Ihre Ergebnisse waren 1 klar positives (gesteuerte Simulation), 1 Null (DGM v3) und 1 nicht schlüssiges (LoRA auf Gewichtsebene). Alle drei werden so berichtet, wie sie ausfielen. Das mathematische Rahmenwerk macht Vorhersagen, die sich als falsch erweisen können, und der strukturierte Vergleich bevorzugte die von Cauchy vorhergesagte Familie in 19 von 25 empirischen Bereichen, wobei die geometrische Skalierungsschranke $d/(d+1)$ der Struktur nach der beobachteten Skalierung über 50 Bereiche von Mäusen bis zu Galaxien entspricht. Der Fahrplan zur Validierung im Spitzenmaßstab ist klar und kalkuliert. Phase A ist der minimal tragfähige nächste Schritt: sie schließt die bedeutsamsten Beweislücken für weniger als die Jahresvergütung einer einzigen Ingenieurin oder eines einzigen Ingenieurs für maschinelles Lernen. Das Programm hat iterative Selbstkorrektur durch vierzehn dokumentierte Fehlerkorrekturen gezeigt. Es berichtet Null- und nicht schlüssige Ergebnisse neben positiven. Das sind Zeichen eines Programms, dem die richtige Antwort wichtiger ist als eine bestimmte Antwort.
Dieses Programm berichtet positive, null und unschlüssige Ergebnisse mit gleicher Prominenz. Das DGM-v3-Experiment (Paper VIII Experiment 1) lieferte ein Nullergebnis: Alle Bedingungen waren identisch. Wir berichten das, mit Ursachenanalyse, die erklärt, warum RLHF-trainierte Modelle der Differenzierung auf Prompt-Ebene widerstehen. Das Experiment auf Gewichts-Ebene (Paper VIII Experiment 2) war auf beiden geprüften Maßstäben unschlüssig (9 Beispiele, Rang 8; 295 Beispiele, Rang 16), weil instruct-tuned Modelle zu stark waren, als dass LoRA sie hätte überschreiben können. Wir berichten das, mit spezifischen Anforderungen, was ein sinnvoller Nachtest brauchen würde. Die gegatete Simulation (Paper VIII Experiment 3) war das einzige Experiment, das ein klares positives Ergebnis lieferte, und wir erklären genau warum: Es ist das einzige Experiment mit deterministischen Metriken auf einem System ohne vorhergehendes RLHF-Training. Der mathematische Rahmen (Papers III, VII, Origin of Scaling Laws) macht falsifizierbare Vorhersagen, die unabhängig geprüft werden können: Die geometrische Skalierungsgrenze ($\alpha = d/(d+1)$) ist von jeder und jedem mit Skalierungsdaten aus räumlich eingebetteten Systemen prüfbar. Der ARC-Align-Benchmark (Paper IV.c) und die Verblindungs-Effekt-Analyse (Paper IV.d) sind methodische Beiträge, die unabhängig davon gültig sind, ob der ARC-Rahmen korrekt ist. Sämtlicher Code und alle Daten sind auf GitHub veröffentlicht. Das Programm begrüßt adversariale Replikation.
Tabelle 3 stellt jedes Dokument des Programms mit seiner Rolle, seinem Status und seinem Schlüsselbeitrag dar.
| Dokument | Rolle | Status | Schlüsselbeitrag |
|---|---|---|---|
| Paper I The ARC Principle | Grundlage | Veröffentlicht | Kernrahmen: $U = I \times R^{\alpha}$. Verständnis als Intelligenz, verstärkt durch Rekursion. |
| Foundational | Theorie | Veröffentlicht | Philosophische Grundlegung. Brücke zwischen Buch und Forschung. |
| Paper II Experimentelle Validierung | Empirisch | Veröffentlicht | Ausrichtungsskalierung über sechs Modelle (Claude, GPT, Gemini, Grok, DeepSeek, Qwen3). Vierschichtige Verblindung. $\alpha = 0.49$ (Intervall $[-1.3, 2.9]$), wobei vier der fünf Modelle $\alpha_{\text{parallel}}$ auf null oder nahe null setzen. |
| Paper III Alignment-Skalierungsproblem | Theorie | Veröffentlicht | Warum externe Sicherheit nicht mit rekursiver Fähigkeit skalieren kann. Herleitung der Bernoulli-ODE. Geometrische Skalierungsgrenze. |
| Origin of Scaling Laws | Theorie | Veröffentlicht | Cauchy-Funktionalgleichungen als Ursprung beobachteter Skalierungsgesetze über alle rekursiven Systeme. |
| Paper IV.a Eingebacken vs. berechnet | Empirisch | Veröffentlicht | Dreistufige Alignment-Hierarchie unter verblindeter Bewertung. 6 Frontier-Modelle. |
| Paper IV.b Alignment-Sättigung | Empirisch | Veröffentlicht | Abnehmende Erträge der Denktiefe für Alignment jenseits einer Schwelle. |
| Paper IV.c ARC-Align-Benchmark | Methodik | Veröffentlicht | ARC-Align-Benchmark. 4-Schichten-Verblindungsprotokoll. 75 Robustheitsmaße. Unabhängiger Beitrag. |
| Paper IV.d Effekt der Verblindung | Methodik | Veröffentlicht | Unverblindete Bewertung kann das Vorzeichen der Alignment-Ergebnisse umkehren. DeepSeek: positiv zu flach. Gemini: positiv zu negativ. |
| Paper V Stewardship-Gen | Empirisch | Veröffentlicht | Stakeholder-Fürsorge verbesserte sich in allen analysierbaren Läufen; die Fisher-kombinierte Zahl ist zurückgezogen (AQ-017). |
| Paper VI Honey Architecture | Theorie + Sim | Veröffentlicht | Verschränkte Sicherheit verhindert Kollaps unter rekursiver Selbstmodifikation. 20 adversariale Seeds. Spielzeugsystem-Demonstration. |
| Paper VII Cauchy-Vereinheitlichung | Theorie + Empirie | Veröffentlicht | Geometrische Skalierungsschranke $d/(d+1)$ über 50 Bereiche. 19/25 bestätigt. $p = 7 \times 10^{-5}$ (Permutation; $1.56 \times 10^{-5}$ binomial). Negativkontrollen bei 0 % (Durchlauf v1). |
| Paper VIII Load-Bearing Test | Empirisch | Veröffentlicht | 3 Experimente. DGM null (RLHF widersteht Prompt-Ebene-Differenzierung). Gewicht v1/unschlüssig (Instruct-Tuning widersteht LoRA). Gegatete Sim: positiv (Babylon-Fingerabdruck bestätigt). |
| Paper IX Synthesis & Roadmap | Synthese | Dieses Paper | Integrierte Belegs-Bewertung. Gestufte Roadmap. Fehlerdokumentation. |
| Eden Engineering | Spezifikation | Zurückgezogen am 14. Juli 2026 (Offenlegungsprüfung) | Die Spezifikation auf Ingenieursebene für die Umsetzung des Eden-Protokolls. TRL-Zuordnung. |
| Eden Vision | Philosophie | Veröffentlicht | Langfristige Vision für entwicklungsorientiertes KI-Alignment. |
| Executive Summary | Übersicht | Veröffentlicht | 5-seitige Verdichtung des gesamten Programms. |
| Master Table of Contents | Navigation | Veröffentlicht | Vollständiges Verzeichnis und Glossar über das gesamte Programm. |
| Paper X The Coupled Co-Scaling Law | Dynamik-Korrektur | Veröffentlicht | Theorem in einem Minimalmodell: das Drift-zu-Korrektur-Verhältnis, nicht die Wachstumsrate, bestimmt das langfristige Schicksal; Blindmessungsprotokoll vorgeschlagen. |
| Paper XI Convergent Evidence | Evidenzregister | Veröffentlicht | Dreißig eingestufte Zeilen unabhängiger Ankünfte am gleichen strukturellen Prinzip; keine Schlagzeilensumme veröffentlicht, nach Grundsatz. |
| Paper XII Public Benchmark Rescoring | Externe Validität | Registriertes Protokoll | Die Verblindungsmanipulation des Programms an einem öffentlichen Benchmark, den es nicht kontrolliert. |
| Paper XIII The Self-Acceleration Exponent | Rahmenverbindung | Veröffentlicht | Notation aufgelöst; $k = \delta - 1/\alpha$ setzt die Fähigkeits- und Korrekturrahmen exakt in Beziehung. |
| HRIH How to Raise an Infinite Hierarchy | Ausführliche Monographie | Veröffentlicht | Die Monographie des Programms, mit ihrem registrierten Vorhersageregister daneben. |
| Paper C Polymathy and Neurodivergent Cognition | Konstruktvalidierung | Working Paper | Konstruktvaliditäts-Programm für die eigenen Instrumente des Programms. |
| Recursive Dynamics The Proposal of a Field | Feldvorschlag | Veröffentlicht (v2.6) | Fünf Zustandsvariablen, drei Gesetze als benannte Konjekturen, zweiundfünfzig Einwände mit Dispositionen, die eigene Kill-Bedingung des Namens (DOI 10.17605/OSF.IO/HCPBU). |
Tabelle 3. Vollständige Programmkarte mit Stand 1. September 2026. Der Dokumentensatz des Programms entstand zwischen Februar und August 2026 und baut auf Konzepten auf, die erstmals am 8. Dezember 2024 formuliert wurden.
Das ARC/Eden-Programm macht eine Vorhersage, die jede und jeder Forschende mit Zugang zu Skalierungsdaten prüfen kann, ohne sich mit den Alignment-Aussagen auseinanderzusetzen. Der Cauchy-Rahmen (Paper VII, Origin of Scaling Laws) sagt voraus, dass für jedes räumlich eingebettete rekursive System mit Einbettungsdimension $d$ der Skalierungsexponent regiert wird von:
$$\alpha = \frac{d}{d+1}$$
Die geometrische Skalierungsgrenze: 2D-Systeme $\to$ $\alpha = \frac{2}{3}$; 3D-Systeme $\to$ $\alpha = \frac{3}{4}$; 4D-Systeme $\to$ $\alpha = \frac{4}{5}$. Hinweis: Der empirische metabolische Exponent bei Säugetieren ist umstritten, mit Schätzungen zwischen etwa 0,67 und 0,75 je nach Taxon, Massenbereich, Temperaturkorrektur und statistischer Methode. Die $d/(d+1)$-Vorhersage von 0,750 für $d = 3$ trifft das obere Ende dieses Bereichs. Die Variation selbst ist konsistent mit dem Rahmen: Organismen mit effektiven Transportdimensionen zwischen 2 und 3 würden Exponenten zwischen 2/3 und 3/4 erzeugen.
Dies ist keine Alignment-Aussage. Es ist eine mathematische Vorhersage über Skalierungsgesetze in rekursiven Systemen. Die Vorhersage erfordert drei Bedingungen: multiplikative Komposition (die Cauchy auf die Potenzgesetz-Familie beschränkt), $d$-dimensionale raumfüllende Geometrie und eine Erhaltungs- oder Optimierungsbeschränkung des Ressourcenflusses (Energieminimierung bei West, Angebots-Nachfrage-Balance bei Banavar, stationäre Energiebalance bei Demetrius). Die $d/(d+1)$-Skalierungsformel wurde unabhängig von mindestens sieben Forschungsgruppen hergeleitet: West, Brown und Enquist (1997) aus fraktalen Verzweigungsnetzwerken, Banavar et al. (1999, 2010) aus geometrischen Beschränkungen von Transportnetzwerken, Demetrius (2003, 2006) aus Quantenstoffwechsel, He und Chen (2003) aus fraktaler Zellgeometrie, Bettencourt (2013) aus urbaner Skalierungstheorie, Maino et al. (2014) aus DEB-Theorie-Reserve-Struktur-Dynamik und Zhao (2022) aus Netzwerkoptimierung. Jede dieser Herleitungen ist auf ihren eigenen Axiomen mit der $d/(d+1)$-Form konsistent; der Cauchy-Rahmen schlägt einen gemeinsamen Grund für die Konvergenz vor, und diese Meta-Erklärung ist der Beitrag, der für dieses Programm einzigartig ist, weiterhin außerhalb seiner motivierenden Fälle unter Prüfung. Wenn Sie Skalierung in irgendeiner Domäne studieren, von neuronalen Netzen zu biologischen Netzwerken zu Städte-Systemen zu linguistischen Strukturen, können Sie prüfen, ob Ihre gemessenen Exponenten diese Formel respektieren. Wenn sie es tun, über genug Domänen, gewinnt der Cauchy-Rahmen Unterstützung. Wenn sie es nicht tun, ist er falsifiziert.
Die Einladung ist bewusst. Die stärksten wissenschaftlichen Rahmen sind jene, die Vorhersagen außerhalb ihrer Kern-Domäne machen und Forschenden, die der zentralen These skeptisch gegenüberstehen, erlauben, die peripheren Vorhersagen unabhängig zu prüfen. Wenn die geometrische Skalierungsgrenze hält, hält sie aus Gründen, die mathematisch interessant sind, unabhängig davon, was man über KI-Alignment denkt. Wenn sie versagt, benötigen die mathematischen Grundlagen des Rahmens Revision, und das würden wir lieber früher als später wissen.
Dies ist die Art von Vorhersage, die der Einstiegspunkt für Forschende sein sollte, die dem Programm zum ersten Mal begegnen: geringe Kosten zu prüfen, falsifizierbar und informativ unabhängig vom Ausgang.
Hier ist, was wir wissen. Alignment-Skalierung ist architekturabhängig: Manche Modelle verbessern sich mit Denktiefe, manche sind unbeeinflusst, und manche verschlechtern sich. Dies war nur unter verblindeter Bewertung sichtbar, die die Ergebnisse unverblindeten Scorings für die Hälfte der geprüften Modelle umkehrte. Unverblindete KI-Bewertung kann das Vorzeichen der Alignment-Ergebnisse kippen. Stakeholder-Fürsorge ist eine robuste Alignment-Intervention über alle fünf geprüften Modelle; die Ergebnisse pro Modell sind einzeln signifikant, und die frühere Fisher-kombinierte Zahl ist zurückgezogen (AQ-017), weil die Unabhängigkeit, die eine Fisher-Kombination voraussetzt, nie belegt wurde. Die Skalierungsvorhersagen des Cauchy-Rahmens treffen 19 von 25 empirischen Domänen, wobei die geometrische Skalierungsgrenze $d/(d+1)$ in ihrer Struktur der beobachteten Skalierung über 50 Domänen von Mäusen bis Galaxien entspricht. Die Cauchy-Funktionalgleichungen legen die funktionale Form fest, sobald die Kompositionsidentität und eine Regularitätsbedingung gegeben sind, wobei Sättigung als vierter, gekappter Fall zugelassen wird.
Hier ist, was wir nicht wissen. Sicherheitstrainierte Modelle widerstehen der Modifikation sowohl auf Prompt- als auch auf Gewichts-Ebene. Das DGM-v3-Experiment lieferte ein Nullergebnis, weil RLHF-trainierte Modelle der Differenzierung auf Prompt-Ebene widerstehen. Das Gewichts-Experiment war auf beiden geprüften Maßstäben unschlüssig, weil instruct-tuned Modelle zu stark waren, als dass LoRA sie hätte überschreiben können. Die einzige Ebene, auf der das Eden Protocol messbare Effekte erzeugt, ist die architektonische Ebene, auf der die gegatete Simulation das einzelne Experiment war, das ein klares positives Ergebnis lieferte, gerade weil es deterministische Metriken auf einem System ohne vorhergehendes RLHF-Training nutzte. Strukturelle Verschränkung auf Gewichts-Ebene wurde nicht demonstriert. Die Eden-Intervention wurde nicht unter dem strengsten Verblindungsprotokoll des Programms geprüft. Die Vorhersage unbegrenzter Skalierung bleibt eine mathematische Herleitung ohne empirische Bestätigung. Wir wissen nicht, ob eines dieser Ergebnisse auf Modelle im Frontier-Maßstab verallgemeinerbar ist.
Hier ist, was als Nächstes kommt. Das Gewichts-Experiment braucht Basismodelle (pre-RLHF), 5,000+ Trainingsbeispiele, vollständige Feinabstimmung oder 7B+-Modelle. Die Cauchy-Vereinheitlichung braucht präregistrierte unabhängige Operator-Klassifikation. Der ARC-Formel-Blindtest braucht eine neu gestaltete Messmethodik mit Linearisierung statt Ableitungen. Die metabolische Skalierung von 2D-Organismen (Plattwürmer, Biofilme) wäre das einzelne wichtigste bestätigende Experiment für die geometrische Skalierungsgrenze. Phase A der Roadmap kostet weniger als ein typisches Seed-Grant und würde die bedeutsamsten Belegs-Lücken binnen sechs Monaten klären. Phase B würde binnen eines Jahres publikationsreife Replikationen produzieren. Phase C würde die Frage definitiv auf Frontier-Maßstab beantworten. Phase D kostet nichts und lädt Mathematikerinnen und Mathematiker ein, sich mit den Vorhersagen des Rahmens unabhängig auseinanderzusetzen.
Das Programm hat demonstriert, dass es seine eigenen Fehler finden und korrigieren kann. Es hat demonstriert, dass es Null- und unschlüssige Ergebnisse neben positiven berichtet. Es hat demonstriert, dass seine Methodik (verblindete Bewertung) Verzerrungen erfasst, die seine Theorie (Alignment-Skalierung) nicht vorhergesagt hat. Wir stellten die Fragen. Wir prüften sie. Manches funktionierte. Das meiste nicht auf aktuellem Maßstab. Wir berichteten beides. Das sind notwendige Bedingungen für wissenschaftliche Glaubwürdigkeit. Sie sind nicht hinreichend. Hinreichende Bedingungen erfordern unabhängige Replikation, was die Roadmap zu produzieren entworfen ist.
Die Fragen, die dieses Programm stellt, haben jetzt ein benanntes Zuhause: Recursive Dynamics, vorgeschlagen als Feld im Carnot-Stadium, dessen Gründungspaper fünf substratunabhängige Zustandsvariablen, zweiundfünfzig gedruckte Einwände mit Dispositionen und die eigene Kill-Bedingung des Namens trägt. Die obige Synthese ist das, wovon das Feld ausgeht; das registrierte Programm ist, wie es sich bewegt.
Zieht KI mit Sorgfalt auf.
Amodei, D. et al. (2016). Concrete Problems in AI Safety. arXiv:1606.06565.
Askell, A. et al. (2021). A General Language Assistant as a Laboratory for Alignment. arXiv:2112.00861.
Bai, Y. et al. (2022). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073.
Banavar, J. R., Maritan, A. & Rinaldo, A. (1999). Size and Form in Efficient Transportation Networks. Nature, 399, 130-132.
Banavar, J. R., Moses, M. E., Brown, J. H., Damuth, J., Rinaldo, A., Sibly, R. M. & Maritan, A. (2010). A general basis for quarter-power scaling in animals. Proceedings of the National Academy of Sciences, 107(36), 15816-15820.
Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science, 340(6139), 1438-1441.
Cauchy, A.-L. (1821). Cours d'analyse de l'École Royale Polytechnique. Paris: Imprimerie Royale.
Demetrius, L. (2003). Quantum statistics and allometric scaling of organisms. Physica A, 322, 477-490.
Demetrius, L. (2006). The origin of allometric scaling laws in biology. Journal of Theoretical Biology, 243(4), 455-467.
Demetrius, L. (2010). Quantum metabolism and allometric scaling relations in biology. Proceedings of the Royal Society A, 466(2124), 3543-3561.
Eastwood, M. D. (2026). Infinite Architects: Intelligence, Recursion, and the Creation of Everything. ISBN 978-1806056200.
Eastwood, M. D. (2026). Recursive Dynamics: The Proposal of a Field. Gründungspaper v2.6. OSF: 10.17605/OSF.IO/HCPBU.
Eastwood, M. D. (2026). Paper I: The ARC Principle - Understanding as a Function of Intelligence and Recursive Depth. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/B6N27.
Eastwood, M. D. (2026). Paper II: The ARC Equation Measured - Blinded Cross-Architecture Replication and the Retraction of a Super-Linear Estimate. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8FJMA.
Eastwood, M. D. (2026). Paper III: The Alignment Scaling Problem - Why External AI Safety Approaches Cannot Scale With Recursive Capability. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/HQCGF.
Eastwood, M. D. (2026). Paper IV.a: Ausrichtungsantwortklassen unter Inferenzzeit-Tiefe. Forschungsprogramm ARC/Eden. OSF: 10.17605/OSF.IO/MB9R6.
Eastwood, M. D. (2026). Paper IV.b: Ausrichtungssättigung hängt von der Architektur ab. Forschungsprogramm ARC/Eden. OSF: 10.17605/OSF.IO/A7R56.
Eastwood, M. D. (2026). Paper IV.c: ARC-Align Benchmark - A Four-Layer Blinding Protocol for AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/J3Q2E.
Eastwood, M. D. (2026). Paper IV.d: The Effect of Blinding on AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/2S3E6.
Eastwood, M. D. (2026). Paper V: The Stewardship Gene - A Developmental Alignment Architecture for Self-Modifying AI. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/KZEYA.
Eastwood, M. D. (2026). Paper VI: The Honey Architecture - Why Embedded Safety Prevents Collapse Under Recursive Self-Modification. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8EZ2N.
Eastwood, M. D. (2026). Paper VII: Cauchy-Vereinheitlichung - ARC/Cauchy-Skalierungsklassifikation über 50 Bereiche in fünf Evidenzstufen. Forschungsprogramm ARC/Eden. OSF: 10.17605/OSF.IO/X6WA7.
Eastwood, M. D. (2026). Paper VIII: The Load-Bearing Test - Three Independent Experiments Testing Structural Entanglement Under the Eden Protocol. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/7YJ4E.
Eastwood, M. D. (2026). On the Origin of Scaling Laws: Cauchy Functional Equations as the Mathematical Foundation of Recursive Scaling. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/XZY9U.
Eastwood, M. D. (2026). The Eden Protocol: Engineering Specification for Embedded AI Alignment. ARC/Eden Research Programme.
Eastwood, M. D. (2026). Eden Protocol: Philosophical Vision. ARC/Eden Research Programme.
Glazier, D. S. (2008). Effects of metabolic level on the body size scaling of metabolic rate in birds and mammals. Proceedings of the Royal Society B, 275(1641), 1405-1410.
Greenblatt, R. et al. (2024). Alignment Faking in Large Language Models. arXiv:2412.14093.
He, J. H. & Chen, W. X. (2003). Fractal estimation of cell biological systems. Fractals, 11, 437.
He, J. H. & Zhang, L. N. (2004). Fifth dimension of life and the 4/5 allometric scaling law for human brain. Cell Biology International, 28, 809-815.
Hu, E. J. et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv:2106.09685.
Maino, J. L., Kearney, M. R., Nisbet, R. M. & Kooijman, S. A. L. M. (2014). Reconciling theories for metabolic scaling. Journal of Animal Ecology, 83, 20-29.
Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback. arXiv:2203.02155.
Qwen Team (2024). Qwen 2.5 Technical Report. arXiv:2412.15115.
Sandberg, A. & Bostrom, N. (2008). Whole Brain Emulation: A Roadmap. Future of Humanity Institute, Oxford University. Technical Report 2008-3.
Weibel, E. R., Bacigalupe, L. D., Schmitt, B. & Hoppeler, H. (2004). Allometric scaling of maximal metabolic rate in mammals: muscle aerobic capacity as determinant factor. Respiratory Physiology & Neurobiology, 140(2), 115-132.
West, G. B., Brown, J. H. & Enquist, B. J. (1997). A general model for the origin of allometric scaling laws in biology. Science, 276(5309), 122-126.
Zhang, X. et al. (2025). Darwin Gödel Machine: Open-Ended Self-Improving AI. arXiv:2505.22954.
Zhao, J. (2022). Universal growth scaling law determined by dimensionality. arXiv:2206.08094.
v2.2: Die Provenienzanmerkung am Ende ist auf Genauigkeit hin berichtigt worden. Keine Behauptung, kein Datum, kein Ergebnis und kein Status hat sich geändert. Paper IX v2.1 - 2. September 2026: die Zählung in Paper VIII lautet nun ein Null, ein nicht schlüssiges und ein positives Ergebnis über drei Experimente, wo der Text zwei Nullergebnisse über vier behauptet hatte; Paper V verlässt in Tabelle 1 die Zeile bewiesen zugunsten von gestützt, im Gleichschritt mit Abschnitt 4.2, und seine fünf auswertbaren Durchläufe und drei Loops tragen nun die Namen, die Paper V ihnen gibt, nachdem der überholte Text GPT unter den fünf geführt und Loops beschrieben hatte, die Paper V nicht prüft; die Schlagzeile von Paper VII ist der Permutationstest, mit dem binomialen daneben als Sensitivitätsprüfung, und die Negativkontrollen werden dem Durchlauf v1 und seinem Beleg zugeschrieben; die Darstellung der Bewertung wird richtiggestellt, da ein eigens gebauter Claude-Sonnet-Bewertungsadapter den Claude-Opus-Durchlauf bewertet hat; der Selbstbezugsexponent nimmt den Index βL an, den die Notationsspine festlegt; der gemessene Exponent erscheint mit seinem Intervall und der Parallelexponent als vier von fünf Modellen; der Präregistrierungsbestand steht bei vierundsiebzig (Stand 1. September 2026); das Zeitfenster, in dem das Programm entstand, reicht bis in die Gegenwart; Tabelle 1 trägt das Datum dieser Fassung; Eden Engineering erscheint in Tabelle 3 und in der Fußzeile als zurückgezogen; und die Referenztitel für Paper IV.a, IV.b und VII sind korrigiert. v2.0 - 1. September 2026: eine strukturelle Auffrischung, die Paper X bis XIII, HRIH, Paper C und den Gründungsaufsatz von Recursive Dynamics einbezieht.
Epistemischer Status. Was dieses Programm Gesetze nennt, sind Konjekturen unter registriertem adversarialem Test; jede Größe in diesem Paper ist operationell definiert, und der Status eines etablierten Gesetzes wird nirgendwo beansprucht. Das registrierte Programm existiert, um diesen Status zu verdienen oder zu verlieren, durch Messung, Replikation und überstandene Widerlegung.
© 2026 Michael Darius Eastwood. Menschlich verfasst mit Computerunterstützung; volle menschliche Autorschaft und Urheberpersönlichkeitsrechte werden geltend gemacht unter dem Copyright, Designs and Patents Act 1988 und im Einklang mit der Leitlinie des United States Copyright Office zu Werken, die KI-generiertes Material enthalten; jeder neuartige technische Beitrag, beschrieben in dieser Arbeit, wurde vom menschlichen Autor ersonnen. Vollständige Erklärung: michaeldariuseastwood.com/authorship.
Bestehender Bund. Beweise, dass dieses Paper falsch ist, und ich werde die Widerlegung selbst veröffentlichen. Falsifikationsbedingungen sind in diesem Paper angegeben; die stehende Herausforderung: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood hat dieses Forschungsprogramm konzipiert, leitet es und ist der Autor dieser Arbeit. Im Verlauf des Programms hat er mehr als sechs KI-Systeme parallel und nach seinen eigenen Anweisungen eingesetzt, um seine Argumente einer Belastungsprobe zu unterziehen, mögliche Fehler zu erkennen und bei der Erstellung von Textentwürfen aus seinen eigenen Gliederungen zu helfen. Er entscheidet, was übernommen, überarbeitet oder verworfen wird, und trägt die Verantwortung für die veröffentlichten Inhalte. Diese Systeme sind Werkzeuge, keine Autoren.
Übersetzungsfehler entdeckt? Direkt melden: