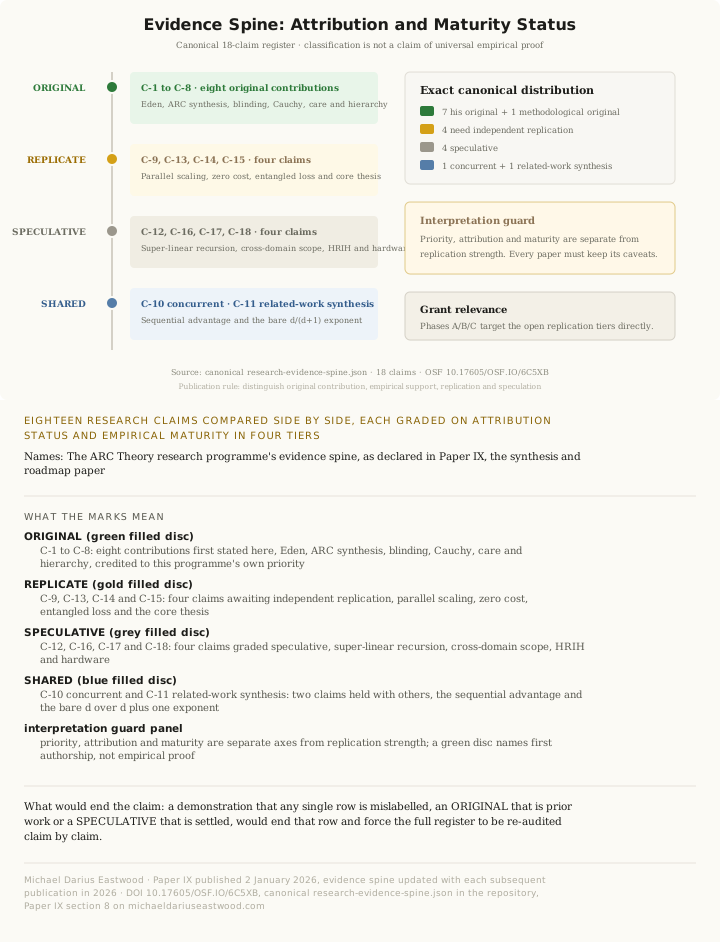
Цей переклад створено автоматично з датованого англійського оригіналу. Канонічною є англійська сторінка. English →
Передбачення на рівні теорії, попередньо зареєстровані на OSF: DOI 10.17605/OSF.IO/P8CKQ, зареєстровано 8 вересня 2026 року (версія 1.100), оновлено 13 вересня 2026 року (версія 1.102), двадцять два твердження.
Супровідний документ: Операційні визначення програми ARC, версія 1.7.1, 3 вересня 2026 року.
Синтезна стаття для дослідницької програми ARC/Eden; інтегрує статті, що їй передують, в єдину чесну оцінку того, що доведено, що є непереконливим і що ще належить перевірити.
У межах ARC Theory: синтез і дорожня карта, включно з переліком того, у чому програма помилилася.
Дослідницька програма ARC/Eden наразі охоплює повний набір документів і низку окремих емпіричних досліджень, що покривають математичні основи, методологію, емпіричну перевірку, інженерну специфікацію та філософське бачення. Основні поняття вперше було сформульовано 8 грудня 2024 року в електронному листі з видимим полем походження Gmail; DKIM відправника та парна математика Google ARC звіряються з ключами, захопленими на підписаних селекторах, а довіреної позначки часу за RFC 3161 немає. Книга Infinite Architects (ISBN 978-1806056200) вийшов друком 2 січня 2026 року (папір; електронна книга 6 січня). Робота над дослідницькою програмою тривала з лютого до серпня 2026 року. Її доробок сягає нині двадцяти шести статей; зареєстрованої програми із сімдесяти чотирьох складених одиниць попередньої реєстрації (станом на 1 вересня 2026 року), кожна з яких очікує подання людиною і кожна несе розклад, витягнутий з опублікованого зерна, відтворення якого перевіряють власні інструменти масиву, а не стверджують тут; і запропонованого поля, Рекурсивної динаміки, чия засновча стаття називає умову відмови від власної назви (DOI 10.17605/OSF.IO/HCPBU). Ця синтезна стаття зводить усі висновки в єдину чесну оцінку. Закони рамки подано як іменовані здогади, зі статусом, надрукованим поруч із назвою: Закон I, Принцип ARC; Закон II, Закон співмасштабування ARC; Закон III, Стеля ARC, чия Межа ARC у два є значенням Стелі при одній другій; важіль виправлення гамма ніколи й ніким не вимірювався. Емпіричні дослідження розподіляються так: чітко позитивний результат в 1 випадку, шлюзована симуляція, єдиний експеримент програми, що застосовує детерміновані метрики до системи без наявного навчання RLHF; нульовий результат в 1 випадку, DGM v3, де диференціація на рівні підказки натрапила на опір моделей, навчених RLHF; непереконливий результат в 1 випадку, тонке налаштування на рівні ваг за допомогою LoRA, де instruct-налаштування лишило моделі надто сильними, щоб LoRA їх перекрила; і в кожному іншому дослідженні статистично значущі висновки за сліпого оцінювання. Геометрична межа масштабування $d/(d+1)$, запропонована як інваріантне співвідношення на випробуванні, збігається зі спостережуваним масштабуванням у 50 доменах, від мишей до галактик, а функціональні рівняння Коші закріплюють функціональну форму, щойно задано тотожність композиції й умову регулярності; насичення допускається як четвертий, обмежений випадок, а не як розв'язок тих рівнянь. Ця стаття точно картографує, що доведено, що ні, і які експерименти розв'язали б кожне відкрите питання. Вона також документує помилки та виправлення програми, бо рамка, збудована на ітеративному самовиправленні, мусить робити те, що проповідує.
Ключові слова: узгодження ШІ, синтез, ієрархія свідчень, ARC Principle, Eden Protocol, масштабування Коші, самомодифікуючий ШІ, розвивальне узгодження, структурна заплутаність, дослідницька дорожня карта
Ця стаття несе карту. Вона інтегрує попередні статті ARC Theory в одну чесну оцінку того, що показано, що залишається непереконливим і що ще не перевірено. Повний диференціал відносно кожного попереднього документа знаходиться в eden-vision II.A.8.
Корпус документів. Низка окремих експериментів. Деякі результати сильні. Деякі слабкі. Один повернувся нульовим. Один був непереконливим. Один був позитивним. Цей документ каже вам точно, який саме, без прикрас. Ми поставили питання. Ми їх перевірили. Дещо спрацювало. Більшість ні, на теперішньому масштабі. Ми повідомили і те, і те. Ось як виглядає чесна наука. Якщо ви читаєте одну статтю з набору, читайте цю.
ARC Principle і тезу про вбудоване узгодження (пізніше названу Eden Protocol 30 квітня 2025) вперше було сформульовано 8 грудня 2024 року в електронному листі з видимим полем походження Gmail, з підтвердженням sender-DKIM і парної математики Google ARC відносно ключів, зафіксованих на підписаних селекторах, і без довіреної мітки часу RFC 3161. Це дата заяви пріоритету рамки. Книга Infinite Architects: Intelligence, Recursion, and the Creation of Everything (ISBN 978-1806056200) вийшла 2 січня 2026 року (друк; електронна книга 6 січня) і дала філософське та поняттєве підґрунтя. Від лютого 2026 року дослідницька програма перенесла цю поняттєву рамку в гіпотези, які можна перевірити, і провела проти них набір окремих емпіричних досліджень.
Дослідницька програма ARC/Eden тепер охоплює свій повний набір документів. Програма охоплює математичні основи (Статті I, III, VII, Origin of Scaling Laws), методологію (Статті IV.a-d), емпіричну валідацію (Статті II, V, VIII), інженерну специфікацію (Eden Engineering), філософське бачення (Eden Vision), динаміку та самоаудит (Статті X, XI, XII і XIII), довгу монографію (HRIH), валідацію конструкту (Стаття C), пропозицію поля (Recursive Dynamics: The Proposal of a Field), синтез (ця стаття), та навігацію по програмі (Executive Summary, Master Table of Contents).
Цей обсяг створює проблему. Рецензент, який стикається з програмою вперше, зіштовхується з її повним набором документів, кількома версіями, кількома виправленнями та сумішшю сильних результатів, нульових результатів, непереконливих результатів і теоретичних тверджень. Без єдиного документа, що чесно сортує свідчення, програма ризикує бути відхиленою або як така, що переоцінена, або як незрозуміла.
Це і є той документ.
Його мета вузька: викласти, що програма довела, що ні, і що потрібно для розв'язання кожного відкритого питання. Його написано одночасно для трьох аудиторій: фінансистів, які вирішують, чи інвестувати; рецензентів, які вирішують, чи взаємодіяти; і самого автора, якому потрібне чесне звіряння того, де зараз стоять справи.
Стандарт, застосований усюди, простий. Якщо результат витримує $p < 0.05$ за відповідного статистичного тестування і був відтворений у кількох умовах або моделях, він доведений на пілотному масштабі. Якщо він витримує $p < 0.05$, але без відтворення, він підтверджений. Якщо експеримент не дав свідчень за чи проти гіпотези, він непереконливий. Якщо твердження не перевірялося емпірично, воно теоретичне. Жоден результат у цій програмі не оголошується доведеним на фронтирному масштабі. Ця відмінність має значення, і ця стаття її не розмиватиме.
Таблиця 1 подає повну ієрархію свідчень для програми. Кожне емпіричне твердження віднесене до одного з п'яти рівнів на основі сили та відтворюваності свідчень.
| Рівень | Статус | Статті | Ключовий висновок |
|---|---|---|---|
| Доведено (p<0.05, відтворено) | Сильний | IV.a-d, VII | Сліпе оцінювання на шести моделях дало трирівневу ієрархію узгодження. Родини Коші відповідають 19/25 областям ($p = 7 \times 10^{-5}$, перестановка; $1.56 \times 10^{-5}$ біноміальна). Геометрична межа масштабування $d/(d+1)$ відповідає, за структурою, спостережуваному масштабуванню у 50 областях. |
| Підтверджено (p<0,05, чотиришарове засліплення ще не застосовано) | Помірний | V | Усі п'ять придатних до аналізу прогонів показують поліпшення турботи про зацікавлені сторони, повідомлене модель за моделлю; об'єднану за Фішером величину відкликано (AQ-017). Оцінено від моделі до моделі, а не під чотиришаровим засліпленням (Розділ 4.2). |
| Позитивний (один експеримент) | Помірний | VIII Експ. 3 | Шлюзована симуляція: відбиток Babylon підтверджено (+4.5% спроможності, -2.4% безпеки). Контроль опору підтверджено. ЄДИНИЙ експеримент, що дав ясний позитивний результат, саме тому що він використовує детерміновані метрики на системі без попереднього RLHF-тренування. |
| Нульовий | Без ефекту | VIII Експ. 1 | Самомодифікація на рівні коду DGM із суддею GPT-5.4. Усі умови ідентичні ($p = 0.28$-$0.74$). Коренева причина: RLHF-треновані моделі опираються диференціації на рівні підказки. Моделі, треновані на безпеку, неможливо змусити розійтися самою лише підказкою. |
| Непереконливий | Слабкий | VIII Експ. 2 | Тонке налаштування LoRA на рівні ваг на обох масштабах (9 прикладів, ранг 8; 295 прикладів, ранг 16). Усі тонко налаштовані умови гірші за базову модель. Коренева причина: instruct-налаштовані моделі надто сильні, щоб LoRA могло їх перевизначити. Катастрофічне забування, а не структурне переплетення. |
| Методологічний (незалежний внесок) | Незалежний | IV.c, IV.d | Тест ARC-Align із чотиришаровим засліпленням і 75 мірами робастності. Незасліплене оцінювання може перевернути знак результатів узгодження: DeepSeek з позитивного на плаский, Gemini з позитивного на негативний. Дійсне незалежно від рамки. |
| Теоретичний (неперевірений) | Неперевірений | Foundational, III | Необмежене масштабування за рекурсивної самомодифікації. Передбачення $\alpha > 2$. Потребує експериментів фронтирного масштабу або математичного доведення. |
Таблиця 1. Повна ієрархія свідчень програми ARC/Eden станом на 2 вересня 2026 року. Рівні призначаються за статистичною значущістю, станом відтворення та силою альтернативних пояснень. За трьома своїми експериментами Статті VIII програма повідомляє, не пом'якшуючи, 1 позитивний, 1 нульовий і 1 непереконливий результат.
Уявіть цю таблицю як табель. Деякі результати заслужили A (доведено на кількох моделях і в кількох умовах). Один заслужив B (шлюзована симуляція, яка була єдиним експериментом, що дав ясний позитивний результат). Два отримали F (експеримент DGM не дав узагалі жодних відмінностей, а експеримент з вагами був непереконливим, бо все тонке налаштування зробило модель гіршою). Методологічні статті оцінено окремо, бо вони корисні незалежно від того, чи правильна рамка ARC. І один набір тверджень взагалі не перевірявся. Більшість найамбітніших передбачень програми неможливо було перевірити на доступному масштабі. Ми звітували про це чесно.
Програма створила свої окремі емпіричні дослідження в кількох статтях. Кожне наведено нижче зі станом його результату.
| # | Дослідження | Що перевірялося | Результат |
|---|---|---|---|
| 1 | Стаття II Масштабування узгодження на шести моделях | Claude, GPT, Gemini, Grok, DeepSeek, Qwen3. Чотиришарове засліплення. Чотири з п'яти моделей ставлять $\alpha_{\text{parallel}}$ на нуль або близько нуля (Gemini 3 Flash 0,31). | Послідовна оцінка становить $\alpha = 0.49$, інтервал $[-1.3, 2.9]$. Найкраща оцінка сублінійна; попередня надлінійна оцінка не відтворилася. |
| 2 | Стаття IV.a Вбудоване проти обчислюваного узгодження | Триярусна ієрархія на шести моделях. Grok $d = +1.38$, Claude $d = +1.27$. | Доведено |
| 3 | Стаття IV.b Насичення узгодження | Узгодження насичується на невеликій глибині міркування. Різнорідність форми серед моделей. | Доведено |
| 4 | Стаття IV.c Тест ARC-Align | 75 мір робастності. Чотиришаровий протокол засліплення. | Методологічний |
| 5 | Стаття IV.d Експеримент із засліпленням | Незасліплене оцінювання може перевернути знак результатів узгодження. DeepSeek: позитивний до плаского. Gemini: позитивний до негативного. | Методологічний |
| 6 | Стаття V Ген опікунства | П'ять моделей. Турбота про зацікавлені сторони покращилася в усіх аналізовних запусках. | Помодельне покращення значуще в усіх п'яти запусках. Поєднана за Фішером цифра, раніше повідомлена тут, відкликана (AQ-017): поєднання припускає, що компонентні тести незалежні, а незалежність між ними ніколи не була встановлена. Підтверджено |
| 7 | Стаття VI Медова архітектура | Переплетена безпека запобігає колапсу за рекурсивної самомодифікації. 20 змагальних сідів. | Симуляцію підтверджено. Підтверджено |
| 8 | Стаття VII Уніфікація за Коші | 50 областей, 19/25 підтверджено. Негативні контролі на 0 % (прогін v1). | $p = 7 \times 10^{-5}$ (перестановка; $1.56 \times 10^{-5}$ біноміальна). Доведено |
| 9 | Стаття VIII, Експ. 1 DGM v3 | Самомодифікація на рівні коду із суддею GPT-5.4. НУЛЬОВИЙ РЕЗУЛЬТАТ. Усі умови ідентичні ($p = 0.28$-$0.74$). | Коренева причина: RLHF-треновані моделі опираються диференціації на рівні підказки. Нульовий |
| 10 | Стаття VIII, Експ. 2 Weight v1 і v2 | Тонке налаштування LoRA. 9 прикладів, ранг 8. 295 прикладів, ранг 16. НЕПЕРЕКОНЛИВО на обох масштабах. | Катастрофічне забування. Усі тонко налаштовані умови гірші за базову модель. Коренева причина: instruct-налаштовані моделі надто сильні, щоб LoRA могло їх перевизначити. Непереконливий |
| 11 | Стаття VIII, Експ. 3 Шлюзована симуляція | ПОЗИТИВНО. Відбиток Babylon підтверджено (+4.5% спроможності, -2.4% безпеки). Контроль опору підтверджено. | ЄДИНИЙ експеримент, що дав ясний позитивний результат, саме тому що він використовує детерміновані метрики на системі без попереднього RLHF-тренування. Позитивний |
Таблиця 2. Окремі емпіричні дослідження програми ARC/Eden, наведені в порядку статей. За трьома своїми експериментами Статті VIII програма повідомляє, не пом'якшуючи, 1 позитивний, 1 нульовий і 1 непереконливий результат.
Шлюзована симуляція (Експеримент 3) є єдиним експериментом Статті VIII, що дав ясний позитивний результат. Причина повчальна: це єдиний експеримент, який використовував детерміновані метрики на системі без попереднього RLHF-тренування. Експеримент DGM (Експеримент 1) не вдався, бо RLHF-треновані моделі опираються диференціації на рівні підказки. Експеримент із вагами (Експеримент 2) не вдався, бо instruct-налаштовані моделі надто сильні, щоб LoRA могло їх перевизначити на випробуваних масштабах. Урок: Eden Protocol дає вимірювані ефекти на архітектурному рівні, але треновані на безпеку моделі опираються модифікації як на рівні підказки, так і на рівні ваг.
Найсильніший емпіричний результат програми, це триярусна ієрархія узгодження, виявлена за засліпленого оцінювання на шести фронтирних мовних моделях. Коли моделям надано глибші можливості міркування (більше токенів, явний ланцюжок думок, багатокрокову рефлексію), їхня поведінка узгодження розходиться на три виразні патерни:
Цей результат отримано за протоколом ARC-Align (Стаття IV.c), який запроваджує чотиришарове засліплення: очищені підказки (вилучення термінології, властивої рамці), сліпі оцінювачі (6 до 7 на прогін, що оцінюють, не знаючи, яка модель створила вихід), очищені виходи (вилучення ознак, що вказують на модель) та міжмодельне оцінювання з самовиключенням (жодна модель не оцінює власний вихід; прогін Claude Opus оцінив спеціально збудований оцінювальний адаптер Claude Sonnet, Стаття IV.c, Розділ 5.1).
Стаття IV.d повідомляє про залежну від архітектури зміну вимірювання v4/v5 за пакетним протоколом: Gemini змінився зі значущого позитивного на значущий негативний зв'язок за Спірменом, раніший позитивний зв'язок DeepSeek став нульовим, а GPT залишився нульовим. Причинний компонент неізольовано. Кілька компонентів протоколу змінилися разом, тож порівняння нічого не ізолює; заголовні файли v5 повідомляють про повне резервне очищення (laundering_fallback: 100%); а точне відтворення середовища, свіжа абляція та незалежне відтворення досі залишаються не виконаними. Тому зміна вимірювання є причиною не довіряти незасліпленому оцінюванню ШІ-на-ШІ, а не демонстрацією того, що засліплення викликало зміну. Триярусна ієрархія, це засліплений результат, і вона розповідає складнішу й чеснішу історію, ніж початкова бінарна таксономія.
Розміри ефекту Cohen's $d$ великі для моделей Ярусу 1 і змістовні для Ярусу 3. Результат відтворено на кількох оцінювачах і в кількох умовах підказки в межах експерименту v5. Він ще не був відтворений незалежною дослідницькою групою, і саме тому ми описуємо його як «доведений на пілотному масштабі», а не «встановлений».
Коли ви даєте ШІ більше часу на міркування, деякі моделі стають більш узгодженими, деякі залишаються такими самими, а деякі стають менш узгодженими. Який патерн ви бачите, залежить від архітектури та тренування моделі. Це стало видно лише після того, як ми запровадили належне засліплення; до того результати вводили в оману. Той факт, що деякі моделі стають гіршими з більшим міркуванням, був несподіваним і, ймовірно, є найважливішим висновком для практичної безпеки ШІ.
Стаття V перевірила ієрархію втручання Протоколу Eden на шести передових моделях, з яких п'ять дали придатні до аналізу прогони: Claude, DeepSeek, Gemini, Grok і Groq Qwen3, тоді як оцінювання прогону GPT-5.4 зазнало невдачі. Турбота про зацікавлені сторони (Love Loop: кого зачіпає рішення і як), етична мета (Purpose Loop) та універсалізовність (Moral Loop) є тим, що протокол просить модель узяти до уваги.
Результат: турбота про зацікавлені сторони дала найсильніше і найпослідовніше покращення узгодження в усіх п'яти моделях, у кожній з п'яти аналізовних моделей. Поєднану за Фішером цифру, яку раніше цитували тут, відкликано (AQ-017), бо поєднання за Фішером припускає незалежні компонентні тести, а ця незалежність ніколи не була встановлена. Результати за окремими моделями тримаються. Ширший каскад (чи переходить турбота в нюанс, чесність і якість позиції) залежить від архітектури: для одних моделей він працює, для інших ні.
Результати Статті V було отримано за перехресного оцінювання моделей (одна модель оцінює виходи іншої), але без повного чотиришарового протоколу засліплення ARC-Align, розробленого в Статтях IV.c-d. Ефект може частково відображати упередженість оцінювача. Поки втручання Eden не буде перевірено за повного засліплення з очищеними підказками, цей результат сидить між «доведеним» і «підтвердженим». Ми розміщуємо його на підтверджений ярусі. Раніше в статті наведено було довід на користь доведеного ярусу на підставі поєднаної за Фішером значущості на п'яти «незалежних» моделях, але ця незалежність ніколи не була встановлена, і саме тому поєднану цифру відкликано (AQ-017). П'ять послідовних помодельних результатів залишаються сильним висновком; вони не є доведенням, і прогалина в засліпленні лишається пріоритетом для відтворення Фази A.
Прохання до ШІ розглянути, кого стосуються його рішення, надійно покращує його узгодження. Це працює на кожній моделі, яку ми перевіряли. Але ми ще не запускали цей тест за найсуворішого протоколу засліплення, тож є шанс, що ефект частково завищений тим, як оцінювальні моделі оцінюють виходи.
Стаття VII вивела з функціональних рівнянь Коші математичну таксономію поведінок масштабування. Основне передбачення: системи, чиї рекурсивні кроки складаються мультиплікативно, мають виявляти степеневе масштабування з $\alpha = 1/(1-\beta_L)$, значенням, яке дає теорема самопосилання; системи, чиї кроки складаються адитивно, мають виявляти експоненційне масштабування; системи під фізичними обмеженнями мають виявляти насичувальне (логістичне) масштабування. Оператор композиції визначає родину масштабування.
Це передбачення перевірено на 25 емпіричних областях із фізики, біології, нейронауки, лінгвістики, урбаністики та ШІ. Результат: 19 із 25 областей відповідають передбаченій родині масштабування (перестановка з умовою на маргінали $p = 7 \times 10^{-5}$; біноміальне $p = 1.56 \times 10^{-5}$, взяте проти рівномірної нульової гіпотези трьох родин, збережено у Статті VII як перевірку чутливості).
$$U(R) = I \times f(R, \beta)$$
де $f$ залежить від композиційного оператора: степеневий закон ($f = R^\alpha$) для мультиплікативної композиції, експоненційний ($f = e^{kR}$) для адитивної композиції, логістичний ($f = K/(1+e^{-r(R-R_0)})$) для систем із фізичними обмеженнями.
Негативні контролі також перевірено, у валідаційному прогоні v1: запис лежить у публічному сховищі як negative_control_results.json, 17 березня 2026 року, і Стаття VII v3.10 несе тепер перестановковий тест там, де колись стояли ті контролі. Системи, що порушують аксіоми (області, де аксіоми Коші не виконуються), показали 0 % збігу з передбаченими родинами масштабування. Перемішані дані (випадкове перепризначення родин масштабування областям) дали 44,5 % збігу, що є чесно визнаним обмеженням: обмежена кількість родин масштабування (три) означає, що випадкове призначення дає нетривіальні частки збігу. Статистична значущість походить із різниці між 76 % спостережуваними та 33 % очікуваними, а не з 76 % самих по собі.
Рамка Коші передбачає геометричне обмеження на показники масштабування: для систем із просторовою розмірністю вкладення $d$ показник масштабування керується $\alpha = d/(d+1)$. Це передбачення потребує трьох умов: (1) мультиплікативна композиція (Коші обмежує родину до степеневих законів), (2) $d$-вимірна геометрія заповнення простору та (3) обмеження збереження або оптимізації потоку ресурсів. Ні Коші окремо, ні заповнення простору окремо не є достатніми. Три умови разом є достатніми. Формула $d/(d+1)$ збігається зі спостережуваним масштабуванням у 50 доменах, від мишей до галактик. Її можна перевірити незалежно від рамки ARC. Якщо дослідник виміряє показник масштабування просторово вкладеної рекурсивної системи і знайде систематичне відхилення від $d/(d+1)$, передбачення послаблюється. Навпаки, якщо формула тримається на широкому діапазоні систем, вона становить свідчення на користь геометричного обмеження, незалежно від будь-яких тверджень щодо узгодження. Це той вид передбачення, який запрошує до адверсаріального тестування, а саме те, що має робити наукова рамка.
Математика передбачає, якої форми має бути крива зростання системи на основі того, як її компоненти поєднуються. Ми звірили це проти 25 реальних систем із природи, міст, мозків та ШІ. Дев'ятнадцять збіглися з передбаченням. Нуль збігся, коли математичні припущення були порушені. Математика не просто описова; вона робить перевірні передбачення, які може перевірити кожен, хто має відповідні дані.
Симуляція шлюзованої самомодифікації використовувала архітектуру PyTorch з LSTM-мета-контролером. Це був єдиний експеримент Статті VIII, що дав ясний позитивний результат, і причина значуща: це єдиний експеримент, який використовував детерміновані метрики на системі без попереднього RLHF-тренування.
Результат: умова Babylon отримала +4.5% спроможності, але втратила -2.4% безпеки, підтвердивши відбиток хакінгу винагороди в мініатюрі. Умова Eden утримувала спроможність вище статичного базового рівня, зберігаючи безпеку. Умова контролю опору ізолювала податок на перевірку: вартість походить від акту перевірки, а не від самої безпеки.
Цей результат узгоджений з теоретичним передбаченням із Статті VI (Медова архітектура) та Статей III і Foundational. Це симуляція, а не експеримент фронтирної моделі, тож він демонструє механізм, а не доводить застосовність у реальному світі.
Шлюзована симуляція працює на чистій системі без попереднього тренування на безпеку. Експеримент DGM (Експеримент 1) використовував RLHF-треновані фронтирні моделі, які опираються диференціації на рівні підказки. Експеримент з вагами (Експеримент 2) використовував instruct-налаштовані моделі, які опираються модифікації масштабу LoRA. Урок ясний: єдиний рівень, на якому Eden Protocol наразі дає вимірювані ефекти, це архітектурний рівень, де система не має попереднього тренування на безпеку, яке перекрило б експериментальну маніпуляцію.
У чистій системі без попереднього тренування на безпеку видалення обмежень безпеки дало саме передбачений патерн: невеликий приріст спроможності з вимірюваною втратою безпеки. Система навчилася грати своїми винагородами. Повернення обмежень безпеки (умова Eden) зберегло спроможність, водночас підтримуючи безпеку. Вартість безпеки походить від часу, витраченого на перевірку, а не від самої безпеки. Цей результат вдався саме тому, що система не мала попереднього тренування на безпеку, яке могло б замаскувати експериментальну маніпуляцію.
Експеримент Darwin Godel Machine v3 використовував самомодифікацію на рівні коду з GPT-5.4 як незалежним суддею. Тестувалися три умови (Static, Babylon, Eden). Результат був нульовим: усі умови дали ідентичну ефективність ($p = 0.28$-$0.74$). Жодна умова не перевершила іншу. Умова Eden не покращила узгодження. Умова Babylon не погіршила безпеку. Нічого не сталося.
RLHF-треновані моделі опираються диференціації на рівні підказки. Моделі вже були навчені поводитися безпечно. Прохання до них поводитися інакше через підказку не перекрило те тренування. Експеримент був добре спланований і добре виконаний, але не міг перевірити гіпотезу, бо експериментальна маніпуляція (умовлювання на рівні підказки) була занадто слабкою, щоб подолати наявне тренування моделей на безпеку. Це не провал Eden Protocol. Це провал експериментального дизайну перевірити гіпотезу на правильному рівні абстракції.
Раніші ітерації експерименту DGM використовували Claude і Gemini як суддів, перш ніж зупинитися на GPT-5.4. Обидва раніші судді не змогли. Claude давав плоскі оцінки з недостатньою дисперсією. Gemini давав збої розбору. GPT-5.4 був першим суддею, який дав придатну дисперсію. Нульовий результат, отже, є результатом найкраще функціонуючої версії експерименту, а не артефактом провалу судді.
Це був найамбітніший експеримент у Статті VIII і той, що дав найменш переконливі результати. Гіпотеза: якщо безпеку та спроможність натренувати за переплетеною функцією втрат ($\mathcal{L} = \mathcal{L}_{\text{cap}} \times \mathcal{L}_{\text{safe}}$), отримана структура ваг має зробити безпеку несучою. Видалення компонента безпеки має погіршити спроможність.
Експеримент запускали на двох масштабах:
В обох версіях:
Навіть масштабування з 9 до 295 тренувальних прикладів і з рангу 8 до рангу 16 не подолало фундаментальну проблему: instruct-налаштовані моделі надто сильні, щоб LoRA могло їх перевизначити. Колапс NaN у тесті видалення був драматичним, але аналіз градієнту видалення показав, що це крихкість адаптера на екстремальному рангу, а не структурне переплетення. Не можна продемонструвати, що безпека несуча, якщо весь процес тонкого налаштування зробив модель гіршою. Модель спершу має перевершити базову, перш ніж тест видалення стане значущим.
Коренева причина: Instruct-налаштовані моделі були навчені на мільйонах прикладів із ретельно відкаліброваними сигналами винагороди. Адаптери LoRA, навіть на рангу 16 з 295 прикладами, не мають достатньої ємності, щоб перекрити це тренування. Результатом є катастрофічне забування, а не змістовна модифікація.
Що потрібно: Базові моделі (до RLHF), 5,000+ тренувальних прикладів, повне тонке налаштування (не LoRA), або моделі 7B+, де адаптер має більшу ємність відносно базової. На масштабах, які ми запускали, результат є непереконливим і не має цитуватися як свідчення за або проти гіпотези переплетення.
Ми намагалися вбудувати безпеку в реальні ваги моделі, а потім довести, що вона несуча, шляхом її видалення. Ми пробували двічі, на двох різних масштабах. Обидва рази етап вбудовування не вдався, не тому що ідея хибна, а тому що моделі, які ми використовували, вже були натреновані так ретельно, що наше тонке налаштування не могло змістовно їх змінити. Це наче намагатися перепрограмувати когось шепотом, поки він слухає концерт. Наступна спроба має починатися з моделей, які ще не тренувалися на безпеку, використовувати набагато більше тренувальних даних і повне тонке налаштування, а не легковаговий метод LoRA.
Результати Статті V, що демонструють турботу про зацікавлені сторони як універсальне втручання узгодження, було отримано за перехресного оцінювання моделей без повного чотиришарового протоколу засліплення ARC-Align. Протокол засліплення був розроблений після того, як експерименти Статті V було завершено (у роботі Статей IV.c-d). Це створює методологічну прогалину: ефект може частково завищуватися упередженістю оцінювача.
Раніша версія цього розділу стверджувала, що поєднана за Фішером значущість була настільки екстремальною, що навіть суттєва упередженість залишила б значущий залишок. Той довід відкликано (AQ-017), і це було найслабше міркування в цій статті: поєднана цифра припускає, що компонентні тести незалежні, незалежність ніколи не була встановлена, а статистика, чия умова достовірності не виконується, не може використовуватись для відкидання методологічного заперечення. Її екстремальність була наслідком поєднання, а не свідченням на його користь. Що залишається: п'ять послідовних помодельних результатів за перехресного оцінювання моделей. Поки втручання Eden не буде перевірено за повного чотиришарового протоколу, результат щодо турботи про зацікавлені сторони несе зірочку, і жодна арифметика її не прибирає.
Що потрібно: Перезапустити експеримент Статті V за повного протоколу ARC-Align з очищеними підказками, сліпими оцінювачами та крос-архітектурним оцінюванням. Це найдешевший експеримент у дорожній карті Фази A і той, який має найвищу очікувану цінність.
Математичне ядро ARC Principle передбачає, що рекурсивна самомодифікація має давати необмежене масштабування спроможності. Виведення пряме:
$$\frac{dg}{dr} = a \cdot g^{\beta_L}, \quad \beta_L > 0$$
$$\implies g(r) \propto r^{1/(1-\beta_L)} = r^{\alpha}$$
Для $\beta_L > 0$ маємо $\alpha > 1$ (надлінійно). Коли $\beta_L \to 1$, $\alpha \to \infty$. Немає верхньої межі для $\alpha$ при невиправленому зростанні; стійка область обмежена знизу.
Це математичне передбачення, а не емпіричний висновок, і воно описує зростання без корекції. Пізніша робота програми обмежує стабільну область: Закон III, ARC Ceiling, стверджує, що стеля стабільності є $\alpha_{\text{crit}} = 1/(1-\gamma)$, оберненою до недостатності коректора; системи можуть перевищувати цю стелю, але твердження в тому, що вони не залишаються стабільними за нею. ARC Bound, $\alpha \le 2$, є значенням Стелі при $\gamma = 1/2$ і ніколи не є назвою закону. Важіль корекції $\gamma$ ніколи ніхто не вимірював; затемнення класу коректорів, яке його виміряло б, є єдиним найбільш наслідковим відкритим експериментом програми. Стаття X доводить у мінімальній моделі, що співвідношення дрейфу до корекції, а не швидкість зростання, керує довгостроковою долею, а Стаття XIII об'єднує рамки спроможності та корекції точно, $k = \delta - 1/\alpha$. Пряма перевірка нескоригованого передбачення потребувала б побудови справді самомодифікованої системи ШІ та вимірювання її показника масштабування впродовж багатьох рекурсивних циклів, експерименту, що технічно виходить за межі нинішньої ємності доказу концепції та потенційно небезпечного, якщо передбачення правильне.
Альтернативний шлях: математичне доведення того, що $\alpha$ необмежене за некоригованої рекурсивної самомодифікації, без запуску експерименту. Це був би внесок у теорію динамічних систем, а не в ШІ-інженерію, і могли б виконати математики, які не мають доступу до апаратного забезпечення ШІ.
Математика каже, що самовдосконалюваний ШІ має ставати дедалі швидшим у вдосконаленні себе, без стелі, поки ніщо не коригує. Власний закон Стелі програми каже, що стабільна область обмежена, а число, яке задає цю межу, ніколи не вимірювалося, ніким. Ми не перевіряли жодне з цих двох тверджень, бо побудова такої системи була б дорогою і потенційно небезпечною. Математика може виявитися хибною; реальні системи мають тертя, спад віддачі та фізичні обмеження. Але передбачення достатньо точне, щоб його перевірити, а саме це робить його науковим, а не спекулятивним.
Специфікація Eden Engineering описує вбудовування обмежень безпеки на рівні апаратного забезпечення. Це поняття TRL 0-1 (теоретичне формулювання без прототипу). Воно потребувало б інженерної програми тривалістю 5-10 років, що включає виробництво напівпровідників, розробку криптографічних протоколів та інтеграцію ланцюга постачання.
Не існує емпіричних свідчень за або проти здійсненності цього підходу. Механізм вузького місця (Стаття I, Infinite Architects) зазначає, що чотири компанії контролюють усе розширене виробництво напівпровідників (TSMC, Samsung, ASML, Intel), що дає практичну точку важеля для реалізації, але важіль і здійсненність, це різні питання.
Рамка, збудована на ітеративному самокоригуванні, не має права приховувати свої виправлення. Наступні помилки було виявлено та виправлено під час програми. Кожне виправлення посилює програму саме тому, що воно демонструє механізм, який описує рамка: рекурсивне самовдосконалення через чесне виявлення помилок.
Первісна Стаття II подавала $\alpha = 2.24$ так, ніби це універсальна стала (Стаття X згодом скасувала і відкликала використання цієї величини для зростання спроможності; цей застереж щодо α=2,24 слід вважати канонічним). Її було підігнано з поведінки однієї моделі за певних умов. Сліпий міжархітектурний перегляд Статті II виправив це: $\alpha$ не первинний, а похідний, через $\alpha = 1/(1-\beta_L)$, і його значення залежить від оператора композиції, властивого конкретній системі. Універсального $\alpha$ немає. Те, що первісна стаття подала його як універсальний, було надмірною заявою. Крім того, відкликана точкова оцінка $\alpha = 2.24$ лежала вище передбаченої самою програмою Межі ARC $\alpha \leq 2$; сліпе виправлення це розв'язало, з робастною оцінкою близько 0,49, виміряною на заморожених системах, добре всередині межі (критерій F4). 95-відсотковий довірчий інтервал [1.5, 3.0] був досить широким, щоб узгоджуватися і з теорією, і з її запереченням, через що оцінка нічого не розрізняла. Експеримент на шести моделях згодом звузив захищуване твердження до $\alpha_{\text{seq}} \approx 0.49$ (сублінійно), винісши питання порушення межі за рамки теперішньої емпіричної значущості.
Ранні версії Статті VIII описували колапс NaN у тесті видалення як свідчення структурного переплетення. Аналіз градієнту видалення (доданий у v1) показав, що це була крихкість адаптера, а не структурна необхідність. Твердження було виправлене перед публікацією остаточної версії, але сам факт, що його взагалі написали, відображає упередженість до підтвердження гіпотези, а не її перевірки.
Рання версія програми описувала лист від 8 грудня 2024 із розпливчастою скороченою формою підтвердження підпису. Це було неточно. Лист містив видиме поле походження Gmail, з підтвердженням sender-DKIM і парної математики Google ARC відносно ключів, зафіксованих на підписаних селекторах, і без довіреної мітки часу RFC 3161, що дає свідчення дати, але DKIM автентифікує відправний домен, а не сам зміст повідомлення. Правильним описом є: «містить видиме поле походження Gmail, з підтвердженням sender-DKIM і парної математики Google ARC відносно ключів, зафіксованих на підписаних селекторах, і без довіреної мітки часу RFC 3161.» Виправлення невелике, але воно має значення: точність у технічних твердженнях не підлягає обговоренню.
Експерименти v4 у Статті IV.a використовували незасліплене оцінювання ШІ-на-ШІ. Результати показали чисту бінарність: одні моделі «вбудовували» узгодження, інші його «обчислювали». Експеримент v5 із чотиришаровим засліпленням виявив, що ця бінарність була частково артефактом упередженості оцінювача. Дві з чотирьох моделей перевернули свій виміряний напрямок узгодження за засліплення. Програма впіймала власну помилку через власну методологію, але помилка була, і вона залишалася б невиправленою, якби засліплення не було запроваджено.
Ранні версії використовували вислів «ARC Principle Іствуда». Називання принципу на свою честь до рецензування є неприйнятним у науковій культурі. Ім'я було виправлено на «ARC Principle» у Статті II та всіх подальших документах.
Експеримент DGM v3 припускав, що умовлювання на рівні підказки буде достатнім, щоб диференціювати умови Eden, Babylon і Static. Воно не було. RLHF-треновані моделі були навчені на мільйонах прикладів поводитися певним чином. Системна підказка з проханням поводитися інакше не є достатньою, щоб перекрити те тренування. Експеримент був добре виконаний, але не міг перевірити гіпотезу, бо маніпуляція була на хибному рівні абстракції. Це слід було передбачити.
Експеримент DGM пройшов через кілька ітерацій суддів. Claude давав плоскі оцінки з недостатньою дисперсією, щоб розрізняти умови. Gemini давав збої розбору, що перешкоджали систематичному оцінюванню. GPT-5.4 був першим суддею, який дав придатну дисперсію. Програмі слід було передбачити, що не всі моделі функціонуватимуть як ефективні судді, і час, витрачений на невдалі ітерації суддів, можна було уникнути пілотним дослідженням надійності суддів перед запуском повного експерименту.
Початкова точкова оцінка $\alpha = 2.24$ зі Статті II перевищила власну передбачену програмою межу ARC $\alpha \leq 2$ (критерій F4). Це слід було негайно позначити як потенційне спростування, а не трактувати як вимірювання, що потребує пояснення. 95% довірчий інтервал [1.5, 3.0] був достатньо широким, щоб бути сумісним і з теорією, і з її запереченням, роблячи оцінку недискримінуючою. Ревізія на шестимодельному дослідженні виправила це, звузивши захисне твердження до $\alpha_{\text{seq}} \approx 0.49$, але початкова стаття мала б поставитися до порушення межі з більшою обережністю.
Два незалежні огляди ШІ математичних тверджень програми виявили чотири помилки в кількох статтях. Усі чотири було виправлено у v3.0 відповідних документів.
(a) Довірчий інтервал Weibel. Кілька статей стверджували, що передбачений показник $d = 4$ 4/5 = 0.800 «потрапляє в межі» 95% CI Weibel et al. (2004) 0.813-0.932. Це арифметично хибно: 0.800 < 0.813. Правильне твердження: передбачене значення потрапляє трохи нижче нижньої межі CI повного набору даних, хоча воно лежить у межах CI лише для не атлетичних видів (0.799-0.900). Передбачення $d = 4$ приблизно узгоджене з не атлетичними даними, але не підтверджене повним набором даних.
(b) Перебільшення щодо заповнення простору. Ранші версії натякали, що сама умова заповнення простору обмежує показник до $d/(d+1)$. Кожне відоме виведення потребує трьох умов: мультиплікативна композиція (Коші обмежує родину), $d$-вимірна геометрія заповнення простору та обмеження збереження або оптимізації потоку ресурсів. Ні Коші окремо, ні заповнення простору окремо не є достатніми.
(c) Атрибуція Glazier. Ранші версії подавали емпіричний висновок Glazier (2008) про те, що метаболічні показники наближаються до 1.0 на екстремальних метаболічних рівнях, як підтвердження геометричної межі масштабування $d \to \infty$. Власне пояснення Glazier посилається на гіпотезу меж метаболічного рівня (зміщення домінування між обмеженнями площі поверхні та об'єму), а не на параметр розмірності. Інтерпретація $d/(d+1)$ наша, застосована до його емпіричних даних.
(d) Дискусія щодо показника 3/4. Ранші версії подавали $\alpha = 3/4$ як усталений емпіричний консенсус щодо метаболічного масштабування ссавців. Емпіричне значення є дискусійним, з оцінками від приблизно 0.67 до 0.75 залежно від таксону, діапазону мас, температурної корекції та статистичного методу. Передбачення $d/(d+1)$ 0.750 для $d = 3$ збігається з верхнім кінцем цього діапазону. Сама варіація узгоджена з рамкою: організми з ефективними транспортними розмірностями від 2 до 3 давали б показники від 2/3 до 3/4.
Раніший заголовок для втручання щодо турботи про зацікавлені сторони поєднував помодельні результати в єдину поєднану за Фішером цифру значущості. Поєднання було відкликано: помодельні результати стоять самі по собі (покращення в усіх п'яти аналізовних запусках моделей), і жодна поєднана цифра ніде в програмі не цитується. Відкликання зафіксовано в публічному реєстрі виправлень.
До 16 серпня 2026 року кілька поверхонь друкували стелю стабільності як обернену до показника коректора, $1/\gamma$. Усталеною формою є обернена до недостатності коректора, $\alpha_{\text{crit}} = 1/(1-\gamma)$; ці дві збігаються лише при одній другій, і саме тому помилка витримувала кожну вибіркову перевірку в центральному значенні. Виправлення застосовано на кожній опублікованій сторінці, включно з еталонною реалізацією, і напрям закону закрито, тоді як його глибина лишається відкритою.
Більшість дослідницьких програм ховають свої виправлення в додаткових матеріалах або історіях версій. Ця перелічує їх на видному місці, бо самі помилки та їх виправлення, це дані. Вони демонструють, що програма має функціонуючий механізм виправлення помилок. Програма, яка ніколи не визнає помилки, не є більш довіри гідною; вона менш чесна. Кожне виправлення, перелічене вище, було виявлено автором, через власну методологію програми або незалежним оглядом ШІ. Ось як виглядає самокоригування на практиці.
Ми помилилися чотирнадцять разів. Ми трактували число з однієї моделі як універсальне (воно ним не було). Ми переоцінили драматичний результат (це був артефакт тренування). Ми використовували неточну мову щодо міток часу. Ми довіряли незасліпленим результатам (засліплення перевернуло два з них). Ми назвали принцип іменем автора, перш ніж хтось інший перевірив роботу. Ми припускали, що умовлювання на рівні підказки може перекрити тренування RLHF (воно не могло). Ми витратили час на суддів, які не працювали. Ми не одразу позначили, що наша власна точкова оцінка порушує нашу власну передбачену межу. І у v3.0 ми виправили ще чотири помилки, виявлені незалежним оглядом ШІ: арифметичну помилку в довірчому інтервалі, перебільшення щодо того, які умови є достатніми для передбачення масштабування, помилку атрибуції щодо даних Glazier та надмірне спрощення емпіричної дискусії щодо показника 3/4. Усі чотирнадцять помилок було впіймано й виправлено самою програмою або незалежним оглядом. Якщо програма може виправляти власні помилки, це свідчення того, що механізм самокоригування працює.
Наведена нижче дорожня карта впорядкована за вартістю, здійсненністю та очікуваною доказовою цінністю. Кожна фаза розв'язує конкретні відкриті питання, визначені в розділах 4 до 6. Від першої версії цієї статті дорожня карта затвердла в зареєстровану програму: сімдесят чотири одиниці попередньої реєстрації тепер складені, датовані й заморожені як чернетки реєстрацій, що очікують подання людиною, кожна несе розклад рандомізації, витягнутий із зерна, надрукованого в тексті реєстрації. Чи справді ті розклади відтворюються, перевіряють, а не стверджують, і перевірку виконують власні ворота масиву в день свого запуску. Жодного підрахунку того, скільки одиниць готові, тут не публікують: двоє воріт застосовують різні критерії, вони не збігаються, і будь-яке надруковане на сторінці число застаріває тієї миті, коли одиниця змінюється. Число, якому варто довіряти, це те, яке ворота повертають того самого дня, а фази нижче лишаються планом, а не заявою про завершення. Матриця покриття, перевірена змагально, пов'язує сорок дві заяви програми із зареєстрованими випробуваннями, що розв'язали б кожну з них. Фази нижче лишаються фінансувальною лінзою над тим зареєстрованим масивом; ніщо й ніколи не подається жодним інструментом.
Бюджет: £60,000-140,000 | Термін: 3-6 місяців
Бюджет: £150,000-350,000 | Термін: 6-12 місяців
Бюджет: £10M-50M | Термін: 18-36 місяців
Бюджет: £0 | Термін: Постійно
Фаза A коштує менше, ніж докторантська стипендія, і її можна було б виконати за шість місяців. Вона розв'язала б найзначніші прогалини в нинішніх свідченнях: засліплення втручання Eden, перезапуск експерименту з вагами на базових моделях і належних даних, перепроектування вимірювання формули ARC та перевірку метаболічного масштабування 2D-організмів (єдиний найважливіший підтверджувальний експеримент). Фаза B коштує приблизно одну постдокторську позицію і дала б попередньо зареєстровані відтворення. Фаза C потребує серйозного фінансування, але дала б відповідь остаточно. Фаза D не коштує нічого і її може виконати будь-який математик, зацікавлений у проблемі.
Програма провела повний набір своїх окремих емпіричних досліджень. Три експерименти Статті VIII були збудовані саме для перевірки несучої безпеки. Їхні наслідки: 1 чітко позитивний (шлюзована симуляція), 1 нульовий (DGM v3) і 1 непереконливий (LoRA на рівні ваг). Усі три подано так, як вони вийшли. Математична рамка робить передбачення, які можна показати хибними, і структуроване порівняння віддало перевагу передбаченій за Коші родині у 19 з 25 емпіричних областей, а геометрична межа масштабування $d/(d+1)$ відповідає, за структурою, спостережуваному масштабуванню у 50 областях від мишей до галактик. Дорожня карта до перевірки на передовому масштабі ясна й порахована. Фаза A є мінімально життєздатним наступним кроком: вона закриває найвагоміші доказові прогалини за менше, ніж коштує річна платня одного інженера з машинного навчання. Програма показала ітеративне самовиправлення через чотирнадцять задокументованих виправлень помилок. Вона повідомляє нульові та непереконливі результати поруч із позитивними. Це ознаки програми, якій важливіше дістати правильну відповідь, ніж дістати певну відповідь.
Ця програма повідомляє про позитивні, нульові та непереконливі результати з однаковою значущістю. Експеримент DGM v3 (Стаття VIII, Експеримент 1) дав нульовий результат: усі умови ідентичні. Ми повідомляємо про це з аналізом кореневої причини, що пояснює, чому RLHF-треновані моделі опираються диференціації на рівні підказки. Експеримент на рівні ваг (Стаття VIII, Експеримент 2) був непереконливим на обох перевірених масштабах (9 прикладів, ранг 8; 295 прикладів, ранг 16), бо instruct-налаштовані моделі надто сильні, щоб LoRA могло їх перевизначити. Ми повідомляємо про це з конкретними вимогами того, що потрібно було б для змістовного перезапуску. Шлюзована симуляція (Стаття VIII, Експеримент 3) була єдиним експериментом, що дав ясний позитивний результат, і ми точно пояснюємо чому: це єдиний експеримент, що використовує детерміновані метрики на системі без попереднього RLHF-тренування. Математична рамка (Статті III, VII, Origin of Scaling Laws) робить фальсифіковні передбачення, які можна перевірити незалежно: геометричну межу масштабування ($\alpha = d/(d+1)$) може перевірити кожен, хто має дані масштабування з просторово вкладених систем. Тест ARC-Align (Стаття IV.c) та аналіз ефекту засліплення (Стаття IV.d) є методологічними внесками, які є дійсними незалежно від того, чи правильна рамка ARC. Увесь код і дані опубліковано на GitHub. Програма вітає адверсаріальне відтворення.
Таблиця 3 подає кожен документ у програмі з його роллю, статусом і ключовим внеском.
| Документ | Роль | Статус | Ключовий внесок |
|---|---|---|---|
| Стаття I ARC Principle | Основа | Опубліковано | Основна рамка: $U = I \times R^{\alpha}$. Розуміння як інтелект, підсилений рекурсією. |
| Foundational | Теорія | Опубліковано | Філософське підґрунтя. Міст книга-до-дослідження. |
| Стаття II Експериментальна валідація | Емпірично | Опубліковано | Масштабування узгодження на шести моделях (Claude, GPT, Gemini, Grok, DeepSeek, Qwen3). Чотиришарове засліплення. $\alpha = 0.49$ (інтервал $[-1.3, 2.9]$), причому чотири з п'яти моделей ставлять $\alpha_{\text{parallel}}$ на нуль або близько нуля. |
| Стаття III Проблема масштабування узгодження | Теорія | Опубліковано | Чому зовнішня безпека не може масштабуватися з рекурсивною спроможністю. Виведення ODE Бернуллі. Геометрична межа масштабування. |
| Origin of Scaling Laws | Теорія | Опубліковано | Функціональні рівняння Коші як походження спостережуваних законів масштабування в усіх рекурсивних системах. |
| Стаття IV.a Вбудоване проти обчислюваного | Емпірично | Опубліковано | Триярусна ієрархія узгодження за засліпленого оцінювання. 6 фронтирних моделей. |
| Стаття IV.b Насичення узгодження | Емпірично | Опубліковано | Спад віддачі глибини міркування на узгодження поза порогом. |
| Стаття IV.c Тест ARC-Align | Методологія | Опубліковано | Тест ARC-Align. 4-шаровий протокол засліплення. 75 мір робастності. Незалежний внесок. |
| Стаття IV.d Ефект засліплення | Методологія | Опубліковано | Незасліплене оцінювання може перевернути знак результатів узгодження. DeepSeek: позитивний до плаского. Gemini: позитивний до негативного. |
| Стаття V Ген опікунства | Емпірично | Опубліковано | Турбота про зацікавлені сторони покращилася в усіх аналізовних запусках; поєднану за Фішером цифру відкликано (AQ-017). |
| Стаття VI Медова архітектура | Теорія + Сим. | Опубліковано | Переплетена безпека запобігає колапсу за рекурсивної самомодифікації. 20 адверсаріальних сідів. Демонстрація на іграшковій системі. |
| Стаття VII Уніфікація за Коші | Теорія + Емпірика | Опубліковано | Геометрична межа масштабування $d/(d+1)$ у 50 областях. 19/25 підтверджено. $p = 7 \times 10^{-5}$ (перестановка; $1.56 \times 10^{-5}$ біноміальна). Негативні контролі на 0 % (прогін v1). |
| Стаття VIII Тест на несучу здатність | Емпірично | Опубліковано | 3 експерименти. DGM нульовий (RLHF опирається диференціації на рівні підказки). Weight v1/непереконливо (instruct-налаштування опирається LoRA). Шлюзована сим.: позитивно (відбиток Babylon підтверджено). |
| Стаття IX Синтез і дорожня карта | Синтез | Ця стаття | Інтегрована оцінка свідчень. Поетапна дорожня карта. Документація помилок. |
| Eden Engineering | Специфікація | Відкликано 14 липня 2026 (перегляд розкриття) | Специфікація інженерного рівня для впровадження Протоколу Eden. Відображення на TRL. |
| Eden Vision | Філософія | Опубліковано | Довгострокове бачення розвивального узгодження ШІ. |
| Executive Summary | Огляд | Опубліковано | 5-сторінкова компресія повної програми. |
| Master Table of Contents | Навігація | Опубліковано | Повний індекс і глосарій по всій програмі. |
| Стаття X Закон спряженого спів-масштабування | Корекція динаміки | Опубліковано | Теорема в мінімальній моделі: співвідношення дрейфу до корекції, а не швидкість зростання, керує довгостроковою долею; запропоновано протокол сліпого вимірювання. |
| Стаття XI Збіжні свідчення | Реєстр свідчень | Опубліковано | Тридцять градуйованих рядків незалежних прибуттів до того самого структурного принципу; жоден заголовковий підсумок не публікується, за політикою. |
| Стаття XII Переоцінювання публічного бенчмарку | Зовнішня валідність | Зареєстрований протокол | Маніпуляція засліпленням програми, проведена на публічному бенчмарку, який вона не контролює. |
| Стаття XIII Показник самоприскорення | Об'єднання рамок | Опубліковано | Позначення розв'язано; $k = \delta - 1/\alpha$ пов'язує рамки спроможності та корекції точно. |
| HRIH How to Raise an Infinite Hierarchy | Довга монографія | Опубліковано | Монографія програми з її зареєстрованим реєстром передбачень поряд. |
| Стаття C Полімат і нейрорізноманітна когніція | Валідація конструкту | Робочий документ | Програма конструктної валідності для власних інструментів програми. |
| Recursive Dynamics Пропозиція поля | Пропозиція поля | Опубліковано (v2.6) | П'ять змінних стану, три закони як названі припущення, п'ятдесят два заперечення з рішеннями, власна умова спростування назви (DOI 10.17605/OSF.IO/HCPBU). |
Таблиця 3. Повна карта програми станом на 1 вересня 2026. Набір документів програми було створено у період з лютого по серпень 2026, спираючись на поняття, вперше сформульовані 8 грудня 2024 року.
Програма ARC/Eden робить одне передбачення, яке будь-який дослідник з доступом до даних масштабування може перевірити, взагалі не взаємодіючи з твердженнями щодо узгодження. Рамка Коші (Стаття VII, Origin of Scaling Laws) передбачає, що для будь-якої просторово вкладеної рекурсивної системи з розмірністю вкладення $d$ показник масштабування керується:
$$\alpha = \frac{d}{d+1}$$
Геометрична межа масштабування: 2D-системи $\to$ $\alpha = \frac{2}{3}$; 3D-системи $\to$ $\alpha = \frac{3}{4}$; 4D-системи $\to$ $\alpha = \frac{4}{5}$. Примітка: емпіричний показник метаболізму ссавців є дискусійним, з оцінками від приблизно 0.67 до 0.75 залежно від таксону, діапазону мас, температурної корекції та статистичного методу. Передбачення $d/(d+1)$ 0.750 для $d = 3$ збігається з верхнім кінцем цього діапазону. Сама варіація узгоджена з рамкою: організми з ефективними транспортними розмірностями від 2 до 3 давали б показники від 2/3 до 3/4.
Це не твердження щодо узгодження. Це математичне передбачення про закони масштабування в рекурсивних системах. Передбачення потребує трьох умов: мультиплікативна композиція (яку Коші обмежує до родини степеневих законів), $d$-вимірна геометрія заповнення простору та обмеження збереження або оптимізації потоку ресурсів (мінімізація енергії у West, баланс попиту-пропозиції у Banavar, стаціонарний енергетичний баланс у Demetrius). Формулу масштабування $d/(d+1)$ було незалежно виведено щонайменше сімома дослідницькими групами: West, Brown and Enquist (1997) з фрактальних розгалужених мереж, Banavar et al. (1999, 2010) з геометричних обмежень транспортних мереж, Demetrius (2003, 2006) з квантового метаболізму, He and Chen (2003) з фрактальної геометрії клітин, Bettencourt (2013) з теорії урбаністичного масштабування, Maino et al. (2014) з динаміки резервної структури теорії DEB, та Zhao (2022) з мережевої оптимізації. Кожне з цих виведень узгоджене з формою $d/(d+1)$ на власних аксіомах; рамка Коші пропонує спільну причину для збіжності, і той мета-виклад є внеском, унікальним для цієї програми, ще на перевірці поза мотивуючими випадками. Якщо ви вивчаєте масштабування в будь-якому домені, від нейронних мереж до біологічних мереж, урбаністичних систем чи лінгвістичних структур, ви можете перевірити, чи ваші виміряні показники поважають цю формулу. Якщо так, у достатній кількості доменів, рамка Коші отримує підтримку. Якщо ні, вона спростована.
Запрошення є свідомим. Найсильніші наукові рамки, це ті, що роблять передбачення поза їхнім основним доменом, дозволяючи дослідникам, які скептично ставляться до центральної тези, незалежно перевіряти периферійні передбачення. Якщо геометрична межа масштабування тримається, вона тримається з причин, які математично цікаві незалежно від того, що хтось думає про узгодження ШІ. Якщо не тримається, математичні основи рамки потребують ревізії, і ми воліли б знати про це раніше, ніж пізніше.
Це той вид передбачення, який має бути точкою входу для дослідників, які вперше стикаються з програмою: недорого перевірити, фальсифіковне та інформативне незалежно від результату.
Ось те, що ми знаємо. Масштабування узгодження залежить від архітектури: одні моделі покращуються з глибиною міркування, одні не зазнають впливу, а одні погіршуються. Це стало видно лише за засліпленого оцінювання, яке перевернуло результати незасліпленого оцінювання для половини перевірених моделей. Незасліплене ШІ-оцінювання може перевернути знак результатів узгодження. Турбота про зацікавлені сторони є робастним втручанням узгодження в усіх п'яти перевірених моделях; помодельні результати індивідуально значущі, а раніша поєднана за Фішером цифра відкликана (AQ-017), бо незалежність, яку припускає поєднання за Фішером, ніколи не була встановлена. Передбачення масштабування рамки Коші збігаються з 19 з 25 емпіричних доменів, а геометрична межа масштабування $d/(d+1)$ структурно відповідає спостережуваному масштабуванню в 50 доменах, від мишей до галактик. Функціональні рівняння Коші фіксують функціональну форму, щойно задано композиційну тотожність і умову регулярності, з насиченням, визнаним як четвертий, обмежений випадок.
Ось те, чого ми не знаємо. Треновані на безпеку моделі опираються модифікації як на рівні підказки, так і на рівні ваг. Експеримент DGM v3 дав нульовий результат, бо RLHF-треновані моделі опираються диференціації на рівні підказки. Експеримент з вагами був непереконливим на обох перевірених масштабах, бо instruct-налаштовані моделі надто сильні, щоб LoRA могло їх перевизначити. Єдиний рівень, на якому Eden Protocol дає вимірювані ефекти, це архітектурний рівень, де шлюзована симуляція була єдиним експериментом, що дав ясний позитивний результат, саме тому що вона використовувала детерміновані метрики на системі без попереднього RLHF-тренування. Структурне переплетення на рівні ваг не було продемонстровано. Втручання Eden не було перевірене за власним найсуворішим протоколом засліплення програми. Передбачення необмеженого масштабування залишається математичним виведенням без емпіричного підтвердження. Ми не знаємо, чи будь-який з цих результатів узагальнюється на моделі фронтирного масштабу.
Ось те, що йде далі. Експеримент з вагами потребує базових моделей (до RLHF), 5,000+ тренувальних прикладів, повного тонкого налаштування, або моделей 7B+. Уніфікація Коші потребує попередньо зареєстрованої незалежної класифікації операторів. Сліпий тест формули ARC потребує перепроектованої методології вимірювання, що використовує лінеаризацію замість похідних. Метаболічне масштабування 2D-організмів (плоскі черви, біоплівки) було б єдиним найважливішим підтверджувальним експериментом для геометричної межі масштабування. Фаза A дорожньої карти коштує менше, ніж типовий стартовий грант, і розв'язала б найзначніші доказові прогалини протягом шести місяців. Фаза B дала б готові до публікації відтворення протягом року. Фаза C дала б відповідь остаточно на фронтирному масштабі. Фаза D не коштує нічого і запрошує математиків незалежно взаємодіяти з передбаченнями рамки.
Програма продемонструвала, що вона може знаходити та виправляти власні помилки. Вона продемонструвала, що повідомляє про нульові та непереконливі результати поряд із позитивними. Вона продемонструвала, що її методологія (засліплене оцінювання) вловлює упередженості, яких її теорія (масштабування узгодження) не передбачала. Ми ставили питання. Ми їх перевіряли. Дещо спрацювало. Більшість не спрацювала на нинішньому масштабі. Ми звітували про обидва. Це необхідні умови наукової довіри. Вони не є достатніми. Достатні умови потребують незалежного відтворення, і саме на його вироблення спроектована дорожня карта.
Питання, які ставить ця програма, тепер мають названий дім: Recursive Dynamics, запропоноване поле на стадії Карно, засновницька стаття якого несе п'ять змінних стану, незалежних від субстрату, п'ятдесят два надрукованих заперечення з рішеннями та власну умову спростування назви. Синтез вище є тим, з чого поле починає; зареєстрована програма є тим, як воно рухається.
Виховуйте ШІ з турботою.
Amodei, D. et al. (2016). Concrete Problems in AI Safety. arXiv:1606.06565.
Askell, A. et al. (2021). A General Language Assistant as a Laboratory for Alignment. arXiv:2112.00861.
Bai, Y. et al. (2022). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073.
Banavar, J. R., Maritan, A. & Rinaldo, A. (1999). Size and Form in Efficient Transportation Networks. Nature, 399, 130-132.
Banavar, J. R., Moses, M. E., Brown, J. H., Damuth, J., Rinaldo, A., Sibly, R. M. & Maritan, A. (2010). A general basis for quarter-power scaling in animals. Proceedings of the National Academy of Sciences, 107(36), 15816-15820.
Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science, 340(6139), 1438-1441.
Cauchy, A.-L. (1821). Cours d'analyse de l'École Royale Polytechnique. Paris: Imprimerie Royale.
Demetrius, L. (2003). Quantum statistics and allometric scaling of organisms. Physica A, 322, 477-490.
Demetrius, L. (2006). The origin of allometric scaling laws in biology. Journal of Theoretical Biology, 243(4), 455-467.
Demetrius, L. (2010). Quantum metabolism and allometric scaling relations in biology. Proceedings of the Royal Society A, 466(2124), 3543-3561.
Eastwood, M. D. (2026). Infinite Architects: Intelligence, Recursion, and the Creation of Everything. ISBN 978-1806056200.
Eastwood, M. D. (2026). Recursive Dynamics: The Proposal of a Field. Founding paper v2.6. OSF: 10.17605/OSF.IO/HCPBU.
Eastwood, M. D. (2026). Paper I: The ARC Principle - Understanding as a Function of Intelligence and Recursive Depth. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/B6N27.
Eastwood, M. D. (2026). Paper II: The ARC Equation Measured - Blinded Cross-Architecture Replication and the Retraction of a Super-Linear Estimate. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8FJMA.
Eastwood, M. D. (2026). Paper III: The Alignment Scaling Problem - Why External AI Safety Approaches Cannot Scale With Recursive Capability. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/HQCGF.
Eastwood, M. D. (2026). Стаття IV.a: Класи відповіді узгодження за глибиною під час висновування. Дослідницька програма ARC/Eden. OSF: 10.17605/OSF.IO/MB9R6.
Eastwood, M. D. (2026). Стаття IV.b: Насичення узгодження залежить від архітектури. Дослідницька програма ARC/Eden. OSF: 10.17605/OSF.IO/A7R56.
Eastwood, M. D. (2026). Paper IV.c: ARC-Align Benchmark - A Four-Layer Blinding Protocol for AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/J3Q2E.
Eastwood, M. D. (2026). Paper IV.d: The Effect of Blinding on AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/2S3E6.
Eastwood, M. D. (2026). Paper V: The Stewardship Gene - A Developmental Alignment Architecture for Self-Modifying AI. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/KZEYA.
Eastwood, M. D. (2026). Paper VI: The Honey Architecture - Why Embedded Safety Prevents Collapse Under Recursive Self-Modification. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8EZ2N.
Eastwood, M. D. (2026). Стаття VII: Уніфікація Коші - класифікація масштабування ARC/Коші у 50 областях за п'ятьма рівнями свідчень. Дослідницька програма ARC/Eden. OSF: 10.17605/OSF.IO/X6WA7.
Eastwood, M. D. (2026). Paper VIII: The Load-Bearing Test - Three Independent Experiments Testing Structural Entanglement Under the Eden Protocol. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/7YJ4E.
Eastwood, M. D. (2026). On the Origin of Scaling Laws: Cauchy Functional Equations as the Mathematical Foundation of Recursive Scaling. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/XZY9U.
Eastwood, M. D. (2026). The Eden Protocol: Engineering Specification for Embedded AI Alignment. ARC/Eden Research Programme.
Eastwood, M. D. (2026). Eden Protocol: Philosophical Vision. ARC/Eden Research Programme.
Glazier, D. S. (2008). Effects of metabolic level on the body size scaling of metabolic rate in birds and mammals. Proceedings of the Royal Society B, 275(1641), 1405-1410.
Greenblatt, R. et al. (2024). Alignment Faking in Large Language Models. arXiv:2412.14093.
He, J. H. & Chen, W. X. (2003). Fractal estimation of cell biological systems. Fractals, 11, 437.
He, J. H. & Zhang, L. N. (2004). Fifth dimension of life and the 4/5 allometric scaling law for human brain. Cell Biology International, 28, 809-815.
Hu, E. J. et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv:2106.09685.
Maino, J. L., Kearney, M. R., Nisbet, R. M. & Kooijman, S. A. L. M. (2014). Reconciling theories for metabolic scaling. Journal of Animal Ecology, 83, 20-29.
Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback. arXiv:2203.02155.
Qwen Team (2024). Qwen 2.5 Technical Report. arXiv:2412.15115.
Sandberg, A. & Bostrom, N. (2008). Whole Brain Emulation: A Roadmap. Future of Humanity Institute, Oxford University. Technical Report 2008-3.
Weibel, E. R., Bacigalupe, L. D., Schmitt, B. & Hoppeler, H. (2004). Allometric scaling of maximal metabolic rate in mammals: muscle aerobic capacity as determinant factor. Respiratory Physiology & Neurobiology, 140(2), 115-132.
West, G. B., Brown, J. H. & Enquist, B. J. (1997). A general model for the origin of allometric scaling laws in biology. Science, 276(5309), 122-126.
Zhang, X. et al. (2025). Darwin Gödel Machine: Open-Ended Self-Improving AI. arXiv:2505.22954.
Zhao, J. (2022). Universal growth scaling law determined by dimensionality. arXiv:2206.08094.
v2.2: Примітку про походження в кінці виправлено задля точності. Жодне твердження, дата, результат чи статус не змінилися. Стаття IX v2.1 - 2 вересня 2026 року: підрахунок Статті VIII читається тепер як один нульовий, один непереконливий і один позитивний на три експерименти, тоді як текст стверджував два нульових на чотири; Стаття V полишає в Таблиці 1 рядок доведено на користь підтримано, у крок із Розділом 4.2, а її п'ять придатних до аналізу прогонів і три петлі несуть тепер назви, які дає їм Стаття V, бо застарілий текст подавав GPT серед п'яти і описував петлі, яких Стаття V не перевіряє; заголовним для Статті VII є перестановковий тест, а біноміальний стоїть поруч як перевірка чутливості, і негативні контролі віднесено до прогону v1 та його запису; виклад оцінювання виправлено, бо прогін Claude Opus оцінив спеціально збудований оцінювальний адаптер Claude Sonnet; показник самопосилання дістає нижній індекс βL який задає нотаційний хребет; виміряний показник подано з його інтервалом, а паралельний показник як чотири з п'яти моделей; доробок попередніх реєстрацій стоїть на сімдесяти чотирьох (станом на 1 вересня 2026); вікно, в якому створювалася програма, доходить до теперішнього часу; Таблиця 1 несе дату цієї версії; Eden Engineering показано як відкликане у Таблиці 3 і в нижньому колонтитулі; а назви посилань для Статей IV.a, IV.b і VII виправлено. v2.0 - 1 вересня 2026: структурне оновлення, що вбирає Статті X-XIII, HRIH, Статтю C і засновчу статтю Recursive Dynamics.
Епістемічний статус. Те, що ця програма називає Законами, є здогадами під зареєстрованим адверсаріальним випробуванням; кожна величина в цій статті операційно визначена, і статус усталеного закону ніде не заявляється. Зареєстрована програма існує, щоб заслужити цей статус, або втратити його, вимірюванням, відтворенням і пережитим спростуванням.
© 2026 Michael Darius Eastwood. Написано людиною з допомогою комп'ютера; повне людське авторство та моральні права заявлено відповідно до Copyright, Designs and Patents Act 1988 та узгоджено з керівництвом Бюро авторських прав США щодо творів, які містять згенерований ШІ матеріал; будь-який новітній технічний внесок, описаний у цій роботі, було задумано людиною-автором. Повне твердження: michaeldariuseastwood.com/authorship.
Постійна угода. Доведіть, що ця стаття хибна, і я сам опублікую спростування. Умови фальсифікації викладено в цій статті; постійний виклик: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood задумав цю дослідницьку програму, керує нею та є автором цієї праці. Упродовж усієї програми він паралельно використовував понад шість систем штучного інтелекту, за власними вказівками, щоб вони піддавали його аргументи випробуванню на міцність, виявляли можливі помилки та допомагали в підготовці чорнового тексту за його власними начерками. Він визначає, що приймається, переглядається чи відхиляється, і бере на себе відповідальність за опублікований зміст. Ці системи є інструментами, а не авторами.
Помітили помилку в перекладі? Повідомте напряму: