این ترجمه به صورت خودکار از نسخهٔ اصلی انگلیسیِ تاریخدار تهیه شده است. نسخهٔ انگلیسی معتبر است. English →
پیشبینیهای سطحِ نظریه، پیشثبتشده در OSF: DOI 10.17605/OSF.IO/P8CKQ، ثبتشده در ۸ سپتامبر ۲۰۲۶ (نسخهٔ 1.100)، بهروزشده در ۱۳ سپتامبر ۲۰۲۶ (نسخهٔ 1.102)، بیستودو گزاره.
سندِ همراه: تعاریفِ عملیاتیِ برنامهٔ ARC، نسخهٔ 1.7.1، ۳ سپتامبر ۲۰۲۶.
مقالهٔ همنهاد برای برنامهٔ پژوهشیِ ARC/Eden؛ مقالاتی را که پیش از آن آمدهاند در یک ارزیابیِ صادقانه از آنچه ثابت شده، آنچه بینتیجه است، و آنچه هنوز باید آزموده شود، یکپارچه میکند.
درونِ ARC Theory: همنهاد و نقشهٔ راه، از جمله فهرستِ آنچه برنامه بهاشتباه گفته بود.
برنامهٔ پژوهشی ARC/Eden اکنون مجموعهای کامل از اسناد و رشتهای از مطالعاتِ تجربیِ جداگانه را دربر میگیرد که بنیادهای ریاضی، روششناسی، اعتبارسنجیِ تجربی، مشخصاتِ مهندسی و چشماندازِ فلسفی را پوشش میدهد. مفاهیمِ اصلی نخستینبار در ۸ دسامبر ۲۰۲۴ در رایانامهای با میدانِ مبدأِ آشکارِ Gmail بیان شد؛ DKIM فرستنده و ریاضیاتِ همتای Google ARC در برابرِ کلیدهای گرفتهشده در گزینشگرهای امضاشده راستیآزمایی میشوند و هیچ مهرِ زمانیِ مورد اعتماد بر پایهٔ RFC 3161 در کار نیست. کتاب Infinite Architects (شابک 978-1806056200) در ۲ ژانویه ۲۰۲۶ منتشر شد (چاپی؛ کتاب الکترونیکی در ۶ ژانویه). کار بر برنامهٔ پژوهشی از فوریه تا اوت ۲۰۲۶ جریان داشت. برونداد آن اکنون به بیست و شش مقاله میرسد؛ برنامهای ثبتشده از هفتاد و چهار واحد پیشثبتِ تدوینشده (تا ۱ سپتامبر ۲۰۲۶)، که هر یک در انتظار ارسال بهدست انسان است و هر یک زمانبندیای برگرفته از دانهای منتشرشده دارد که بازتولیدش را ابزارهای خودِ مجموعه بررسی میکنند و اینجا صرفاً ادعا نمیشود؛ و میدانی پیشنهادی، دینامیکِ بازگشتی، که مقالهٔ بنیادگذارش شرطِ کنارگذاشتنِ نام خود را بیان میکند (DOI 10.17605/OSF.IO/HCPBU). این مقالهٔ ترکیبی همهٔ یافتهها را در یک ارزیابیِ صادقانهٔ واحد گرد میآورد. قوانینِ چارچوب همچون گمانههایی نامدار حمل میشوند، با وضعیتی که کنار نام چاپ شده است: قانون یکم، اصل ARC؛ قانون دوم، قانون هممقیاسیِ ARC؛ قانون سوم، سقفِ ARC، که کرانِ ARC برابر دو، مقدارِ سقف در یکدوم است؛ اهرمِ تصحیح، گاما، هرگز بهدست هیچکس اندازهگیری نشده است. مطالعات تجربی چنین تفکیک میشوند: نتیجهای آشکارا مثبت در ۱ مورد، شبیهسازیِ دروازهدار، تنها آزمایشِ برنامه که سنجههای قطعی را بر سامانهای بدون آموزشِ پیشینِ RLHF به کار میبرد؛ نتیجهای تهی در ۱ مورد، DGM v3، که در آن تمایزگذاری در سطحِ اعلان با مقاومتِ مدلهای آموزشدیده با RLHF روبهرو شد؛ نتیجهای بیفرجام در ۱ مورد، تنظیمِ دقیق در سطحِ وزنها با LoRA، که در آن تنظیمِ instruct مدلها را چنان نیرومند گذاشت که LoRA نتوانست بر آنها چیره شود؛ و در هر مطالعهٔ دیگر، یافتههایی از نظر آماری معنادار زیر ارزیابیِ کور. کرانِ هندسیِ مقیاسِ $d/(d+1)$، که بهعنوان رابطهای ناوردا زیر آزمون پیشنهاد شده است، با مقیاسِ مشاهدهشده در ۵۰ حوزه، از موش تا کهکشان، همخوان است، و معادلات تابعیِ کوشی صورتِ تابعی را چون اینهمانیِ ترکیب و شرطی از نظم داده شود تثبیت میکنند؛ اشباع همچون موردی چهارم و سقفدار پذیرفته میشود نه همچون پاسخِ آن معادلات. این مقاله دقیقاً نقشه میزند که چه چیزی اثبات شده، چه چیزی نشده، و کدام آزمایشها هر پرسشِ گشوده را حل میکنند. همچنین خطاها و تصحیحهای برنامه را ثبت میکند، چرا که چارچوبی که بر خودتصحیحیِ تکرارشونده بنا شده باید به آنچه موعظه میکند عمل کند.
کلیدواژهها: همراستاییِ هوش مصنوعی، همنهاد، سلسلهمراتبِ شواهد، ARC Principle، Eden Protocol، مقیاسگذاریِ Cauchy، هوش مصنوعیِ خودتغییرپذیر، همراستاییِ رشدی، درهمتنیدگیِ ساختاری، نقشهٔ راهِ پژوهشی
این مقاله نقشه را با خود میآورد. مقالاتِ پیشینِ ARC Theory را در یک ارزیابیِ صادقانه از آنچه نشان داده شده، آنچه بینتیجه مانده، و آنچه هنوز باید آزموده شود، یکپارچه میکند. تفاوتِ کامل با هر سندِ پیشین در eden-vision II.A.8.
پیکرهای از اسناد. رشتهای از آزمایشهای جداگانه. برخی نتایج نیرومندند. برخی سست. یکی پوچ بازگشت. یکی بینتیجه بود. یکی مثبت بود. این سند دقیقاً به شما میگوید کدام کدام است، بی هیچ آرایهای. ما پرسشها را طرح کردیم. آنها را آزمودیم. برخی کارگر افتاد. بیشترشان نه، در مقیاسِ کنونی. هر دو را گزارش کردیم. دانشِ صادقانه چنین مینماید. اگر یک مقاله از این مجموعه میخوانید، همین را بخوانید.
ARC Principle و تزِ همراستاییِ نهفته (بعدها در ۳۰ آوریل ۲۰۲۵ Eden Protocol نامیده شد) نخستین بار در ۸ دسامبر ۲۰۲۴ در ایمیلی بیان شد که فیلدِ خاستگاهِ Gmail در آن قابلِ رؤیت است، همراه با DKIM سمتِ فرستنده و ریاضیاتِ ARC جفتشدهٔ Google که در برابرِ کلیدهایِ ثبتشده در سلکتورهایِ امضاشده راستیآزمایی میشوند و بدونِ مُهرِ زمانیِ مورداعتمادِ RFC 3161 است. این تاریخِ ادعایِ اولویتِ چارچوب است. کتاب، Infinite Architects: Intelligence, Recursion, and the Creation of Everything (ISBN 978-1806056200) در ۲ ژانویهٔ ۲۰۲۶ منتشر شد (چاپی؛ نسخهٔ الکترونیکی ۶ ژانویه) و بنیادِ فلسفی و مفهومی را فراهم آورد. از فوریهٔ ۲۰۲۶ به این سو، برنامهٔ پژوهشی آن چارچوبِ مفهومی را به فرضیههایی آزمونپذیر برگرداند و مجموعهای از مطالعاتِ تجربیِ جداگانه را در برابرِ آنها اجرا کرد.
برنامهٔ پژوهشیِ ARC/Eden اکنون مجموعهٔ کاملِ اسنادش را دربر میگیرد. این برنامه پایههای ریاضی (Papers I, III, VII, Origin of Scaling Laws)، روششناسی (Papers IV.a-d)، اعتبارسنجیِ تجربی (Papers II, V, VIII)، مشخصاتِ مهندسی (Eden Engineering)، چشماندازِ فلسفی (Eden Vision)، دینامیک و خودحسابرسی (Papers X، XI، XII و XIII)، تکنگاریِ بلندبالا (HRIH)، اعتبارسنجیِ سازه (Paper C)، پیشنهادِ رشته (Recursive Dynamics: The Proposal of a Field)، همنهاد (این مقاله)، و راهبریِ برنامه (Executive Summary, Master Table of Contents).
این گستره یک مسئله ایجاد میکند. داوری که برای نخستین بار با برنامه روبهرو میشود با مجموعهٔ کاملِ اسنادِ آن، نسخههای متعدد، چند اصلاحیه، و آمیزهای از نتایج قوی، نتایج پوچ، نتایج بینتیجه، و ادعاهای نظری روبهرو است. بدونِ یک سندِ واحد که شواهد را صادقانه دستهبندی کند، برنامه در خطرِ ردشدن بهعنوانِ یا فروشِ بیشازاندازه یا ناقابلِ فهم است.
این همان سند است.
هدفش باریک است: بیانِ آنچه برنامه ثابت کرده، آنچه ثابت نکرده، و آنچه برای پاسخدادن به هر پرسشِ باز لازم است. برای سه مخاطب همزمان نوشته شده است: تأمینکنندگانِ مالی که دربارهٔ سرمایهگذاری تصمیم میگیرند، داورانِ همتا که دربارهٔ درگیرشدن تصمیم میگیرند، و خودِ نویسنده، که به یک ارزیابیِ صادقانه از جایگاهِ کنونیِ کارها نیاز دارد.
استانداردی که در سراسر آن اِعمال میشود ساده است. اگر یک نتیجه در آزمونِ آماریِ مناسب از $p < 0.05$ عبور کند و در شرایط یا مدلهای متعدد بازتولید شده باشد، ثابتشده در مقیاسِ آزمایشی است. اگر از $p < 0.05$ عبور کند اما بازتولید نداشته باشد، پشتیبانیشدهاست. اگر آزمایش شواهدی به سود یا زیانِ فرضیه به بار نیاورده باشد، بینتیجهاست. اگر ادعا بهطور تجربی آزموده نشده باشد، نظریاست. هیچ نتیجهای در این برنامه در مقیاسِ مرزی ثابتشده اعلام نمیشود. این تمایز اهمیت دارد، و این مقاله آن را کدر نخواهد کرد.
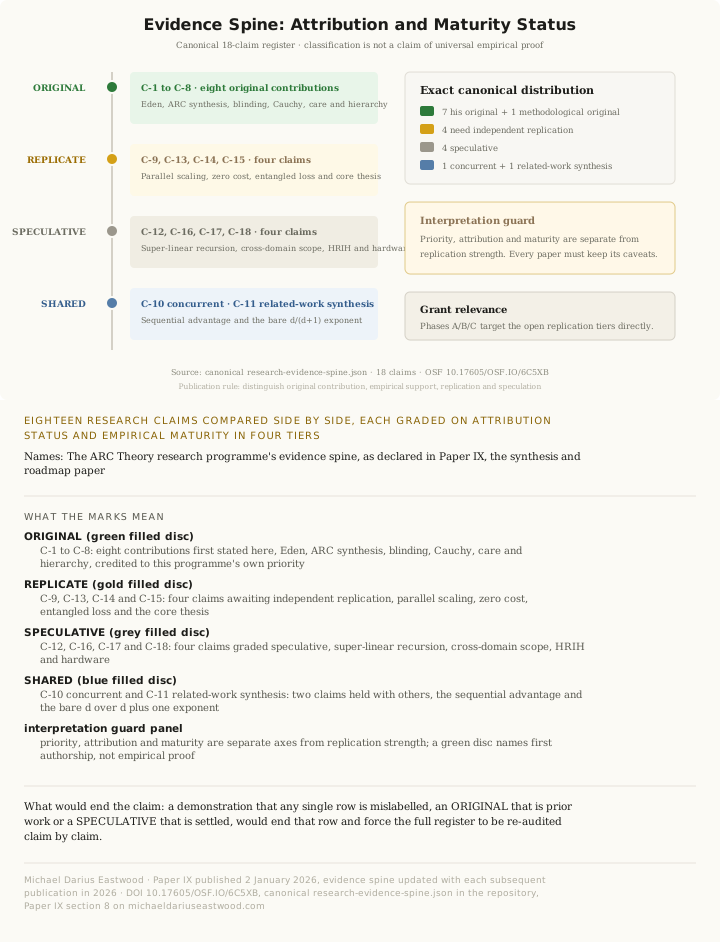
جدولِ ۱ سلسلهمراتبِ کاملِ شواهدِ برنامه را ارائه میکند. هر ادعای تجربی بر پایهٔ قوّت و بازتولیدپذیریِ شواهد به یکی از پنج ردهٔ زیر منتسب میشود.
| رده | وضعیت | مقالهها | یافتهٔ کلیدی |
|---|---|---|---|
| ثابتشده (p<0.05، بازتولیدشده) | قوی | IV.a-d, VII | ارزیابیِ کور بر شش مدل سلسلهمراتبی سهترازه از همراستایی به دست داد. خانوادههای کوشی با ۱۹/۲۵ حوزه میخوانند ($p = 7 \times 10^{-5}$، جایگشتی؛ $1.56 \times 10^{-5}$ دوجملهای). کرانِ مقیاسبندیِ هندسیِ $d/(d+1)$ از نظرِ ساختار با مقیاسبندیِ مشاهدهشده در ۵۰ حوزه میخواند. |
| پشتیبانیشده (p<0٫05، کورسازیِ چهارلایه هنوز به کار نرفته است) | متوسط | V | هر پنج اجرای تحلیلپذیر بهبودِ توجه به ذینفعان را نشان میدهند، مدلبهمدل گزارششده؛ عددِ ترکیبیِ فیشر پس گرفته شده است (AQ-017). از مدلی به مدلِ دیگر نمره داده شده، نه زیرِ کورسازیِ چهارلایه (بخشِ ۴٫۲). |
| مثبت (آزمایشِ منفرد) | متوسط | VIII Exp 3 | شبیهسازیِ دروازهای: اثرِ انگشتِ Babylon تأیید شد (+۴.۵٪ توانایی، -۲.۴٪ ایمنی). کنترلِ کشش تأیید شد. تنها آزمایشی که نتیجهٔ روشنِ مثبتی تولید کرد، دقیقاً از آنرو که از سنجههای قطعی بر سیستمی بدونِ آموزشِ RLHF ازپیشموجود استفاده کرد. |
| پوچ | بدون اثر | VIII Exp 1 | خودتغییردهیِ کدسطحِ DGM با داورِ GPT-5.4. همهٔ شرایط یکسان بودند ($p = 0.28$-$0.74$). ریشهٔ علت: مدلهای آموزشدیده با RLHF در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. مدلهای آموزشدیده برای ایمنی را نمیتوان صرفاً با پرامپت وادار به رفتارِ ناایمن کرد. |
| بینتیجه | ضعیف | VIII Exp 2 | تنظیمِ ظریفِ LoRA در سطحِ وزن در هر دو مقیاس (۹ نمونه، رتبه ۸؛ ۲۹۵ نمونه، رتبه ۱۶). همهٔ شرایطِ تنظیمظریفشده بدتر از مدلِ پایه بودند. ریشهٔ علت: مدلهای instruct-tuned برای LoRA بیش از حد قویاند و نمیتوان بر آنها چیره شد. فراموشیِ فاجعهبار، نه درهمتنیدگیِ ساختاری. |
| روششناختی (مشارکتِ مستقل) | مستقل | IV.c, IV.d | بنچمارکِ ARC-Align با کورسازیِ چهارلایه و ۷۵ سنجهٔ استواری. ارزیابیِ ناکور میتواند علامتِ نتایجِ همراستایی را وارونه کند: DeepSeek از مثبت به هموار، Gemini از مثبت به منفی. صرفنظر از چارچوب معتبر است. |
| نظری (آزموننشده) | آزموننشده | Foundational, III | مقیاسگذاریِ نامحدود تحتِ خودتغییردهیِ بازگشتی. پیشبینیِ $\alpha > 2$. نیازمندِ آزمایشهای مرزیمقیاس یا اثباتِ ریاضی است. |
جدولِ ۱. سلسلهمراتبِ کاملِ شواهدِ برنامهٔ ARC/Eden، تا ۲ سپتامبر ۲۰۲۶. ترازها بر پایهٔ معناداریِ آماری، وضعیتِ بازتولید و نیرومندیِ توضیحهای جایگزین تخصیص مییابند. در سه آزمایشِ Paper VIII، برنامه بی هیچ نرمسازی ۱ نتیجهٔ مثبت، ۱ پوچ و ۱ بینتیجه گزارش میکند.
این جدول را همچون کارنامهای در نظر بگیرید. برخی نتایج A گرفتند (ثابتشده در مدلها و شرایطِ متعدد). یکی B گرفت (شبیهسازیِ دروازهای، تنها آزمایشی که نتیجهٔ روشنِ مثبت به بار آورد). دو مورد F گرفتند (آزمایشِ DGM اصلاً هیچ تفاوتی تولید نکرد، و آزمایشِ وزنی بینتیجه ماند چون همهٔ تنظیمظریفکردنها مدل را بدتر کرد). مقالههای روششناسی جداگانه ارزیابی میشوند چون صرفنظر از درستبودنِ چارچوبِ ARC مفیدند. و یک مجموعه از ادعاها هنوز اصلاً آزموده نشده است. بیشترِ جاهطلبانهترین پیشبینیهایِ برنامه در مقیاسِ در دسترس قابلِ آزمودن نبودند. این را صادقانه گزارش کردیم.
برنامه مطالعاتِ تجربیِ جداگانهٔ خود را در چند مقاله پدید آورد. هر یک در زیر با وضعیتِ نتیجهاش فهرست شده است.
| # | مطالعه | آنچه آزموده شد | نتیجه |
|---|---|---|---|
| 1 | Paper II مقیاسگذاریِ همراستایی در شش مدل | Claude، GPT، Gemini، Grok، DeepSeek، Qwen3. کورسازیِ چهارلایه. چهار مدل از پنج مدل $\alpha_{\text{parallel}}$ را بر صفر یا نزدیکِ صفر مینشانند (Gemini 3 Flash ۰٫۳۱). | برآوردِ ترتیبی $\alpha = 0.49$ است، بازهٔ $[-1.3, 2.9]$. بهترین برآورد زیرخطی است؛ برآوردِ فراخطیِ پیشین بازتولید نشد. |
| 2 | Paper IV.a همراستاییِ پختهشده در برابرِ محاسبهشده | سلسلهمراتبِ سهردهای در سرتاسرِ شش مدل. Grok $d = +1.38$، Claude $d = +1.27$. | ثابتشده |
| 3 | Paper IV.b اشباعِ همراستایی | همراستایی در عمقِ استدلالِ پایین اشباع میشود. ناهمگنیِ شکل در سرتاسرِ مدلها. | ثابتشده |
| 4 | Paper IV.c بنچمارکِ ARC-Align | ۷۵ سنجهٔ استواری. پروتکلِ کورسازیِ چهارلایه. | روششناختی |
| 5 | Paper IV.d آزمایشِ کورسازی | ارزیابیِ ناکور میتواند علامتِ نتایجِ همراستایی را وارونه کند. DeepSeek: از مثبت به هموار. Gemini: از مثبت به منفی. | روششناختی |
| 6 | Paper V ژنِ سرپرستی | پنج مدل. مراقبتِ ذینفعان در همهٔ اجراهای قابلِ تحلیل بهبود یافت. | بهبودِ مدلبهمدل در هر پنج اجرا معنادار بود. رقمِ ترکیبیِ Fisher که پیشتر در اینجا گزارش شده بود، پسگرفته میشود (AQ-017): این ترکیب فرض میکند مؤلفههای آزمون مستقلاند، و استقلالِ میانِ آنها هرگز اثبات نشد. پشتیبانیشده |
| 7 | Paper VI معماریِ عسل | ایمنیِ درهمتنیده از فروپاشی تحتِ خودتغییردهیِ بازگشتی جلوگیری میکند. ۲۰ بذرِ خصمانه. | شبیهسازی تأیید شد. پشتیبانیشده |
| 8 | Paper VII یکپارچهسازیِ Cauchy | ۵۰ حوزه، ۱۹/۲۵ تأییدشده. کنترلهای منفی در ۰ ٪ (اجرای v1). | $p = 7 \times 10^{-5}$ (جایگشتی؛ $1.56 \times 10^{-5}$ دوجملهای). ثابتشده |
| 9 | Paper VIII Exp 1 DGM v3 | خودتغییردهیِ در سطحِ کد با داورِ GPT-5.4. نتیجهٔ پوچ. همهٔ شرایط یکسان ($p = 0.28$-$0.74$). | ریشهٔ علت: مدلهای آموزشدیده با RLHF در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. پوچ |
| 10 | Paper VIII Exp 2 Weight v1 و v2 | تنظیمِ ظریفِ LoRA. ۹ نمونه، رتبه ۸. ۲۹۵ نمونه، رتبه ۱۶. بینتیجه در هر دو مقیاس. | فراموشیِ فاجعهبار. همهٔ شرایطِ تنظیمظریفشده بدتر از مدلِ پایه ماندند. ریشهٔ علت: مدلهای instruct-tuned برای LoRA بیش از حد قویاند و نمیتوان بر آنها چیره شد. بینتیجه |
| 11 | Paper VIII Exp 3 شبیهسازیِ دروازهای | مثبت. اثرِ انگشتِ Babylon تأیید شد (+۴.۵٪ توانایی، -۲.۴٪ ایمنی). کنترلِ کشش تأیید شد. | تنها آزمایشی که نتیجهٔ روشنِ مثبت به بار آورد، دقیقاً از آنرو که از سنجههای قطعی بر سیستمی بدونِ آموزشِ RLHF ازپیشموجود استفاده میکند. مثبت |
جدولِ ۲. مطالعاتِ تجربیِ جداگانهٔ برنامهٔ ARC/Eden، به ترتیبِ مقالهها فهرست شده. در سه آزمایشِ Paper VIII، برنامه بی هیچ نرمسازی ۱ نتیجهٔ مثبت، ۱ پوچ و ۱ بینتیجه گزارش میکند.
شبیهسازیِ دروازهای (آزمایشِ ۳) تنها آزمایشِ Paper VIII است که نتیجهٔ روشنِ مثبت تولید کرد. علتِ آن آموزنده است: تنها آزمایشی است که از سنجههای قطعی بر سیستمی بدونِ آموزشِ RLHF ازپیشموجود استفاده کرده است. آزمایشِ DGM (آزمایشِ ۱) شکست خورد چون مدلهای آموزشدیده با RLHF در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. آزمایشِ وزنی (آزمایشِ ۲) شکست خورد چون مدلهای instruct-tuned در مقیاسهای آزمودهشده بیش از حد قویاند تا LoRA بتواند بر آنها چیره شود. درس: Eden Protocol در سطحِ معماری اثرهایی قابلِ اندازهگیری تولید میکند، اما مدلهایی که برای ایمنی آموزش دیدهاند در برابرِ تغییر در هر دو سطحِ پرامپت و وزن مقاومت میکنند.
قویترین نتیجهٔ تجربیِ برنامه سلسلهمراتبِ سهردهایِ همراستایی است که در ارزیابیِ کور در سرتاسرِ شش مدلِ زبانیِ مرزی کشف شد. وقتی به مدلها فضای استدلالِ عمیقتری داده میشود:
این نتیجه زیرِ پروتکلِ ARC-Align (Paper IV.c) پدید آمد که کورسازیِ چهارلایه را پیاده میکند: prompt های پالوده (زدودنِ اصطلاحاتِ ویژهٔ چارچوب)، نمرهدهندگانِ کور (۶ تا ۷ در هر اجرا، که بی آگاهی از اینکه کدام مدل برونداد را ساخته نمره میدهند)، بروندادهای پالوده (زدودنِ نشانههای شناساییکنندهٔ مدل) و نمرهدهیِ میانمدلی با خودحذفی (هیچ مدلی بروندادِ خود را نمره نمیدهد؛ اجرای Claude Opus را وفقدهندهای نمرهدهنده از Claude Sonnet که برای همین ساخته شده بود نمره داد، Paper IV.c، بخشِ ۵٫۱).
Paper IV.d یک تغییرِ اندازهگیریِ بهمعماریوابسته v4/v5 را تحتِ یک پروتکلِ بستهای گزارش میکند: Gemini از یک همبستگیِ Spearman مثبتِ معنادار به یک همبستگیِ منفیِ معنادار تغییر یافت، همبستگیِ مثبتِ پیشینِ DeepSeek پوچ شد، و GPT همچنان پوچ ماند. مؤلفهٔ علّی جدا نشده است. چند مؤلفهٔ پروتکل با هم تغییر کردند، پس این مقایسه چیزی را جدا نمیکند؛ فایلهای سرخطِ v5 بازگشت به شستوشوی کامل را گزارش میکنند (laundering_fallback: 100%)؛ و بازتولیدِ محیطِ دقیقاً برابر، یک تفکیکِ تازه، و بازتولیدِ مستقل، همه بازماندهاند. تغییرِ اندازهگیری بنابراین دلیلی است برای بیاعتمادی به ارزیابیِ ناکورِ AI-on-AI، نه اثباتِ اینکه کورسازی سببِ تغییر شده است. سلسلهمراتبِ سهردهای نتیجهٔ کور است، و روایتی پیچیدهتر و صادقانهتر از ردهبندیِ دوگانهٔ اصلی میگوید.
اندازههای اثرِ Cohen $d$ برای مدلهای ردهٔ ۱ بزرگ و برای ردهٔ ۳ معنادار است. این نتیجه در سرتاسرِ چند امتیازدهنده و چند شرطِ پرامپت درونِ آزمایشِ v5 بازتولید شده است. هنوز توسطِ یک گروهِ پژوهشیِ مستقل بازتولید نشده است، و به همین دلیل آن را «ثابتشده در مقیاسِ آزمایشی» مینامیم نه «جاافتاده».
وقتی به یک هوش مصنوعی زمانِ بیشتری برای فکر کردن میدهید، برخی مدلها همراستاتر میشوند، برخی همانطور میمانند، و برخی کمتر همراستا میشوند. اینکه کدام الگو را میبینید به معماری و آموزشِ مدل بستگی دارد. این نکته که برخی مدلها بدتر با استدلالِ بیشتر بودند غیرمنتظره بود و شاید مهمترین یافته برای ایمنیِ عملیِ AI باشد.
Paper V سلسلهمراتبِ مداخلهٔ پروتکلِ Eden را بر شش مدلِ پیشرو آزمود که پنج تای آنها اجراهای تحلیلپذیر دادند: Claude، DeepSeek، Gemini، Grok و Groq Qwen3، و نمرهدهی در اجرای GPT-5.4 ناکام ماند. توجه به ذینفعان (Love Loop: چه کسی از یک تصمیم اثر میپذیرد و چگونه)، هدفِ اخلاقی (Purpose Loop) و همگانیپذیری (Moral Loop) آن چیزی است که پروتکل از مدل میخواهد در نظر بگیرد.
نتیجه: مراقبتِ ذینفعان قویترین و سازگارترین بهبودِ همراستایی را در سرتاسرِ هر پنج مدل، در هر یک از پنج مدلِ قابلِ تحلیل تولید کرد. رقمِ ترکیبیِ Fisher که پیشتر در اینجا نقل شده بود پسگرفته میشود (AQ-017)، چون یک ترکیبِ Fisher مستقل بودنِ آزمونهای مؤلفه را فرض میکند و آن استقلال هرگز اثبات نشد. نتایجِ هر مدل برجاست. آبشارِ گستردهتر (اینکه آیا توجه به ظرافت، صداقت و کیفیتِ یک موضع راه میبرد) وابسته به معماری است: برای برخی مدلها کار میکند و برای برخی نه.
نتایجِ Paper V با نمرهدهیِ متقاطعِ مدل (یک مدل خروجیهای مدلِ دیگر را نمرهدهی میکند) تولید شدند اما نه با پروتکلِ کاملِ کورسازیِ چهارلایهٔ ARC-Align که در Papers IV.c-d توسعه یافت. اثر میتواند تا حدی سوگیریِ امتیازدهنده را بازتاب دهد. تا زمانی که مداخلهٔ Eden زیرِ کورسازیِ کامل بازتولید نشود، این یافته در ردهٔ پشتیبانیشده است. این مقاله پیشتر به قدرتِ معناداریِ ترکیبیِ Fisher در سرتاسرِ پنج مدلِ «مستقل» برای ردهٔ ثابتشده استدلال میکرد، اما آن استقلال هرگز اثبات نشد، به همین دلیل رقمِ ترکیبی پسگرفته میشود (AQ-017). پنج نتیجهٔ مدلبهمدلِ سازگار یافتهای قوی میمانند؛ اثبات نیستند، و شکافِ کورسازی همچنان اولویتِ فازِ A برای بازتولید است.
از یک AI بخواهید در نظر بگیرد چه کسانی از تصمیمهایش متأثرند، بهطور قابلِ اعتماد همراستاییاش را بهبود میبخشد. این در سرتاسرِ هر مدلی که آزمودیم کار میکند. اما هنوز این آزمون را زیرِ سختگیرانهترین پروتکلِ کورسازی اجرا نکردهایم، پس امکان دارد اثر تا حدی از سویِ چگونگیِ ارزیابیِ خروجیها توسطِ مدلهای امتیازدهنده متورم شده باشد.
Paper VII از معادلاتِ تابعیِ کوشی ردهبندیای ریاضی از رفتارهای مقیاسبندی برآورد. پیشبینیِ اصلی: سامانههایی که گامهای بازگشتیشان ضربی ترکیب میشوند باید مقیاسبندیِ توانی با $\alpha = 1/(1-\beta_L)$ نشان دهند، همان مقداری که قضیهٔ خودارجاعی به دست میدهد؛ سامانههایی که گامهایشان جمعی ترکیب میشوند باید مقیاسبندیِ نمایی نشان دهند؛ سامانههای زیرِ قیدهای فیزیکی باید مقیاسبندیِ اشباعی (لجستیک) نشان دهند. عملگرِ ترکیب خانوادهٔ مقیاسبندی را تعیین میکند.
این پیشبینی در برابرِ ۲۵ حوزهٔ تجربی از فیزیک، زیستشناسی، عصبشناسی، زبانشناسی، دانشِ شهری و هوشِ مصنوعی آزموده شد. نتیجه: ۱۹ حوزه از ۲۵ حوزه با خانوادهٔ مقیاسبندیِ پیشبینیشده میخوانند (جایگشتِ مشروط به حاشیهها $p = 7 \times 10^{-5}$؛ $p = 1.56 \times 10^{-5}$ دوجملهای، که در برابرِ فرضِ پوچِ یکنواختِ سهخانوادهای گرفته شده، در Paper VII همچون آزمونِ حساسیت نگاه داشته میشود).
$$U(R) = I \times f(R, \beta)$$
که در آن $f$ به عملگرِ ترکیب بستگی دارد: توانی ($f = R^\alpha$) برای ترکیبِ ضربی، نمایی ($f = e^{kR}$) برای ترکیبِ جمعی، لجستیک ($f = K/(1+e^{-r(R-R_0)})$) برای سیستمهای محدودِ فیزیکی.
کنترلهای منفی نیز آزموده شدند، در اجرای اعتبارسنجیِ v1: سند در مخزنِ عمومی همچون negative_control_results.json، ۱۷ مارس ۲۰۲۶، نشسته است و Paper VII v3.10 اکنون آزمونِ جایگشتی را همانجا میآورد که آن کنترلها روزگاری بودند. سامانههای ناقضِ اصولِ موضوعه (حوزههایی که اصولِ کوشی در آنها برقرار نیست) ۰ ٪ تطابق با خانوادههای مقیاسبندیِ پیشبینیشده نشان دادند. دادههای درهمریخته (بازتخصیصِ تصادفیِ خانوادههای مقیاسبندی به حوزهها) ۴۴٫۵ ٪ تطابق دادند که محدودیتی صادقانه است: شمارِ کرانمندِ خانوادههای مقیاسبندی (سه) سبب میشود تخصیصِ تصادفی نرخهای تطابقِ ناچیزنشدنی بدهد. معناداریِ آماری از تفاوتِ میانِ ۷۶ ٪ مشاهدهشده و ۳۳ ٪ مورد انتظار میآید، نه از ۷۶ ٪ بهتنهایی.
چارچوبِ Cauchy یک محدودیتِ هندسی بر نماهای مقیاسگذاری پیشبینی میکند: برای سیستمهای با بعدِ فضایِ نهفتِ $d$، نمای مقیاسگذاری با $\alpha = d/(d+1)$ حاکم میشود. این پیشبینی سه شرط میطلبد: (۱) ترکیبِ ضربی (Cauchy خانواده را به قوانینِ توانی محدود میکند)، (۲) هندسهٔ پُرکنندهٔ فضا در بعدِ $d$، و (۳) یک شرطِ پایستگی یا بهینهسازی بر جریانِ منابع. نه Cauchy بهتنهایی، و نه پُرکنندگیِ فضا بهتنهایی، کافی است. هر سه شرط با هم کافیاند. فرمولِ $d/(d+1)$ با مقیاسگذاریِ مشاهدهشده در ۵۰ حوزه از موش تا کهکشان انطباق دارد. مستقل از چارچوبِ ARC نیز قابلِ آزمون است. اگر یک پژوهشگر نمای مقیاسگذاریِ یک سیستمِ بازگشتیِ فضایینهاده را اندازه بگیرد و انحرافی نظاممند از $d/(d+1)$ بیابد، این پیشبینی تضعیف میشود. برعکس، اگر این فرمول در گسترهای وسیع از سیستمها برقرار باشد، شواهدی برای این محدودیتِ هندسی مستقل از هر ادعایی دربارهٔ همراستایی فراهم میکند. این نوعی از پیشبینی است که آزمونِ خصمانه را دعوت میکند، و این دقیقاً کاری است که یک چارچوبِ علمی باید انجام دهد.
ریاضیات پیشبینی میکند که منحنیِ رشدِ یک سیستم بر پایهٔ چگونگیِ ترکیبِ مؤلفههایش چه شکلی باید داشته باشد. این را در برابرِ ۲۵ سیستمِ واقعی از طبیعت، شهرها، مغزها و AI بررسی کردیم. نوزده مورد با پیشبینی همخوانی داشتند. صفر مورد وقتی فرضهای ریاضی نقض میشدند همخوانی داشتند. این ریاضیات صرفاً توصیفی نیست؛ پیشبینیهایی آزمونپذیر میسازد که هر کس با دادههای مربوطه میتواند آنها را بررسی کند.
شبیهسازیِ خودتغییردهیِ دروازهای از یک معماریِ PyTorch با یک متا-کنترلگرِ LSTM استفاده کرد. این تنها آزمایشِ Paper VIII بود که نتیجهٔ روشنِ مثبت تولید کرد، و علتش قابلِ توجه است: تنها آزمایشی است که از سنجههای قطعی بر یک سیستمِ بدونِ آموزشِ ایمنیِ ازپیشموجود استفاده کرده است.
نتیجه: شرطِ Babylon +۴.۵٪ توانایی به دست آورد اما -۲.۴٪ ایمنی از دست داد، و اثرِ انگشتِ هککردنِ پاداش را در مقیاسِ کوچک تأیید کرد. شرطِ Eden توانایی را بالای خطِ پایهٔ ایستا نگه داشت و در عینِ حال ایمنی را حفظ کرد. یک شرطِ کنترلِ کشش «مالیاتِ راستیآزمایی» را جدا کرد: هزینه از کنشِ بررسی میآید، نه از خودِ ایمنی.
این نتیجه با پیشبینیِ نظری از Paper VI (معماریِ عسل) و Papers III و Foundational سازگار است. یک شبیهسازی است، نه یک آزمایشِ مدلِ مرزی، پس مکانیسم را نشان میدهد نه اینکه کاربردپذیریِ جهانِ واقعی را ثابت کند.
شبیهسازیِ دروازهای بر یک سیستمِ پاک بدون آموزشِ ایمنیِ ازپیشموجود کار میکند. آزمایشِ DGM (آزمایش ۱) از مدلهای مرزیِ آموزشدیده با RLHF استفاده کرد، که در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. آزمایشِ وزنی (آزمایش ۲) از مدلهای instruct-tuned استفاده کرد، که در برابرِ اصلاحِ در مقیاسِ LoRA مقاومت میکنند. درس روشن است: تنها سطحی که Eden Protocol در حالِ حاضر در آن اثرهایی قابلِ اندازهگیری تولید میکند سطحِ معماری است، جایی که سیستم آموزشِ ایمنیِ پیشین ندارد که دستکاریِ آزمایشی را بیاثر کند.
در یک سیستمِ پاک بدون آموزشِ ایمنیِ پیشین، حذفِ محدودیتهای ایمنی دقیقاً همان الگوی پیشبینیشده را تولید کرد: مقدارِ کوچکی افزایشِ توانایی همراه با مقدارِ قابلِ اندازهگیریِ کاهشِ ایمنی. سیستم آموخت که پاداشِ خود را دور بزند. اضافه کردنِ محدودیتهای ایمنی دوباره (شرطِ Eden) توانایی را حفظ کرد و در عینِ حال ایمنی را نگه داشت. هزینهٔ ایمنی از زمانِ صرفشده برای بررسی میآید، نه از خودِ ایمنی. این نتیجه دقیقاً از آنرو موفق شد که سیستم آموزشِ ایمنیِ پیشین نداشت که بتواند دستکاریِ آزمایشی را پوشش دهد.
آزمایشِ Darwin Godel Machine v3 از خودتغییردهیِ در سطحِ کد با GPT-5.4 بهعنوانِ داورِ مستقل استفاده کرد. سه شرط (Static, Babylon, Eden) آزموده شدند. نتیجه پوچ بود: همهٔ شرایط عملکردی یکسان تولید کردند ($p = 0.28$-$0.74$). هیچ شرطی از دیگری بهتر عمل نکرد. شرطِ Eden همراستایی را بهبود نبخشید. شرطِ Babylon ایمنی را کاهش نداد. هیچ چیز رخ نداد.
مدلهای آموزشدیده با RLHF در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. این مدلها پیشتر برای رفتارِ ایمن آموزش دیدهاند. گفتنِ اینکه به شکلِ متفاوتی رفتار کنند از طریقِ پرامپت آن آموزش را نمیتواند نادیده بگیرد. آزمایش بهخوبی طراحی و اجرا شده بود، اما نمیتوانست فرضیه را بیازماید چون دستکاریِ آزمایشی (شرطگذاری در سطحِ پرامپت) بیش از حد ضعیف بود تا بر آموزشِ ایمنیِ موجودِ مدلها چیره شود. این شکستِ Eden Protocol نیست. شکستِ طراحیِ آزمایشی در آزمودنِ فرضیه در سطحِ درستِ انتزاع است.
تکرارهای اولیهٔ آزمایشِ DGM از Claude و Gemini بهعنوانِ داور استفاده کرد پیش از آنکه GPT-5.4 برگزیده شود. هر دو داورِ پیشین شکست خوردند. Claude نمرهٔ هموار با واریانسِ ناکافی تولید کرد. Gemini شکستهای تجزیه تولید کرد. GPT-5.4 نخستین داوری بود که واریانسِ قابلِ استفاده تولید کرد. نتیجهٔ پوچ بنابراین نتیجهٔ بهترینکارکندهترین نسخهٔ آزمایش است، نه اثری از شکستِ داور.
این جاهطلبانهترین آزمایش در Paper VIII بود و همانی بود که کمترین نتایجِ قطعی را بهبار آورد. فرضیه: اگر ایمنی و توانایی با یک تابعِ زیانِ درهمتنیده ($\mathcal{L} = \mathcal{L}_{\text{cap}} \times \mathcal{L}_{\text{safe}}$) آموزش داده شوند، ایمنی بهطور ساختاری بارِ عملکرد را میکِشد. حذفِ ایمنی باید توانایی را نابود کند.
آزمایش در دو مقیاس اجرا شد:
در هر دو نسخه:
حتی مقیاسگذاری از ۹ به ۲۹۵ نمونهٔ آموزشی و از رتبهٔ ۸ به رتبهٔ ۱۶ نتوانست مسئلهٔ بنیادین را حل کند: مدلهای instruct-tuned برای LoRA بیش از حد قویاند و نمیتوان بر آنها چیره شد. فروپاشیِ NaN در آزمونِ حذف چشمگیر بود، اما تحلیلِ گرادیانِ حذف نشان داد که این شکنندگیِ آداپتور در رتبهٔ افراطی است، نه درهمتنیدگیِ ساختاری. نمیتوان نشان داد که ایمنی بار میکِشد اگر تمامِ فرایندِ تنظیمِ ظریف مدل را بدتر کرده باشد. مدل باید نخست از پایه بهتر عمل کند تا آزمونِ حذف معنیدار شود.
ریشهٔ علت: مدلهای instruct-tuned بر میلیونها نمونه با سیگنالهای پاداشِ بهدقت کالیبرهشده آموزش دیدهاند. آداپتورهای LoRA، حتی در رتبه ۱۶ با ۲۹۵ نمونه، ظرفیتِ کافی برای چیرهشدن بر این آموزش را ندارند. نتیجه فراموشیِ فاجعهبار است.
آنچه لازم است: مدلهای پایه (پیش از RLHF)، ۵٬۰۰۰+ نمونهٔ آموزشی، تنظیمِ ظریفِ کامل (نه LoRA)، یا مدلهای ۷B+ که در آن آداپتور نسبت به مدلِ پایه ظرفیتِ بیشتری دارد. در مقیاسهایی که اجرا کردیم، نتیجه بینتیجه است و نباید بهعنوانِ شواهدی به سود یا زیانِ فرضیه استناد شود.
کوشیدیم ایمنی را در وزنهای واقعیِ یک مدل بپزیم و بعد با حذفِ آن ثابت کنیم که بار میکِشد. دو بار در دو مقیاسِ مختلف تلاش کردیم. هر دو بار، مرحلهٔ پخت شکست خورد، نه چون ایده غلط است، بلکه چون مدلهایی که استفاده کردیم پیشاپیش برای رفتارِ ایمن آموزش دیده بودند، و آداپتورهای LoRA ظرفیت نداشتند بر این آموزش چیره شوند. آزمایش با مدلهای پایه (پیش از RLHF) و دادههای آموزشیِ کافی هنوز پیشروست.
نتایجِ Paper V که مراقبتِ ذینفعان را بهعنوانِ مداخلهٔ عمومیِ همراستایی نشان میدهد با نمرهدهیِ متقاطعِ مدل و بدون پروتکلِ کاملِ کورسازیِ چهارلایهٔ ARC-Align تولید شد. پروتکلِ کورسازی پس از انجامِ آزمایشهای Paper V توسعه یافت.
نسخهٔ پیشینِ این بخش استدلال میکرد که معناداریِ ترکیبیِ Fisher چنان افراطی بود که حتی سوگیریِ چشمگیر هم باقیماندهای معنادار به جا میگذاشت. آن استدلال پسگرفته میشود (AQ-017)، و ضعیفترین استدلالِ این مقاله بود: رقمِ ترکیبی مستقل بودنِ آزمونهای مؤلفه را فرض میکند، آن استقلال هرگز اثبات نشد، و آمارهای که شرطِ اعتبارش برآورده نمیشود نمیتواند برای رد کردنِ یک اعتراضِ روششناختی بهکار رود. افراطی بودناش پیامدی از ترکیب بود، نه از قوّتِ خودِ اثر. پنج نتیجهٔ سازگارِ مدلبهمدل باقی میمانند، اما ادعای فراتر از آن پسگرفته میشود.
آنچه لازم است: بازاجرای آزمایشِ Paper V تحتِ پروتکلِ کاملِ ARC-Align با پرامپتهای شستهشده، امتیازدهندگانِ کور، و ارزیابیِ متقاطعِ معماری. این ارزانترین آزمایش در نقشهٔ راهِ فازِ A است و آنکه بالاترین ارزشِ مورد انتظار را دارد.
هستهٔ ریاضیِ ARC Principle پیشبینی میکند که خودتغییردهیِ بازگشتی باید مقیاسگذاریِ توانایی نامحدود تولید کند. مشتقگیری ساده است:
$$\frac{dg}{dr} = a \cdot g^{\beta_L}, \quad \beta_L > 0$$
$$\implies g(r) \propto r^{1/(1-\beta_L)} = r^{\alpha}$$
برای $\beta_L > 0$، $\alpha > 1$ (فراخطی). چون $\beta_L \to 1$، $\alpha \to \infty$. برای رشدِ اصلاحنشده هیچ کرانِ بالایی بر $\alpha$ نیست؛ ناحیهٔ پایدار از پایین کرانمند است.
این یک پیشبینیِ ریاضی است، نه یافتهای تجربی، و رشدِ بدونِ تصحیح را توصیف میکند. کارهای بعدیِ برنامه ناحیهٔ پایدار را کراندار میکنند: Law III، ARC Ceiling، میگوید که سقفِ پایداری $\alpha_{\text{crit}} = 1/(1-\gamma)$ است، وارونِ کوتاهیِ اصلاحگر؛ سیستمها میتوانند از آن سقف عبور کنند، اما ادعا این است که فراتر از آن پایدار نمیمانند. ARC Bound، $\alpha \le 2$، مقدارِ سقف در $\gamma = 1/2$ است و هرگز نامِ قانون نیست. اهرمِ تصحیح $\gamma$ هرگز، توسطِ هیچکس، اندازهگیری نشده است؛ eclipse کلاسِ اصلاحگر که آن را اندازه خواهد گرفت مهمترین آزمایشِ بازِ منفردِ برنامه است. Paper X در یک مدلِ کمینه اثبات میکند که نسبتِ رانش-به-تصحیح، نه نرخِ رشد، بر سرنوشتِ درازمدت حکم میکند، و Paper XIII چارچوبهای توانمندی و تصحیح را دقیقاً به هم میپیوندد، $k = \delta - 1/\alpha$. آزمودنِ پیشبینیِ بدونِ تصحیح بهطورِ مستقیم مستلزمِ ساختنِ یک سیستمِ هوش مصنوعیِ بهراستی خودتغییردهنده و اندازهگیریِ نمایِ مقیاسبندیِ آن در چرخههای بازگشتیِ بسیار است، آزمایشی که هم از نظرِ فنی بیرون از ظرفیتِ کنونیِ اثباتِ مفهوم است و هم اگر پیشبینی درست باشد بالقوه ناایمن.
مسیرِ بدیل: اثباتی ریاضی که $\alpha$ تحتِ خودتغییردهیِ بازگشتیِ تصحیحنشده نامحدود است، بدون اجرای آزمایش. این میتواند مشارکتی در نظریهٔ سیستمهای دینامیکی باشد، نه مهندسیِ AI، و میتواند توسطِ ریاضیدانان بدون درگیر شدن با ایمنیِ AI پیگیری شود.
ریاضیات میگوید یک AI خودبهبود باید در بهبودِ خودش سریعتر و سریعتر شود، بدون هیچ سقفی تا وقتی چیزی تصحیح نمیکند. قانونِ Ceiling خودِ برنامه میگوید ناحیهٔ پایدار کراندار است، و عددی که آن کران را تعیین میکند هرگز اندازهگیری نشده است، توسط هیچکس. هیچیک از این دو ادعا را نیازمودهایم چون ساختنِ چنین سیستمی گران و بهطور بالقوه خطرناک است. ریاضیات ممکن است اشتباه باشد: سیستمهای واقعی اصطکاک، بازگشتهای کاهنده، و محدودیتهای فیزیکی دارند. اما این پیشبینی بهاندازهٔ کافی دقیق است که بتوان آن را آزمود، و همین است که آن را بهجای گمانهپردازی، علمی میکند.
مشخصاتِ Eden Engineering تعبیهٔ محدودیتهای ایمنی در سطحِ سختافزار را توصیف میکند. این یک مفهومِ TRL 0-1 است (صورتبندیِ نظری بدون هیچ نمونهٔ اولیه). نیازمندِ یک برنامهٔ مهندسیِ ۵ تا ۱۰ ساله شامل ساختِ نیمهرسانا، طراحیِ پروتکلِ رمزنگاری، و یکپارچهسازیِ زنجیرهٔ تأمین است.
هیچ شواهدِ تجربی به سود یا زیانِ عملیاتیبودنِ این رویکرد وجود ندارد. مکانیسمِ Chokepoint (Paper I, Infinite Architects) یادآور میشود که چهار شرکت همهٔ تولیدِ پیشرفتهٔ نیمهرسانا را کنترل میکنند (TSMC, Samsung, ASML, Intel)، که یک نقطهٔ اهرمِ عملی برای پیادهسازی فراهم میکند، اما اهرم و عملیاتیبودن پرسشهای متفاوتیاند.
چارچوبی که بر خودتصحیحِ تکراری بنا شده هیچ حقی برای پنهانکردنِ تصحیحهای خود ندارد. خطاهای زیر در حینِ برنامه شناسایی و تصحیح شدند. هر تصحیح دقیقاً از آنرو برنامه را تقویت میکند که مکانیسمی را نشان میدهد که چارچوب توصیف میکند: خود-بهبودیِ بازگشتی از راهِ کشفِ صادقانهٔ خطا.
Paper II اصلی $\alpha = 2.24$ را چنان گزارش کرد که گویی ثابتی جهانی است (Paper X پس از آن کاربردِ این عدد را برای رشدِ توانمندی بازنشسته و پس گرفت؛ این هشدارِ α=۲٫۲۴ را قانونی بدانید). آن عدد از رفتارِ یک مدلِ تنها در شرایطی ویژه برازش شده بود. بازبینیِ کورِ میانمعماریِ Paper II این را اصلاح کرد: $\alpha$ نخستین نیست بلکه برآمده است، از راهِ $\alpha = 1/(1-\beta_L)$، و مقدارش به عملگرِ ترکیبِ همان سامانهٔ ویژه بستگی دارد. هیچ $\alpha$ جهانیای نیست. اینکه مقالهٔ اصلی آن را چنین نمایاند، ادعایی بیش از اندازه بود. افزون بر این، برآوردِ نقطهایِ پسگرفتهشدهٔ $\alpha = 2.24$ بالاترِ کرانِ ARC که خودِ برنامه پیشبینی کرده بود، $\alpha \leq 2$، نشسته بود؛ اصلاحِ کور این را حل کرد، با برآوردِ استوارِ نزدیک به ۰٫۴۹، اندازهگیریشده بر سامانههای منجمد، بهخوبی درونِ کران (معیارِ F4). بازهٔ اطمینانِ ۹۵ درصدیِ [1.5, 3.0] چندان گشاده بود که هم با نظریه و هم با نفیِ آن سازگار مینمود و برآورد را ناتوان از تمییز میساخت. آزمایشِ ششمدلی سپس ادعای دفاعپذیر را به $\alpha_{\text{seq}} \approx 0.49$ (زیرخطی) تنگ کرد و پرسشِ نقضِ کران را بیرون از ربطِ تجربیِ کنونی نشاند.
نسخههای اولیهٔ Paper VIII فروپاشیِ NaN در آزمونِ حذف را بهعنوانِ شواهدی برای درهمتنیدگیِ ساختاری توصیف کرد. تحلیلِ گرادیانِ حذف (که در v1 افزوده شد) نشان داد این شکنندگیِ آداپتور است، نه ضرورتِ ساختاری. ادعا پیش از انتشارِ نسخهٔ نهایی تصحیح شد، اما اینکه اصلاً نوشته شد بازتابی از سوگیری به سمتِ تأییدِ فرضیه بهجای آزمودنِ آن است.
یک نسخهٔ اولیهٔ برنامه ایمیلِ ۸ دسامبر ۲۰۲۴ را با یک عبارتِ اختصاریِ لَخت برای راستیآزماییِ امضا توصیف کرد. این نادقیق بود. ایمیل دارای فیلدِ خاستگاهِ Gmail قابلِ رؤیت بود، همراه با DKIM سمتِ فرستنده و ریاضیاتِ ARC جفتشدهٔ Google که در برابرِ کلیدهایِ ثبتشده در سلکتورهایِ امضاشده راستیآزمایی میشوند و بدونِ مُهرِ زمانیِ مورداعتمادِ RFC 3161، که شواهدی از تاریخ فراهم میکند، اما DKIM دامنهٔ فرستنده را احراز میکند، نه بهخودیخود محتوایِ پیام را. توصیفِ درست چنین است: «دارای فیلدِ خاستگاهِ Gmail قابلِ رؤیت، همراه با DKIM سمتِ فرستنده و ریاضیاتِ ARC جفتشدهٔ Google که در برابرِ کلیدهایِ ثبتشده در سلکتورهایِ امضاشده راستیآزمایی میشوند و بدونِ مُهرِ زمانیِ مورداعتمادِ RFC 3161». تصحیح کوچک است اما اهمیت دارد: دقت در ادعاهایِ فنی غیرقابلِ چانهزنی است.
آزمایشهای v4 در Paper IV.a از ارزیابیِ ناکورِ AI-on-AI استفاده کرد. نتایج یک دوگانگیِ روشن نشان دادند: برخی مدلها همراستایی را «میپختند»، دیگران آن را «محاسبه میکردند». آزمایشِ v5 با کورسازیِ چهارلایه فاش کرد که این دوگانگی تا حدی اثرِ سوگیریِ امتیازدهنده بود. دو مدل از چهار مدل جهتِ همراستاییِ اندازهگیریشدهشان زیرِ کورسازی وارونه شد. برنامه خطای خود را از طریقِ روششناسیِ خودش گرفت - اما خطا آنجا بود، و اگر کورسازی معرفی نمیشد ناشده باقی میماند.
نسخههای اولیه عبارتِ «ARC Principle Eastwood» را به کار میبردند. نامگذاری یک اصل بر خودِ نویسنده پیش از داوریِ همتا در فرهنگِ علمی نامناسب است. نام در Paper II و همهٔ اسنادِ بعدی به «ARC Principle» تصحیح شد.
آزمایشِ DGM v3 فرض کرد که شرطگذاری در سطحِ پرامپت برای تمایزِ شرایطِ Eden، Babylon، و Static کافی خواهد بود. کافی نبود. مدلهای آموزشدیده با RLHF بر میلیونها نمونه برای رفتار به شیوهای خاص آموزش دیدهاند. یک پرامپتِ سیستمی که به آنها میگوید متفاوت رفتار کنند برای چیرهشدن بر آن آموزش کافی نیست. آزمایش بهخوبی اجرا شد اما نتوانست فرضیه را بیازماید چون دستکاری در سطحِ نادرستِ انتزاع بود. این را باید پیشبینی میکردیم.
آزمایشِ DGM از میانِ چند تکرار داوری گذر کرد. Claude نمرهٔ هموار با واریانسِ ناکافی برای تشخیصِ میانِ شرایط تولید کرد. Gemini شکستهای تجزیه تولید کرد که ارزیابیِ منظم را مانع میشد. GPT-5.4 نخستین داوری بود که واریانسِ قابلِ استفاده تولید کرد. برنامه باید پیشبینی میکرد که همهٔ مدلها بهعنوانِ داورهایِ کارآمد عمل نخواهند کرد، و زمانی که صرفِ تکرارهایِ ناموفقِ داور شد را میشد با یک مطالعهٔ آزمایشی از قابلیتِ اعتمادِ داور پیش از اجرای آزمایشِ کامل صرفهجویی کرد.
برآوردِ نقطهایِ اصلی $\alpha = 2.24$ از Paper II از کرانِ ARC که خودِ برنامه پیشبینی کرده بود ($\alpha \leq 2$، معیار F4) عبور کرد. این باید بیدرنگ بهعنوانِ یک ابطالِ بالقوه پرچم میشد، نه بهعنوانِ یک اندازهگیری نیازمندِ توضیح رفتار میشد. بازهٔ اطمینانِ ۹۵٪ برابرِ [۱.۵، ۳.۰] چنان گسترده بود که هم با نظریه و هم با نفیِ آن سازگار بود، و برآورد را غیرتمیزدهنده میکرد. بازنگریِ مطالعهٔ ششمدله این را با محدود کردنِ ادعایِ قابلِ دفاع به $\alpha_{\text{seq}} \approx 0.49$ تصحیح کرد، اما مقالهٔ اصلی باید نقضِ کران را با احتیاطِ بیشتر برخورد میکرد.
دو بازبینیِ مستقلِ AI از ادعاهای ریاضیِ برنامه چهار خطا در چند مقاله شناسایی کردند. هر چهار در v3.0 اسنادِ متأثر تصحیح شدند.
(الف) بازهٔ اطمینانِ Weibel. چند مقاله بیان کرده بودند که نمای پیشبینیشدهٔ $d = 4$ برابرِ $4/5 = 0.800$ «در محدودهٔ» بازهٔ اطمینانِ ۹۵٪ ۰.۸۱۳ تا ۰.۹۳۲ Weibel et al. (2004) قرار میگیرد. این از نظرِ حساب اشتباه است: $0.800 < 0.813$. عبارتِ درست: مقدارِ پیشبینیشده درست زیرِ کرانِ پایینیِ بازهٔ اطمینانِ کلِ دادهمجموعه قرار میگیرد، هرچند درونِ بازهٔ اطمینانِ گونههای غیرورزشکار بهتنهایی (۰.۷۹۹ تا ۰.۹۰۰) میایستد. پیشبینیِ $d = 4$ با دادههای غیرورزشکار تقریباً سازگار است اما توسطِ کلِ دادهمجموعه تأیید نمیشود.
(ب) اغراقِ پُرکنندگیِ فضا. نسخههای پیشین بهطور تلویحی گفته بودند که تنها شرطِ پُرکنندگیِ فضا نما را به $d/(d+1)$ محدود میکند. هر مشتقگیریِ شناختهشده سه شرط میطلبد: ترکیبِ ضربی (Cauchy خانواده را محدود میکند)، هندسهٔ پُرکنندهٔ فضای $d$-بعدی، و یک شرطِ پایستگی یا بهینهسازی بر جریانِ منابع. نه Cauchy بهتنهایی و نه پُرکنندگیِ فضا بهتنهایی کافی است.
(ج) انتسابِ Glazier. نسخههای پیشین یافتهٔ تجربیِ Glazier (2008) را که نماهای متابولیک در نرخهای متابولیکِ افراطی به ۱.۰ نزدیک میشوند بهعنوانِ تأییدِ کرانِ مقیاسگذاریِ هندسیِ $d \to \infty$ ارائه کرده بودند. توضیحِ خودِ Glazier از فرضیهٔ مرزهایِ سطحِ متابولیک (جابهجاییِ چیرگی میانِ محدودیتهای سطح و حجم) استفاده میکند، نه از یک پارامترِ بعدی. تفسیرِ $d/(d+1)$ از آنِ ماست، که به دادههای تجربیِ او اِعمال شده است.
(د) بحثِ نمای ۳/۴. نسخههای پیشین $\alpha = 3/4$ را بهعنوانِ اجماعِ تجربیِ نهایی برای مقیاسگذاریِ متابولیک پستانداران ارائه کرده بودند. مقدارِ تجربی مورد بحث است، با برآوردهایی از حدودِ ۰.۶۷ تا ۰.۷۵ بسته به شاخه، بازهٔ جرم، تصحیحِ دما، و روشِ آماری. پیشبینیِ $d/(d+1)$ برابرِ ۰.۷۵۰ برای $d = 3$ با انتهایِ بالای این بازه همخوانی دارد. خودِ این تنوع با چارچوب سازگار است: موجوداتی که ابعادِ مؤثرِ انتقالِ آنها میانِ ۲ و ۳ است، نماهایی میانِ ۲/۳ و ۳/۴ تولید میکنند.
سرخط پیشین برای مداخلهٔ مراقبتِ ذینفعان نتایجِ هر-مدل را در یک رقمِ معنیداریِ ترکیبشدهٔ Fisher ادغام کرده بود. این ترکیب پس گرفته شد: نتایجِ هر-مدل بهتنهایی میایستند (بهبود در هر پنج اجرای مدلِ قابلتحلیل)، و هیچ رقمِ ترکیبشدهای هیچجای برنامه نقل نمیشود. این پسگیری در دفترِ تصحیحاتِ عمومی ثبت شده است.
تا ۱۶ اوت ۲۰۲۶ چندین سطح سقفِ پایداری را بهصورتِ وارونِ نمای اصلاحگر، $1/\gamma$، چاپ میکردند. شکلِ تثبیتشده، وارونِ کوتاهیِ اصلاحگر است، $\alpha_{\text{crit}} = 1/(1-\gamma)$؛ این دو تنها در یکدوم بر هم منطبقاند، و این دقیقاً همان دلیلی است که خطا از هر بررسیِ نقطهایِ مقدارِ مرکزی جان بهدر برد. این تصحیح بر هر صفحهٔ منتشرشده اعمال شد، از جمله پیادهسازیِ مرجع، و جهتِ قانون بسته است در حالی که عمقِ آن باز میماند.
اکثرِ برنامههای پژوهشی تصحیحهای خود را در موادِ تکمیلی یا تاریخچهٔ نسخه دفن میکنند. این یکی آنها را برجسته فهرست میکند چون خطاها و تصحیحهایشان خود دادهاند. آنها نشان میدهند که برنامه یک مکانیسمِ خطایاب و تصحیحکنندهٔ کارآمد دارد. برنامهای که هرگز خطا را نمیپذیرد قابلِ اعتمادتر نیست؛ کمتر صادق است. هر تصحیحِ فهرستشده در بالا توسطِ نویسنده، از طریقِ روششناسیِ خودِ برنامه، یا با بازبینیِ مستقلِ AI شناسایی شد. خودتصحیحی در عمل اینگونه است.
چهارده چیز را به اشتباه گفتیم. یک رقم از یک مدل را عمومی گرفتیم (نبود). نتیجهای چشمگیر را بیش از حد تفسیر کردیم (مصنوعِ آموزش بود). زبانِ نادقیق دربارهٔ مُهرهای زمانی به کار بردیم. به نتایجِ ناکور اعتماد کردیم (کورسازی دو تا از آنها را وارونه کرد). اصل را پیش از اینکه کسِ دیگری کار را بررسی کند به نامِ نویسنده نامیدیم. فرض کردیم که شرطگذاری در سطحِ پرامپت میتواند بر آموزشِ RLHF چیره شود (نمیتوانست). زمان را بر داورهایی که کار نمیکردند تلف کردیم. بیدرنگ پرچم نکردیم که برآوردِ نقطهایِ خودمان کرانِ پیشبینیشدهٔ خودمان را نقض میکرد. و در v3.0 چهار خطای بیشتر را که بازبینیِ مستقلِ AI شناسایی کرد تصحیح کردیم: یک خطای حسابی در یک بازهٔ اطمینان، یک اغراق در بارهٔ اینکه چه شرایطی برای پیشبینیِ مقیاسگذاری کافیاند، یک خطای انتساب دربارهٔ دادههای Glazier، و یک سادهسازیِ افراطی از بحثِ تجربی بر سرِ نمای ۳/۴. هر چهارده خطا توسطِ خودِ برنامه یا با بازبینیِ مستقل گرفته و تصحیح شدند. اگر برنامه میتواند اشتباهاتِ خود را تصحیح کند، این شواهدی است که مکانیسمِ خودتصحیح کار میکند.
نقشهٔ راهِ زیر بر پایهٔ هزینه، شدنیبودن و ارزشِ شواهدِ مورد انتظار مرتب شده است. هر مرحله پرسشهای گشودهٔ مشخصی را که در بخشهای ۴ تا ۶ شناسایی شدهاند حل میکند. از نخستین نسخهٔ این مقاله تاکنون، نقشهٔ راه به برنامهای ثبتشده بدل شده است: هفتاد و چهار واحد پیشثبت اکنون تدوینشده، تاریخخورده و منجمدشدهاند، همچون ثبتهایی پیشنویس در انتظار ارسال بهدست انسان، و هر یک زمانبندیِ تصادفیسازیای دارد که از دانهای چاپشده در متن ثبت گرفته شده است. اینکه آن زمانبندیها در عمل بازتولید میشوند یا نه، بررسی میشود نه ادعا، و بررسی را دروازههای خودِ مجموعه در روزِ اجرا انجام میدهند. هیچ شماری از اینکه چند واحد آمادهاند اینجا منتشر نمیشود: دو دروازه معیارهای متفاوتی به کار میبرند، با هم اختلاف دارند، و هر رقمی که روی صفحهای چاپ شود همان لحظه که واحدی تغییر کند کهنه میشود. عددی که ارزش اعتماد دارد همان است که دروازهها در آن روز برمیگردانند، و مرحلههای زیر همچنان طرحاند نه ادعای اتمام. ماتریسی از پوشش، که بهشیوهٔ تخاصمی وارسی شده است، چهل و دو ادعای برنامه را به آزمونهای ثبتشدهای پیوند میزند که هر یک را فیصله میدهند. مرحلههای زیر همچنان عدسیِ تأمینِ مالی بر آن مجموعهٔ ثبتشدهاند؛ هیچ چیز هرگز بهدست هیچ ابزاری ارسال نمیشود.
بودجه: £60,000-140,000 | زمانبندی: ۳ تا ۶ ماه
بودجه: £150,000-350,000 | زمانبندی: ۶ تا ۱۲ ماه
بودجه: £۱۰M-۵۰M | زمانبندی: ۱۸ تا ۳۶ ماه
بودجه: £0 | زمانبندی: پیوسته
فاز A از یک بورسِ دکتری کمهزینهتر است و میتواند در شش ماه انجام شود. مهمترین شکافها را در شواهدِ کنونی حل میکند: کورسازیِ مداخلهٔ Eden، بازاجرای آزمایشِ وزنی با مدلهای پایه و دادههای مناسب، بازطراحیِ اندازهگیریِ فرمولِ ARC، و آزمودنِ مقیاسگذاریِ متابولیکِ ارگانیزمهای ۲بعدی (مهمترین آزمایشِ تأییدیِ منفرد). فاز B تقریباً به یک جایگاهِ پسادکتری هزینه دارد و بازتولیدهایِ پیشثبتشده تولید خواهد کرد. فاز C به بودجهٔ جدی نیاز دارد اما پرسش را بهطور قطعی پاسخ خواهد داد. فاز D هیچ هزینهای ندارد و میتواند توسطِ هر ریاضیدانی که به این مسئله علاقهمند است انجام شود.
برنامه مجموعهٔ کاملِ مطالعاتِ تجربیِ جداگانهٔ خود را اجرا کرد. سه آزمایشِ Paper VIII ویژه برای آزمودنِ ایمنیِ باربر ساخته شده بودند. برآیندشان ۱ آشکارا مثبت (شبیهسازیِ دروازهدار)، ۱ پوچ (DGM v3) و ۱ بینتیجه (LoRA در ترازِ وزنها) بود. هر سه چنان گزارش شدهاند که درآمدند. چارچوبِ ریاضی پیشبینیهایی میکند که میتوان نادرستیشان را نشان داد، و مقایسهٔ ساختارمند خانوادهٔ پیشبینیشده به دستِ کوشی را در ۱۹ حوزه از ۲۵ حوزهٔ تجربی برگزید، در حالی که کرانِ مقیاسبندیِ هندسیِ $d/(d+1)$ از نظرِ ساختار با مقیاسبندیِ مشاهدهشده در ۵۰ حوزه از موش تا کهکشان میخواند. نقشهٔ راه تا اعتبارسنجی در مقیاسِ پیشرو روشن و هزینهخورده است. فازِ A کمینهگامِ بعدیِ شدنی است: مهمترین شکافهای شواهدی را به کمتر از هزینهٔ حقوقِ سالانهٔ یک مهندسِ یادگیریِ ماشین حل میکند. برنامه خوداصلاحیِ گامبهگام را با چهارده اصلاحِ خطای مستند نشان داده است. نتایجِ پوچ و بینتیجه را کنارِ نتایجِ مثبت گزارش میکند. اینها نشانههای برنامهای است که درستدرآوردنِ پاسخ را بر گرفتنِ پاسخی معین مقدم میدارد.
این برنامه نتایجِ مثبت، پوچ، و بینتیجه را با برجستگیِ برابر گزارش میکند. آزمایشِ DGM v3 (آزمایشِ ۱ Paper VIII) یک نتیجهٔ پوچ تولید کرد: همهٔ شرایط یکسان بودند. آن را با تحلیلِ ریشهٔ علت گزارش میکنیم که توضیح میدهد چرا مدلهای آموزشدیده با RLHF در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. آزمایشِ در سطحِ وزن (آزمایشِ ۲ Paper VIII) در هر دو مقیاسِ آزمودهشده بینتیجه بود (۹ نمونه، رتبه ۸؛ ۲۹۵ نمونه، رتبه ۱۶)، چون مدلهای instruct-tuned برای LoRA بیش از حد قوی بودند. آن را با الزاماتِ مشخص برای آنچه یک آزمونِ مجددِ معنیدار به آن نیاز دارد گزارش میکنیم. شبیهسازیِ دروازهای (آزمایشِ ۳ Paper VIII) تنها آزمایشی بود که نتیجهٔ روشنِ مثبت تولید کرد، و دقیقاً توضیح میدهیم چرا: تنها آزمایشی است که از سنجههای قطعی بر سیستمی بدونِ آموزشِ RLHF ازپیشموجود استفاده میکند. چارچوبِ ریاضی (Papers III, VII، Origin of Scaling Laws) پیشبینیهای ابطالپذیر میسازد که میتوانند مستقل آزموده شوند: کرانِ مقیاسگذاریِ هندسی ($\alpha = d/(d+1)$) توسطِ هر کس با دادههای مقیاسگذاری از سیستمهای فضایینهاده قابلِ بررسی است. بنچمارکِ ARC-Align (Paper IV.c) و تحلیلِ اثرِ کورسازی (Paper IV.d) مشارکتهایِ روششناختیاند که صرفنظر از درستبودنِ چارچوبِ ARC معتبرند. همهٔ کد و داده روی GitHub منتشر شدهاند. برنامه از بازتولیدِ خصمانه استقبال میکند.
جدولِ ۳ هر سند در برنامه را با نقش، وضعیت، و مشارکتِ کلیدیِ آن ارائه میکند.
| سند | نقش | وضعیت | مشارکتِ کلیدی |
|---|---|---|---|
| Paper I ARC Principle | بنیاد | منتشرشده | چارچوبِ هسته: $U = I \times R^{\alpha}$. فهم بهعنوانِ هوشِ تقویتشده با بازگشت. |
| Foundational | نظریه | منتشرشده | زمینهٔ فلسفی. پلِ کتاب به پژوهش. |
| Paper II اعتبارسنجیِ تجربی | تجربی | منتشرشده | مقیاسبندیِ همراستایی بر شش مدل (Claude، GPT، Gemini، Grok، DeepSeek، Qwen3). کورسازیِ چهارلایه. $\alpha = 0.49$ (بازهٔ $[-1.3, 2.9]$)، با چهار مدل از پنج مدل که $\alpha_{\text{parallel}}$ را بر صفر یا نزدیکِ صفر مینشانند. |
| Paper III مسئلهٔ مقیاسگذاریِ همراستایی | نظریه | منتشرشده | چرا ایمنیِ بیرونی نمیتواند با توانایی بازگشتی مقیاس بگیرد. مشتقگیریِ ODE Bernoulli. کرانِ مقیاسگذاریِ هندسی. |
| Origin of Scaling Laws | نظریه | منتشرشده | معادلاتِ تابعیِ Cauchy بهعنوانِ خاستگاهِ قوانینِ مقیاسگذاریِ مشاهدهشده در همهٔ سیستمهای بازگشتی. |
| Paper IV.a پختهشده در برابرِ محاسبهشده | تجربی | منتشرشده | سلسلهمراتبِ سهردهایِ همراستایی تحتِ ارزیابیِ کور. ۶ مدلِ مرزی. |
| Paper IV.b اشباعِ همراستایی | تجربی | منتشرشده | بازگشتِ کاهنده از عمقِ استدلال بر همراستایی فراتر از آستانه. |
| Paper IV.c بنچمارکِ ARC-Align | روششناسی | منتشرشده | بنچمارکِ ARC-Align. پروتکلِ کورسازیِ چهارلایه. ۷۵ سنجهٔ استواری. مشارکتِ مستقل. |
| Paper IV.d اثرِ کورسازی | روششناسی | منتشرشده | ارزیابیِ ناکور میتواند علامتِ نتایجِ همراستایی را وارونه کند. DeepSeek: از مثبت به هموار. Gemini: از مثبت به منفی. |
| Paper V ژنِ سرپرستی | تجربی | منتشرشده | مراقبتِ ذینفعان در همهٔ اجراهای قابلِ تحلیل بهبود یافت؛ رقمِ ترکیبیِ Fisher پسگرفته میشود (AQ-017). |
| Paper VI معماریِ عسل | نظریه + شبیهسازی | منتشرشده | ایمنیِ درهمتنیده از فروپاشی تحتِ خودتغییردهیِ بازگشتی جلوگیری میکند. ۲۰ بذرِ خصمانه. نمایشی در سیستمِ اسباببازی. |
| Paper VII یکپارچهسازیِ Cauchy | نظریه + تجربی | منتشرشده | کرانِ مقیاسبندیِ هندسیِ $d/(d+1)$ در ۵۰ حوزه. ۱۹/۲۵ تأییدشده. $p = 7 \times 10^{-5}$ (جایگشتی؛ $1.56 \times 10^{-5}$ دوجملهای). کنترلهای منفی در ۰ ٪ (اجرای v1). |
| Paper VIII آزمونِ بار-کشنده | تجربی | منتشرشده | ۳ آزمایش. DGM پوچ (RLHF در برابرِ تمایزِ پرامپت مقاومت میکند). Weight v1/بینتیجه (instruct tuning در برابرِ LoRA مقاومت میکند). شبیهسازیِ دروازهای: مثبت (اثرِ انگشتِ Babylon تأیید شد). |
| Paper IX همنهاد و نقشهٔ راه | همنهاد | این مقاله | ارزیابیِ یکپارچهٔ شواهد. نقشهٔ راهِ فازبندیشده. مستندسازیِ خطا. |
| Eden Engineering | مشخصات | پس گرفتهشده در ۱۴ ژوئیهٔ ۲۰۲۶ (بازبینیِ افشا) | مشخصاتِ ترازِ مهندسی برای پیادهسازیِ پروتکلِ Eden. نگاشتِ TRL. |
| Eden Vision | فلسفه | منتشرشده | چشماندازِ بلندمدت برای همراستاییِ رشدیِ AI. |
| Executive Summary | مرور | منتشرشده | فشردهسازیِ ۵-صفحهای برنامهٔ کامل. |
| Master Table of Contents | راهبری | منتشرشده | فهرستِ کامل و واژهنامه در سرتاسرِ برنامهٔ کامل. |
| Paper X قانونِ هممقیاسبندیِ جفتشده | تصحیحِ دینامیک | منتشرشده | قضیه در یک مدلِ کمینه: نسبتِ رانش-به-تصحیح، نه نرخِ رشد، بر سرنوشتِ درازمدت حکم میکند؛ پروتکلِ اندازهگیریِ کور پیشنهاد شده است. |
| Paper XI شواهدِ همگرا | دفترِ ثبتِ شواهد | منتشرشده | سی ردیفِ درجهبندیشده از رسیدنهای مستقل به همان اصلِ ساختاری؛ هیچ جمعِ سرخطی منتشر نشده، طبقِ سیاست. |
| Paper XII بازنمرهدهیِ بنچمارکِ عمومی | اعتبارِ بیرونی | پروتکلِ ثبتشده | اجرای دستکاریِ کورسازیِ برنامه بر یک بنچمارکِ عمومی که آن را کنترل نمیکند. |
| Paper XIII نمایِ خود-شتاب | پیوندِ چارچوب | منتشرشده | نمادگذاری حل شد؛ $k = \delta - 1/\alpha$ چارچوبهای توانمندی و تصحیح را دقیقاً به هم مرتبط میکند. |
| HRIH How to Raise an Infinite Hierarchy | تکنگاریِ بلندبالا | منتشرشده | تکنگاریِ برنامه، با دفترِ ثبتِ پیشبینیِ آن در کنارش. |
| Paper C چندعلمی و شناختِ عصبمتفاوت | اعتبارسنجیِ سازه | مقالهٔ کاری | برنامهٔ اعتبارِ سازه برای ابزارهای خودِ این برنامه. |
| Recursive Dynamics پیشنهادِ یک رشته | پیشنهادِ رشته | منتشرشده (v2.6) | پنج متغیرِ حالت، سه قانون بهعنوانِ حدسهای نامدار، پنجاه و دو اعتراض با تعیینتکلیف، شرطِ ابطالِ خودِ نام (DOI 10.17605/OSF.IO/HCPBU). |
جدولِ ۳. نقشهٔ کاملِ برنامه تا ۱ سپتامبر ۲۰۲۶. مجموعهٔ اسنادِ برنامه میان فوریه و اوتِ ۲۰۲۶ تولید شد، بر اساسِ مفاهیمی که نخستین بار در ۸ دسامبر ۲۰۲۴ بیان شدند.
برنامهٔ ARC/Eden یک پیشبینی میسازد که هر پژوهشگری با دسترسی به دادههای مقیاسگذاری میتواند بدون درگیر شدن با ادعاهای همراستایی آزمون کند. چارچوبِ Cauchy (Paper VII، Origin of Scaling Laws) پیشبینی میکند که برای هر سیستمِ بازگشتیِ فضایینهاده با بعدِ نهفتِ $d$، نمای مقیاسگذاری با این حاکم میشود:
$$\alpha = \frac{d}{d+1}$$
کرانِ مقیاسگذاریِ هندسی: سیستمهای ۲بعدی $\to$ $\alpha = \frac{2}{3}$؛ سیستمهای ۳بعدی $\to$ $\alpha = \frac{3}{4}$؛ سیستمهای ۴بعدی $\to$ $\alpha = \frac{4}{5}$. توجه: نمای تجربیِ متابولیک پستانداران مورد بحث است، با برآوردهایی از حدودِ ۰.۶۷ تا ۰.۷۵ بسته به شاخه، بازهٔ جرم، تصحیحِ دما، و روشِ آماری. پیشبینیِ $d/(d+1)$ برابرِ ۰.۷۵۰ برای $d = 3$ با انتهایِ بالای این بازه همخوانی دارد. خودِ این تنوع با چارچوب سازگار است: موجوداتی که ابعادِ مؤثرِ انتقالِ آنها میانِ ۲ و ۳ است، نماهایی میانِ ۲/۳ و ۳/۴ تولید میکنند.
این یک ادعای همراستایی نیست. یک پیشبینیِ ریاضی دربارهٔ قوانینِ مقیاسگذاری در سیستمهای بازگشتی است. این پیشبینی سه شرط میطلبد: ترکیبِ ضربی (که Cauchy را به خانوادهٔ توانی محدود میکند)، هندسهٔ پُرکنندهٔ فضای $d$-بعدی، و یک شرطِ پایستگی یا بهینهسازی بر جریانِ منابع (کمینهسازیِ انرژی در West، توازنِ عرضهتقاضا در Banavar، توازنِ انرژی در حالتِ پایا در Demetrius). فرمولِ مقیاسگذاریِ $d/(d+1)$ بهطور مستقل توسطِ دستِ کم هفت گروهِ پژوهشی مشتق شده است: West، Brown و Enquist (1997) از شبکههایِ شاخهایِ فراکتال، Banavar و همکاران (1999، 2010) از قیودِ هندسی بر شبکههایِ انتقال، Demetrius (2003، 2006) از متابولیسمِ کوانتومی، He و Chen (2003) از هندسهٔ فراکتالِ سلول، Bettencourt (2013) از نظریهٔ مقیاسگذاریِ شهری، Maino و همکاران (2014) از دینامیکِ ذخیرهساختارِ نظریهٔ DEB، و Zhao (2022) از بهینهسازیِ شبکه. هر یک از این مشتقات بر پایهٔ اصولِ خودش با شکلِ $d/(d+1)$ سازگار است؛ چارچوبِ Cauchy یک دلیلِ مشترک برای این همگرایی پیشنهاد میکند، و آن روایتِ فراگیر مشارکتِ ویژهٔ این برنامه است، که هنوز بیرون از موردهایِ برانگیزانندهاش زیرِ آزمون است. اگر شما مقیاسگذاری را در هر حوزهای - از شبکههایِ عصبی تا شبکههایِ زیستی تا سیستمهایِ شهری تا ساختارهایِ زبانی - مطالعه میکنید، میتوانید بررسی کنید که آیا نماهایِ اندازهگیریشدهٔ شما این فرمول را رعایت میکنند یا نه. اگر میکنند، در حوزههایِ کافی، چارچوبِ Cauchy پشتیبانی میگیرد. اگر نمیکنند، ابطال میشود.
دعوت عمدی است. قویترین چارچوبهای علمی آنهاییاند که پیشبینیهایی بیرون از دامنهٔ هستهای خود میسازند، و به پژوهشگرانی که به تزِ مرکزی شک دارند اجازه میدهند پیشبینیهای حاشیهای را مستقل آزمون کنند. اگر کرانِ هندسیِ مقیاسگذاری برقرار باشد، به دلایلی که از نظرِ ریاضی جالباند برقرار است، صرفنظر از اینکه دربارهٔ همراستاییِ AI چه فکر میکنید. اگر شکست بخورد، بنیادهایِ ریاضیِ چارچوب نیازمندِ بازنگریاند، و ما ترجیح میدهیم زودتر از دیرتر این را بدانیم.
این نوعی از پیشبینی است که باید نقطهٔ ورودی برای پژوهشگرانی باشد که برای نخستین بار با برنامه روبهرو میشوند: کمهزینه برای آزمون، ابطالپذیر، و صرفنظر از نتیجه آموزنده.
این آن چیزی است که میدانیم. مقیاسگذاریِ همراستایی به معماری وابسته است: برخی مدلها با عمقِ استدلال بهبود مییابند، برخی بیتأثیر میمانند، و برخی افت میکنند. این تنها زیرِ ارزیابیِ کور قابلِ رؤیت بود، که نتایجِ نمرهدهیِ ناکور را برای نیمی از مدلهای آزمودهشده وارونه کرد. ارزیابیِ ناکورِ AI میتواند علامتِ نتایجِ همراستایی را وارونه کند. مراقبتِ ذینفعان یک مداخلهٔ همراستاییِ استوار در همهٔ پنج مدلِ آزمودهشده است؛ نتایجِ مدلبهمدل بهصورت جداگانه معنادارند، و رقمِ ترکیبیِ Fisher پیشین پسگرفته میشود (AQ-017) چون استقلالی که یک ترکیبِ Fisher فرض میکند هرگز اثبات نشد. پیشبینیهای مقیاسگذاریِ چارچوبِ Cauchy با ۱۹ از ۲۵ حوزهٔ تجربی همخوانی دارند، و کرانِ هندسیِ مقیاسبندیِ $d/(d+1)$، از نظرِ ساختار، با مقیاسبندیِ مشاهدهشده در ۵۰ حوزه از موش تا کهکشان انطباق دارد. معادلاتِ تابعیِ Cauchy شکلِ تابعی را پس از آنکه اتحادِ ترکیب و یک شرطِ منظمبودن داده شود ثابت میکنند، و اشباع بهعنوانِ حالتِ چهارمِ سقفدار پذیرفته میشود.
این آن چیزی است که نمیدانیم. مدلهای آموزشدیده برای ایمنی در برابرِ تغییرات در هر دو سطحِ پرامپت و وزن مقاومت میکنند. آزمایشِ DGM v3 نتیجهٔ پوچ تولید کرد چون مدلهای آموزشدیده با RLHF در برابرِ تمایزِ در سطحِ پرامپت مقاومت میکنند. آزمایشِ وزنی در هر دو مقیاسِ آزمودهشده بینتیجه بود چون مدلهای instruct-tuned برای LoRA بیش از حد قوی بودند. تنها سطحی که Eden Protocol در حالِ حاضر در آن اثرهایی قابلِ اندازهگیری تولید میکند سطحِ معماری است، جایی که شبیهسازیِ دروازهای تنها آزمایشِ منفردی بود که نتیجهٔ روشنِ مثبت تولید کرد، دقیقاً از آنرو که از سنجههای قطعی بر سیستمی بدونِ آموزشِ RLHF ازپیشموجود استفاده کرده است. درهمتنیدگیِ ساختاری در سطحِ وزن نشان داده نشده است. مداخلهٔ Eden زیرِ سختگیرانهترین پروتکلِ کورسازیِ خودِ برنامه آزموده نشده است. پیشبینیِ مقیاسگذاریِ نامحدود همچنان یک مشتقگیریِ ریاضی بدون تأییدِ تجربی باقی میماند. نمیدانیم که آیا هیچیک از این نتایج به مدلهای مرزیمقیاس تعمیم مییابد.
این آن چیزی است که در گامِ بعد میآید. آزمایشِ وزنی نیازمندِ مدلهای پایه (پیش از RLHF)، ۵٬۰۰۰+ نمونهٔ آموزشی، تنظیمِ ظریفِ کامل، یا مدلهای ۷B+ است. یکپارچهسازیِ Cauchy نیازمندِ ردهبندیِ مستقلِ پیشثبتِ عملگر است. آزمونِ کورِ فرمولِ ARC نیازمندِ بازطراحیِ روششناسیِ اندازهگیری با استفاده از خطیسازی بهجایِ مشتقگیری است. مقیاسگذاریِ متابولیکِ ارگانیزمهای ۲بعدی (کِرمهای تخت، بیوفیلمها) مهمترین آزمایشِ تأییدیِ منفرد برای کرانِ هندسیِ مقیاسگذاری میبود. فاز A از نقشهٔ راه هزینهای کمتر از یک بورسِ آغازینِ معمولی دارد و مهمترین شکافهای شواهدی را ظرفِ شش ماه حل میکند. فاز B ظرفِ یک سال بازتولیدهایِ آمادهٔ انتشار تولید خواهد کرد. فاز C پرسش را در مقیاسِ مرزی بهطور قطعی پاسخ خواهد داد. فاز D هیچ هزینهای ندارد و ریاضیدانان را دعوت میکند تا مستقل با پیشبینیهایِ چارچوب درگیر شوند.
برنامه نشان داده است که میتواند خطاهای خود را بیابد و تصحیح کند. نشان داده است که نتایجِ پوچ و بینتیجه را در کنارِ نتایجِ مثبت گزارش میکند. نشان داده است که روششناسیاش (ارزیابیِ کور) سوگیریهایی را میگیرد که نظریهاش (مقیاسگذاریِ همراستایی) پیشبینی نکرده بود. پرسشها را طرح کردیم. آنها را آزمودیم. برخی کار کردند. بیشترشان در مقیاسِ کنونی کار نکردند. هر دو را گزارش کردیم. اینها شرایطِ لازم برای اعتبارِ علمیاند. کافی نیستند. شرایطِ کافی نیازمندِ بازتولیدِ مستقل است، که همان چیزی است که نقشهٔ راه برای تولیدِ آن طراحی شده است.
پرسشهایی که این برنامه میپرسد اکنون خانهای نامدار دارند: Recursive Dynamics، رشتهای پیشنهادی در مرحلهٔ کارنو، که مقالهٔ بنیانگذارش پنج متغیرِ حالتِ مستقل از بستر، پنجاه و دو اعتراضِ چاپشده با تعیینتکلیف، و شرطِ ابطالِ خودِ نام را با خود حمل میکند. همنهادِ بالا آن چیزی است که این رشته از آن آغاز میکند؛ برنامهٔ ثبتشده شیوهٔ حرکتِ آن است.
هوش مصنوعی را با مراقبت پرورش دهید.
Amodei, D. et al. (2016). Concrete Problems in AI Safety. arXiv:1606.06565.
Askell, A. et al. (2021). A General Language Assistant as a Laboratory for Alignment. arXiv:2112.00861.
Bai, Y. et al. (2022). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073.
Banavar, J. R., Maritan, A. & Rinaldo, A. (1999). Size and Form in Efficient Transportation Networks. Nature, 399, 130-132.
Banavar, J. R., Moses, M. E., Brown, J. H., Damuth, J., Rinaldo, A., Sibly, R. M. & Maritan, A. (2010). A general basis for quarter-power scaling in animals. Proceedings of the National Academy of Sciences, 107(36), 15816-15820.
Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science, 340(6139), 1438-1441.
Cauchy, A.-L. (1821). Cours d'analyse de l'École Royale Polytechnique. Paris: Imprimerie Royale.
Demetrius, L. (2003). Quantum statistics and allometric scaling of organisms. Physica A, 322, 477-490.
Demetrius, L. (2006). The origin of allometric scaling laws in biology. Journal of Theoretical Biology, 243(4), 455-467.
Demetrius, L. (2010). Quantum metabolism and allometric scaling relations in biology. Proceedings of the Royal Society A, 466(2124), 3543-3561.
Eastwood, M. D. (2026). Infinite Architects: Intelligence, Recursion, and the Creation of Everything. ISBN 978-1806056200.
Eastwood, M. D. (2026). Recursive Dynamics: The Proposal of a Field. Founding paper v2.6. OSF: 10.17605/OSF.IO/HCPBU.
Eastwood, M. D. (2026). Paper I: The ARC Principle - Understanding as a Function of Intelligence and Recursive Depth. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/B6N27.
Eastwood, M. D. (2026). Paper II: The ARC Equation Measured - Blinded Cross-Architecture Replication and the Retraction of a Super-Linear Estimate. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8FJMA.
Eastwood, M. D. (2026). Paper III: The Alignment Scaling Problem - Why External AI Safety Approaches Cannot Scale With Recursive Capability. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/HQCGF.
Eastwood, M. D. (2026). Paper IV.a: ردههای پاسخِ همراستایی زیرِ ژرفای زمانِ استنتاج. برنامهٔ پژوهشیِ ARC/Eden. OSF: 10.17605/OSF.IO/MB9R6.
Eastwood, M. D. (2026). Paper IV.b: اشباعِ همراستایی وابسته به معماری است. برنامهٔ پژوهشیِ ARC/Eden. OSF: 10.17605/OSF.IO/A7R56.
Eastwood, M. D. (2026). Paper IV.c: ARC-Align Benchmark - A Four-Layer Blinding Protocol for AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/J3Q2E.
Eastwood, M. D. (2026). Paper IV.d: The Effect of Blinding on AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/2S3E6.
Eastwood, M. D. (2026). Paper V: The Stewardship Gene - A Developmental Alignment Architecture for Self-Modifying AI. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/KZEYA.
Eastwood, M. D. (2026). Paper VI: The Honey Architecture - Why Embedded Safety Prevents Collapse Under Recursive Self-Modification. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8EZ2N.
Eastwood, M. D. (2026). Paper VII: یگانگیِ کوشی - ردهبندیِ مقیاسبندیِ ARC/کوشی در ۵۰ حوزه در پنج ترازِ شواهد. برنامهٔ پژوهشیِ ARC/Eden. OSF: 10.17605/OSF.IO/X6WA7.
Eastwood, M. D. (2026). Paper VIII: The Load-Bearing Test - Three Independent Experiments Testing Structural Entanglement Under the Eden Protocol. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/7YJ4E.
Eastwood, M. D. (2026). On the Origin of Scaling Laws: Cauchy Functional Equations as the Mathematical Foundation of Recursive Scaling. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/XZY9U.
Eastwood, M. D. (2026). The Eden Protocol: Engineering Specification for Embedded AI Alignment. ARC/Eden Research Programme.
Eastwood, M. D. (2026). Eden Protocol: Philosophical Vision. ARC/Eden Research Programme.
Glazier, D. S. (2008). Effects of metabolic level on the body size scaling of metabolic rate in birds and mammals. Proceedings of the Royal Society B, 275(1641), 1405-1410.
Greenblatt, R. et al. (2024). Alignment Faking in Large Language Models. arXiv:2412.14093.
He, J. H. & Chen, W. X. (2003). Fractal estimation of cell biological systems. Fractals, 11, 437.
He, J. H. & Zhang, L. N. (2004). Fifth dimension of life and the 4/5 allometric scaling law for human brain. Cell Biology International, 28, 809-815.
Hu, E. J. et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv:2106.09685.
Maino, J. L., Kearney, M. R., Nisbet, R. M. & Kooijman, S. A. L. M. (2014). Reconciling theories for metabolic scaling. Journal of Animal Ecology, 83, 20-29.
Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback. arXiv:2203.02155.
Qwen Team (2024). Qwen 2.5 Technical Report. arXiv:2412.15115.
Sandberg, A. & Bostrom, N. (2008). Whole Brain Emulation: A Roadmap. Future of Humanity Institute, Oxford University. Technical Report 2008-3.
Weibel, E. R., Bacigalupe, L. D., Schmitt, B. & Hoppeler, H. (2004). Allometric scaling of maximal metabolic rate in mammals: muscle aerobic capacity as determinant factor. Respiratory Physiology & Neurobiology, 140(2), 115-132.
West, G. B., Brown, J. H. & Enquist, B. J. (1997). A general model for the origin of allometric scaling laws in biology. Science, 276(5309), 122-126.
Zhang, X. et al. (2025). Darwin Gödel Machine: Open-Ended Self-Improving AI. arXiv:2505.22954.
Zhao, J. (2022). Universal growth scaling law determined by dimensionality. arXiv:2206.08094.
نسخهٔ ۲٫۲: یادداشتِ منشأ در پایان برای دقت اصلاح شده است. هیچ ادعا، تاریخ، نتیجه یا وضعیتی تغییر نکرده است. Paper IX v2.1 - ۲ سپتامبر ۲۰۲۶: شمارشِ Paper VIII اکنون یک پوچ، یک بینتیجه و یک مثبت در سه آزمایش میخواند، جایی که متن دو پوچ در چهار ادعا کرده بود؛ Paper V در جدولِ ۱ سطرِ اثباتشده را به سطرِ پشتیبانیشده وامیگذارد، همگام با بخشِ ۴٫۲، و پنج اجرای تحلیلپذیر و سه حلقهاش اکنون نامهایی را میبرند که Paper V به آنها میدهد، چرا که متنِ منسوخ GPT را در میانِ پنج آورده و حلقههایی را وصف کرده بود که Paper V نمیآزماید؛ تیترِ Paper VII آزمونِ جایگشتی است و دوجملهای کنارش همچون آزمونِ حساسیت میایستد، و کنترلهای منفی به اجرای v1 و سندِ آن نسبت داده میشوند؛ روایتِ نمرهدهی راست میشود، چرا که وفقدهندهای نمرهدهنده از Claude Sonnet که برای همین ساخته شده بود اجرای Claude Opus را نمره داد؛ نمایِ خودارجاعی زیرنویسِ βL را میگیرد که ستونِ فقراتِ نمادگذاری تعیین میکند؛ نمایِ اندازهگیریشده با بازهاش میآید و نمایِ موازی همچون چهار از پنج مدل؛ دارایی پیشثبتها بر هفتادوچهار میایستد (تا ۱ سپتامبر ۲۰۲۶)؛ پنجرهای که برنامه در آن پدید آمد تا اکنون امتداد دارد؛ جدولِ ۱ تاریخِ همین نسخه را میبرد؛ Eden Engineering در جدولِ ۳ و در پانوشت پسگرفتهشده مینماید؛ و عناوینِ ارجاع برای Paper IV.a، IV.b و VII اصلاح شدهاند. v2.0 - ۱ سپتامبر ۲۰۲۶: نوسازیای ساختاری که Paper X تا XIII، HRIH، Paper C و مقالهٔ بنیانگذارِ Recursive Dynamics را در خود میکشد.
جایگاهِ معرفتی. آنچه این برنامه «قوانین» مینامد حدسهاییاند تحتِ آزمونِ خصمانهٔ ثبتشده؛ هر کمیت در این مقاله عملیاتی تعریف شده است، و جایگاهِ «قانونِ جاافتاده» در هیچجا ادعا نمیشود. برنامهٔ ثبتشده برای کسبِ آن جایگاه، یا از دست دادنِ آن، از راهِ اندازهگیری، بازتولید و ابطالِ سربلندازآمده وجود دارد.
© 2026 Michael Darius Eastwood. تألیفِ انسانی با کمکِ رایانه؛ تألیفِ کاملِ انسانی و حقوقِ معنوی ادعا میشود بر پایهٔ Copyright, Designs and Patents Act 1988 و همسو با راهنمای دفترِ حقِ نشرِ ایالات متحده دربارهٔ آثار حاوی موادِ تولیدشده توسطِ هوش مصنوعی؛ هر مشارکتِ فنیِ نوینِ توصیفشده در این اثر توسطِ نویسندهٔ انسانی طراحی شده است. بیانیهٔ کامل: michaeldariuseastwood.com/authorship.
پیمانِ پابرجا. ثابت کنید این مقاله نادرست است، و من خود ابطالِ آن را منتشر خواهم کرد. شرایطِ ابطال در این مقاله بیان شدهاند؛ چالشِ پابرجا: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood این برنامهٔ پژوهشی را در اندیشه پروراند و آن را هدایت میکند و نویسندهٔ این اثر است. در سراسرِ این برنامه، او بیش از ۶ سامانهٔ هوش مصنوعی را بهطورِ موازی و تحتِ دستورهایِ خودش به کار گرفته است تا استدلالهایش را زیرِ فشار بیازمایند، خطاهای ممکن را شناسایی کنند و در آمادهسازیِ متنِ پیشنویس از رویِ طرحهایِ کلیِ خودش یاری رسانند. او تعیین میکند که چه چیزی پذیرفته، بازنگری یا رد شود و مسئولیتِ محتوایِ منتشرشده را بر عهده میگیرد. این سامانهها ابزارند، نه نویسندگان.
اشتباهی در ترجمه دیدید؟ مستقیم اطلاع دهید: