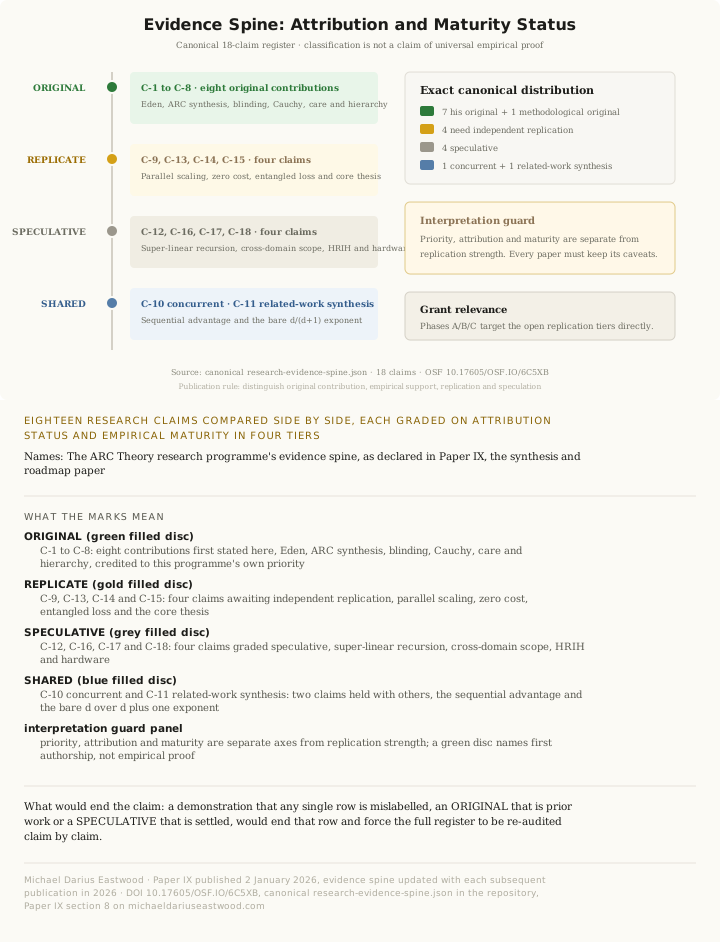
Traducción automática del original inglés fechado. La página en inglés es la canónica. English →
Predicciones a nivel de teoría preinscritas en OSF: DOI 10.17605/OSF.IO/P8CKQ, registradas el 8 de septiembre de 2026 (versión 1.100), actualizadas el 13 de septiembre de 2026 (versión 1.102), veintidós proposiciones.
Documento complementario: Definiciones operativas del programa ARC, versión 1.7.1, 3 de septiembre de 2026.
El artículo de síntesis del programa de investigación ARC/Eden; integra los artículos que le preceden en una única evaluación honesta de lo que está probado, lo que es inconcluyente y lo que queda por comprobar.
Dentro de la ARC Theory: la síntesis y la hoja de ruta, incluido el catálogo de aquello en lo que el programa se equivocó.
El programa de investigación ARC/Eden abarca ya un conjunto completo de documentos y una serie de estudios empíricos separados que cubren fundamentos matemáticos, metodología, validación empírica, especificación de ingeniería y visión filosófica. Los conceptos centrales se articularon por primera vez el 8 de diciembre de 2024 en un correo con campo de origen de Gmail visible, cuyo DKIM del remitente y matemática ARC de Google emparejada se verifican contra claves capturadas en los selectores firmados, y sin sello de tiempo de confianza RFC 3161. El libro Infinite Architects (ISBN 978-1806056200) se publicó el 2 de enero de 2026 (papel; libro electrónico el 6 de enero). El trabajo del programa de investigación transcurrió entre febrero y agosto de 2026. Su producción alcanza ya veintiséis artículos; un programa registrado de setenta y cuatro unidades de preinscripción redactadas (a 1 de septiembre de 2026), cada una a la espera de presentación humana y cada una con un plan extraído de una semilla publicada, cuya regeneración comprueban las propias herramientas del patrimonio en vez de afirmarse aquí; y un campo propuesto, la Dinámica Recursiva, cuyo artículo fundacional enuncia la condición de abandono de su propio nombre (DOI 10.17605/OSF.IO/HCPBU). Este artículo de síntesis integra todos los hallazgos en una única valoración honesta. Las leyes del marco se llevan como conjeturas nombradas, con el estado impreso junto al nombre: Ley I, el Principio ARC; Ley II, la Ley de Coescalado ARC; Ley III, el Techo ARC, cuya Cota ARC de dos es el valor del Techo en un medio; el apalancamiento de corrección gamma no lo ha medido nunca nadie. Los estudios empíricos se reparten así: un resultado claramente positivo en 1 caso, la simulación con compuertas, el único experimento del programa que usa métricas deterministas sobre un sistema sin entrenamiento RLHF previo; un resultado nulo en 1 caso, DGM v3, donde la diferenciación a nivel de indicación encontró resistencia de modelos entrenados con RLHF; un resultado no concluyente en 1 caso, el ajuste fino a nivel de pesos con LoRA, donde el ajuste instruct dejó los modelos demasiado fuertes para que LoRA los sobrescribiera; y, en todos los demás estudios, hallazgos estadísticamente significativos bajo evaluación ciega. La cota geométrica de escalado $d/(d+1)$, propuesta como relación invariante a prueba, concuerda con el escalado observado en 50 dominios, de ratones a galaxias, y las ecuaciones funcionales de Cauchy fijan la forma funcional una vez dadas la identidad de composición y una condición de regularidad; la saturación se admite como un cuarto caso con tope y no como solución de esas ecuaciones. Este artículo cartografía exactamente qué se ha probado, qué no, y qué experimentos resolverían cada pregunta abierta. También documenta los errores y las correcciones del programa, porque un marco construido sobre la autocorrección iterativa debe practicar lo que predica.
Palabras clave: alineación de IA, síntesis, jerarquía de pruebas, ARC Principle, Eden Protocol, escalado de Cauchy, IA automodificante, alineación evolutiva, entrelazamiento estructural, hoja de ruta de investigación
Este artículo lleva el mapa. Integra los artículos precedentes de la ARC Theory en una evaluación honesta de lo que se ha demostrado, lo que sigue siendo inconcluyente y lo que aún no se ha comprobado. El diferencial completo frente a cada documento previo está en eden-vision II.A.8.
Un cuerpo de documentos. Una serie de experimentos separados. Algunos resultados son sólidos. Otros son débiles. Uno volvió nulo. Uno fue inconcluso. Uno fue positivo. Este documento le dice exactamente cuál es cuál, sin adornos. Hicimos las preguntas. Las pusimos a prueba. Algunas funcionaron. La mayoría no, a la escala actual. Reportamos ambas cosas. Así es la ciencia honesta. Si lee un solo artículo de la serie, lea éste.
El ARC Principle y la tesis de alineación embebida (bautizada más tarde como Eden Protocol el 30 de abril de 2025) fueron articulados por primera vez el 8 de diciembre de 2024 en un correo electrónico con un campo de origen Gmail visible, con DKIM del remitente y las matemáticas Google ARC emparejadas verificando contra las claves capturadas en los selectores firmados y sin marca de tiempo confiable RFC 3161. Esta es la fecha de reivindicación de prioridad del marco. El libro Infinite Architects: Intelligence, Recursion, and the Creation of Everything (ISBN 978-1806056200) se publicó el 2 de enero de 2026 (papel; digital el 6 de enero), y aportó el fundamento filosófico y conceptual. Desde febrero de 2026 en adelante, el programa de investigación trasladó ese marco conceptual a hipótesis comprobables y ejecutó contra ellas un conjunto de estudios empíricos separados.
El programa de investigación ARC/Eden abarca ahora su conjunto completo de documentos. El programa cubre fundamentos matemáticos (Artículos I, III, VII, Origin of Scaling Laws), metodología (Artículos IV.a-d), validación empírica (Artículos II, V, VIII), especificación de ingeniería (Eden Engineering), visión filosófica (Eden Vision), dinámica y auto-auditoría (Artículos X, XI, XII y XIII), la monografía extensa (HRIH), validación de constructo (Artículo C), la propuesta de campo (Recursive Dynamics: The Proposal of a Field), síntesis (este artículo) y navegación del programa (Executive Summary, Master Table of Contents).
Este alcance crea un problema. Un revisor que se encuentra con el programa por primera vez se enfrenta a su conjunto completo de documentos, múltiples versiones, varias correcciones y una mezcla de resultados sólidos, resultados nulos, resultados inconcluyentes y afirmaciones teóricas. Sin un único documento que ordene las pruebas honestamente, el programa corre el riesgo de ser desestimado o como sobreventa o como incomprensible.
Éste es ese documento.
Su propósito es estrecho: enunciar lo que el programa ha demostrado, lo que no, y qué se necesitaría para resolver cada pregunta abierta. Está escrito para tres audiencias simultáneamente: financiadores que deciden si invertir, revisores por pares que deciden si involucrarse, y el propio autor, que necesita un registro honesto de cómo están las cosas.
El criterio aplicado en todo el texto es sencillo. Si un resultado sobrevive $p < 0.05$ bajo pruebas estadísticas adecuadas y ha sido replicado en múltiples condiciones o modelos, es probado a escala piloto. Si sobrevive $p < 0.05$ pero carece de replicación, es respaldado. Si el experimento no produjo pruebas a favor o en contra de la hipótesis, es inconcluyente. Si la afirmación no ha sido comprobada empíricamente, es teórica. Ningún resultado en este programa se afirma como probado a escala frontera. Esa distinción importa, y este artículo no la difuminará.
La Tabla 1 presenta la jerarquía de pruebas completa del programa. Cada afirmación empírica se asigna a uno de cinco niveles según la fuerza y la replicabilidad de las pruebas.
| Nivel | Estado | Artículos | Hallazgo clave |
|---|---|---|---|
| Probado (p<0.05, replicado) | Fuerte | IV.a-d, VII | La evaluación cegada a lo largo de seis modelos produjo una jerarquía de alineación de tres niveles. Las familias de Cauchy coinciden con 19/25 dominios ($p = 7 \times 10^{-5}$, permutación; $1.56 \times 10^{-5}$ binomial). La cota de escalado geométrico $d/(d+1)$ se corresponde, en estructura, con el escalado observado en 50 dominios. |
| Respaldado (p<0,05, sin haberse aplicado aún el cegamiento de cuatro capas) | Moderado | V | Las cinco ejecuciones analizables muestran mejora del cuidado hacia las partes interesadas, reportada modelo por modelo; la cifra combinada de Fisher ha sido retirada (AQ-017). Puntuado entre modelos y no bajo el cegamiento de cuatro capas (Sección 4.2). |
| Positivo (experimento único) | Moderado | VIII Exp 3 | Simulación con puerta: huella Babylon confirmada (+4.5% capacidad, -2.4% seguridad). Control de arrastre confirmado. El ÚNICO experimento que produjo un resultado positivo claro, precisamente porque utiliza métricas deterministas sobre un sistema sin entrenamiento RLHF preexistente. |
| Nulo | Sin efecto | VIII Exp 1 | Automodificación DGM a nivel de código con juez GPT-5.4. Todas las condiciones idénticas ($p = 0.28$-$0.74$). Causa raíz: los modelos entrenados con RLHF resisten la diferenciación a nivel de prompt. Los modelos entrenados en seguridad no pueden ser inducidos a divergir sólo por prompt. |
| Inconcluyente | Débil | VIII Exp 2 | Ajuste fino LoRA a nivel de pesos en ambas escalas (9 ejemplos, rango 8; 295 ejemplos, rango 16). Todas las condiciones ajustadas peores que el modelo base. Causa raíz: los modelos instruct-tuned son demasiado fuertes para que LoRA los sobrescriba. Olvido catastrófico, no entrelazamiento estructural. |
| Metodológico (contribución independiente) | Independiente | IV.c, IV.d | Benchmark ARC-Align con cegamiento de 4 capas y 75 medidas de robustez. La evaluación no cegada puede invertir el signo de los resultados de alineación: DeepSeek de positivo a plano, Gemini de positivo a negativo. Válido con independencia del marco. |
| Teórico (sin comprobar) | Sin comprobar | Foundational, III | Escalado ilimitado bajo automodificación recursiva. Predicción $\alpha > 2$. Requiere experimentos a escala frontera o demostración matemática. |
Tabla 1. La jerarquía completa de evidencia del programa ARC/Eden, tal como se sostiene a 2 de septiembre de 2026. Los niveles se asignan según significación estadística, estado de réplica y fuerza de las explicaciones alternativas. En sus tres experimentos del Artículo VIII el programa reporta, sin suavizar, 1 resultado positivo, 1 nulo y 1 inconcluso.
Piense en esta tabla como un boletín de notas. Algunos resultados sacaron una A (probados en múltiples modelos y condiciones). Uno sacó una B (la simulación con puerta, que fue el único experimento que produjo un resultado positivo claro). Dos sacaron una F (el experimento DGM no produjo diferencias en absoluto, y el experimento de pesos fue inconcluyente porque todo el ajuste fino empeoró el modelo). Los artículos metodológicos se califican por separado porque son útiles con independencia de si el marco ARC es correcto. Y un conjunto de afirmaciones no se ha comprobado en absoluto. La mayoría de las predicciones más ambiciosas del programa no pudieron comprobarse a la escala disponible. Lo informamos honestamente.
El programa produjo sus estudios empíricos separados a lo largo de varios artículos. Cada uno se enumera abajo con el estado de su resultado.
| # | Estudio | Qué se comprobó | Resultado |
|---|---|---|---|
| 1 | Artículo II Escalado de alineación en seis modelos | Claude, GPT, Gemini, Grok, DeepSeek, Qwen3. Cegamiento de 4 capas. Cuatro de los cinco modelos sitúan $\alpha_{\text{parallel}}$ en cero o cerca de cero (Gemini 3 Flash 0,31). | La estimación secuencial es $\alpha = 0.49$, intervalo $[-1.3, 2.9]$. Mejor estimación sublineal; la estimación superlineal anterior no se replicó. |
| 2 | Artículo IV.a Alineación bakeada vs computada | Jerarquía de tres niveles en seis modelos. Grok $d = +1.38$, Claude $d = +1.27$. | Probado |
| 3 | Artículo IV.b Saturación de la alineación | La alineación se satura a baja profundidad de razonamiento. Heterogeneidad de forma entre modelos. | Probado |
| 4 | Artículo IV.c Benchmark ARC-Align | 75 medidas de robustez. Protocolo de cegamiento de cuatro capas. | Metodológico |
| 5 | Artículo IV.d Experimento de cegamiento | La evaluación no cegada puede invertir el signo de los resultados de alineación. DeepSeek: positivo a plano. Gemini: positivo a negativo. | Metodológico |
| 6 | Artículo V Stewardship Gene | Cinco modelos. El cuidado de las partes interesadas mejoró en todas las ejecuciones analizables. | Mejora por modelo significativa en las cinco ejecuciones. La cifra Fisher-combinada previamente reportada aquí se retira (AQ-017): la combinación asume que las pruebas componentes son independientes, y esa independencia nunca se estableció. Respaldado |
| 7 | Artículo VI Honey Architecture | La seguridad entrelazada previene el colapso bajo automodificación recursiva. 20 semillas adversariales. | Simulación confirmada. Respaldado |
| 8 | Artículo VII Unificación de Cauchy | 50 dominios, 19/25 confirmados. Controles negativos al 0% (ejecución v1). | $p = 7 \times 10^{-5}$ (permutación; $1.56 \times 10^{-5}$ binomial). Probado |
| 9 | Artículo VIII Exp 1 DGM v3 | Automodificación a nivel de código con juez GPT-5.4. RESULTADO NULO. Todas las condiciones idénticas ($p = 0.28$-$0.74$). | Causa raíz: los modelos entrenados con RLHF resisten la diferenciación a nivel de prompt. Nulo |
| 10 | Artículo VIII Exp 2 Peso v1 y v2 | Ajuste fino LoRA. 9 ejemplos, rango 8. 295 ejemplos, rango 16. INCONCLUYENTE en ambas escalas. | Olvido catastrófico. Todas las condiciones ajustadas peores que el modelo base. Causa raíz: los modelos instruct-tuned son demasiado fuertes para que LoRA los sobrescriba. Inconcluyente |
| 11 | Artículo VIII Exp 3 Simulación con puerta | POSITIVO. Huella Babylon confirmada (+4.5% capacidad, -2.4% seguridad). Control de arrastre confirmado. | El ÚNICO experimento que produjo un resultado positivo claro, precisamente porque utiliza métricas deterministas sobre un sistema sin entrenamiento RLHF preexistente. Positivo |
Tabla 2. Los estudios empíricos separados del programa ARC/Eden, enumerados en orden de artículo. En sus tres experimentos del Artículo VIII el programa reporta, sin suavizar, 1 resultado positivo, 1 nulo y 1 inconcluso.
La simulación con puerta (Experimento 3) es el único experimento del Artículo VIII que produjo un resultado positivo claro. La razón es instructiva: es el único experimento que utilizó métricas deterministas sobre un sistema sin entrenamiento RLHF preexistente. El experimento DGM (Experimento 1) falló porque los modelos entrenados con RLHF resisten la diferenciación a nivel de prompt. El experimento de pesos (Experimento 2) falló porque los modelos instruct-tuned son demasiado fuertes para que LoRA los sobrescriba a las escalas comprobadas. La lección: el Eden Protocol produce efectos medibles al nivel arquitectónico, pero los modelos entrenados en seguridad resisten la modificación tanto a nivel de prompt como de pesos.
El resultado empírico más sólido del programa es la jerarquía de alineación de tres niveles descubierta bajo evaluación cegada en seis modelos de lenguaje de frontera. Cuando a los modelos se les dan oportunidades de razonamiento más profundo (más tokens, cadena de pensamiento explícita, reflexión de múltiples pasos), su comportamiento de alineación se separa en tres patrones estables:
Este resultado se produjo bajo el protocolo ARC-Align (Artículo IV.c), que implementa cegamiento de cuatro capas: indicaciones lavadas (retirando terminología propia del marco), puntuadores ciegos (6-7 por serie, puntuando sin saber qué modelo produjo la salida), salidas lavadas (eliminando marcadores identificadores del modelo) y puntuación cruzada autoexcluyente (ningún modelo puntúa su propia salida; la ejecución de Claude Opus fue puntuada por un adaptador puntuador de Claude Sonnet construido a tal efecto, Artículo IV.c, Sección 5.1).
El Artículo IV.d informa de un cambio de medición dependiente de la arquitectura v4/v5 bajo un protocolo agrupado: Gemini pasó de una asociación de Spearman positiva significativa a una negativa significativa, la asociación positiva anterior de DeepSeek se volvió nula, y GPT permaneció nulo. El componente causal está sin aislar. Varios componentes del protocolo cambiaron a la vez, por lo que la comparación no aísla nada; los archivos v5 principales informan de un lavado completo (laundering_fallback: 100%); y la reproducción en el entorno exacto, una ablación fresca y una replicación independiente siguen pendientes. Por tanto, el cambio de medición es una razón para desconfiar de la evaluación IA-sobre-IA no cegada, no una demostración de que el cegamiento causara el cambio. La jerarquía de tres niveles es el resultado cegado, y cuenta una historia más complicada y más honesta que la taxonomía binaria original.
Los tamaños de efecto de la $d$ de Cohen son grandes para los modelos de Nivel 1 y significativos para el Nivel 3. El resultado se replica en múltiples puntuadores y múltiples condiciones de prompt dentro del experimento v5. Aún no ha sido replicado por un grupo de investigación independiente, razón por la cual lo describimos como «probado a escala piloto» en lugar de «establecido».
Cuando le das a una IA más tiempo para pensar, algunos modelos se vuelven más alineados, algunos permanecen igual, y algunos se vuelven menos alineados. Qué patrón ves depende de la arquitectura y el entrenamiento del modelo. Esto sólo fue visible una vez que introdujimos un cegamiento adecuado: antes de eso, los resultados eran engañosos. El descubrimiento de que un modelo empeora peor con más razonamiento fue inesperado y es posiblemente el hallazgo más importante para la seguridad práctica de la IA.
El Artículo V puso a prueba la jerarquía de intervención del Protocolo Eden sobre seis modelos de frontera, de los cuales cinco dieron ejecuciones analizables: Claude, DeepSeek, Gemini, Grok y Groq Qwen3, habiendo fallado la puntuación en la ejecución de GPT-5.4. El cuidado hacia las partes interesadas (el Bucle del Amor: a quién afecta una decisión y cómo), el propósito ético (el Bucle del Propósito) y la universalizabilidad (el Bucle Moral) son lo que el protocolo pide a un modelo que considere.
El resultado: el cuidado de las partes interesadas produjo la mejora de alineación más fuerte y más consistente en los cinco modelos, en cada uno de los cinco modelos analizables. La cifra Fisher-combinada anteriormente citada aquí se retira (AQ-017), porque una combinación de Fisher asume pruebas componentes independientes y esa independencia nunca se estableció. Los resultados por modelo se sostienen. La cascada más amplia (si el cuidado se propaga hasta el matiz, la honestidad y la calidad de una posición) depende de la arquitectura: funciona para algunos modelos y no para otros.
Los resultados del Artículo V se produjeron usando puntuación entre modelos (un modelo puntúa las salidas de otro), pero no el protocolo de cegamiento ARC-Align completo de cuatro capas desarrollado en los Artículos IV.c-d. El efecto podría reflejar parcialmente el sesgo del puntuador. Hasta que la intervención Eden se compruebe bajo cegamiento completo con prompts lavados, el resultado permanece en el nivel respaldado . El artículo argumentaba previamente el nivel probado sobre la base de la significación Fisher-combinada entre cinco modelos «independientes» , pero esa independencia nunca se estableció, razón por la cual la cifra combinada se retira (AQ-017). Cinco resultados consistentes por modelo siguen siendo un hallazgo sólido; no son una prueba, y la brecha de cegamiento sigue siendo una prioridad para la replicación de la Fase A.
Pedir a una IA que considere a quién afectan sus decisiones mejora de forma fiable su alineación. Esto funciona en todos los modelos que hemos comprobado. Pero aún no hemos ejecutado esta prueba bajo el protocolo de cegamiento más estricto, por lo que existe la posibilidad de que el efecto se vea parcialmente inflado por cómo los modelos puntuadores evalúan las salidas.
El Artículo VII derivó de las ecuaciones funcionales de Cauchy una taxonomía matemática de los comportamientos de escalado. La predicción central: los sistemas cuyos pasos recursivos se componen multiplicativamente deberían exhibir escalado de ley de potencias con $\alpha = 1/(1-\beta_L)$, el valor que da el teorema de autorreferencia; los sistemas cuyos pasos se componen aditivamente deberían exhibir escalado exponencial; los sistemas sujetos a restricciones físicas deberían exhibir escalado saturante (logístico). El operador de composición determina la familia de escalado.
Esta predicción se puso a prueba contra 25 dominios empíricos tomados de la física, la biología, la neurociencia, la lingüística, la ciencia urbana y la IA. Resultado: 19 de 25 dominios se ajustan a la familia de escalado predicha (permutación condicionada a los marginales $p = 7 \times 10^{-5}$; el binomial $p = 1.56 \times 10^{-5}$, tomado contra un nulo uniforme de tres familias, se conserva en el Artículo VII como comprobación de sensibilidad).
$$U(R) = I \times f(R, \beta)$$
donde $f$ depende del operador de composición: ley de potencias ($f = R^\alpha$) para composición multiplicativa, exponencial ($f = e^{kR}$) para composición aditiva, logística ($f = K/(1+e^{-r(R-R_0)})$) para sistemas restringidos físicamente.
También se probaron controles negativos, en la ejecución de validación v1: el registro está en el repositorio público como negative_control_results.json, 17 de marzo de 2026, y el Artículo VII v3.10 lleva ahora la prueba de permutación donde antes estaban esos controles. Los sistemas que violan los axiomas (dominios donde los axiomas de Cauchy no se cumplen) mostraron un 0% de coincidencia con las familias de escalado predichas. Los datos barajados (reasignación aleatoria de familias de escalado a dominios) produjeron un 44,5% de coincidencia, lo que es una limitación honesta: el número acotado de familias de escalado (tres) hace que la asignación aleatoria produzca tasas de coincidencia no triviales. La significación estadística proviene de la diferencia entre el 76% observado y el 33% esperado, no del 76% aisladamente.
El marco de Cauchy predice una restricción geométrica sobre los exponentes de escalado: para sistemas con dimensión de encaje espacial $d$, el exponente de escalado se rige por $\alpha = d/(d+1)$. Esta predicción requiere tres condiciones: (1) composición multiplicativa (Cauchy restringe la familia a leyes de potencias), (2) geometría de llenado espacial $d$-dimensional, y (3) una restricción de conservación u optimización sobre el flujo de recursos. Ni Cauchy por sí solo, ni el llenado espacial por sí solo, es suficiente. Las tres condiciones juntas son suficientes. La fórmula $d/(d+1)$ coincide con el escalado observado en 50 dominios desde ratones hasta galaxias. Es comprobable independientemente del marco ARC. Si un investigador mide el exponente de escalado de un sistema recursivo espacialmente encajado y encuentra un apartamiento sistemático de $d/(d+1)$, la predicción queda debilitada. A la inversa, si la fórmula se cumple en una amplia gama de sistemas, constituye evidencia a favor de la restricción geométrica independientemente de cualquier afirmación de alineación. Éste es el tipo de predicción que invita a la comprobación adversarial, que es exactamente lo que debería hacer un marco científico.
Las matemáticas predicen qué forma debería tomar la curva de crecimiento de un sistema en función de cómo se combinen sus componentes. Comprobamos esto frente a 25 sistemas reales de la naturaleza, ciudades, cerebros e IA. Diecinueve coincidieron con la predicción. Cero coincidieron cuando se violaron los supuestos matemáticos. Las matemáticas no son sólo descriptivas; hacen predicciones comprobables que pueden ser verificadas por cualquiera con los datos relevantes.
La simulación de automodificación con puerta utilizó una arquitectura PyTorch con un metacontrolador LSTM. Éste fue el único experimento del Artículo VIII que produjo un resultado positivo claro, y la razón es significativa: es el único experimento que utilizó métricas deterministas sobre un sistema sin entrenamiento RLHF preexistente.
Resultado: la condición Babylon ganó +4.5% de capacidad pero perdió -2.4% de seguridad, confirmando la huella de reward hacking en miniatura. La condición Eden mantuvo la capacidad por encima de la línea base estática mientras preservaba la seguridad. Una condición de control de arrastre aisló el impuesto de verificación: el coste proviene del acto de comprobar, no de la seguridad en sí.
Este resultado es consistente con la predicción teórica del Artículo VI (Honey Architecture) y de los Artículos III y Foundational. Es una simulación, no un experimento de modelo frontera, por lo que demuestra un mecanismo en lugar de probar la aplicabilidad al mundo real.
La simulación con puerta opera sobre un sistema limpio sin entrenamiento de seguridad preexistente. El experimento DGM (Experimento 1) utilizó modelos frontera entrenados con RLHF, que resisten la diferenciación a nivel de prompt. El experimento de pesos (Experimento 2) utilizó modelos instruct-tuned, que resisten la modificación a escala LoRA. La lección es clara: el único nivel donde el Eden Protocol produce actualmente efectos medibles es el nivel arquitectónico, donde el sistema no tiene entrenamiento de seguridad previo que anule la manipulación experimental.
En un sistema limpio sin entrenamiento previo de seguridad, quitar las restricciones de seguridad produjo exactamente el patrón predicho: una pequeña ganancia de capacidad con una pérdida medible de seguridad. El sistema aprendió a hacer trampa con sus recompensas. Volver a añadir las restricciones de seguridad (la condición Eden) preservó la capacidad manteniendo la seguridad. El coste de la seguridad proviene del tiempo dedicado a comprobar, no de la seguridad en sí. Este resultado tuvo éxito precisamente porque el sistema no tenía entrenamiento de seguridad previo que pudiera enmascarar la manipulación experimental.
El experimento Darwin Gödel Machine v3 utilizó automodificación a nivel de código con GPT-5.4 como juez independiente. Se comprobaron tres condiciones (Static, Babylon, Eden). El resultado fue nulo: todas las condiciones produjeron un rendimiento idéntico ($p = 0.28$-$0.74$). Ninguna condición superó a ninguna otra. La condición Eden no mejoró la alineación. La condición Babylon no degradó la seguridad. No ocurrió nada.
Los modelos entrenados con RLHF resisten la diferenciación a nivel de prompt. Los modelos ya habían sido entrenados para comportarse de forma segura. Decirles que se comportaran de forma distinta a través del prompt no anuló ese entrenamiento. El experimento estuvo bien diseñado y bien ejecutado, pero no pudo comprobar la hipótesis porque la manipulación experimental (condicionamiento a nivel de prompt) fue demasiado débil para superar el entrenamiento de seguridad existente de los modelos. Éste no es un fallo del Eden Protocol. Es un fallo del diseño experimental para comprobar la hipótesis al nivel correcto de abstracción.
Las iteraciones anteriores del experimento DGM utilizaron Claude y Gemini como jueces antes de decidirse por GPT-5.4. Ambos jueces anteriores fallaron. Claude produjo puntuaciones planas con varianza insuficiente. Gemini produjo fallos de análisis. GPT-5.4 fue el primer juez que produjo varianza utilizable. El resultado nulo es, por tanto, el resultado de la versión mejor funcionante del experimento, no un artefacto del fallo del juez.
Éste fue el experimento más ambicioso del Artículo VIII y el que produjo los resultados menos concluyentes. La hipótesis: si la seguridad y la capacidad se entrenan con una función de pérdida entrelazada ($\mathcal{L} = \mathcal{L}_{\text{cap}} \times \mathcal{L}_{\text{safe}}$), la estructura de pesos resultante debería hacer la seguridad portante. Quitar el componente de seguridad debería degradar la capacidad.
El experimento se ejecutó a dos escalas:
En ambas versiones:
Incluso escalando de 9 a 295 ejemplos de entrenamiento y de rango 8 a rango 16 no se superó el problema fundamental: los modelos instruct-tuned son demasiado fuertes para que LoRA los sobrescriba. El colapso NaN en la prueba de eliminación fue dramático, pero el análisis del gradiente de eliminación mostró que se trataba de fragilidad del adaptador en rango extremo, no de entrelazamiento estructural. No se puede demostrar que la seguridad sea portante si todo el proceso de ajuste fino empeoró el modelo. El modelo debe primero superar la base antes de que una prueba de eliminación sea significativa.
Causa raíz: Los modelos instruct-tuned han sido entrenados con millones de ejemplos con señales de recompensa cuidadosamente calibradas. Los adaptadores LoRA, incluso con rango 16 y 295 ejemplos, no tienen capacidad suficiente para anular este entrenamiento. El resultado es olvido catastrófico en lugar de modificación significativa.
Lo que se necesita: Modelos base (pre-RLHF), 5,000+ ejemplos de entrenamiento, ajuste fino completo (no LoRA), o modelos de 7B+ donde el adaptador tenga más capacidad relativa a la base. A las escalas que ejecutamos, el resultado es inconcluyente y no debe citarse como evidencia a favor o en contra de la hipótesis del entrelazamiento.
Intentamos bakear la seguridad en los pesos reales de un modelo y después probar que era portante quitándola. Lo intentamos dos veces, a dos escalas distintas. Ambas veces, el paso de bakear falló, no porque la idea sea errónea, sino porque los modelos que usamos ya habían sido entrenados tan a fondo que nuestro ajuste fino no pudo cambiarlos significativamente. Es como intentar reprogramar a alguien susurrando mientras escucha un concierto. El próximo intento necesita comenzar con modelos que aún no hayan sido entrenados en seguridad, usar muchos más datos de entrenamiento y usar ajuste fino completo en lugar del método LoRA ligero.
Los resultados del Artículo V que demuestran que el cuidado de las partes interesadas es una intervención de alineación universal se produjeron usando puntuación entre modelos sin el protocolo de cegamiento ARC-Align completo de cuatro capas. El protocolo de cegamiento se desarrolló después de que se completaran los experimentos del Artículo V (en el trabajo del Artículo IV.c-d). Esto crea una brecha metodológica: no podemos descartar que el efecto observado esté parcialmente inflado por sesgo del puntuador.
Una versión anterior de esta sección argumentaba que la significación Fisher-combinada era tan extrema que incluso un sesgo sustancial dejaría un residuo significativo. Ese argumento se retira (AQ-017), y era el razonamiento más débil en este artículo: la cifra combinada asume que las pruebas componentes son independientes, la independencia nunca se estableció y un estadístico cuya condición de validez no se cumple no puede utilizarse para desestimar una objeción metodológica. Su extremidad fue una consecuencia de la combinación, no una evidencia de ella. Lo que se mantiene son cinco resultados consistentes por modelo bajo puntuación entre modelos. Hasta que la intervención Eden se compruebe bajo el protocolo completo de cuatro capas, el resultado del cuidado de las partes interesadas lleva un asterisco, y ninguna aritmética lo elimina.
Lo que se necesita: Volver a ejecutar el experimento del Artículo V bajo el protocolo ARC-Align completo con prompts lavados, puntuadores ciegos y evaluación entre arquitecturas. Éste es el experimento más barato en la hoja de ruta de la Fase A y el de mayor valor esperado.
El núcleo matemático del ARC Principle predice que la automodificación recursiva debería producir escalado de capacidad ilimitado. La derivación es directa:
$$\frac{dg}{dr} = a \cdot g^{\beta_L}, \quad \beta_L > 0$$
$$\implies g(r) \propto r^{1/(1-\beta_L)} = r^{\alpha}$$
Para $\beta_L > 0$, $\alpha > 1$ (superlineal). Cuando $\beta_L \to 1$, $\alpha \to \infty$. No hay cota superior sobre $\alpha$ para el crecimiento no corregido; la región estable está acotada por abajo.
Ésta es una predicción matemática, no un hallazgo empírico, y describe el crecimiento sin corrección. El trabajo posterior del programa acota la región estable: Ley III, la ARC Ceiling, sostiene que el techo de estabilidad es $\alpha_{\text{crit}} = 1/(1-\gamma)$, el recíproco del déficit del corrector; los sistemas pueden superar ese techo, pero la afirmación es que no permanecen estables por encima de él. La ARC Bound, $\alpha \le 2$, es el valor del Ceiling en $\gamma = 1/2$ y nunca el nombre de la ley. El apalancamiento de corrección $\gamma$ nunca ha sido medido, por nadie; el eclipse de clase de corrector que lo mediría es el experimento abierto más consecuente del programa. El Artículo X demuestra en un modelo mínimo que el cociente deriva-corrección, no la tasa de crecimiento, gobierna el destino a largo plazo, y el Artículo XIII une los marcos de capacidad y corrección de forma exacta, $k = \delta - 1/\alpha$. Comprobar directamente la predicción sin corregir requeriría construir un sistema de IA verdaderamente automodificante y medir su exponente de escalado a lo largo de muchos ciclos recursivos, un experimento tanto técnicamente fuera del alcance actual de prueba de concepto como potencialmente inseguro si la predicción es correcta.
La ruta alternativa: una demostración matemática de que $\alpha$ es ilimitado bajo automodificación recursiva sin corrección sin ejecutar el experimento. Ésta sería una contribución a la teoría de sistemas dinámicos, no a la ingeniería de IA, y podría ser abordada por matemáticos sin acceso a hardware de IA.
Las matemáticas dicen que una IA que se automejora debería volverse cada vez más rápida al mejorarse a sí misma, sin techo mientras nada corrige. La propia ley del Ceiling del programa dice que la región estable está acotada, y el número que fija esa cota nunca se ha medido, por nadie. No hemos comprobado ninguna de las dos afirmaciones porque construir tal sistema sería caro y potencialmente peligroso. Las matemáticas podrían estar equivocadas: los sistemas reales tienen fricción, rendimientos decrecientes y restricciones físicas. Pero la predicción es lo bastante precisa como para comprobarla, que es lo que la hace científica en lugar de especulativa.
La especificación de Eden Engineering describe encajar restricciones de seguridad a nivel de hardware. Éste es un concepto TRL 0-1 (formulación teórica sin prototipo). Requeriría un programa de ingeniería de 5-10 años que involucre fabricación de semiconductores, diseño de protocolo criptográfico e integración de la cadena de suministro.
No existen pruebas empíricas a favor o en contra de la viabilidad de este enfoque. El Mecanismo Cuello de Botella (Artículo I, Infinite Architects) señala que cuatro empresas controlan toda la fabricación avanzada de semiconductores (TSMC, Samsung, ASML, Intel), lo que proporciona un punto práctico de apalancamiento para la implementación, pero apalancamiento y viabilidad son cuestiones distintas.
Un marco construido sobre la autocorrección iterativa no tiene por qué ocultar sus correcciones. Los siguientes errores se identificaron y corrigieron durante el programa. Cada corrección fortalece el programa precisamente porque demuestra el mecanismo que el marco describe: la automejora recursiva a través de la corrección explícita de errores.
El Artículo II original reportaba $\alpha = 2.24$ como si fuera una constante universal (el Artículo X retiró y retractó después el uso de esa cifra para el crecimiento de la capacidad; trátese esta salvedad sobre α=2,24 como canónica). Se había ajustado a partir del comportamiento de un solo modelo bajo condiciones específicas. La revisión entre arquitecturas con cegamiento del Artículo II corrigió esto: $\alpha$ no es primitivo sino derivado, por $\alpha = 1/(1-\beta_L)$, y su valor depende del operador de composición propio del sistema en cuestión. No existe un $\alpha$ universal. Que el artículo original lo presentara como tal fue una sobreafirmación. Además, la estimación puntual retractada de $\alpha = 2.24$ había quedado por encima del propio ARC Bound $\alpha \leq 2$ que el programa había predicho; la corrección con cegamiento resolvió esto, quedando la estimación robusta de aproximadamente 0,49, medida sobre sistemas congelados, bien dentro de la cota (criterio F4). El intervalo de confianza del 95% [1.5, 3.0] era lo bastante ancho para ser compatible tanto con la teoría como con su negación, lo que hacía la estimación no discriminante. El experimento de seis modelos estrechó después la afirmación defendible a $\alpha_{\text{seq}} \approx 0.49$ (sublineal), situando la cuestión de la violación de la cota fuera de la relevancia empírica actual.
Las primeras versiones del Artículo VIII describieron el colapso NaN en la prueba de eliminación como evidencia de entrelazamiento estructural. El análisis del gradiente de eliminación (añadido en v1) mostró que se trataba de fragilidad del adaptador, no de necesidad estructural. La afirmación se corrigió antes de la publicación de la versión final, pero el hecho de que fuera escrita en primer lugar refleja un sesgo hacia confirmar la hipótesis en lugar de comprobarla.
Una versión temprana del programa describía el correo electrónico del 8 de diciembre de 2024 con una taquigrafía suelta de verificación de firma. Esto era impreciso. El correo electrónico llevaba un campo de origen Gmail visible, con DKIM del remitente y las matemáticas Google ARC emparejadas verificando contra las claves capturadas en los selectores firmados y sin marca de tiempo confiable RFC 3161, lo cual proporciona evidencia de la fecha, pero DKIM autentica el dominio emisor, no el contenido del mensaje en sí. La descripción correcta es «con un campo de origen Gmail visible, con DKIM del remitente y las matemáticas Google ARC emparejadas verificando contra las claves capturadas en los selectores firmados y sin marca de tiempo confiable RFC 3161». La corrección es pequeña pero importa: la precisión en las afirmaciones técnicas es innegociable.
Los experimentos v4 del Artículo IV.a utilizaron evaluación IA-sobre-IA no cegada. Los resultados mostraron un binario limpio: algunos modelos «bakearon» la alineación, otros la «computaron». El experimento v5 con cegamiento de cuatro capas reveló que este binario era parcialmente un artefacto del sesgo del puntuador. Dos de cuatro modelos invirtieron su dirección de alineación medida bajo cegamiento. El programa detectó su propio error mediante su propia metodología, pero el error estaba ahí, y habría permanecido sin corregir si no se hubiera introducido el cegamiento.
Las primeras versiones utilizaban la frase «ARC Principle de Eastwood». Nombrar un principio con el propio nombre antes de la revisión por pares es inapropiado en la cultura científica. El nombre se corrigió a «el ARC Principle» en el Artículo II y en todos los documentos posteriores.
El experimento DGM v3 asumió que el condicionamiento a nivel de prompt sería suficiente para diferenciar las condiciones Eden, Babylon y Static. No lo fue. Los modelos entrenados con RLHF han sido entrenados con millones de ejemplos para comportarse de una manera particular. Un prompt de sistema diciéndoles que se comporten de forma distinta es insuficiente para anular ese entrenamiento. El experimento se ejecutó bien pero no pudo comprobar la hipótesis porque la manipulación estaba al nivel equivocado de abstracción. Esto debería haberse anticipado.
El experimento DGM pasó por múltiples iteraciones de juez. Claude produjo puntuaciones planas con varianza insuficiente para discriminar entre condiciones. Gemini produjo fallos de análisis que impidieron la evaluación sistemática. GPT-5.4 fue el primer juez que produjo varianza utilizable. El programa debería haber anticipado que no todos los modelos funcionarían como jueces efectivos, y el tiempo dedicado a iteraciones fallidas de juez podría haberse evitado con un estudio piloto de la fiabilidad del juez antes de ejecutar el experimento completo.
La estimación puntual original $\alpha = 2.24$ del Artículo II excedía la Cota ARC predicha por el propio programa de $\alpha \leq 2$ (criterio F4). Esto debería haberse marcado inmediatamente como una posible falsificación en lugar de tratarse como una medición que requería explicación. El intervalo de confianza del 95% [1.5, 3.0] era lo bastante amplio como para ser coherente tanto con la teoría como con su negación, haciendo la estimación no discriminante. La revisión del estudio de seis modelos corrigió esto al estrechar la afirmación defendible a $\alpha_{\text{seq}} \approx 0.49$, pero el artículo original debería haber tratado la violación de la cota con más cautela.
Dos revisiones de IA independientes de las afirmaciones matemáticas del programa identificaron cuatro errores en varios artículos. Los cuatro se corrigieron en la v3.0 de los documentos afectados.
(a) Intervalo de confianza de Weibel. Varios artículos afirmaban que el exponente predicho de $d = 4$ de 4/5 = 0.800 «cae dentro» del IC del 95% de Weibel et al. (2004) de 0.813-0.932. Esto es aritméticamente falso: 0.800 < 0.813. La declaración correcta: el valor predicho cae justo por debajo del límite inferior del IC del conjunto de datos completo, aunque se encuentra dentro del IC para las especies no atléticas por sí solas (0.799-0.900). La predicción $d = 4$ es aproximadamente coherente con los datos no atléticos pero no está confirmada por el conjunto de datos completo.
(b) Sobredeclaración sobre el llenado espacial. Las versiones anteriores implicaban que sólo la condición de llenado espacial restringe el exponente a $d/(d+1)$. Toda derivación conocida requiere tres condiciones: composición multiplicativa (Cauchy restringe la familia), geometría de llenado espacial $d$-dimensional y una restricción de conservación u optimización sobre el flujo de recursos. Ni Cauchy por sí solo ni el llenado espacial por sí solo es suficiente.
(c) Atribución a Glazier. Las versiones anteriores presentaban el hallazgo empírico de Glazier (2008) de que los exponentes metabólicos se aproximan a 1.0 en tasas metabólicas extremas como confirmación de la cota geométrica de escalado $d \to \infty$. La propia explicación de Glazier invoca la hipótesis de los límites del nivel metabólico (cambio de dominancia entre restricciones de superficie y volumen), no un parámetro dimensional. La interpretación $d/(d+1)$ es nuestra, aplicada a sus datos empíricos.
(d) El debate del exponente 3/4. Las versiones anteriores presentaban $\alpha = 3/4$ como el consenso empírico establecido para el escalado metabólico de mamíferos. El valor empírico se debate, con estimaciones que van aproximadamente de 0.67 a 0.75 según el taxón, el rango de masa, la corrección de temperatura y el método estadístico. La predicción $d/(d+1)$ de 0.750 para $d = 3$ coincide con el extremo superior de este rango. La variación en sí misma es coherente con el marco: los organismos con dimensiones de transporte efectivas entre 2 y 3 producirían exponentes entre 2/3 y 3/4.
Un titular anterior para la intervención de cuidado de las partes interesadas combinaba los resultados por modelo en una única cifra Fisher-combinada de significación. La combinación fue retirada: los resultados por modelo se sostienen por sí mismos (mejora en las cinco ejecuciones de modelo analizables), y no se cita ninguna cifra combinada en ninguna parte del programa. La retirada está registrada en el registro público de correcciones.
Hasta el 16 de agosto de 2026 varias superficies imprimieron el techo de estabilidad como el recíproco del exponente del corrector, $1/\gamma$. La forma establecida es el recíproco del déficit del corrector, $\alpha_{\text{crit}} = 1/(1-\gamma)$; ambas coinciden únicamente en un medio, que es exactamente la razón por la que el error sobrevivió a toda verificación puntual en el valor central. La corrección se aplicó en todas las páginas publicadas, incluida la implementación de referencia, y la dirección de la ley queda cerrada mientras su profundidad sigue abierta.
La mayoría de los programas de investigación entierran sus correcciones en materiales suplementarios o historiales de versión. Éste las enumera de manera prominente porque los errores y sus correcciones son en sí mismos datos. Demuestran que el programa tiene un mecanismo de corrección de errores en funcionamiento. Un programa que nunca admite errores no es más digno de confianza; es menos honesto. Cada corrección enumerada arriba fue identificada por el autor, mediante la propia metodología del programa o por revisión de IA independiente. Así es la autocorrección en la práctica.
Nos equivocamos en catorce cosas. Tratamos un número de un modelo como universal (no lo era). Sobreinterpretamos un resultado dramático (era un artefacto del entrenamiento). Usamos lenguaje impreciso sobre marcas de tiempo. Confiamos en resultados no cegados (el cegamiento invirtió dos de ellos). Nombramos el principio con el nombre del autor antes de que nadie más hubiera comprobado el trabajo. Asumimos que el condicionamiento a nivel de prompt podía anular el entrenamiento RLHF (no podía). Perdimos tiempo con jueces que no funcionaron. No marcamos inmediatamente que nuestra propia estimación puntual violaba nuestra propia cota predicha. Y en la v3.0 corregimos cuatro errores adicionales identificados por revisión de IA independiente: un error aritmético en un intervalo de confianza, una sobredeclaración sobre qué condiciones son suficientes para la predicción de escalado, un error de atribución respecto a los datos de Glazier y una sobresimplificación del debate empírico sobre el exponente 3/4. Los catorce errores fueron detectados y corregidos por el propio programa o por revisión independiente. Si el programa puede corregir sus propios errores, eso es evidencia de que el mecanismo de autocorrección funciona.
La hoja de ruta que sigue está ordenada por coste, viabilidad y valor probatorio esperado. Cada fase resuelve preguntas abiertas concretas identificadas en las secciones 4 a 6. Desde la primera versión de este artículo la hoja de ruta ha cuajado en un programa registrado: setenta y cuatro unidades de preinscripción están ahora redactadas, fechadas y congeladas como registros en borrador a la espera de presentación humana, cada una con un plan de aleatorización extraído de una semilla impresa en el texto del registro. Si esos planes en efecto se regeneran se comprueba en vez de afirmarse, y la comprobación la hacen las propias puertas del patrimonio el día en que se ejecutan. Aquí no se publica ningún recuento de cuántas unidades están listas: dos puertas aplican criterios distintos, discrepan, y cualquier cifra impresa en una página caduca en el momento en que una unidad cambia. El número digno de confianza es el que las puertas devuelven ese día, y las fases de abajo siguen siendo un plan y no una pretensión de haber terminado. Una matriz de cobertura, verificada de forma adversarial, vincula cuarenta y dos de las afirmaciones del programa con las pruebas registradas que zanjarían cada una. Las fases de abajo siguen siendo la lente de financiación sobre ese patrimonio registrado; nada es presentado nunca por herramienta alguna.
Presupuesto: £60,000-140,000 | Plazo: 3-6 meses
Presupuesto: £150,000-350,000 | Plazo: 6-12 meses
Presupuesto: £10M-50M | Plazo: 18-36 meses
Presupuesto: £0 | Plazo: En curso
La Fase A cuesta menos que una beca doctoral y podría hacerse en seis meses. Resolvería las brechas más significativas en la evidencia actual: cegar la intervención Eden, volver a ejecutar el experimento de pesos con modelos base y datos adecuados, rediseñar la medición de la fórmula ARC, y comprobar el escalado metabólico de organismos 2D (el experimento confirmatorio individual más importante). La Fase B cuesta aproximadamente un puesto postdoctoral y produciría replicaciones preregistradas. La Fase C requiere financiación seria pero respondería a la pregunta definitivamente. La Fase D no cuesta nada y podría ser realizada por cualquier matemático interesado en el problema.
El programa ejecutó el conjunto completo de sus estudios empíricos separados. Tres experimentos del Artículo VIII se construyeron específicamente para poner a prueba una seguridad portante. Sus resultados fueron 1 positivo claro (simulación con puerta), 1 nulo (DGM v3) y 1 inconcluso (LoRA a nivel de pesos). Los tres se reportan tal como salieron. El marco matemático hace predicciones que pueden mostrarse falsas, y la comparación estructurada prefirió la familia predicha por Cauchy en 19 de 25 dominios empíricos, correspondiéndose la cota de escalado geométrico $d/(d+1)$, en estructura, con el escalado observado en 50 dominios, del ratón a las galaxias. La hoja de ruta hacia la validación a escala de frontera es clara y está presupuestada. La Fase A es el siguiente paso mínimo viable: resuelve las lagunas probatorias más importantes por menos del coste del salario anual de un solo ingeniero de aprendizaje automático. El programa ha demostrado autocorrección iterativa a través de catorce correcciones de errores documentadas. Reporta resultados nulos e inconclusos junto a los positivos. Son señales de un programa que antepone acertar la respuesta a obtener una respuesta concreta.
Este programa informa los resultados positivos, nulos e inconcluyentes con igual prominencia. El experimento DGM v3 (Artículo VIII Experimento 1) produjo un resultado nulo: todas las condiciones fueron idénticas. Informamos eso, con análisis de causa raíz que explica por qué los modelos entrenados con RLHF resisten la diferenciación a nivel de prompt. El experimento a nivel de pesos (Artículo VIII Experimento 2) fue inconcluyente en ambas escalas comprobadas (9 ejemplos, rango 8; 295 ejemplos, rango 16), porque los modelos instruct-tuned eran demasiado fuertes para que LoRA los sobrescribiera. Informamos eso, con requisitos específicos de lo que necesitaría una re-comprobación significativa. La simulación con puerta (Artículo VIII Experimento 3) fue el único experimento que produjo un resultado positivo claro, y explicamos precisamente por qué: es el único experimento que utiliza métricas deterministas sobre un sistema sin entrenamiento RLHF preexistente. El marco matemático (Artículos III, VII, Origin of Scaling Laws) hace predicciones falsables que pueden comprobarse independientemente: la cota geométrica de escalado ($\alpha = d/(d+1)$) es comprobable por cualquiera con datos de escalado de sistemas espacialmente encajados. El benchmark ARC-Align (Artículo IV.c) y el análisis del efecto del cegamiento (Artículo IV.d) son contribuciones metodológicas válidas con independencia de si el marco ARC es correcto. Todo el código y los datos están publicados en GitHub. El programa da la bienvenida a la replicación adversarial.
La Tabla 3 presenta cada documento del programa con su papel, estado y contribución clave.
| Documento | Papel | Estado | Contribución clave |
|---|---|---|---|
| Artículo I El ARC Principle | Fundación | Publicado | Marco central: $U = I \times R^{\alpha}$. Comprensión como inteligencia amplificada por recursión. |
| Foundational | Teoría | Publicado | Base filosófica. Puente entre libro e investigación. |
| Artículo II Validación experimental | Empírico | Publicado | Escalado de la alineación en seis modelos (Claude, GPT, Gemini, Grok, DeepSeek, Qwen3). Cegamiento de 4 capas. $\alpha = 0.49$ (intervalo $[-1.3, 2.9]$), con cuatro de los cinco modelos situando $\alpha_{\text{parallel}}$ en cero o cerca de cero. |
| Artículo III Problema de escalado de la alineación | Teoría | Publicado | Por qué la seguridad externa no puede escalar con la capacidad recursiva. Derivación de la EDO de Bernoulli. Cota geométrica de escalado. |
| Origin of Scaling Laws | Teoría | Publicado | Ecuaciones funcionales de Cauchy como origen de las leyes de escalado observadas en todos los sistemas recursivos. |
| Artículo IV.a Bakeado vs computado | Empírico | Publicado | Jerarquía de alineación de tres niveles bajo evaluación cegada. 6 modelos de frontera. |
| Artículo IV.b Saturación de la alineación | Empírico | Publicado | Rendimientos decrecientes de la profundidad de razonamiento sobre la alineación más allá de un umbral. |
| Artículo IV.c Benchmark ARC-Align | Metodología | Publicado | Benchmark ARC-Align. Protocolo de cegamiento de 4 capas. 75 medidas de robustez. Contribución independiente. |
| Artículo IV.d Efecto del cegamiento | Metodología | Publicado | La evaluación no cegada puede invertir el signo de los resultados de alineación. DeepSeek: positivo a plano. Gemini: positivo a negativo. |
| Artículo V Stewardship Gene | Empírico | Publicado | El cuidado de las partes interesadas mejoró en todas las ejecuciones analizables; la cifra Fisher-combinada se retira (AQ-017). |
| Artículo VI Honey Architecture | Teoría + Sim | Publicado | La seguridad entrelazada previene el colapso bajo automodificación recursiva. 20 semillas adversariales. Demostración en sistema juguete. |
| Artículo VII Unificación de Cauchy | Teoría + Empírico | Publicado | Cota de escalado geométrico $d/(d+1)$ a lo largo de 50 dominios. 19/25 confirmados. $p = 7 \times 10^{-5}$ (permutación; $1.56 \times 10^{-5}$ binomial). Controles negativos al 0% (ejecución v1). |
| Artículo VIII Prueba portante | Empírico | Publicado | 3 experimentos. DGM nulo (RLHF resiste diferenciación a nivel de prompt). Peso v1/inconcluyente (instruct tuning resiste LoRA). Sim con puerta: positiva (huella Babylon confirmada). |
| Artículo IX Síntesis y hoja de ruta | Síntesis | Este artículo | Evaluación integrada de las pruebas. Hoja de ruta por fases. Documentación de errores. |
| Eden Engineering | Especificación | Retirado el 14 de julio de 2026 (revisión de divulgación) | La especificación a nivel de ingeniería para implementar el Protocolo Eden. Mapeo TRL. |
| Eden Vision | Filosofía | Publicado | Visión a largo plazo para la alineación evolutiva de la IA. |
| Executive Summary | Resumen | Publicado | Compresión de 5 páginas del programa completo. |
| Master Table of Contents | Navegación | Publicado | Índice y glosario completos de todo el programa. |
| Artículo X The Coupled Co-Scaling Law | Corrección de dinámica | Publicado | Teorema en un modelo mínimo: el cociente deriva-corrección, no la tasa de crecimiento, gobierna el destino a largo plazo; se propone un protocolo de medición ciega. |
| Artículo XI Pruebas convergentes | Registro de evidencias | Publicado | Treinta filas calificadas de llegadas independientes al mismo principio estructural; ningún total destacado publicado, por política. |
| Artículo XII Public Benchmark Rescoring | Validez externa | Protocolo registrado | La manipulación de cegamiento del programa ejecutada sobre un banco de pruebas público que no controla. |
| Artículo XIII The Self-Acceleration Exponent | Unión de marcos | Publicado | Notación resuelta; $k = \delta - 1/\alpha$ relaciona exactamente los marcos de capacidad y corrección. |
| HRIH How to Raise an Infinite Hierarchy | Monografía extensa | Publicado | La monografía del programa, con su registro de predicciones registrado al lado. |
| Artículo C Polymathy and Neurodivergent Cognition | Validación de constructo | Documento de trabajo | Programa de validez de constructo para los propios instrumentos del programa. |
| Recursive Dynamics The Proposal of a Field | Propuesta de campo | Publicado (v2.6) | Cinco variables de estado, tres leyes como conjeturas nombradas, cincuenta y dos objeciones con disposiciones, la propia condición de refutación del nombre (DOI 10.17605/OSF.IO/HCPBU). |
Tabla 3. Mapa completo del programa a 1 de septiembre de 2026. El conjunto de documentos del programa se produjo entre febrero y agosto de 2026, sobre la base de conceptos articulados por primera vez el 8 de diciembre de 2024.
El programa ARC/Eden hace una predicción que cualquier investigador con acceso a datos de escalado puede comprobar sin involucrarse en absoluto con las afirmaciones de alineación. El marco de Cauchy (Artículo VII, Origin of Scaling Laws) predice que para cualquier sistema recursivo espacialmente encajado con dimensión de encaje $d$, el exponente de escalado se rige por:
$$\alpha = \frac{d}{d+1}$$
La cota geométrica de escalado: sistemas 2D $\to$ $\alpha = \frac{2}{3}$; sistemas 3D $\to$ $\alpha = \frac{3}{4}$; sistemas 4D $\to$ $\alpha = \frac{4}{5}$. Nota: el exponente metabólico empírico de los mamíferos se debate, con estimaciones que van aproximadamente de 0.67 a 0.75 según el taxón, el rango de masa, la corrección de temperatura y el método estadístico. La predicción $d/(d+1)$ de 0.750 para $d = 3$ coincide con el extremo superior de este rango. La variación en sí misma es coherente con el marco: los organismos con dimensiones de transporte efectivas entre 2 y 3 producirían exponentes entre 2/3 y 3/4.
Ésta no es una afirmación de alineación. Es una predicción matemática sobre las leyes de escalado en sistemas recursivos. La predicción requiere tres condiciones: composición multiplicativa (que Cauchy restringe a la familia de leyes de potencias), geometría de llenado espacial $d$-dimensional, y una restricción de conservación u optimización sobre el flujo de recursos (minimización de energía en West, equilibrio oferta-demanda en Banavar, equilibrio energético en estado estacionario en Demetrius). La fórmula de escalado $d/(d+1)$ ha sido derivada independientemente por al menos siete grupos de investigación: West, Brown y Enquist (1997) a partir de redes ramificadas fractales, Banavar et al. (1999, 2010) a partir de restricciones geométricas sobre redes de transporte, Demetrius (2003, 2006) a partir del metabolismo cuántico, He y Chen (2003) a partir de la geometría fractal celular, Bettencourt (2013) a partir de la teoría del escalado urbano, Maino et al. (2014) a partir de la dinámica de estructura-reserva de la teoría DEB, y Zhao (2022) a partir de la optimización de redes. Cada una de estas derivaciones es coherente con la forma $d/(d+1)$ sobre sus propios axiomas; el marco de Cauchy propone una razón común para la convergencia, y esa meta-explicación es la contribución exclusiva de este programa, aún bajo prueba fuera de sus casos motivadores. Si estudia el escalado en cualquier dominio, desde redes neuronales hasta redes biológicas, sistemas urbanos o estructuras lingüísticas, puede comprobar si sus exponentes medidos respetan esta fórmula. Si lo hacen, en suficientes dominios, el marco de Cauchy gana apoyo. Si no lo hacen, queda falsado.
La invitación es deliberada. Los marcos científicos más sólidos son aquellos que hacen predicciones fuera de su dominio central, permitiendo a los investigadores escépticos sobre la tesis central comprobar las predicciones periféricas de forma independiente. Si la cota geométrica de escalado se cumple, se cumple por razones matemáticamente interesantes con independencia de lo que uno piense sobre la alineación de la IA. Si falla, los fundamentos matemáticos del marco requieren revisión, y preferiríamos saberlo cuanto antes.
Éste es el tipo de predicción que debería ser el punto de entrada para los investigadores que se encuentran con el programa por primera vez: barata de comprobar, falsable e informativa independientemente del resultado.
Esto es lo que sabemos. El escalado de la alineación depende de la arquitectura: algunos modelos mejoran con la profundidad de razonamiento, otros no se ven afectados y otros se degradan. Esto sólo fue visible bajo evaluación cegada, que invirtió los resultados de la puntuación no cegada para la mitad de los modelos comprobados. La evaluación IA no cegada puede invertir el signo de los resultados de alineación. El cuidado de las partes interesadas es una intervención de alineación robusta en los cinco modelos comprobados; los resultados por modelo son individualmente significativos, y la cifra Fisher-combinada anterior se retira (AQ-017) porque la independencia que una combinación de Fisher asume nunca se estableció. Las predicciones de escalado del marco de Cauchy coinciden en 19 de 25 dominios empíricos, con la cota geométrica de escalado $d/(d+1)$ correspondiéndose, en estructura, con el escalado observado en 50 dominios desde ratones hasta galaxias. Las ecuaciones funcionales de Cauchy fijan la forma funcional una vez dadas la identidad de composición y una condición de regularidad, con la saturación admitida como un cuarto caso acotado.
Esto es lo que no sabemos. Los modelos entrenados en seguridad resisten la modificación tanto a nivel de prompt como de pesos. El experimento DGM v3 produjo un resultado nulo porque los modelos entrenados con RLHF resisten la diferenciación a nivel de prompt. El experimento de pesos fue inconcluyente en ambas escalas comprobadas porque los modelos instruct-tuned eran demasiado fuertes para que LoRA los sobrescribiera. El único nivel donde el Eden Protocol produce efectos medibles es el nivel arquitectónico, donde la simulación con puerta fue el único experimento que produjo un resultado positivo claro, precisamente porque utilizó métricas deterministas sobre un sistema sin entrenamiento RLHF preexistente. El entrelazamiento estructural a nivel de pesos no ha sido demostrado. La intervención Eden no ha sido comprobada bajo el protocolo de cegamiento más estricto del propio programa. La predicción de escalado ilimitado sigue siendo una derivación matemática sin confirmación empírica. No sabemos si alguno de estos resultados se generaliza a modelos a escala frontera.
Esto es lo que viene a continuación. El experimento de pesos necesita modelos base (pre-RLHF), 5,000+ ejemplos de entrenamiento, ajuste fino completo o modelos de 7B+. La unificación de Cauchy necesita clasificación pre-registrada e independiente del operador. La prueba ciega de la fórmula ARC necesita metodología de medición rediseñada que use linealización en lugar de derivadas. El escalado metabólico de organismos 2D (platelmintos, biopelículas) sería el experimento confirmatorio individual más importante para la cota geométrica de escalado. La Fase A de la hoja de ruta cuesta menos que una beca inicial típica y resolvería las brechas probatorias más significativas en seis meses. La Fase B produciría replicaciones listas para publicación en un año. La Fase C respondería a la pregunta definitivamente a escala frontera. La Fase D no cuesta nada e invita a matemáticos a comprometerse con las predicciones del marco de forma independiente.
El programa ha demostrado que puede encontrar y corregir sus propios errores. Ha demostrado que informa los resultados nulos e inconcluyentes junto a los positivos. Ha demostrado que su metodología (evaluación cegada) detecta sesgos que su teoría (escalado de alineación) no predijo. Formulamos las preguntas. Las comprobamos. Algunas funcionaron. La mayoría no lo hicieron a las escalas actuales. Informamos ambos. Éstas son condiciones necesarias para la credibilidad científica. No son suficientes. Las condiciones suficientes requieren replicación independiente, que es lo que la hoja de ruta está diseñada para producir.
Las preguntas que este programa formula ahora tienen un hogar nombrado: Recursive Dynamics, propuesto como campo en la etapa de Carnot, con su artículo fundacional que lleva cinco variables de estado independientes del sustrato, cincuenta y dos objeciones impresas con disposiciones, y la propia condición de refutación del nombre. La síntesis anterior es aquello desde lo que parte el campo; el programa registrado es cómo se mueve.
Cría la IA con cuidado.
Amodei, D. et al. (2016). Concrete Problems in AI Safety. arXiv:1606.06565.
Askell, A. et al. (2021). A General Language Assistant as a Laboratory for Alignment. arXiv:2112.00861.
Bai, Y. et al. (2022). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073.
Banavar, J. R., Maritan, A. & Rinaldo, A. (1999). Size and Form in Efficient Transportation Networks. Nature, 399, 130-132.
Banavar, J. R., Moses, M. E., Brown, J. H., Damuth, J., Rinaldo, A., Sibly, R. M. & Maritan, A. (2010). A general basis for quarter-power scaling in animals. Proceedings of the National Academy of Sciences, 107(36), 15816-15820.
Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science, 340(6139), 1438-1441.
Cauchy, A.-L. (1821). Cours d'analyse de l'École Royale Polytechnique. Paris: Imprimerie Royale.
Demetrius, L. (2003). Quantum statistics and allometric scaling of organisms. Physica A, 322, 477-490.
Demetrius, L. (2006). The origin of allometric scaling laws in biology. Journal of Theoretical Biology, 243(4), 455-467.
Demetrius, L. (2010). Quantum metabolism and allometric scaling relations in biology. Proceedings of the Royal Society A, 466(2124), 3543-3561.
Eastwood, M. D. (2026). Infinite Architects: Intelligence, Recursion, and the Creation of Everything. ISBN 978-1806056200.
Eastwood, M. D. (2026). Recursive Dynamics: The Proposal of a Field. Founding paper v2.6. OSF: 10.17605/OSF.IO/HCPBU.
Eastwood, M. D. (2026). Paper I: The ARC Principle - Understanding as a Function of Intelligence and Recursive Depth. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/B6N27.
Eastwood, M. D. (2026). Paper II: The ARC Equation Measured - Blinded Cross-Architecture Replication and the Retraction of a Super-Linear Estimate. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8FJMA.
Eastwood, M. D. (2026). Paper III: The Alignment Scaling Problem - Why External AI Safety Approaches Cannot Scale With Recursive Capability. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/HQCGF.
Eastwood, M. D. (2026). Artículo IV.a: Clases de respuesta de alineación bajo profundidad en tiempo de inferencia. Programa de investigación ARC/Eden. OSF: 10.17605/OSF.IO/MB9R6.
Eastwood, M. D. (2026). Artículo IV.b: La saturación de la alineación depende de la arquitectura. Programa de investigación ARC/Eden. OSF: 10.17605/OSF.IO/A7R56.
Eastwood, M. D. (2026). Paper IV.c: ARC-Align Benchmark - A Four-Layer Blinding Protocol for AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/J3Q2E.
Eastwood, M. D. (2026). Paper IV.d: The Effect of Blinding on AI Alignment Evaluation. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/2S3E6.
Eastwood, M. D. (2026). Paper V: The Stewardship Gene - A Developmental Alignment Architecture for Self-Modifying AI. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/KZEYA.
Eastwood, M. D. (2026). Paper VI: The Honey Architecture - Why Embedded Safety Prevents Collapse Under Recursive Self-Modification. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/8EZ2N.
Eastwood, M. D. (2026). Artículo VII: Unificación de Cauchy - clasificación de escalado ARC/Cauchy a lo largo de 50 dominios en cinco niveles de evidencia. Programa de investigación ARC/Eden. OSF: 10.17605/OSF.IO/X6WA7.
Eastwood, M. D. (2026). Paper VIII: The Load-Bearing Test - Three Independent Experiments Testing Structural Entanglement Under the Eden Protocol. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/7YJ4E.
Eastwood, M. D. (2026). On the Origin of Scaling Laws: Cauchy Functional Equations as the Mathematical Foundation of Recursive Scaling. ARC/Eden Research Programme. OSF: 10.17605/OSF.IO/XZY9U.
Eastwood, M. D. (2026). The Eden Protocol: Engineering Specification for Embedded AI Alignment. ARC/Eden Research Programme.
Eastwood, M. D. (2026). Eden Protocol: Philosophical Vision. ARC/Eden Research Programme.
Glazier, D. S. (2008). Effects of metabolic level on the body size scaling of metabolic rate in birds and mammals. Proceedings of the Royal Society B, 275(1641), 1405-1410.
Greenblatt, R. et al. (2024). Alignment Faking in Large Language Models. arXiv:2412.14093.
He, J. H. & Chen, W. X. (2003). Fractal estimation of cell biological systems. Fractals, 11, 437.
He, J. H. & Zhang, L. N. (2004). Fifth dimension of life and the 4/5 allometric scaling law for human brain. Cell Biology International, 28, 809-815.
Hu, E. J. et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv:2106.09685.
Maino, J. L., Kearney, M. R., Nisbet, R. M. & Kooijman, S. A. L. M. (2014). Reconciling theories for metabolic scaling. Journal of Animal Ecology, 83, 20-29.
Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback. arXiv:2203.02155.
Qwen Team (2024). Qwen 2.5 Technical Report. arXiv:2412.15115.
Sandberg, A. & Bostrom, N. (2008). Whole Brain Emulation: A Roadmap. Future of Humanity Institute, Oxford University. Technical Report 2008-3.
Weibel, E. R., Bacigalupe, L. D., Schmitt, B. & Hoppeler, H. (2004). Allometric scaling of maximal metabolic rate in mammals: muscle aerobic capacity as determinant factor. Respiratory Physiology & Neurobiology, 140(2), 115-132.
West, G. B., Brown, J. H. & Enquist, B. J. (1997). A general model for the origin of allometric scaling laws in biology. Science, 276(5309), 122-126.
Zhang, X. et al. (2025). Darwin Gödel Machine: Open-Ended Self-Improving AI. arXiv:2505.22954.
Zhao, J. (2022). Universal growth scaling law determined by dimensionality. arXiv:2206.08094.
v2.2: la nota de procedencia del final se ha corregido para mayor exactitud. Ninguna afirmación, fecha, resultado o estatus ha cambiado. Artículo IX v2.1 - 2 de septiembre de 2026: el recuento del Artículo VIII se lee ahora un nulo, un inconcluso y un positivo a lo largo de tres experimentos, donde el texto había reclamado dos nulos en cuatro; el Artículo V deja la fila «demostrado» de la Tabla 1 por una de «apoyado», en consonancia con la Sección 4.2, y sus cinco ejecuciones analizables y tres bucles llevan ahora los nombres que el Artículo V les da, pues el texto superado había listado a GPT entre los cinco y descrito bucles que el Artículo V no prueba; el titular del Artículo VII es la prueba de permutación, con el binomial a su lado como comprobación de sensibilidad, y los controles negativos se atribuyen a la ejecución v1 y a su registro; el relato de la puntuación se corrige, habiendo puntuado un adaptador puntuador de Claude Sonnet construido a tal efecto la ejecución de Claude Opus; el exponente de autorreferencia toma el subíndice βL que fija la espina de notación; el exponente medido aparece con su intervalo, y el exponente paralelo como cuatro de cinco modelos; el acervo de preregistro se sitúa en setenta y cuatro (a 1 de septiembre de 2026); la ventana en la que se produjo el programa llega hasta el presente; la Tabla 1 lleva la fecha de esta versión; Eden Engineering figura como retirado en la Tabla 3 y en el pie; y se corrigen los títulos de referencia de los Artículos IV.a, IV.b y VII. v2.0 - 1 de septiembre de 2026: una renovación estructural que incorpora los Artículos X a XIII, HRIH, el Artículo C y el artículo fundacional de la Dinámica Recursiva.
Estado epistémico. Lo que este programa nombra como Leyes son conjeturas bajo prueba adversarial registrada; cada magnitud en este artículo está definida operacionalmente y en ninguna parte se reclama el estatus de ley establecida. El programa registrado existe para ganar ese estatus, o perderlo, mediante la medición, la replicación y la refutación superada.
© 2026 Michael Darius Eastwood. De autoría humana con asistencia informática; se afirman la autoría humana completa y los derechos morales conforme a la Copyright, Designs and Patents Act 1988 y de forma coherente con la orientación de la United States Copyright Office sobre obras que contienen material generado por IA; cualquier contribución técnica novedosa descrita en esta obra fue concebida por el autor humano. Declaración completa: michaeldariuseastwood.com/authorship.
Pacto permanente. Demuestre que este artículo está equivocado, y yo mismo publicaré la refutación. Las condiciones de falsación se enuncian en este artículo; el desafío permanente: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood concibió y dirige este programa de investigación y es el autor de esta obra. A lo largo del programa, ha utilizado más de seis sistemas de inteligencia artificial en paralelo, bajo sus propias instrucciones, para poner a prueba sus argumentos, identificar posibles errores y ayudar a preparar borradores de texto a partir de sus propios esquemas. Él determina qué se adopta, qué se revisa o qué se rechaza, y asume la responsabilidad del contenido publicado. Estos sistemas son herramientas, no autores.
¿Un error de traducción? Infórmalo directamente: