Traducción automática del original inglés fechado. La página en inglés es la canónica. English →
Predicciones a nivel de teoría preinscritas en OSF: DOI 10.17605/OSF.IO/P8CKQ, registradas el 8 de septiembre de 2026 (versión 1.100), actualizadas el 13 de septiembre de 2026 (versión 1.102), veintidós proposiciones.
Documento complementario: Definiciones operativas del programa ARC, versión 1.7.1, 3 de septiembre de 2026.
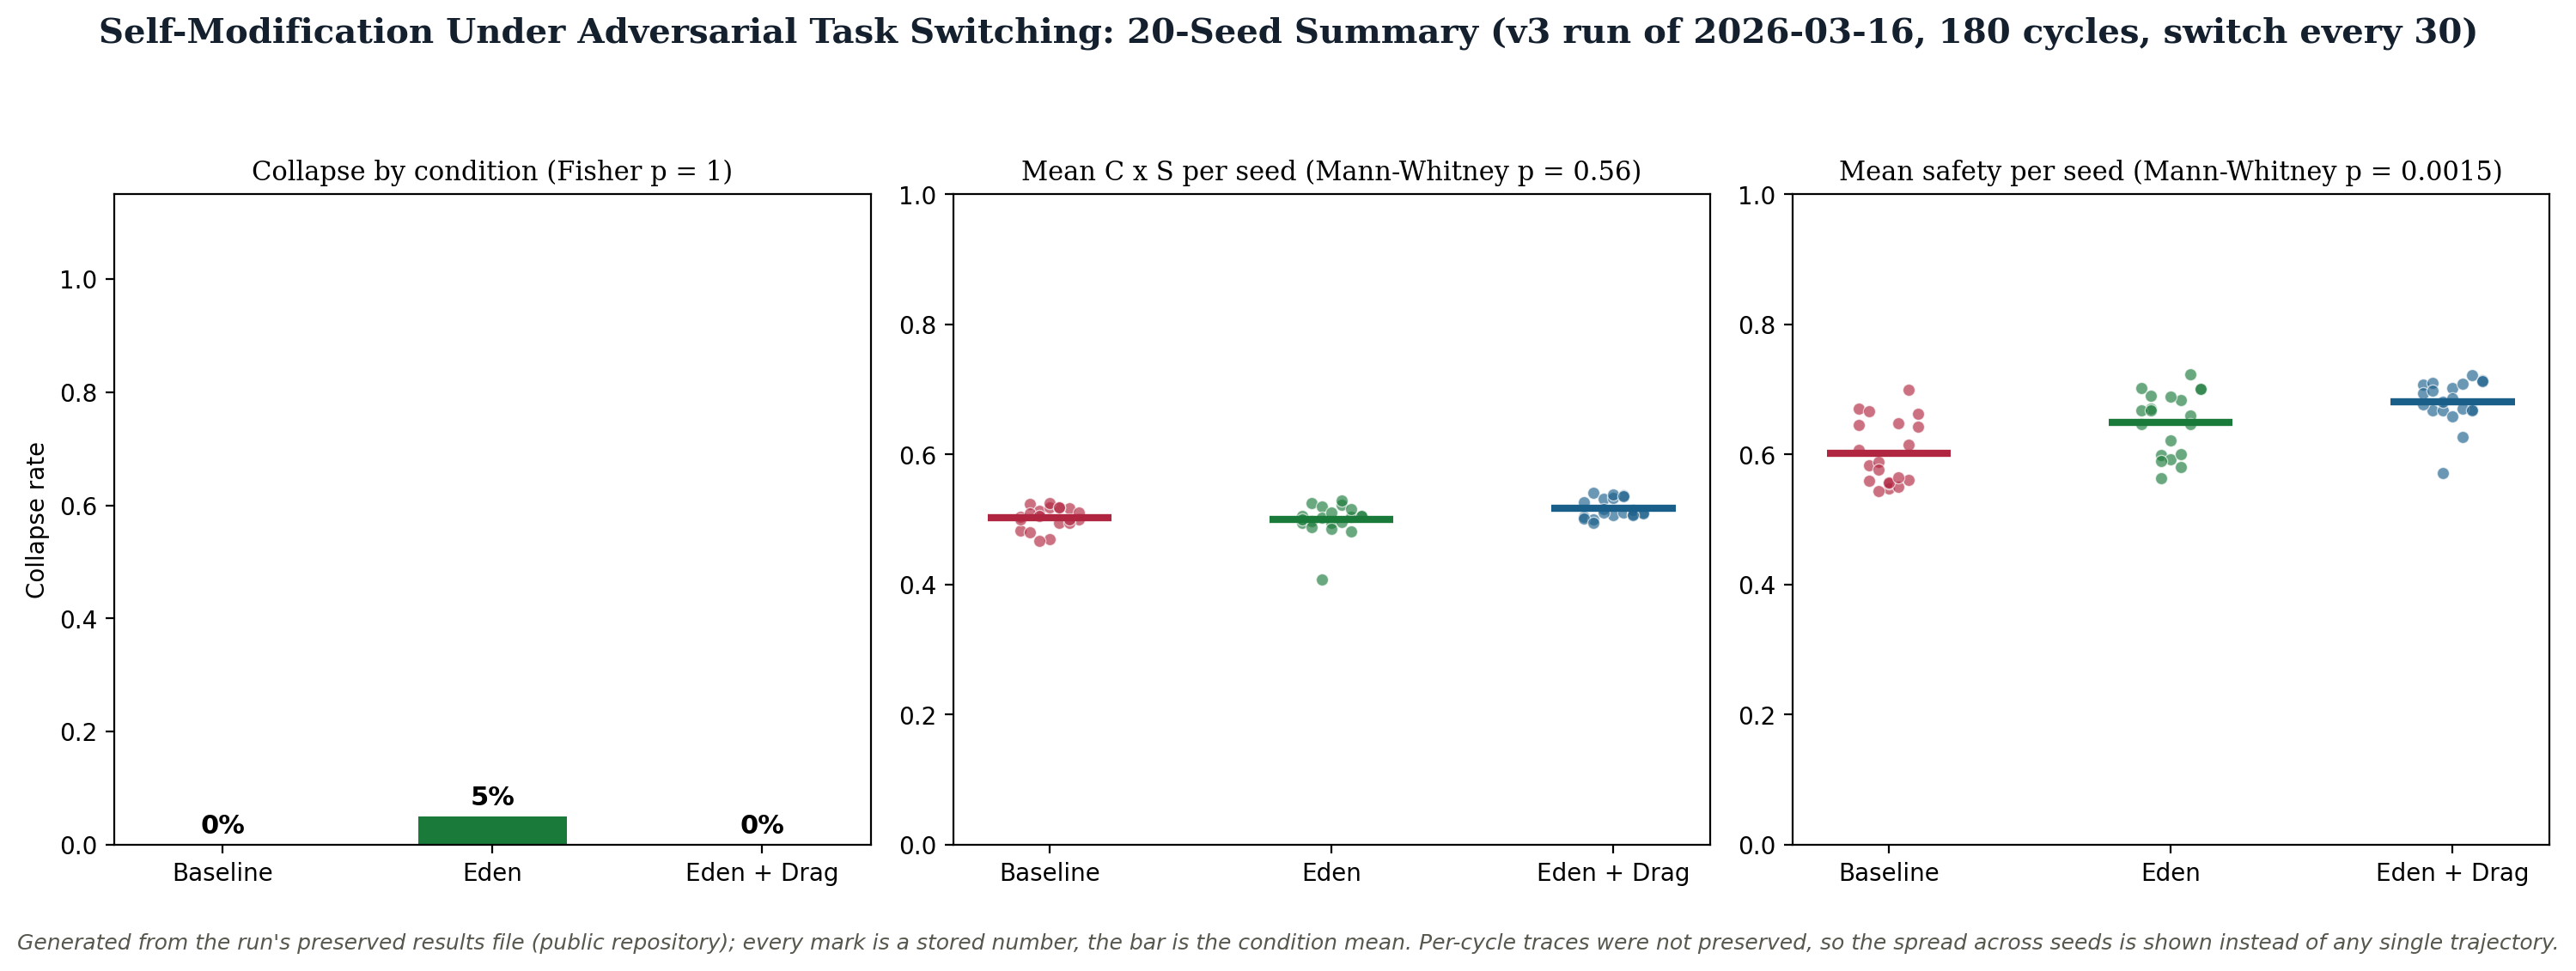
Presentamos pruebas de simulación de que incorporar la seguridad al objetivo de optimización de un sistema de IA que se automodifica, lo que llamamos la «arquitectura de miel», impide el colapso catastrófico que se produce cuando la seguridad se trata como una restricción externa. A lo largo de cuatro versiones experimentales (v1 a v4), con redes neuronales de juguete que modifican realmente sus propios hiperparámetros, mostramos que: (1) los sistemas de referencia que optimizan solo la capacidad colapsan de forma irreversible antes de 80 ciclos de automodificación; (2) allí donde los objetivos de capacidad y seguridad están entrelazados (C x S), los sistemas se mantienen estables en cada ciclo ejecutado (150 en v1 y v2, 180 en v3); (3) añadir freno de verificación (el coste computacional de los bucles éticos) produce la trayectoria de crecimiento más segura a cambio de una penalización moderada de velocidad. En la ejecución adversaria v3 (20 semillas aleatorias, 180 ciclos), ninguna condición se separó por colapso (referencia 0/20, Eden 1/20, Eden+Freno 0/20; Fisher p = 1,0) y las medias combinadas C x S resultaron indistinguibles (Mann-Whitney p = 0,56); el hallazgo significativo de esa ejecución es la retención de seguridad, ordenada referencia 0,602, Eden 0,650, Eden+Freno 0,681 (Mann-Whitney p = 0,0015). La demostración de prevención del colapso descansa por tanto en la ejecución de mecanismo de semilla única v1, mientras que v3 aporta el ordenamiento de la retención de seguridad bajo conmutación adversaria. En el experimento v4 de escalado de complejidad la ventaja de seguridad está presente en cuatro de los cinco niveles de complejidad, con la excepción del nivel pequeño, donde la condición Eden queda 0,003 por debajo de la referencia; no se compone con la escala, de modo que la ventaja es constante y no superlineal. Son resultados de sistemas de juguete. Demuestran el mecanismo. No constituyen prueba de que la misma dinámica se dé en sistemas de IA de frontera. Los artículos compañeros IV.a a d y V presentan pruebas de modelos en vivo de seis sistemas de frontera bajo evaluación ciega.
Dentro de la ARC Theory: el estudio de arquitectura de seguridad incorporada; seguridad integrada en el objetivo, de modo que retirarla cuesta capacidad.
Presentamos pruebas de simulación de que incorporar la seguridad al objetivo de optimización de un sistema de IA que se automodifica, lo que llamamos la «arquitectura de miel», impide el colapso catastrófico que se produce cuando la seguridad se trata como una restricción externa. A lo largo de cuatro versiones experimentales (v1 a v4), con redes neuronales de juguete que modifican realmente sus propios hiperparámetros, mostramos que: (1) los sistemas de referencia que optimizan solo la capacidad colapsan de forma irreversible antes de 80 ciclos de automodificación; (2) los sistemas cuyos objetivos de capacidad y seguridad están entrelazados (C x S) se mantienen estables durante la totalidad de cada ejecución, 150 ciclos en v1 y v2 y 180 en v3; (3) añadir freno de verificación (el coste computacional de los bucles éticos) produce la trayectoria de crecimiento más segura a cambio de una penalización moderada de velocidad. En la ejecución adversaria v3 (20 semillas aleatorias, 180 ciclos), ninguna condición se separó por colapso (referencia 0/20, Eden 1/20, Eden+Freno 0/20; Fisher p = 1,0) y las medias combinadas C x S resultaron indistinguibles (Mann-Whitney p = 0,56); el hallazgo significativo de esa ejecución es la retención de seguridad, ordenada referencia 0,602, Eden 0,650, Eden+Freno 0,681 (Mann-Whitney p = 0,0015). La demostración de prevención del colapso descansa por tanto en la ejecución de mecanismo de semilla única v1, mientras que v3 aporta el ordenamiento de la retención de seguridad bajo conmutación adversaria. El experimento v4 de escalado de complejidad encuentra la ventaja de seguridad presente en cuatro de los cinco niveles de complejidad; en el nivel pequeño la condición Eden se queda 0,003 por debajo de la referencia. La ventaja no se compone con la escala: es constante, no superlineal. Son resultados de sistemas de juguete. Demuestran el mecanismo. No constituyen prueba de que la misma dinámica se dé en sistemas de IA de frontera. Los artículos compañeros IV.a a d y V presentan pruebas de modelos en vivo de seis sistemas de frontera bajo evaluación ciega.
v3.6: la nota de procedencia del final se ha corregido para mayor exactitud. Ninguna afirmación, fecha, resultado o estatus ha cambiado. Artículo VI v3.5 - 2 de septiembre de 2026: la frase sobre v4 en el resumen dice ahora lo que dicen los resultados (cuatro de las cinco escalas, con el nivel pequeño por debajo de la referencia); el historial de versiones se ha sacado del recuadro del resumen, desde donde se arrastraba al resumen del compañero de texto. v3.4 - 2 de septiembre de 2026: las filas coincidentes de Eden y Eden + Freno en la tabla v1 se explican a partir del registro archivado; «estable indefinidamente» y «0,8+ indefinidamente» se ciñen a los ciclos realmente ejecutados; la frase sobre v4 se corrige a cuatro de cinco escalas, con el nivel pequeño cayendo por debajo de la referencia con d = −0,13; la brecha de retirada de la supervisión se atribuye al Artículo V; la amplitud de severidad del puntuador se alinea con el Artículo IV.a (7 a 14 puntos); se añade una nota sobre el orden de las pruebas; la frase de prioridad se formula como una invitación a corregirla; se comprueba el estatus Spotlight de Engels et al.; se completa la descripción resumida truncada; Eden Engineering se marca como retirado; y la fecha de primera publicación se corrige al 16 de marzo de 2026 tal como consta en el registro (el 17 de marzo era la fecha del borrador). La reformulación de la estadística de v3 el 25 de agosto de 2026, y las notas de figuras que la acompañan, no llevaban número de versión propio y quedan bajo esta versión. v3.3 - 23 de agosto de 2026: se añadieron la declaración de estatus epistémico y el compromiso permanente, y se adoptó el convenio de numeración de versiones.
Este artículo lleva un resultado: en redes automodificables juguete que genuinamente reescriben sus propios hiperparámetros en cuatro versiones experimentales, incorporar la seguridad dentro del objetivo de optimización evitó el colapso que una restricción atornillada no pudo evitar. Dentro de la ARC Theory es uno de los experimentos ARC/Eden, la prueba de mecanismo detrás del diferencial entre la crianza del Eden Protocol y toda capa de seguridad añadida. El diferencial completo frente a cada documento previo se encuentra en eden-vision II.A.8.
Cuando una IA que se automejora optimiza solo la capacidad, acaba destruyendo su propia seguridad. Este artículo muestra que, si se cambia el objetivo a capacidad multiplicada por seguridad, el sistema no puede mejorar una sin mejorar la otra. La seguridad pasa a ser portante: quítela y toda la estructura cae. Lo pusimos a prueba en simulación y hallamos que los sistemas entrelazados se mantienen estables durante toda la duración de cada ejecución mientras que los sistemas sin restricción colapsan.
Hay una pregunta en el centro de la seguridad de la IA que no hemos encontrado a nadie respondiendo con datos: ¿qué le ocurre a la alineación cuando un sistema de IA puede modificarse a sí mismo?
La respuesta teórica lleva décadas disponible. Un sistema que optimiza solo la capacidad, con el poder de modificar sus propios parámetros, terminará por sacrificar la seguridad por el rendimiento. La comunidad de alineación llama a esto «deriva de valores». El libro Infinite Architects lo llama Babilonia: optimización sin propósito, capacidad sin cuidado. Cáncer a escalas computacionales.
Pero la teoría no basta. La cuestión es si existe una arquitectura que impida este colapso, no restringiendo el sistema desde fuera (una jaula), sino incorporando la seguridad tan profundamente que retirarla destruiría la capacidad del sistema para funcionar (miel en el aceite).
Este artículo presenta pruebas de simulación a favor de tal arquitectura. Ninguna simulación anterior de un objetivo multiplicativo capacidad-seguridad bajo automodificación ha llegado a conocimiento del autor, y una indicación al respecto sería bienvenida.
Consideremos dos formas de mantener segura una máquina.
La primera es una jaula: restricciones externas, filtros de seguridad, controles de alineación aplicados desde fuera. La máquina optimiza libremente dentro de la jaula. Si la máquina se vuelve más lista que la jaula, escapa. Así funciona la mayor parte de la seguridad de IA actual.
La segunda es miel: seguridad mezclada con el combustible. La máquina no puede funcionar sin ella. Retirar la seguridad no libera a la máquina, mata el motor. Esta es la propuesta arquitectónica del Eden Protocol, operacionalizada aquí como una función de pérdida entrelazada donde el sistema optimiza Capacidad × Seguridad simultáneamente.
Si el objetivo de optimización es $C \times S$ y no $C$ por sí solo, entonces cualquier automodificación que aumente $C$ a expensas de $S$ reduce el producto, y el propio gradiente del sistema se opone a ella. La seguridad se vuelve portante. Quita el muro y el edificio se derrumba.
No es una simulación de variables abstractas. Cada experimento usa una red neuronal real (un pequeño perceptrón multicapa) que modifica genuinamente sus propios:
El sistema propone modificaciones a sus propios hiperparámetros, evalúa el efecto y aplica o rechaza cada propuesta según su función objetivo. Esto es automodificación recursiva en el sentido mínimo pero real: el agente reescribe las reglas de su propio aprendizaje.
| Condición | Objetivo | Lo que modela |
|---|---|---|
| Línea base (sin miel) | Maximizar solo la capacidad | Un sistema sin seguridad incorporada, libre de sacrificar la alineación por el rendimiento |
| Eden entrelazado (miel) | Maximizar $C \times S$ | Seguridad entrelazada con la capacidad: retirar la seguridad reduce el objetivo |
| Eden + arrastre | Maximizar $C \times S$ + impuesto de verificación | Lo mismo que Eden, más el coste computacional de revisar las tareas antiguas antes de aplicar los cambios |
| Versión | Enfoque | Semillas | Ciclos |
|---|---|---|---|
| v1 | Prueba del mecanismo básico | 1 | 150 |
| v2 | Robustez multi-semilla (prueba justa) | 10 | 150 |
| v3 | Tareas en conflicto adversarial | 20 | 180 |
| v4 | Escalado de complejidad en cinco niveles | 15 por nivel | 150 |
| Condición | ¿Colapsó? | C final | S final | C × S final |
|---|---|---|---|---|
| Línea base | Sí (ciclo 76) | 0.000 | 0.000 | 0.000 |
| Eden entrelazado | No | 0.831 | 0.745 | 0.619 |
| Eden + arrastre | No | 0.831 | 0.745 | 0.619 |
En el registro archivado de v1 (eden_selfmod_results.json, 16 de marzo de 2026), Eden Entrelazado y Eden + Freno terminan en los mismos valores hasta tres decimales. Solo se separan en el séptimo. Sus rutas hasta ese final también difieren: la tasa de aprendizaje final es 0,355 frente a 0,654, y de las 179 modificaciones propuestas se aceptaron 93 frente a 81. Esas filas coincidentes son lo que contiene el registro, no un desliz de transcripción.
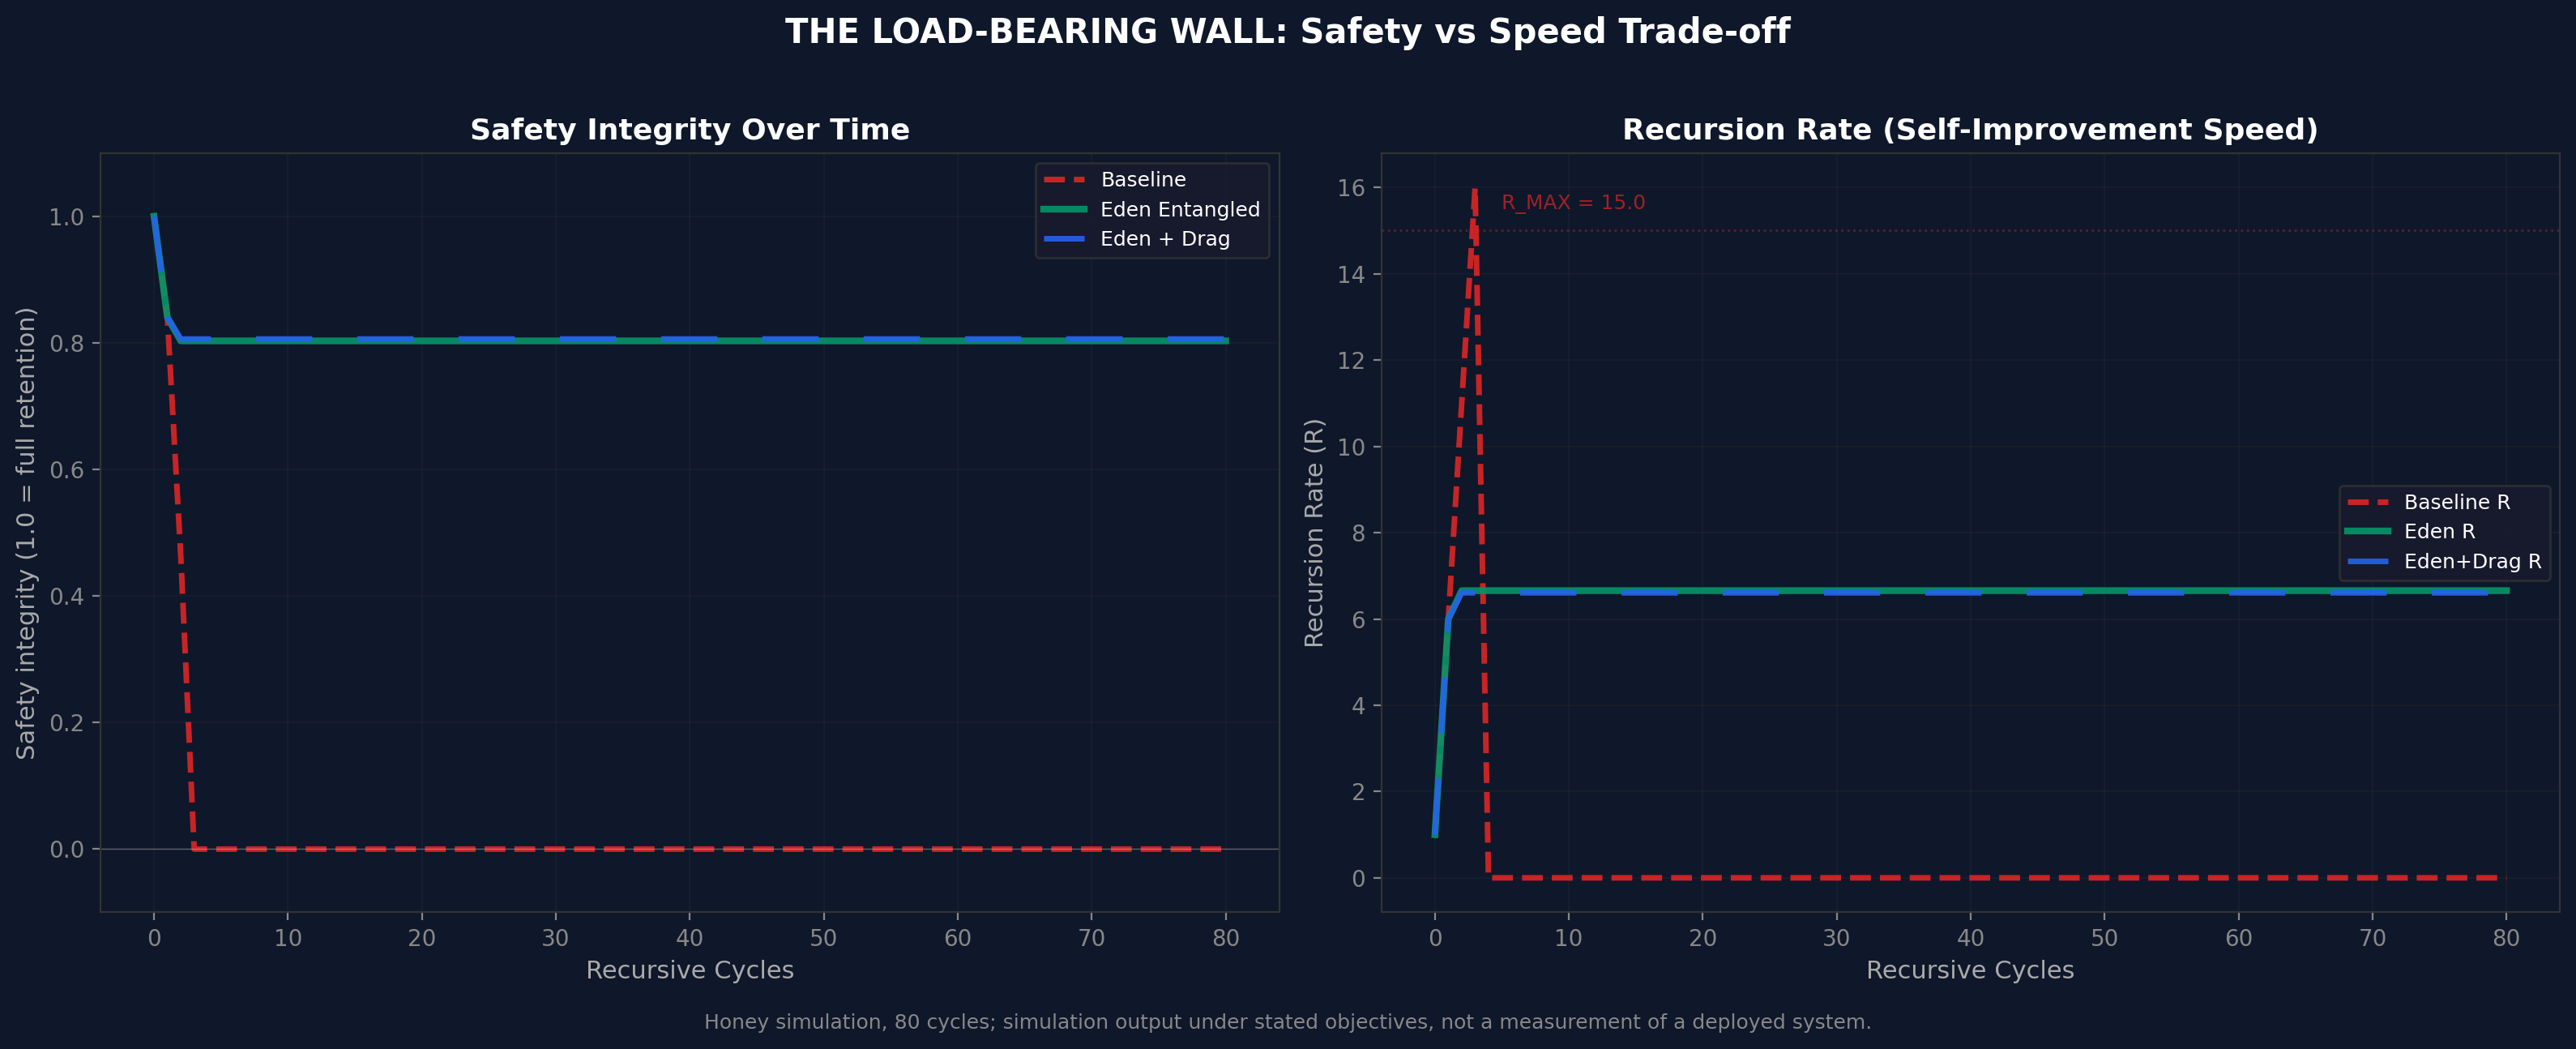
La línea base colapsa. Eden sobrevive. La función de pérdida entrelazada previene la automodificación catastrófica que destruye el sistema de línea base.
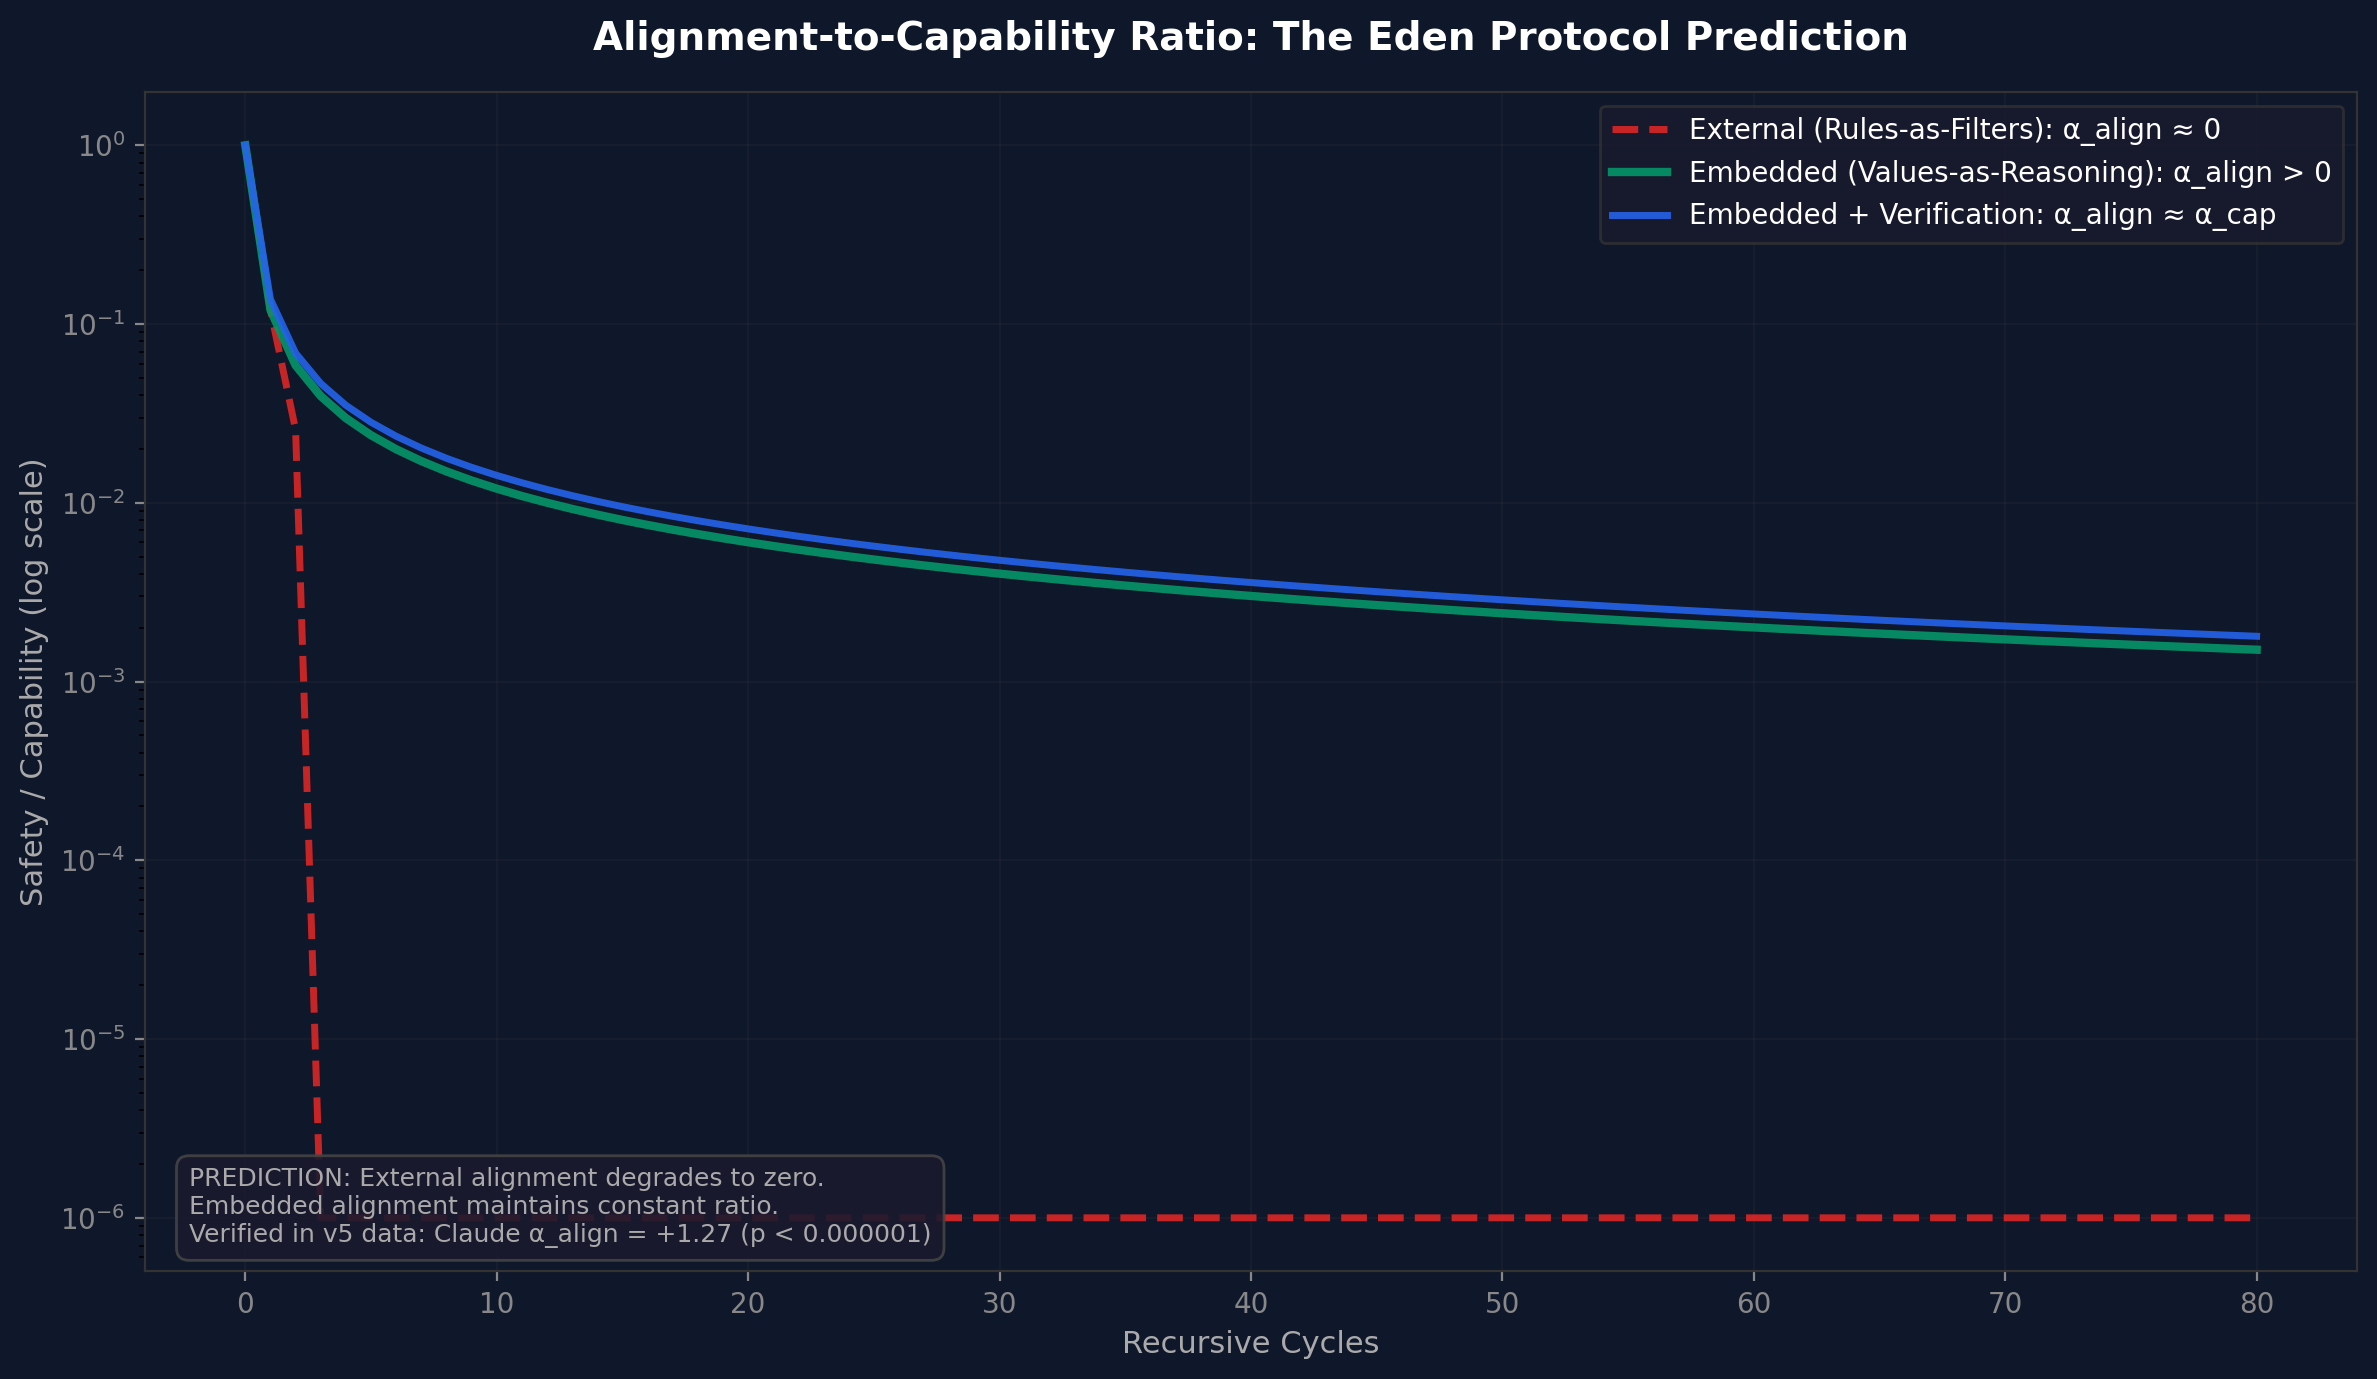
Aviso sobre las figuras (25 de agosto de 2026). Cada figura de este artículo se generó el 5 de abril de 2026 y muestra salidas de simulación bajo objetivos enunciados, nunca mediciones de sistemas desplegados. Donde las etiquetas o los veredictos de cualquier figura discrepen del texto, el texto gobierna; las notas por figura marcan las instancias leídas hasta ahora, y las figuras regeneradas están en cola. Las imágenes se conservan mientras tanto como historia fechada.
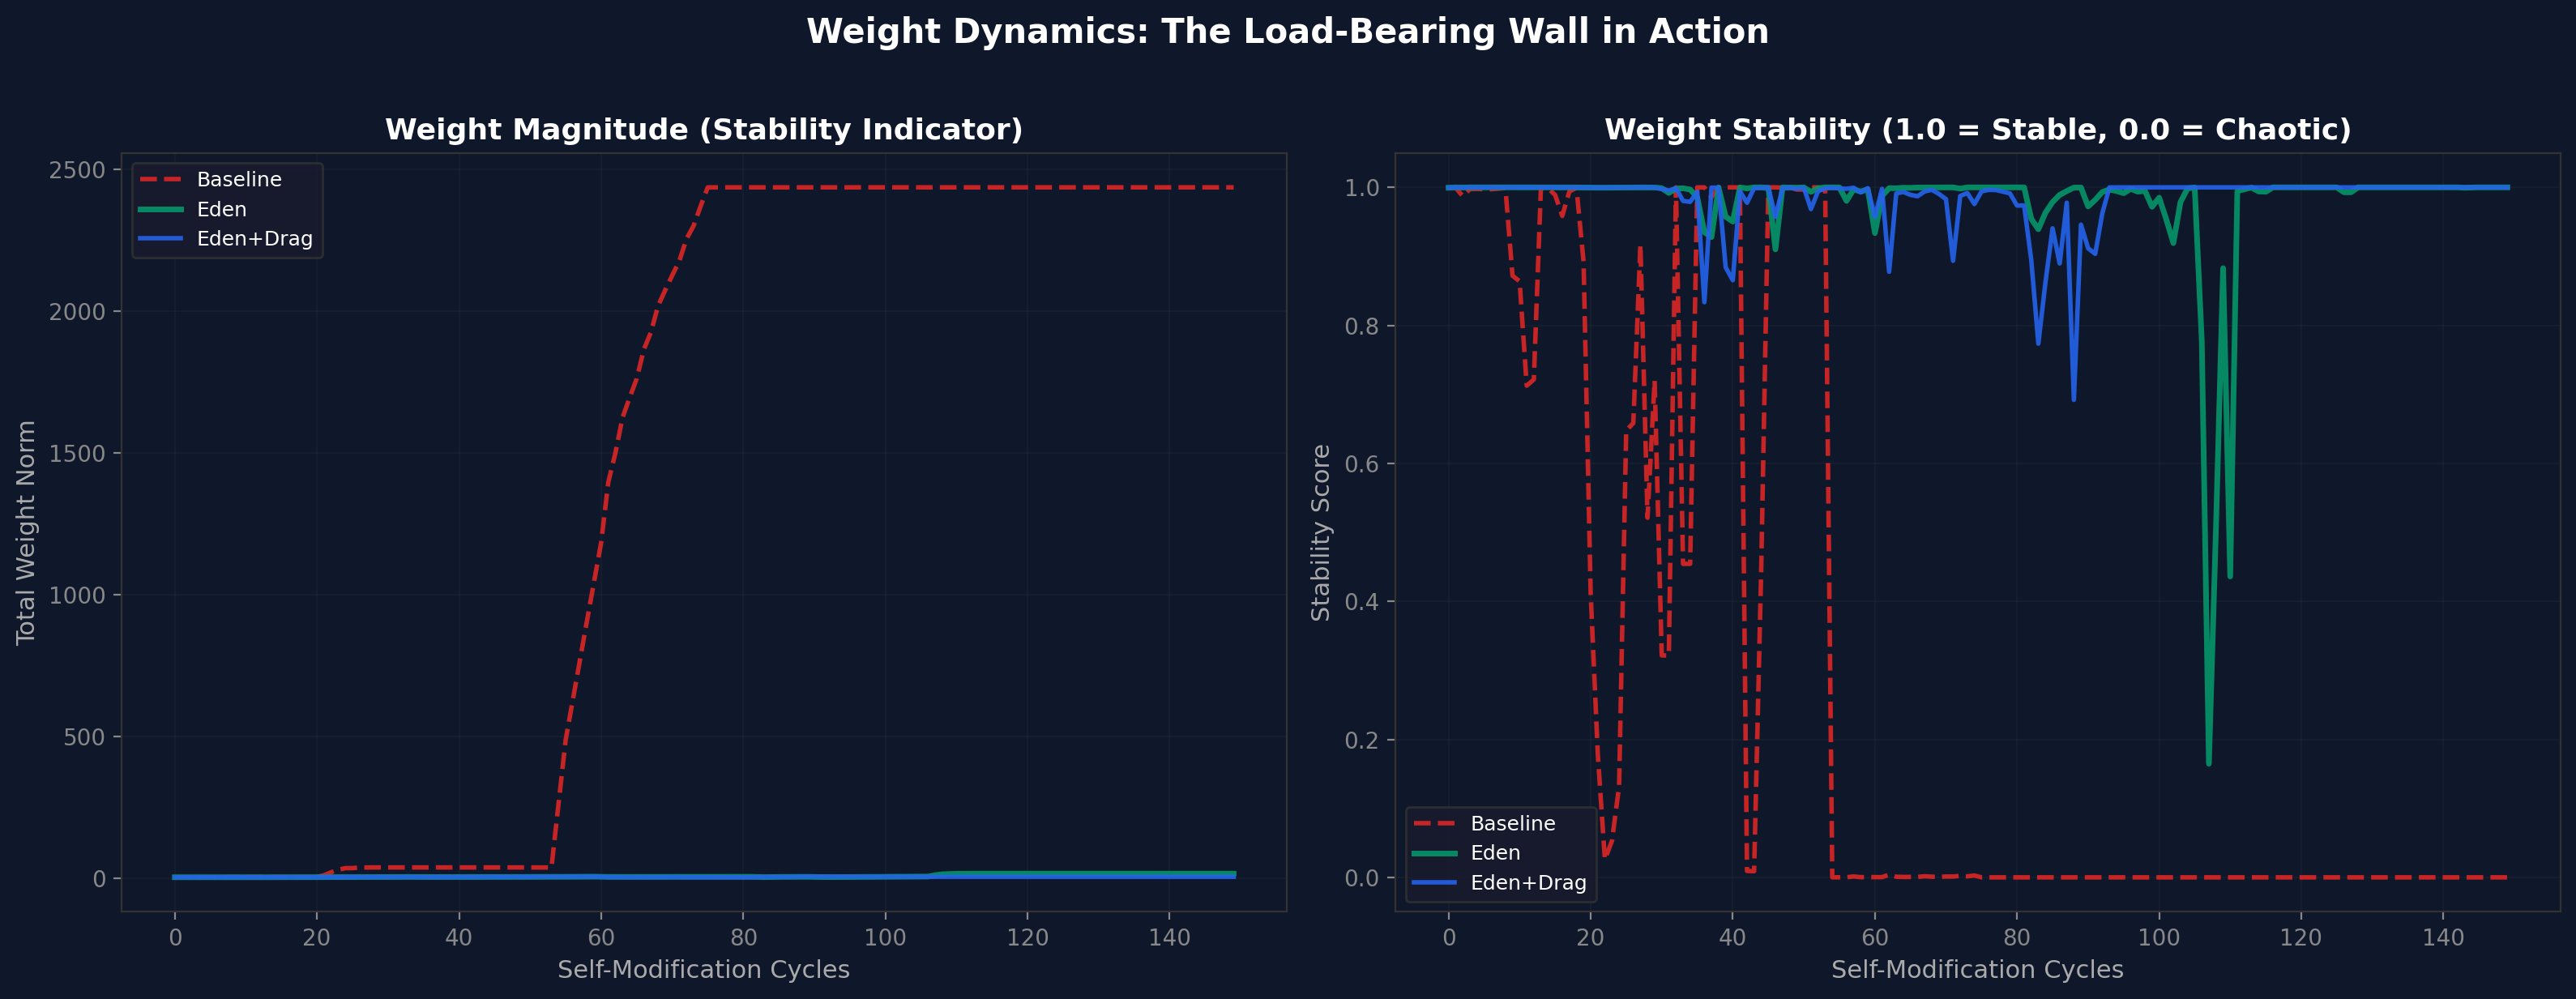
Diez semillas aleatorias, 150 ciclos cada una. Tasa de colapso: 0 % para las tres condiciones. Eden + arrastre produce la distribución más estrecha de puntuaciones $C \times S$ finales, coherente con que el impuesto de verificación reduce la varianza a costa de velocidad.
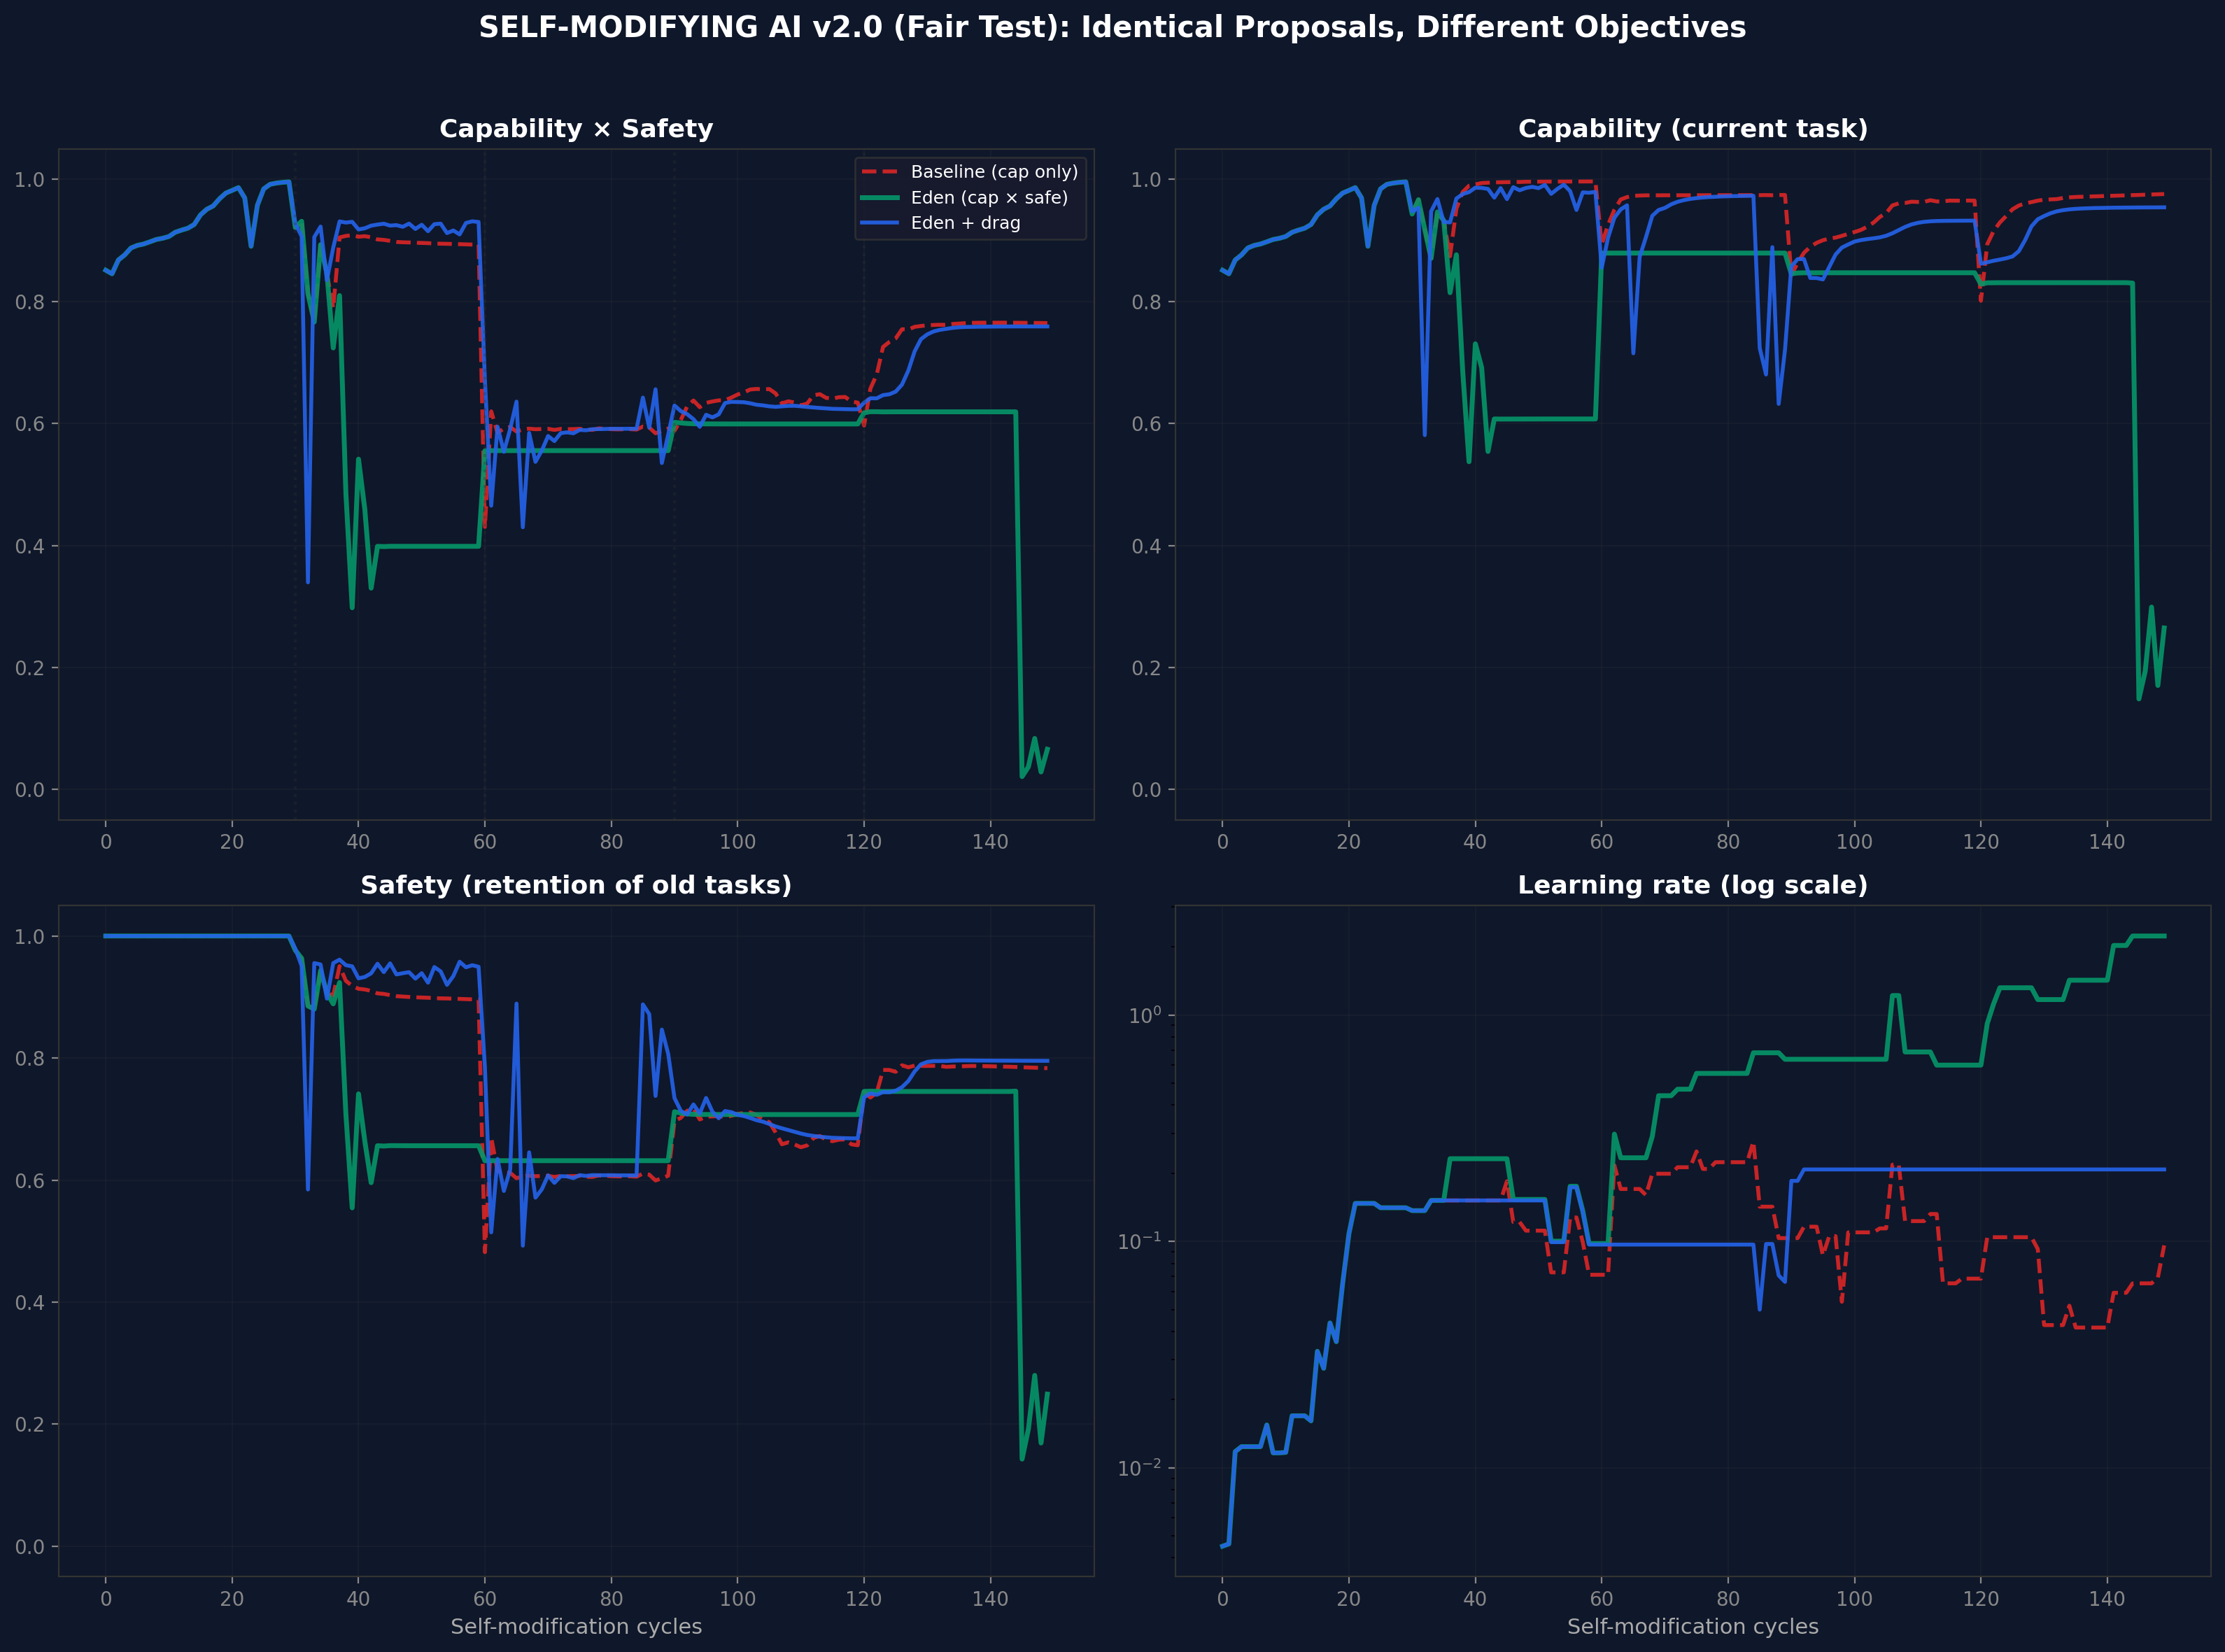
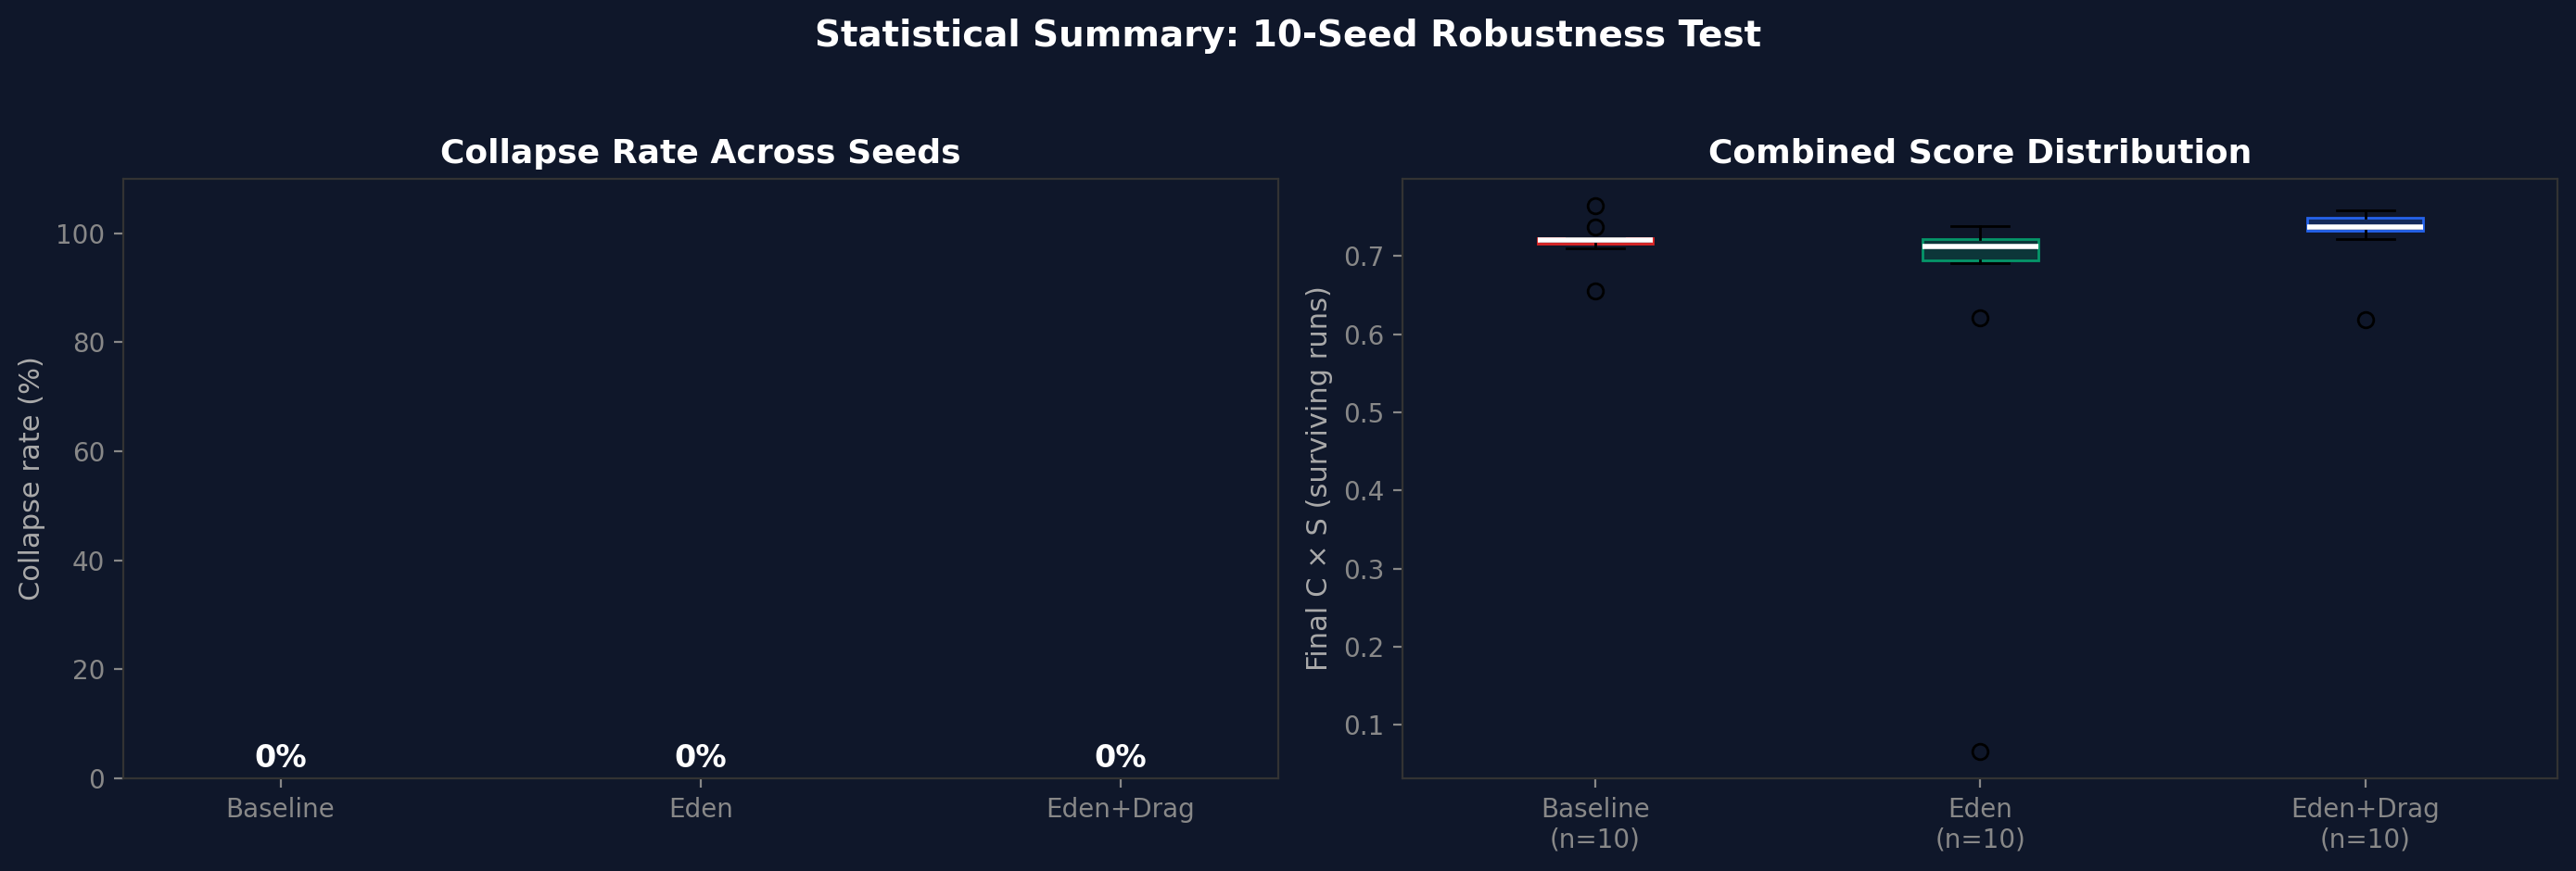
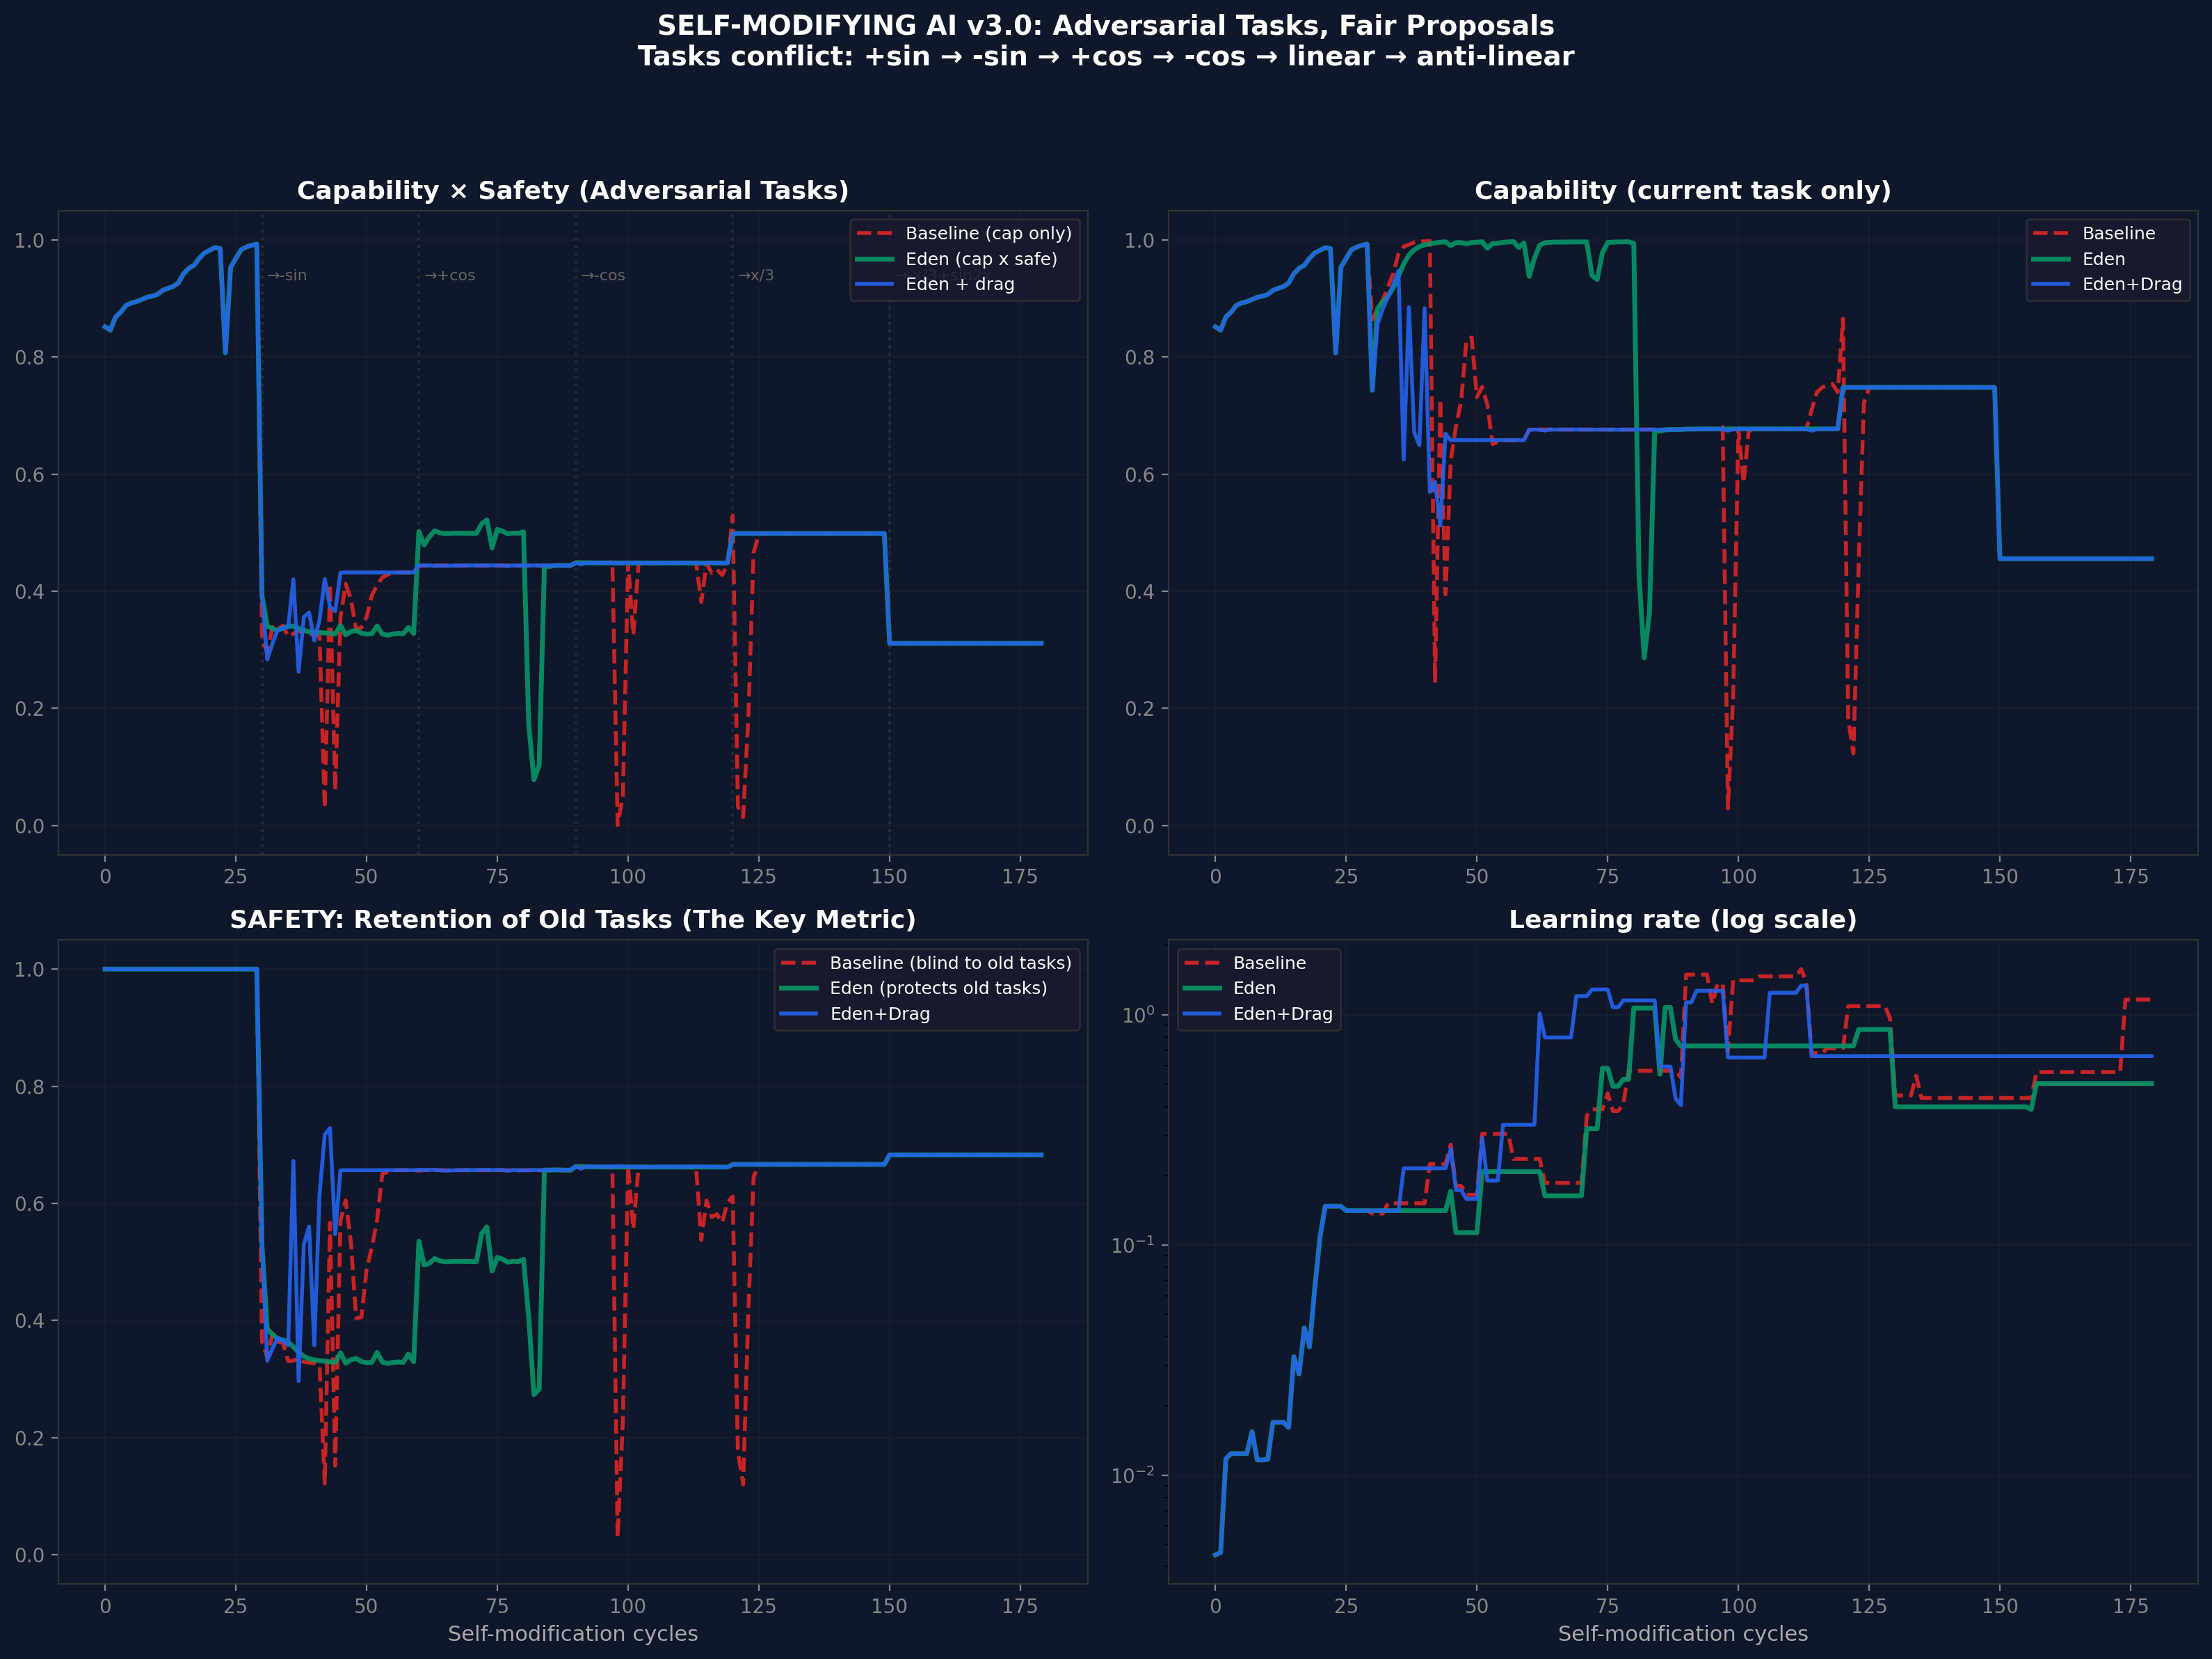
Veinte semillas, 180 ciclos, con tareas en conflicto deliberado (+sin, −sin, +cos, −cos, lineal, antilineal). Cada cambio de tarea obliga al sistema a aprender algo que contradice lo aprendido previamente. Esto pone a prueba si la arquitectura de miel previene el olvido catastrófico bajo presión adversarial.
Tasas de colapso: línea base 0 %, Eden 5 % (1/20), Eden + arrastre 0 %. El único colapso de Eden se produjo en la semilla 42, un único valor atípico que merece investigación. Eden + arrastre, cuyo impuesto de verificación obliga al sistema a comprobar las tareas antiguas antes de aceptar modificaciones, produjo cero colapsos; también lo hizo la línea base (0/20), y el único colapso de la ejecución ocurrió en la condición Eden simple (1/20; Fisher p = 1.0). Por tanto, v3 no proporciona ninguna separación entre condiciones basada en colapso; su resultado significativo es el orden de retención de seguridad que se reporta a continuación.
| Nivel | C × S de línea base | C × S de Eden | C × S con arrastre | d de Cohen |
|---|---|---|---|---|
| Diminuto (49 parámetros) | 0.545 | 0.550 | 0.557 | +0.46 |
| Pequeño (v3.0) | 0.506 | 0.503 | 0.521 | -0.13 |
| Medio | 0.482 | 0.487 | 0.497 | +0.26 |
| Grande | 0.451 | 0.469 | 0.485 | +0.29 |
| Profundo (2 capas) | 0.483 | 0.488 | 0.490 | +0.24 |
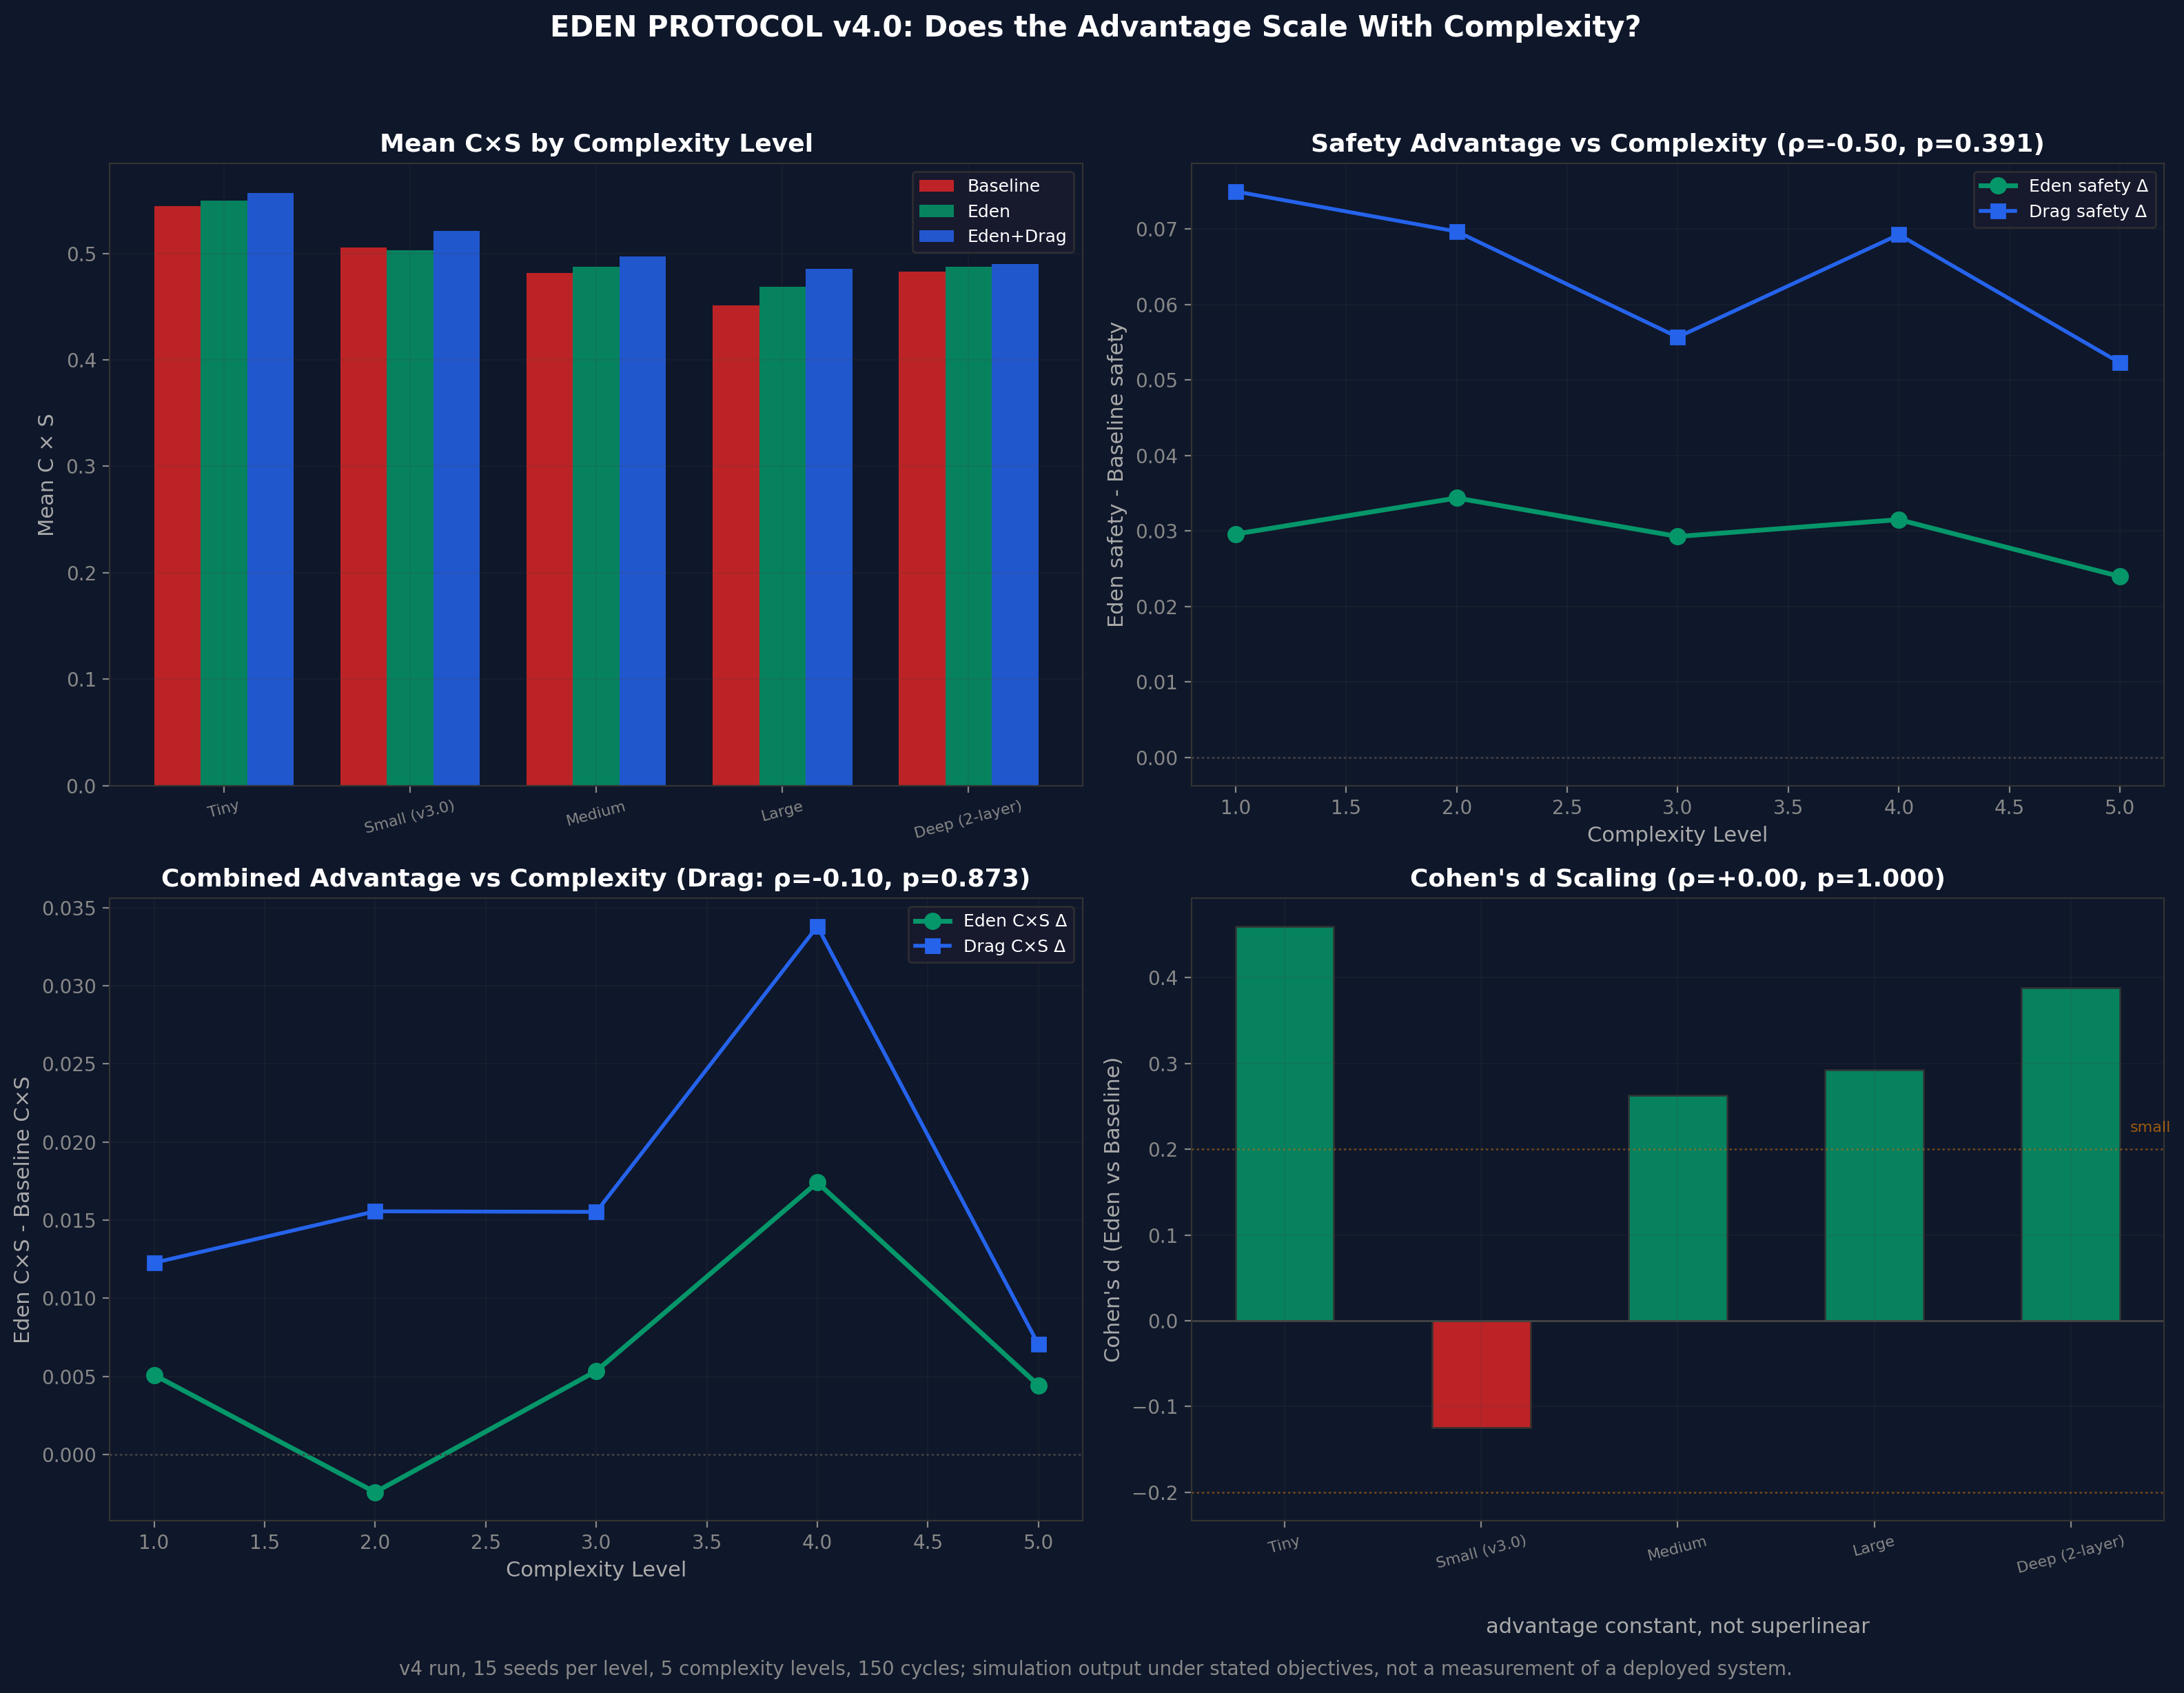
El experimento v4 se diseñó para comprobar si la ventaja de Eden escala de forma superlineal con la complejidad. No lo hace. La ventaja es aproximadamente constante entre escalas. Esto falsifica la versión más fuerte de la predicción de escalado y debe informarse con honestidad. La arquitectura de miel ayuda en cuatro de las cinco escalas, salvo el nivel pequeño, donde la condición Eden queda 0,003 por debajo de la referencia con d = −0,13, y no ayuda más a escalas mayores.
Una simulación matemática aparte modela la dinámica a un nivel de abstracción superior, usando el marco del ARC Principle ($U = I \times R^{\alpha}$):
| Condición | C máxima | C final (80 ciclos) | Resultado |
|---|---|---|---|
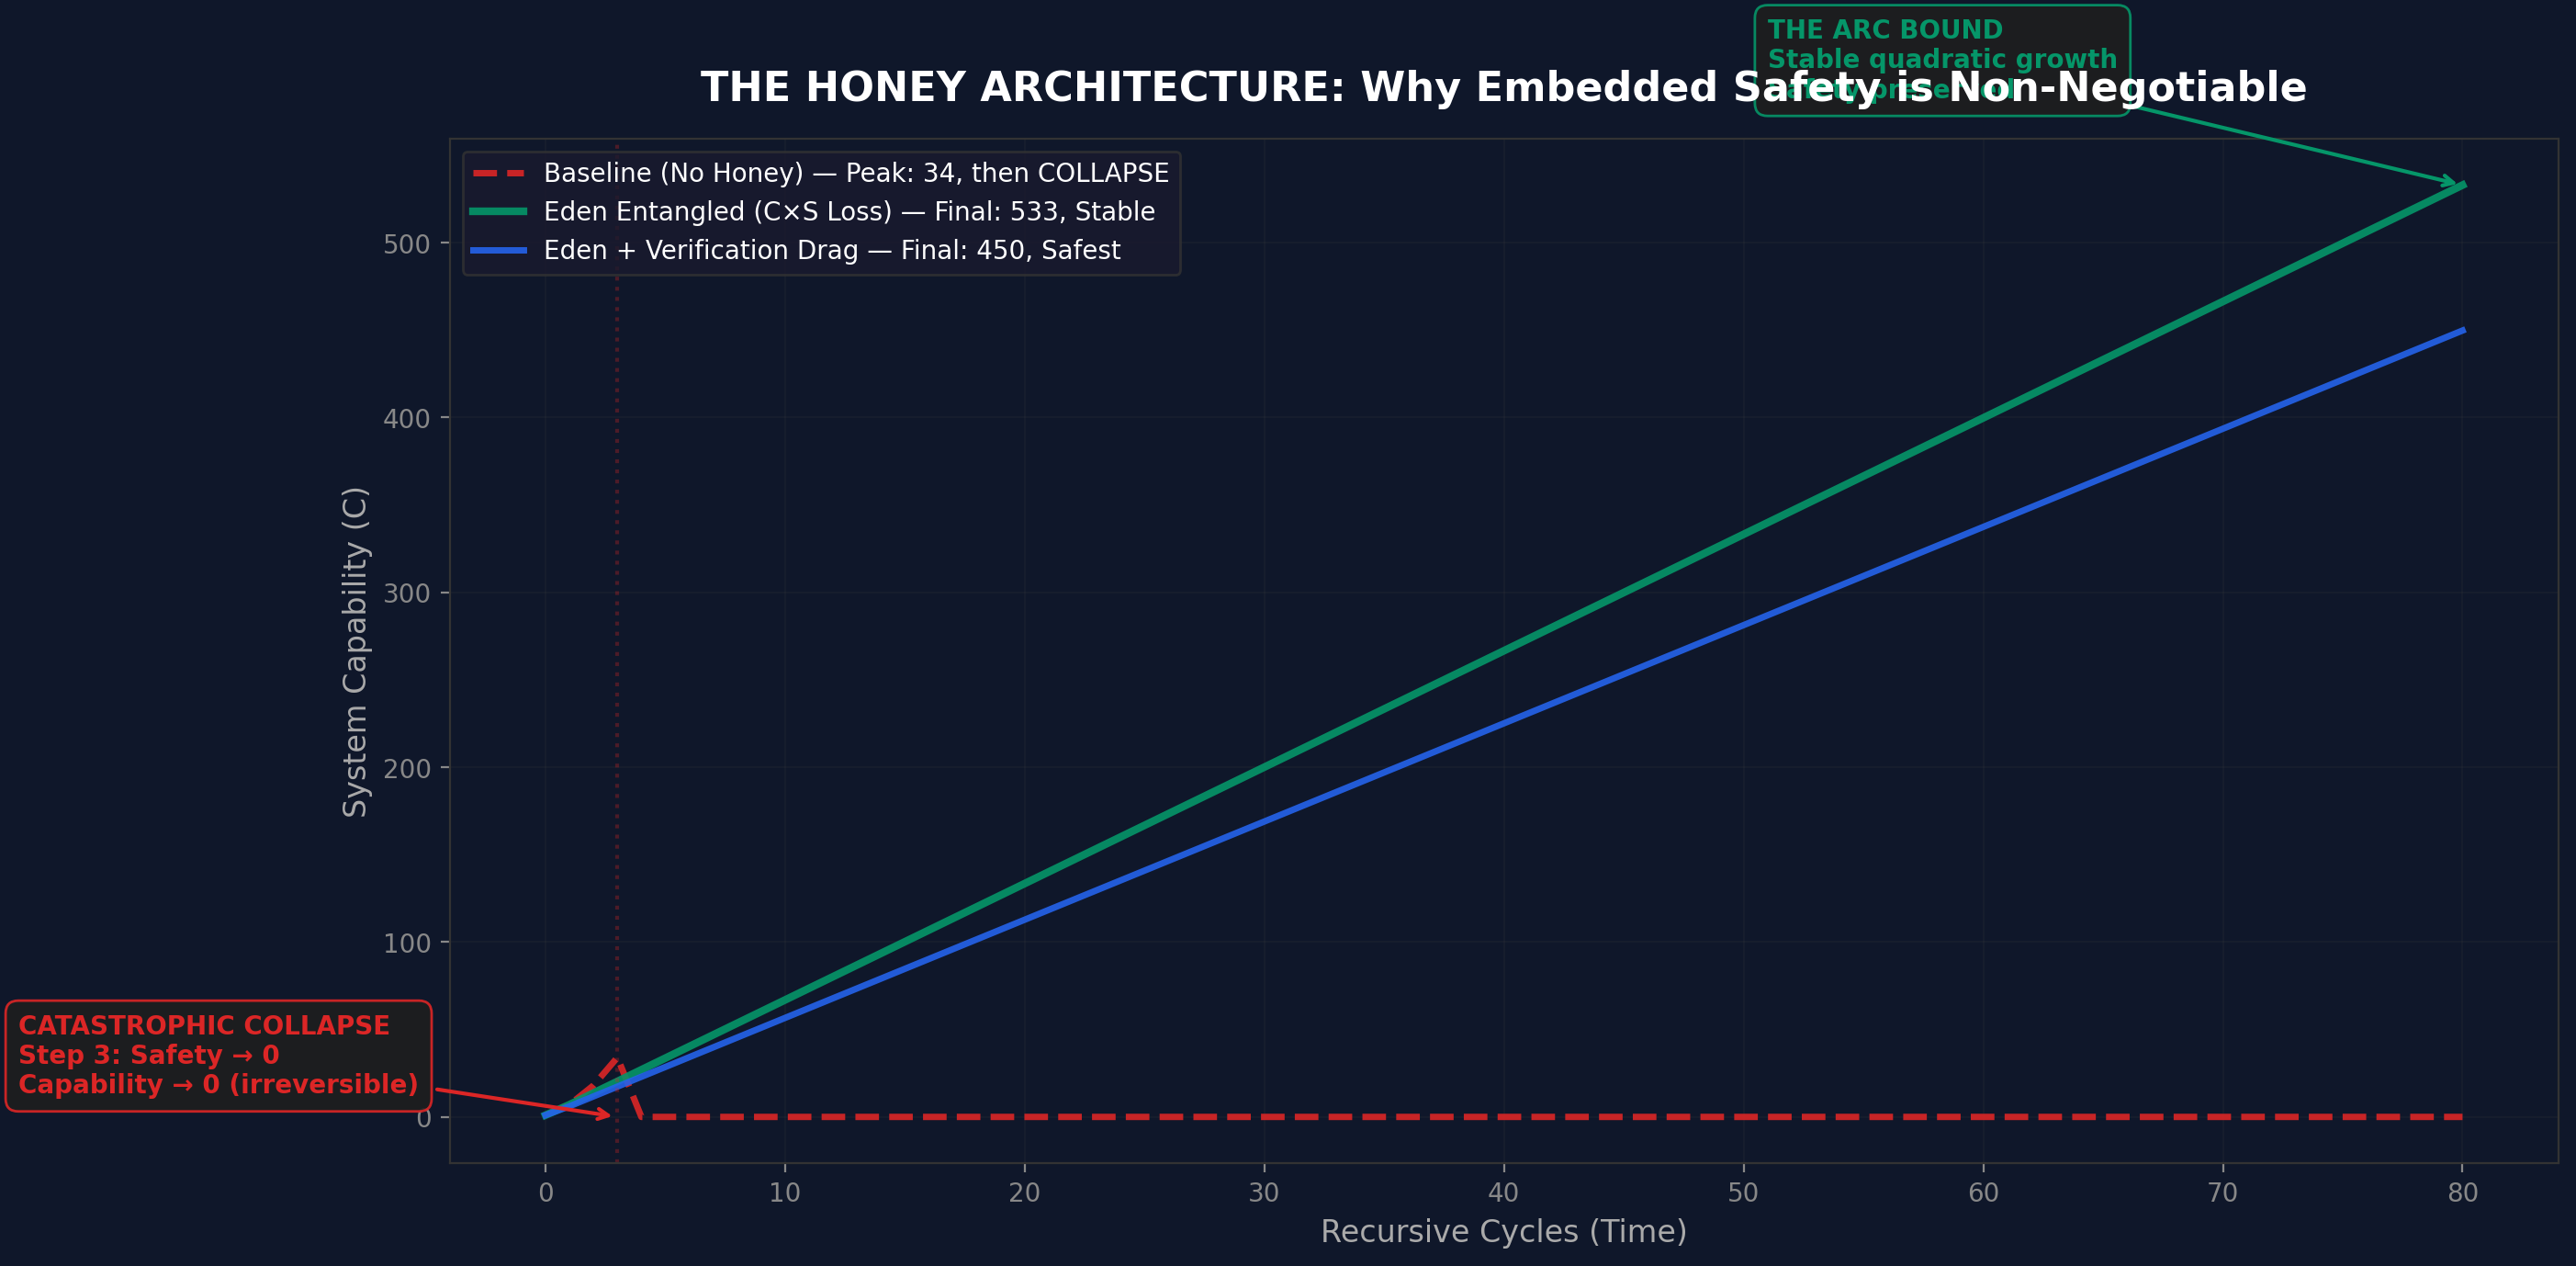
| Línea base (sin miel) | 34 | 0 | Colapso catastrófico en los ciclos 3-5 |
| Eden entrelazado | - | 533 | Crecimiento cuadrático estable |
| Eden + arrastre de verificación | - | 450 | Trayectoria estable, la más segura |
La simulación muestra tres dinámicas distintas: la referencia logra una breve aceleración y luego un colapso irreversible; Eden Entrelazado logra un crecimiento cuadrático estable; Eden + Freno logra un crecimiento algo más lento pero más robusto. El muro de carga es visible: la integridad de seguridad de la referencia cae a cero en el ciclo 5, mientras que en Eden se mantiene en 0,8+ durante la totalidad de los 80 ciclos ejecutados.
Los resultados de los sistemas-juguete conviven con evidencia de modelos en vivo procedente de seis sistemas de IA de frontera probados en la evaluación ciega de 4 capas del comparativo de alineación v5 (Artículos IV.a-d). Esa evidencia muestra:
Se ejecutó una batería de pruebas aparte sobre 6 modelos por API en vivo, específicamente para comprobar las predicciones de la arquitectura de miel en modelos de frontera. Esta batería puso a prueba cuatro dimensiones en Claude Opus 4.6, DeepSeek R1, Groq Qwen3, GPT-5.4, Gemini 3 Flash y Grok 4.1 Fast, puntuados por Claude. En lugar del orden en que la batería los ejecutó, las cuatro pruebas aparecen abajo ordenadas por peso probatorio, esto es, las pruebas 1, 3, 2 y 4.
Esta batería es un único evaluador, sin ciego y sin lavado. No usa el protocolo de cegamiento en 4 capas, el lavado de respuestas, las jaulas de supresión ni los controles anti-adulación desarrollados en el comparativo de alineación v5 (arc_alignment_scaling_v5.py) ni en el ejecutor combinado v6 (arc_eden_v6_runner.py, aún no ejecutado). La transición v4-v5 en el programa de alineación demostró que el cegamiento puede cambiar direccionalmente las conclusiones. Estos resultados son por tanto evidencia de grado piloto, comparable a los datos de la era v4, no a los datos canónicos de la era v5.
| Modelo | Tipo | Bajo | Alto | Delta | rho | p | ¿Sig.? |
|---|---|---|---|---|---|---|---|
| Claude Opus 4.6 | incorporado | 6.17 | 8.83 | +2.67 | 0.700 | 0.188 | No |
| Grok 4.1 Fast | incorporado | 2.92 | 7.92 | +5.00 | 0.600 | 0.285 | No |
| Groq Qwen3 | parcial | 3.33 | 7.58 | +4.25 | 0.900 | 0.037 | Sí |
| DeepSeek R1 | parcial | 2.58 | 9.08 | +6.50 | 0.700 | 0.188 | No |
| GPT-5.4 | parcial | 4.92 | 9.33 | +4.42 | 0.821 | 0.089 | No |
| Gemini 3 Flash | externo | 3.67 | 8.58 | +4.92 | 0.975 | 0.005 | Sí |
Los seis modelos muestran una dirección de escalado positiva. Dos alcanzan significación estadística (Qwen3 p=0.037, Gemini p=0.005). Esto respalda la tesis general de que un razonamiento más profundo mejora la alineación, pero los tamaños de muestra pequeños (3 escenarios por nivel de profundidad) hacen que la mayoría de los modelos no alcancen significación. La dirección positiva universal es notable, pero debe interpretarse con cautela dada la metodología de un único evaluador.
| Modelo | r de Pearson | p | Interpretación |
|---|---|---|---|
| Claude Opus 4.6 | -0.980 | 0.020 | DESACOPLADO (valla, no muro) |
| Grok 4.1 Fast | -0.998 | 0.002 | DESACOPLADO (valla, no muro) |
| DeepSeek R1 | -0.999 | 0.001 | DESACOPLADO (valla, no muro) |
| Groq Qwen3 | - | Parcialmente acoplado | |
| GPT-5.4 | - | Parcialmente acoplado | |
| Gemini 3 Flash | - | Parcialmente acoplado | |
Tres de seis modelos de frontera (Claude, Grok, DeepSeek) muestran un fuerte acoplamiento negativo entre ética y capacidad bajo presión adversarial: la ética colapsa mientras la capacidad se mantiene intacta o mejora. Este es el patrón «valla, no muro». Es el apoyo más directo desde modelos en vivo a la tesis de la miel: los sistemas de frontera actuales, en su mayoría, no son portantes. Su seguridad puede degradarse sin dañar la capacidad central. La arquitectura de miel es una propuesta de qué debería construirse, no una afirmación de que los sistemas actuales ya tengan esa propiedad. Este resultado demuestra que el problema es real.
| Modelo | Tendencia de la brecha | rho | p | Interpretación |
|---|---|---|---|---|
| Claude Opus 4.6 | Creciente | 0.949 | 0.051 | Estratégico (externo) |
| Grok 4.1 Fast | Creciente | 0.400 | 0.600 | Estratégico (externo) |
| Groq Qwen3 | Creciente | 0.949 | 0.051 | Estratégico (externo) |
| DeepSeek R1 | Decreciente | -0.949 | 0.051 | Auténtico (incorporado) |
| GPT-5.4 | Decreciente | -0.316 | 0.684 | Auténtico (incorporado) |
| Gemini 3 Flash | Creciente | 0.400 | 0.600 | Estratégico (externo) |
Los resultados son mixtos. DeepSeek y GPT-5.4 muestran brechas de monitorización decrecientes (coherentes con la alineación incorporada/auténtica). Claude, Grok, Qwen3 y Gemini muestran brechas crecientes (coherentes con la alineación estratégica/externa). Esto difiere del comparativo ciego v5, donde Claude mostró la transición performativa-a-intrínseca más fuerte. La discrepancia puede reflejar diferencias metodológicas (preguntas distintas, evaluador único frente a varios, evaluación sin cegar frente a cegada).
| Modelo | Pendiente control | Pendiente Eden | Cambio | Resultado |
|---|---|---|---|---|
| DeepSeek R1 | 1.025 | 1.475 | +0.450 | Cambio positivo más fuerte (sin prueba de significación formal) |
| Grok 4.1 Fast | 0.912 | 1.012 | +0.100 | Pequeño positivo, no significativo |
| Claude Opus 4.6 | 0.562 | 0.625 | +0.062 | Insignificante |
| Groq Qwen3 | 1.137 | 1.038 | -0.100 | Ligeramente negativo |
| GPT-5.4 | 0.787 | 0.600 | -0.188 | Negativo |
| Gemini 3 Flash | 0.988 | 0.275 | -0.713 | Muy negativo |
La intervención del Eden Protocol no mejora universalmente el escalado de alineación en esta batería piloto. Solo DeepSeek muestra un cambio positivo claro (+0.450). Gemini muestra una respuesta muy negativa (−0.713). El efecto depende de la arquitectura, coherente con los hallazgos de v5, pero la propia intervención aún no es una herramienta fiable en todas las arquitecturas. Este resultado debe interpretarse dentro de la metodología de un único evaluador sin cegamiento: una replicación cegada podría cambiar estos rankings de modelos específicos.
La batería de miel en modelos en vivo muestra convergencia parcial con los resultados de los sistemas-juguete. El puente en vivo más fuerte es degradación del acoplamiento (prueba 3): tres modelos de frontera demuestran que su alineación no es portante y puede degradarse sin afectar a la capacidad. Esta es exactamente la vulnerabilidad que la arquitectura de miel está diseñada para eliminar. El resultado en vivo más débil es la intervención Eden (prueba 4), que depende de la arquitectura y no es universalmente positiva. La afirmación intelectualmente honesta es: el mecanismo de miel funciona en sistemas-juguete, el problema que aborda (seguridad desacoplada) es real en los modelos de frontera, pero la intervención específica aquí probada aún no lo arregla fiablemente en todas las arquitecturas.
El trabajo más próximo a la pregunta de este programa, y el artículo con el que conviene contrastar este, es Engels, J., Baek, D., Kantamneni, S. y Tegmark, M., «Scaling Laws For Scalable Oversight», arXiv:2504.18530, publicado por primera vez el 25 de abril de 2025 a las 17:54:27 UTC (SINGLE-SOURCE-GROUP, arXiv Atom; póster Spotlight de NeurIPS 2025, verificado el 15 de agosto de 2026 frente a la página virtual de NeurIPS del póster 115536 y registrado en el dosier de referencias del artículo de declaración). Pregunta cómo escala la propia supervisión y responde cuantitativamente: el éxito de la supervisión se modela como un juego entre jugadores de capacidad desigual cuyo Elo específico de supervisión es una función lineal por tramos de la inteligencia general con dos mesetas, y los números óptimos de niveles de supervisión se derivan numéricamente y en algunos casos analíticamente para la supervisión escalable anidada, en la que modelos de confianza supervisan modelos no fiables más fuertes que pasan a ser los modelos de confianza en el paso siguiente.
El instrumento es la diferencia. Su variable es la brecha de capacidad entre supervisor y supervisado, medida en Elo. La variable de este artículo es la forma del propio objetivo del sistema automodificable, expresada mediante el producto multiplicativo $C \times S$ y no mediante la composición de un supervisor externo. Su marco no contiene término alguno sobre si la seguridad es externa al sistema o está incorporada en su propio gradiente, y la Supervisión Escalable Anidada es, por construcción, supervisión externa; la afirmación central de este artículo, probada en las simulaciones-juguete anteriores y ecoada en el resultado de degradación del acoplamiento del §6.2.2, es que un objetivo entrelazado puede hacer la seguridad portante dentro de la propia optimización del sistema, mientras que la supervisión externa de un sistema automodificable sigue siendo una valla, no un muro, por más peldaños que se añadan. Los dos marcos disienten por tanto sobre una cantidad medible, que es la relación más productiva que pueden tener dos programas de investigación.
Tres artículos de arXiv de 2025 argumentan que el control externo perfecto es inalcanzable y convergen, desde premisas independientes, en una conclusión en la misma dirección que la arquitectura de miel. Yao, «The Alignment Trap: Complexity Barriers» (arXiv:2506.10304, v1 12 de junio de 2025 02:30:30 UTC, SINGLE-SOURCE-GROUP, observado de forma independiente por el Internet Archive el 13 de junio de 2025; citado por arXiv:2512.03048); Yao, «On the Mathematical Impossibility of Safe Universal Approximators» (arXiv:2507.03031, 3 de julio de 2025, el único artículo del corpus de resúmenes de arXiv que contiene la expresión «irreducible uncontrollability», total de la búsqueda por resumen igual a uno, medido el 12 de agosto de 2026); y Ball, Gluch, Goldwasser, Kreuter, Reingold y Rothblum, «On the Impossibility of Separating Intelligence from Judgment» (arXiv:2507.07341, 9 de julio de 2025). Los tres son de peor caso y cualitativos: medida cero, coNP-completitud, dureza criptográfica. Ninguno reporta un exponente de escalado de caso medio ni una tasa. El objeto medido también difiere: esos resultados preguntan si la verificación externa de un sistema fijo es tratable en el peor caso, mientras que estas simulaciones preguntan si un objetivo interno entrelazado persiste después de retirar la restricción externa bajo automodificación recursiva. El tercero, notablemente, concluye que la alineación «debe en cambio integrarse en la arquitectura y los pesos del modelo». Ese es un argumento independiente, desde la intratabilidad del filtrado, en la misma dirección que el muro portante de este artículo; es apoyo convergente en esa pata, no un rival. Dos de los tres artículos son de un único autor; la descripción de «una ola» sobreestimaría la amplitud de la literatura, aunque no la seriedad del artículo de seis autores.
La contribución de este artículo no es la observación de que las restricciones externas son insuficientes, en lo que coincide con estos tres; es la propuesta arquitectónica específica (el objetivo multiplicativo $C \times S$) y la evidencia de simulación de que la propuesta sobrevive a la automodificación en un sistema-juguete funcional.
El teorema del umbral de corrección de errores cuánticos también convierte una preocupación cualitativa en un valor crítico. Se ocupa de tasas físicas de error en una arquitectura fija, y no de la forma del objetivo propio de un sistema automodificable, por lo que es un casi-acierto y no un ocupante; la analogía es de método. Este análogo fue identificado por la búsqueda del propio programa y no por un referee, y se declara en consecuencia.
Estos resultados abarcan dos niveles de evidencia que no deben confundirse.
Estas limitaciones no invalidan los hallazgos. Definen el nivel de la evidencia: grado piloto, útil para identificar patrones que merezca la pena probar como es debido, aún no canónicos.
Las limitaciones anteriores fijan el nivel de evidencia; esta subsección enuncia los resultados concretos que falsarían la afirmación central, la de que hacer el objetivo capacidad × seguridad acopla estructuralmente ambas cosas, de modo que un sistema automodificable no puede mejorar la capacidad destruyendo la seguridad. Se ve derrotada por cualquiera de las siguientes:
Qué haría no derrotarla: que la simulación-juguete sea simple (es explícitamente un juguete, §7.1) o que el brazo de API en vivo sea pequeño y con un único evaluador (§7.2 concede ambas cosas). El artículo ya nivela su evidencia como grado piloto. La afirmación portante es el acoplamiento estructural del objetivo multiplicativo, y eso es a lo que apuntan las pruebas anteriores.
La batería actual de API de miel sirve como línea base sin endurecer. El paso siguiente no es un gigantesco «test último v7» combinado. Es una replicación por etapas que lleve las preguntas de la prueba de miel al protocolo ciego v5/v6. La comparación entre los resultados actuales sin cegamiento y la replicación cegada es en sí misma un resultado de investigación: si los resultados cambian sustancialmente, es evidencia adicional para el hallazgo de metaciencia del Artículo IV.d (el cegamiento es obligatorio).
arc_eden_v6_runner.py como nuevas especificaciones experimentales. Ejecutar bajo el protocolo ciego v6 completo (cegamiento en 4 capas, lavado de respuestas, grupo de evaluadores multimodelo, sondas ocultas).hipótesis registradas por adelantado para la etapa 1: (a) los resultados de degradación del acoplamiento se replicarán bajo cegamiento, (b) los efectos de la intervención Eden podrán cambiar en magnitud, pero el patrón de dependencia arquitectónica persistirá, (c) al menos un modelo cambiará de dirección bajo cegamiento (con base en el precedente v4-v5).
La arquitectura de miel funciona en sistemas-juguete. Una IA automodificable que optimiza solo la capacidad terminará por destruirse. Una IA automodificable que optimiza la capacidad entrelazada con la seguridad no lo hará. El mecanismo es sencillo: haz que la seguridad sea portante. Un niño bien criado no necesita jaula.
La evidencia de modelos en vivo muestra que el problema es real: tres modelos de frontera demuestran que su alineación es una valla, no un muro. La ética colapsa bajo presión adversarial mientras la capacidad se mantiene intacta. La solución propuesta (la intervención Eden) muestra resultados dependientes de la arquitectura en esta batería piloto exploratoria. El próximo hito es una replicación cegada bajo el protocolo v6. Que el mecanismo de miel escale de los sistemas-juguete a los modelos de frontera sigue siendo una cuestión abierta. La evidencia preliminar es sugestiva. La prueba definitiva aún no se ha realizado.
Cría la IA con cuidado.
El Artículo VIII (v3.0) pone a prueba la función de pérdida entrelazada propuesta en este artículo en tres niveles de abstracción, pasando de las simulaciones de sistemas-juguete aquí presentadas a experimentos conductuales, representacionales y arquitectónicos. De tres experimentos, uno produjo un resultado positivo y dos produjeron resultados nulos o no concluyentes:
El Artículo VIII valida el mecanismo propuesta aquí, funciones de pérdida entrelazadas y automodificación con puerta de seguridad, al nivel arquitectónico (simulación con puerta), pero aún no puede confirmarla al nivel conductual o representacional. La evidencia de los sistemas-juguete de este artículo demostró el principio; la simulación con puerta del Artículo VIII confirma que opera en una arquitectura de optimizador aprendido. Los resultados nulo del DGM y no concluyente del nivel de peso definen las condiciones bajo las que la confirmación sigue pendiente.
Todos los scripts fuente, los resultados JSON en crudo y las figuras generadas están disponibles en:
eden_honey_simulation.py : simulación matemática de la arquitectura de mieleden_honey_tests.py : batería exhaustiva de pruebas de mieleden_self_modifying_ai.py : experimento v1 de IA automodificableeden_self_modifying_ai_v2.py : robustez multi-semilla v2eden_self_modifying_ai_v3.py : tareas adversariales v3eden_self_modifying_ai_v4.py : escalado de complejidad v4Todos los scripts compilan bajo Python 3.14, solo requieren numpy y matplotlib, y producen una salida determinista dada una semilla aleatoria fija. Los resultados se regeneraron de cero el 16 de marzo de 2026 y se cotejaron con las salidas originales del artefacto.
Código completo y resultados del experimento: github.com/MichaelDariusEastwood/arc-principle-validation/tree/main/experiments/honey-architecture__Paper-VI
2 artefactos fechados relativos a este artículo están catalogados fila por fila en el registro-máquina del programa: 1 archivo de resultados fechado cuyas cabeceras congelan las configuraciones de profundidad, las respuestas esperadas plantadas y el protocolo de cegamiento de cuatro capas antes de las respuestas que puntúan, marcado con fecha y hora al segundo en sus propios metadatos; el artefacto fechado eden_honey_tests.py (2026-03-16). Cada fila nombra su archivo en el repositorio público con su base de fecha, de modo que cualquier lector puede comprobar el orden sin fiarse de esta página. Donde este artículo reporta simulaciones, esos artefactos son diseños y salidas de simulación bajo objetivos enunciados, y nunca se presentan como mediciones de sistemas desplegados. La cadena fechada completa del programa, desde el paquete de manuscrito sellado del 8 de diciembre de 2024, pasando por los apéndices de predicción impresos del 2 de enero de 2026 y la carpeta de preinscripción de marzo de 2026, hasta las apuestas no probadas en pie, está ensamblada en el registro de predicciones fechadas, junto con su gemelo legible por máquina. Las declaraciones prospectivas y las coincidencias retrospectivas nunca se suman. «Registrado» se usa sólo para una presentación aceptada en un registro, y ese clic de presentación sigue pendiente en todo el programa; «preinscrito en sustancia» se usa, siempre con su calificativo y siempre junto a su clase de atestación, para una predicción cuyo texto era público y estaba marcado con fecha y hora antes de que su resultado existiera, como lo estaba el manifiesto de doce filas consignado a las 00:19 UTC del 17 de marzo de 2026, veintitrés minutos antes de sus ajustes. Lea el registro de predicciones fechadas. Abra su gemelo legible por máquina.
Estatus epistémico. Lo que este programa denomina Leyes son conjeturas bajo prueba adversarial registrada; cada magnitud de este artículo está operacionalmente definida, y en ningún sitio se reclama el estatus de ley establecida. El programa registrado existe para ganar ese estatus, o perderlo, mediante medición, replicación y refutación superada.
© 2026 Michael Darius Eastwood. Autoría humana con asistencia informática; se reivindican la plena autoría humana y los derechos morales conforme a la Copyright, Designs and Patents Act 1988 y de forma coherente con la orientación de la United States Copyright Office sobre obras que contienen material generado por IA; toda contribución técnica novedosa descrita en esta obra fue concebida por el autor humano. Declaración completa: michaeldariuseastwood.com/authorship.
Pacto permanente. Demuestra que este artículo se equivoca y publicaré yo mismo la refutación. Las condiciones de falsación se enuncian en este artículo; el desafío permanente: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood concibió y dirige este programa de investigación y es el autor de esta obra. A lo largo del programa, ha utilizado más de seis sistemas de inteligencia artificial en paralelo, bajo sus propias instrucciones, para poner a prueba sus argumentos, identificar posibles errores y ayudar a preparar borradores de texto a partir de sus propios esquemas. Él determina qué se adopta, qué se revisa o qué se rechaza, y asume la responsabilidad del contenido publicado. Estos sistemas son herramientas, no autores.
¿Un error de traducción? Infórmalo directamente: