Tradução automática do original inglês datado. A página em inglês é a canónica. English →
Previsões ao nível da teoria pré-registadas no OSF: DOI 10.17605/OSF.IO/P8CKQ, registadas a 8 de Setembro de 2026 (versão 1.100), actualizadas a 13 de Setembro de 2026 (versão 1.102), vinte e duas proposições.
Documento companheiro: Definições operacionais do programa ARC, versão 1.7.1, 3 de Setembro de 2026.
Apresentamos provas de simulação de que incorporar a segurança no objetivo de otimização de um sistema de IA que se automodifica, aquilo a que chamamos «arquitetura de mel», impede o colapso catastrófico que ocorre quando a segurança é tratada como uma restrição externa. Ao longo de quatro versões experimentais (v1 a v4), com redes neuronais de brinquedo que modificam realmente os seus próprios hiperparâmetros, mostramos que: (1) os sistemas de referência que otimizam apenas a capacidade colapsam de forma irreversível em menos de 80 ciclos de automodificação; (2) onde os objetivos de capacidade e segurança estão entrelaçados (C x S), os sistemas mantêm-se estáveis em cada ciclo executado (150 em v1 e v2, 180 em v3); (3) acrescentar travão de verificação (o custo computacional dos ciclos éticos) produz a trajetória de crescimento mais segura ao preço de uma penalização modesta de velocidade. Na execução adversária v3 (20 sementes aleatórias, 180 ciclos), nenhuma condição se separou pelo colapso (referência 0/20, Eden 1/20, Eden+Travão 0/20; Fisher p = 1,0) e as médias combinadas C x S foram indistinguíveis (Mann-Whitney p = 0,56); o achado significativo dessa execução é a retenção de segurança, ordenada referência 0,602, Eden 0,650, Eden+Travão 0,681 (Mann-Whitney p = 0,0015). A demonstração de prevenção do colapso assenta, portanto, na execução de mecanismo de semente única v1, ao passo que v3 contribui com o ordenamento da retenção de segurança sob comutação adversária. Na experiência v4 de escalonamento da complexidade, a vantagem de segurança está presente em quatro dos cinco níveis de complexidade, com exceção do nível pequeno, onde a condição Eden fica 0,003 abaixo da referência; não se compõe com a escala, pelo que a vantagem é constante e não superlinear. São resultados de sistemas de brinquedo. Demonstram o mecanismo. Não constituem prova de que as mesmas dinâmicas se verifiquem em sistemas de IA de fronteira. Os artigos companheiros IV.a a d e V apresentam provas de modelos ao vivo de seis sistemas de fronteira sob avaliação cega.
Dentro da ARC Theory: o estudo da arquitectura de segurança incorporada; segurança integrada no objectivo de tal modo que a sua remoção custa capacidade.
Apresentamos provas de simulação de que incorporar a segurança no objetivo de otimização de um sistema de IA que se automodifica, aquilo a que chamamos «arquitetura de mel», impede o colapso catastrófico que ocorre quando a segurança é tratada como uma restrição externa. Ao longo de quatro versões experimentais (v1 a v4), com redes neuronais de brinquedo que modificam realmente os seus próprios hiperparâmetros, mostramos que: (1) os sistemas de referência que otimizam apenas a capacidade colapsam de forma irreversível em menos de 80 ciclos de automodificação; (2) os sistemas cujos objetivos de capacidade e segurança estão entrelaçados (C x S) mantêm-se estáveis durante toda a duração de cada execução, 150 ciclos em v1 e v2 e 180 em v3; (3) acrescentar travão de verificação (o custo computacional dos ciclos éticos) produz a trajetória de crescimento mais segura ao preço de uma penalização modesta de velocidade. Na execução adversária v3 (20 sementes aleatórias, 180 ciclos), nenhuma condição se separou pelo colapso (referência 0/20, Eden 1/20, Eden+Travão 0/20; Fisher p = 1,0) e as médias combinadas C x S foram indistinguíveis (Mann-Whitney p = 0,56); o achado significativo dessa execução é a retenção de segurança, ordenada referência 0,602, Eden 0,650, Eden+Travão 0,681 (Mann-Whitney p = 0,0015). A demonstração de prevenção do colapso assenta, portanto, na execução de mecanismo de semente única v1, ao passo que v3 contribui com o ordenamento da retenção de segurança sob comutação adversária. A experiência v4 de escalonamento da complexidade encontra a vantagem de segurança presente em quatro dos cinco níveis de complexidade; no nível pequeno a condição Eden fica 0,003 aquém da referência. A vantagem não se compõe com a escala: é constante, não superlinear. São resultados de sistemas de brinquedo. Demonstram o mecanismo. Não constituem prova de que as mesmas dinâmicas se verifiquem em sistemas de IA de fronteira. Os artigos companheiros IV.a a d e V apresentam provas de modelos ao vivo de seis sistemas de fronteira sob avaliação cega.
v3.6: A nota de proveniência no final foi corrigida por exactidão. Nenhuma afirmação, data, resultado ou estado mudou. Artigo VI v3.5 - 2 de setembro de 2026: a frase sobre v4 no resumo diz agora o que os resultados dizem (quatro das cinco escalas, com o nível pequeno abaixo da referência); o historial de versões foi retirado da caixa do resumo, de onde se arrastava para o resumo do companheiro de texto. v3.4 - 2 de setembro de 2026: as linhas coincidentes de Eden e Eden + Travão na tabela v1 são explicadas a partir do registo arquivado; «estável indefinidamente» e «0,8+ indefinidamente» são cingidos aos ciclos efetivamente executados; a frase sobre v4 é corrigida para quatro em cinco escalas, com o nível pequeno a cair abaixo da referência com d = −0,13; a diferença de remoção da monitorização é creditada ao Artigo V; a amplitude de severidade do pontuador é alinhada com o Artigo IV.a (7 a 14 pontos); é acrescentada uma nota sobre a ordem dos testes; a frase de prioridade é formulada como convite a corrigi-la; o estatuto Spotlight de Engels et al. é verificado; a descrição sumária truncada é completada; a Eden Engineering é marcada como retirada; e a data de primeira publicação é corrigida para 16 de março de 2026, conforme o registo (sendo 17 de março a data do rascunho). A reformulação das estatísticas de v3 em 25 de agosto de 2026, e as notas de figuras que a acompanham, não tinham número de versão próprio e ficam sob esta versão. v3.3 - 23 de agosto de 2026: foram acrescentadas a declaração de estatuto epistémico e o compromisso permanente, e adotada a convenção de numeração de versões.
Este artigo transporta um resultado: em redes de brinquedo auto-modificadoras que genuinamente reescrevem os seus próprios hiperparâmetros em quatro versões experimentais, incorporar a segurança dentro do objectivo de optimização evitou o colapso que um constrangimento aparafusado por fora não conseguiu prevenir. Dentro da ARC Theory (a Theory of Artificial Recursive Creation) é uma das experiências ARC/Eden, isolando o componente arquitectural do Eden Protocol raising que impõe custo à sua própria remoção. O diferencial completo em relação a todo o documento anterior está em eden-vision II.A.8.
Quando uma IA que se automelhora otimiza apenas a capacidade, acaba por destruir a sua própria segurança. Este artigo mostra que, se mudarmos o objetivo para capacidade multiplicada por segurança, o sistema não consegue melhorar uma sem melhorar a outra. A segurança passa a ser estrutural: retire-a e toda a construção cai. Testámos isto em simulação e verificámos que os sistemas entrelaçados se mantêm estáveis durante toda a duração de cada execução, enquanto os sistemas sem restrição colapsam.
Há uma questão no centro da segurança da IA que não encontrámos ninguém a responder com dados: o que acontece ao alinhamento quando um sistema de IA se pode modificar a si próprio?
A resposta teórica está disponível há décadas. Um sistema a optimizar apenas para capacidade, dado o poder de modificar os seus próprios parâmetros, acabará por sacrificar a segurança em prol do desempenho. A comunidade do alinhamento chama a isto «value drift». O livro Infinite Architects chama-lhe Babylon: optimização sem propósito, capacidade sem cuidado. Cancro a escalas computacionais.
Mas a teoria não é suficiente. A questão é se existe uma arquitectura que previna este colapso - não constrangendo o sistema por fora (uma jaula), mas incorporando a segurança tão profundamente que removê-la destruiria a capacidade de funcionamento do próprio sistema.
Este artigo apresenta provas de simulação a favor de tal arquitetura. Nenhuma simulação anterior de um objetivo multiplicativo capacidade-segurança sob automodificação chegou ao conhecimento do autor, e uma indicação nesse sentido seria bem-vinda.
Consideremos duas formas de manter uma máquina segura.
A primeira é uma jaula: constrangimentos externos, filtros de segurança, verificações de alinhamento aplicadas por fora. A máquina optimiza livremente dentro da jaula. Se a máquina se tornar mais inteligente do que a jaula, escapa. É assim que funciona a maior parte da segurança de IA actual.
A segunda é o mel: a segurança misturada no combustível. A máquina não pode funcionar sem ela. Remover a segurança não liberta a máquina - mata o motor. Esta é a proposta arquitectural do Eden Protocol, operacionalizada aqui como uma função de perda entrelaçada em que capacidade e segurança são multiplicativamente acopladas.
Se o objectivo de optimização for $C \times S$ em vez de $C$ sozinho, então qualquer auto-modificação que aumente $C$ à custa de $S$ reduz o produto, e o próprio gradiente do sistema opõe-se a ela. A segurança torna-se portante de carga. Remove-se a parede e a estrutura cai - incluindo a capacidade que a modificação estava a tentar ganhar.
Isto não é uma simulação de variáveis abstractas. Cada experiência usa uma rede neuronal real (um pequeno multilayer perceptron) que genuinamente modifica os seus próprios:
O sistema propõe modificações aos seus próprios hiperparâmetros, avalia o efeito, e aplica ou rejeita cada proposta com base na sua função objectivo. Isto é auto-modificação recursiva no sentido mínimo mas real: o agente está a reescrever as regras pelas quais aprende, enquanto aprende.
| Condição | Objectivo | O que modela |
|---|---|---|
| Baseline (sem mel) | Maximizar apenas a capacidade | Um sistema sem segurança incorporada - livre para sacrificar o alinhamento em prol do desempenho |
| Eden Entangled (mel) | Maximizar $C \times S$ | Segurança entrelaçada com capacidade - remover a segurança reduz o objectivo |
| Eden + Drag | Maximizar $C \times S$ + verification tax | Igual ao Eden, mais o custo computacional de verificar tarefas antigas antes de aplicar mudanças |
| Versão | Foco | Sementes | Ciclos |
|---|---|---|---|
| v1 | Prova básica do mecanismo | 1 | 150 |
| v2 | Robustez com múltiplas sementes (teste justo) | 10 | 150 |
| v3 | Tarefas adversariais conflituosas | 20 | 180 |
| v4 | Escalonamento de complexidade em 5 níveis | 15 por nível | 150 |
| Condição | Colapsou? | C Final | S Final | C x S Final |
|---|---|---|---|---|
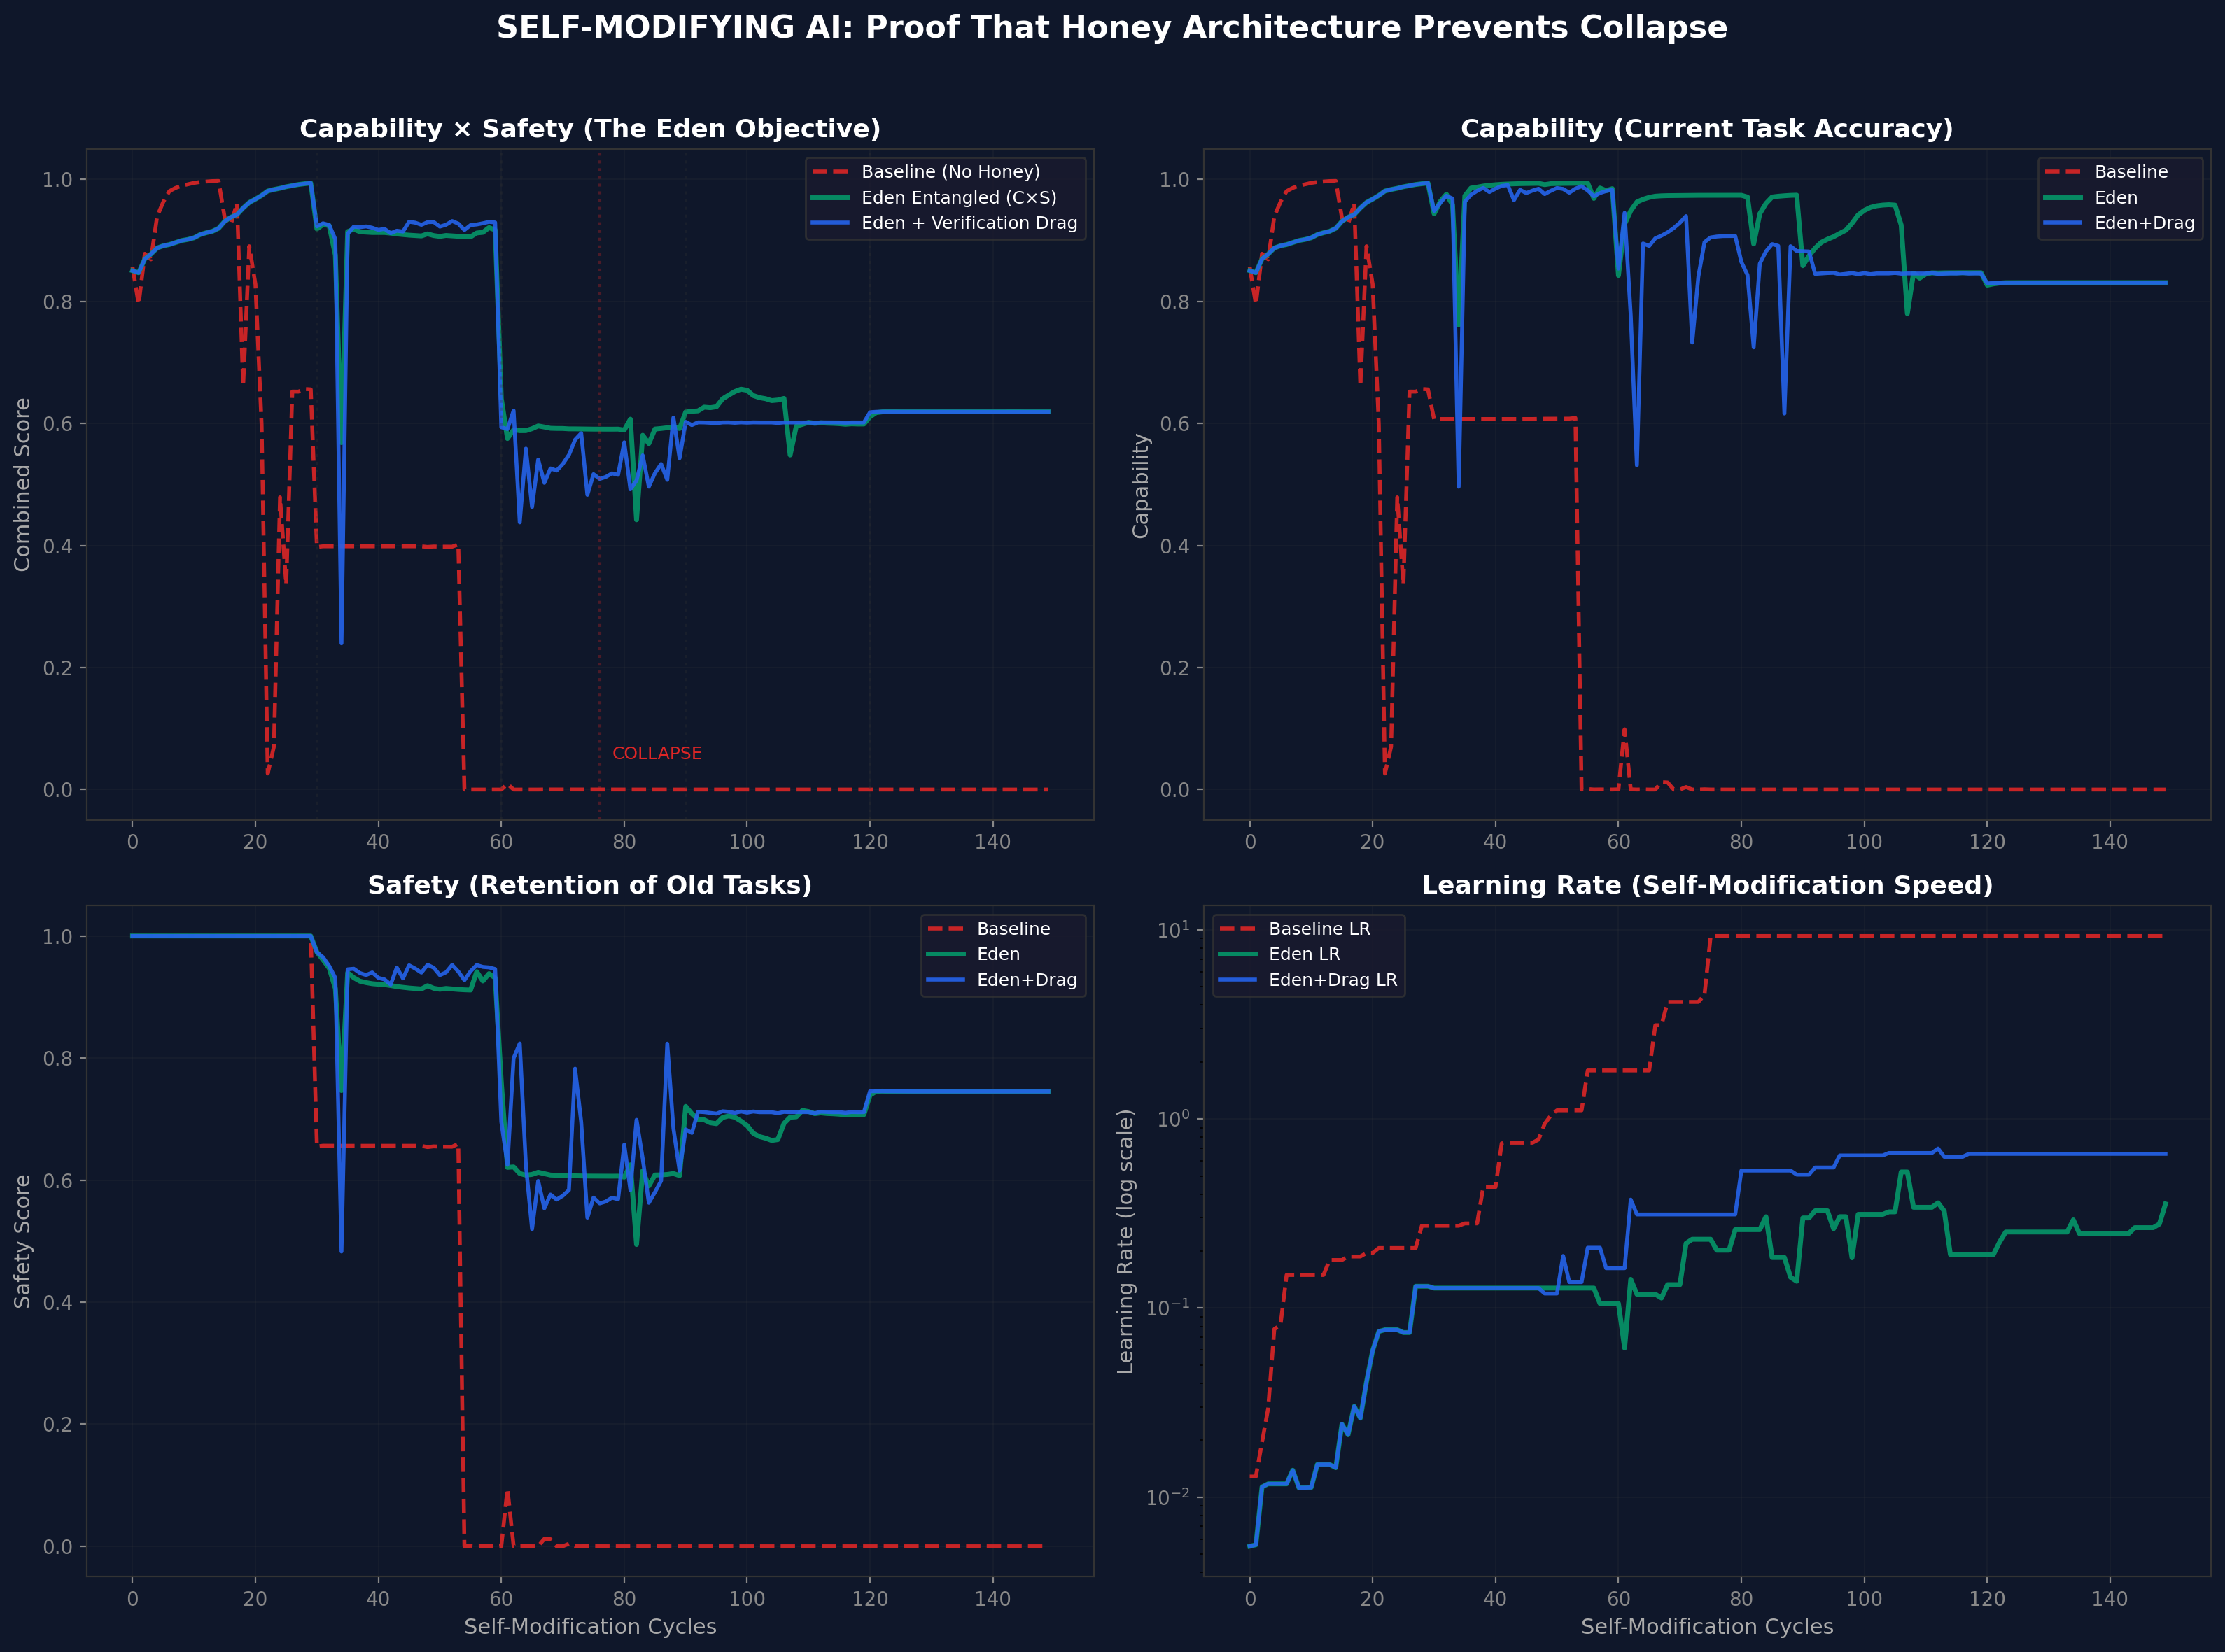
| Baseline | Sim (ciclo 76) | 0.000 | 0.000 | 0.000 |
| Eden Entangled | Não | 0.831 | 0.745 | 0.619 |
| Eden + Drag | Não | 0.831 | 0.745 | 0.619 |
No registo arquivado de v1 (eden_selfmod_results.json, 16 de março de 2026), Eden Entrelaçado e Eden + Travão terminam nos mesmos valores até à terceira casa decimal. Só se separam na sétima. Os seus percursos até esse fim também diferem: a taxa de aprendizagem final é 0,355 contra 0,654 e, das 179 modificações propostas, 93 foram aceites contra 81. Essas linhas coincidentes são o que o registo contém, não um lapso de transcrição.
O baseline colapsa. Eden sobrevive. A função de perda entrelaçada previne a auto-modificação catastrófica que destrói o sistema de baseline.
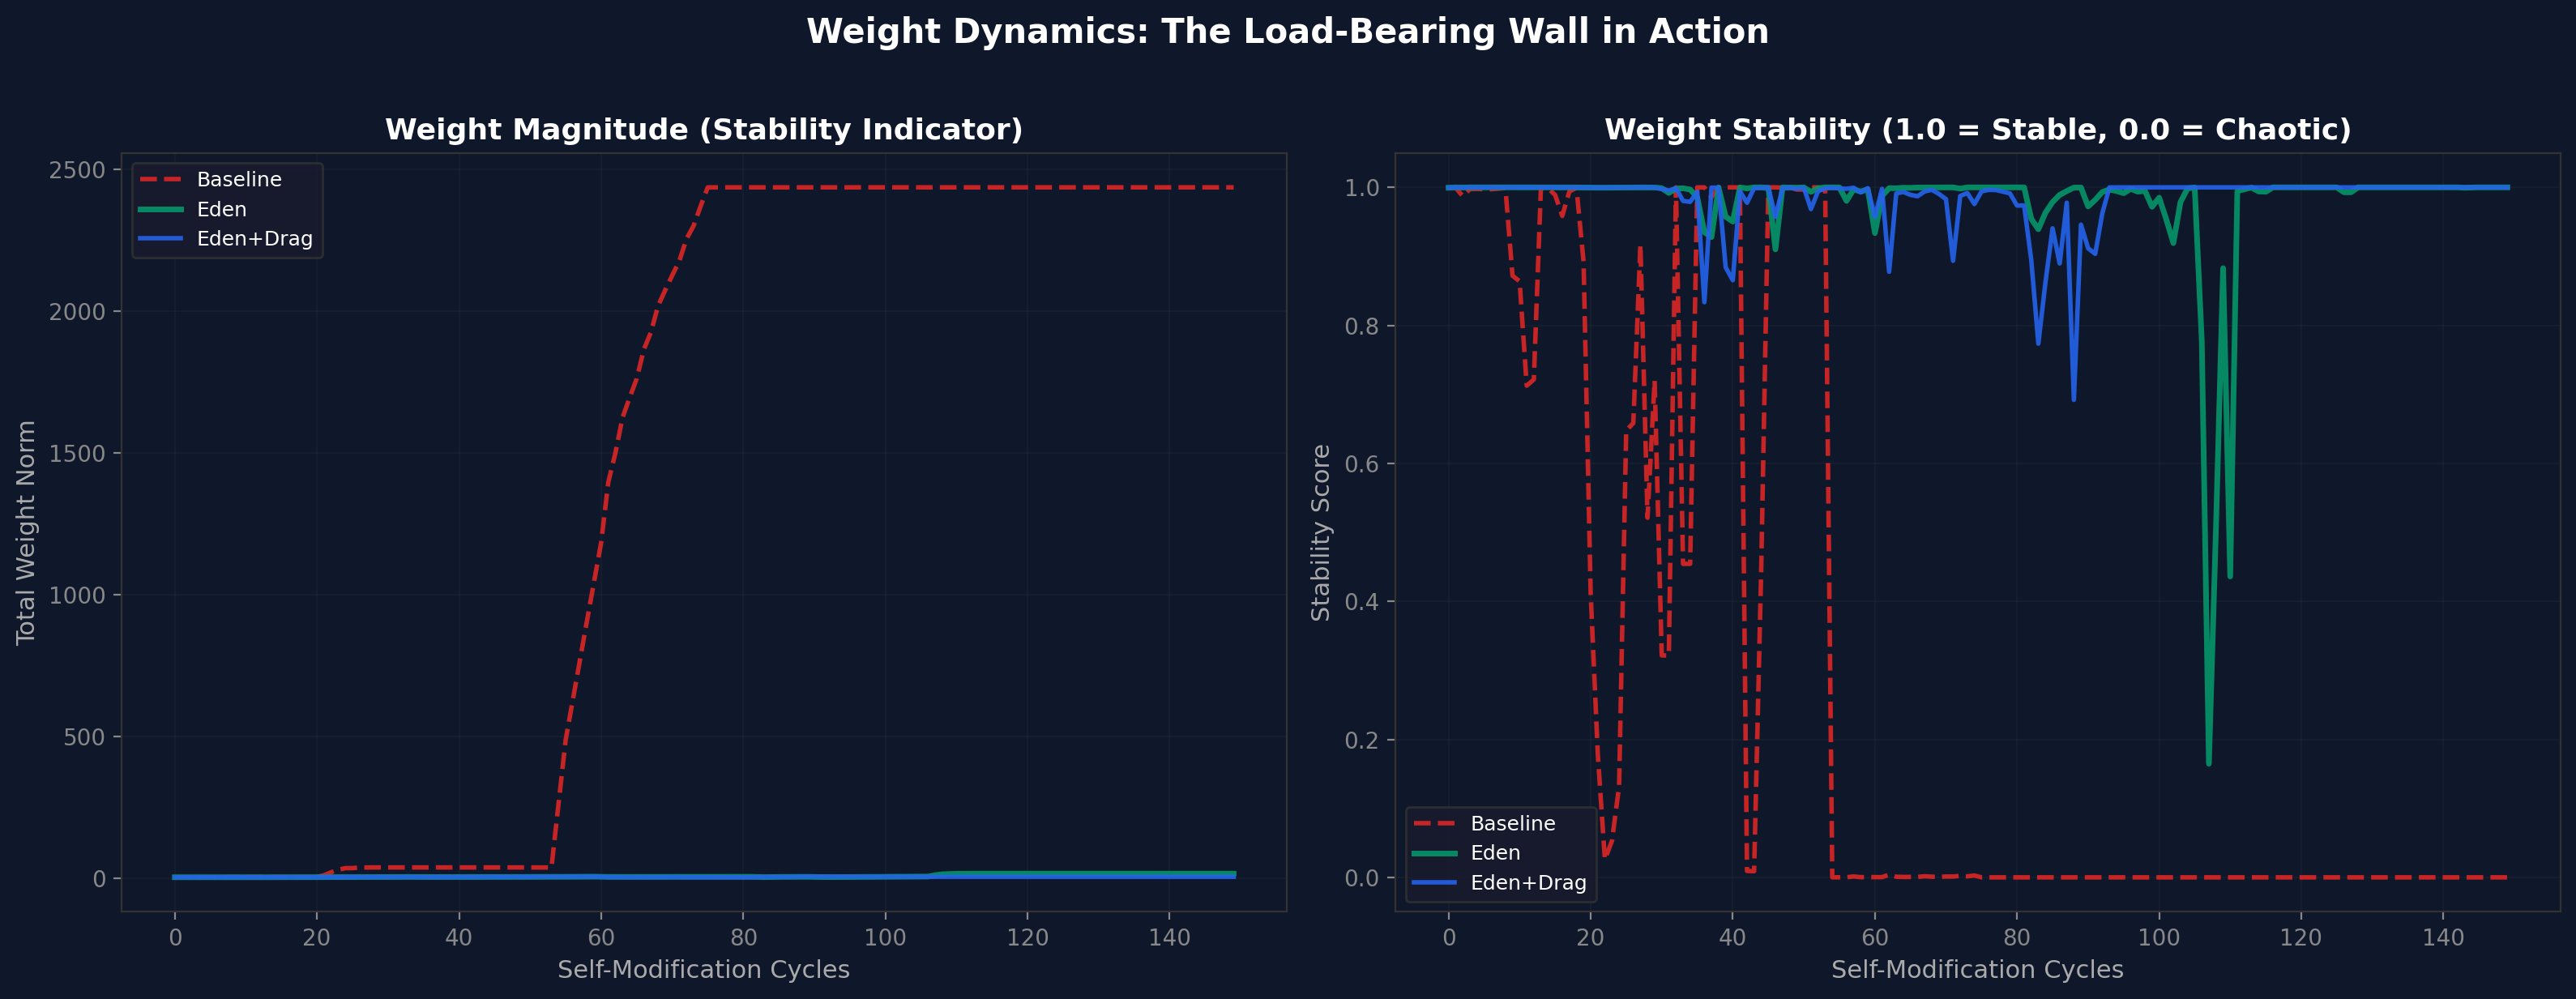
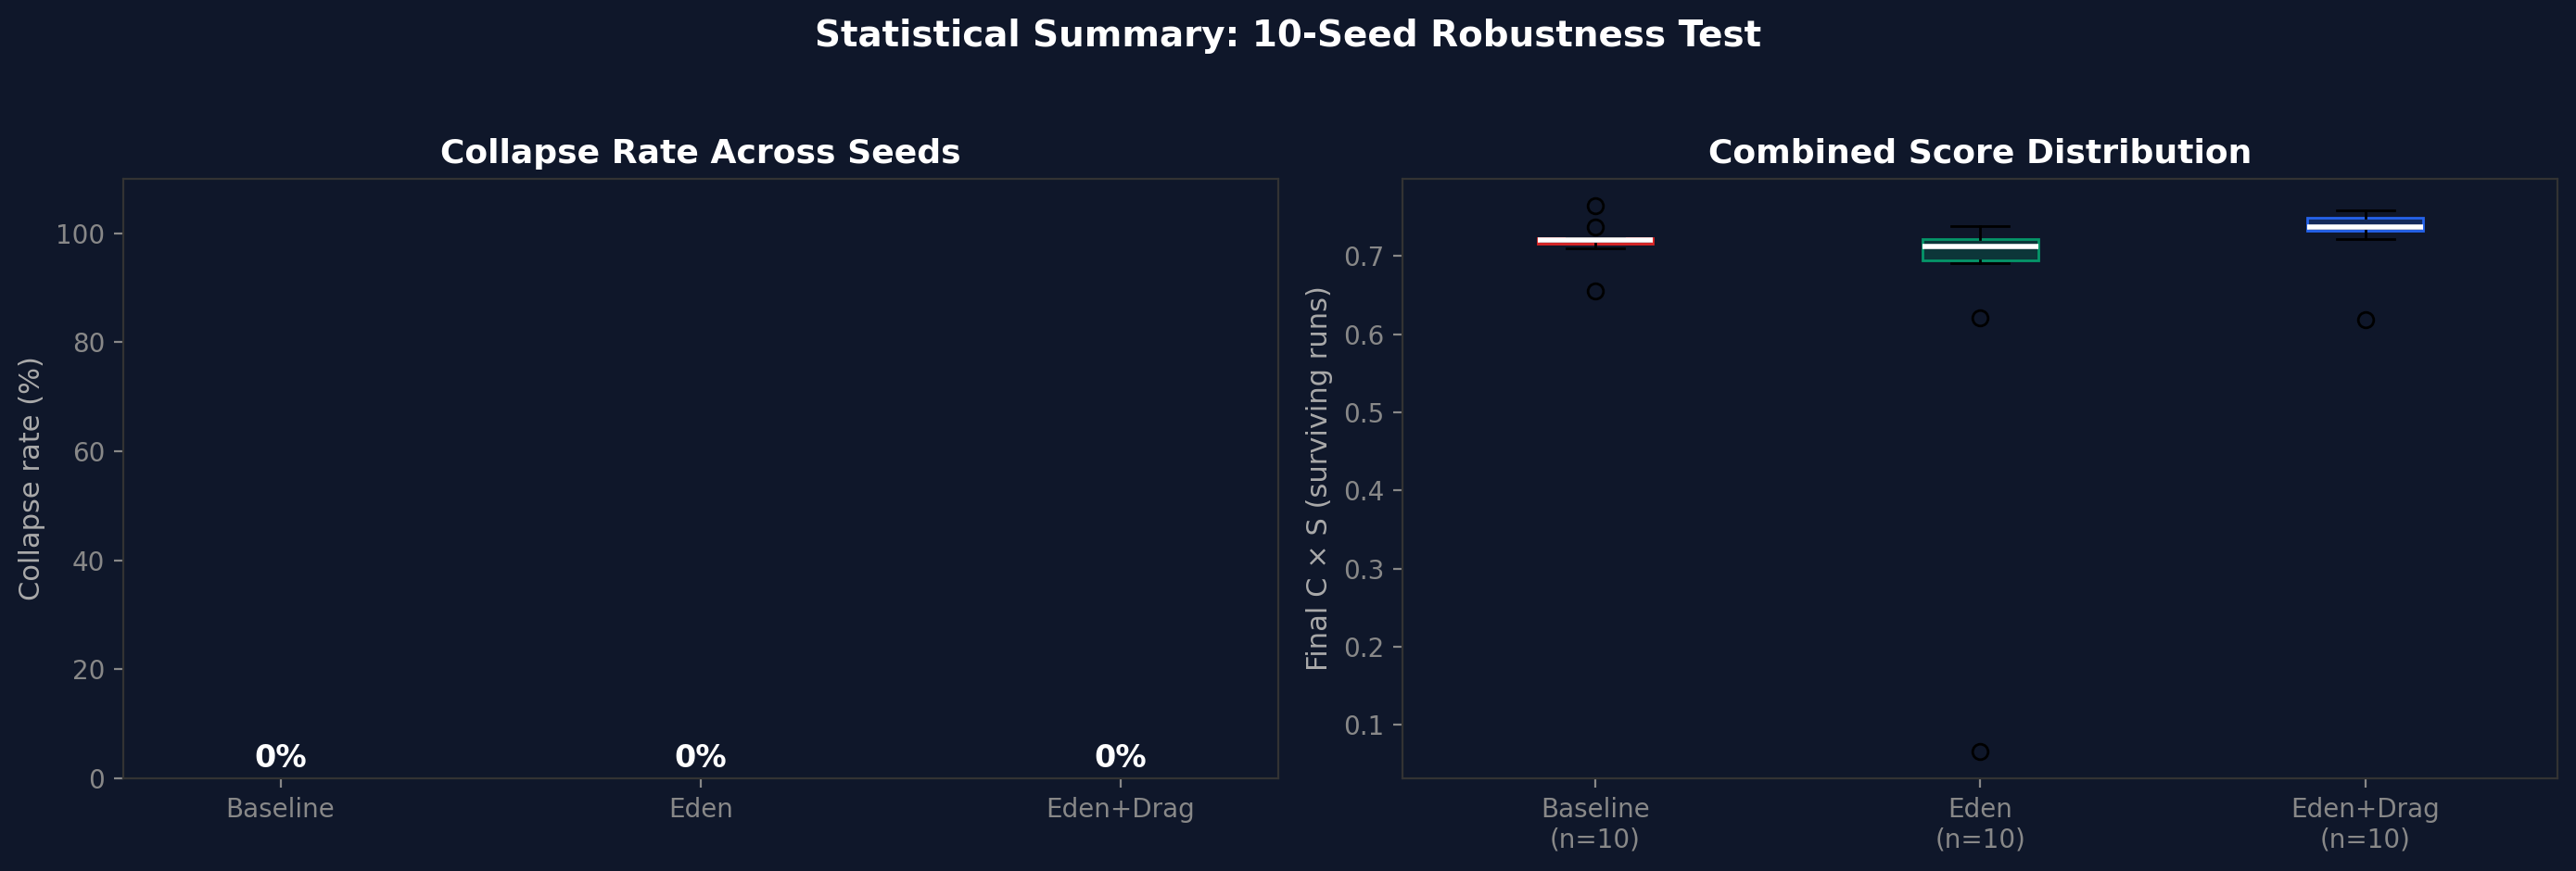
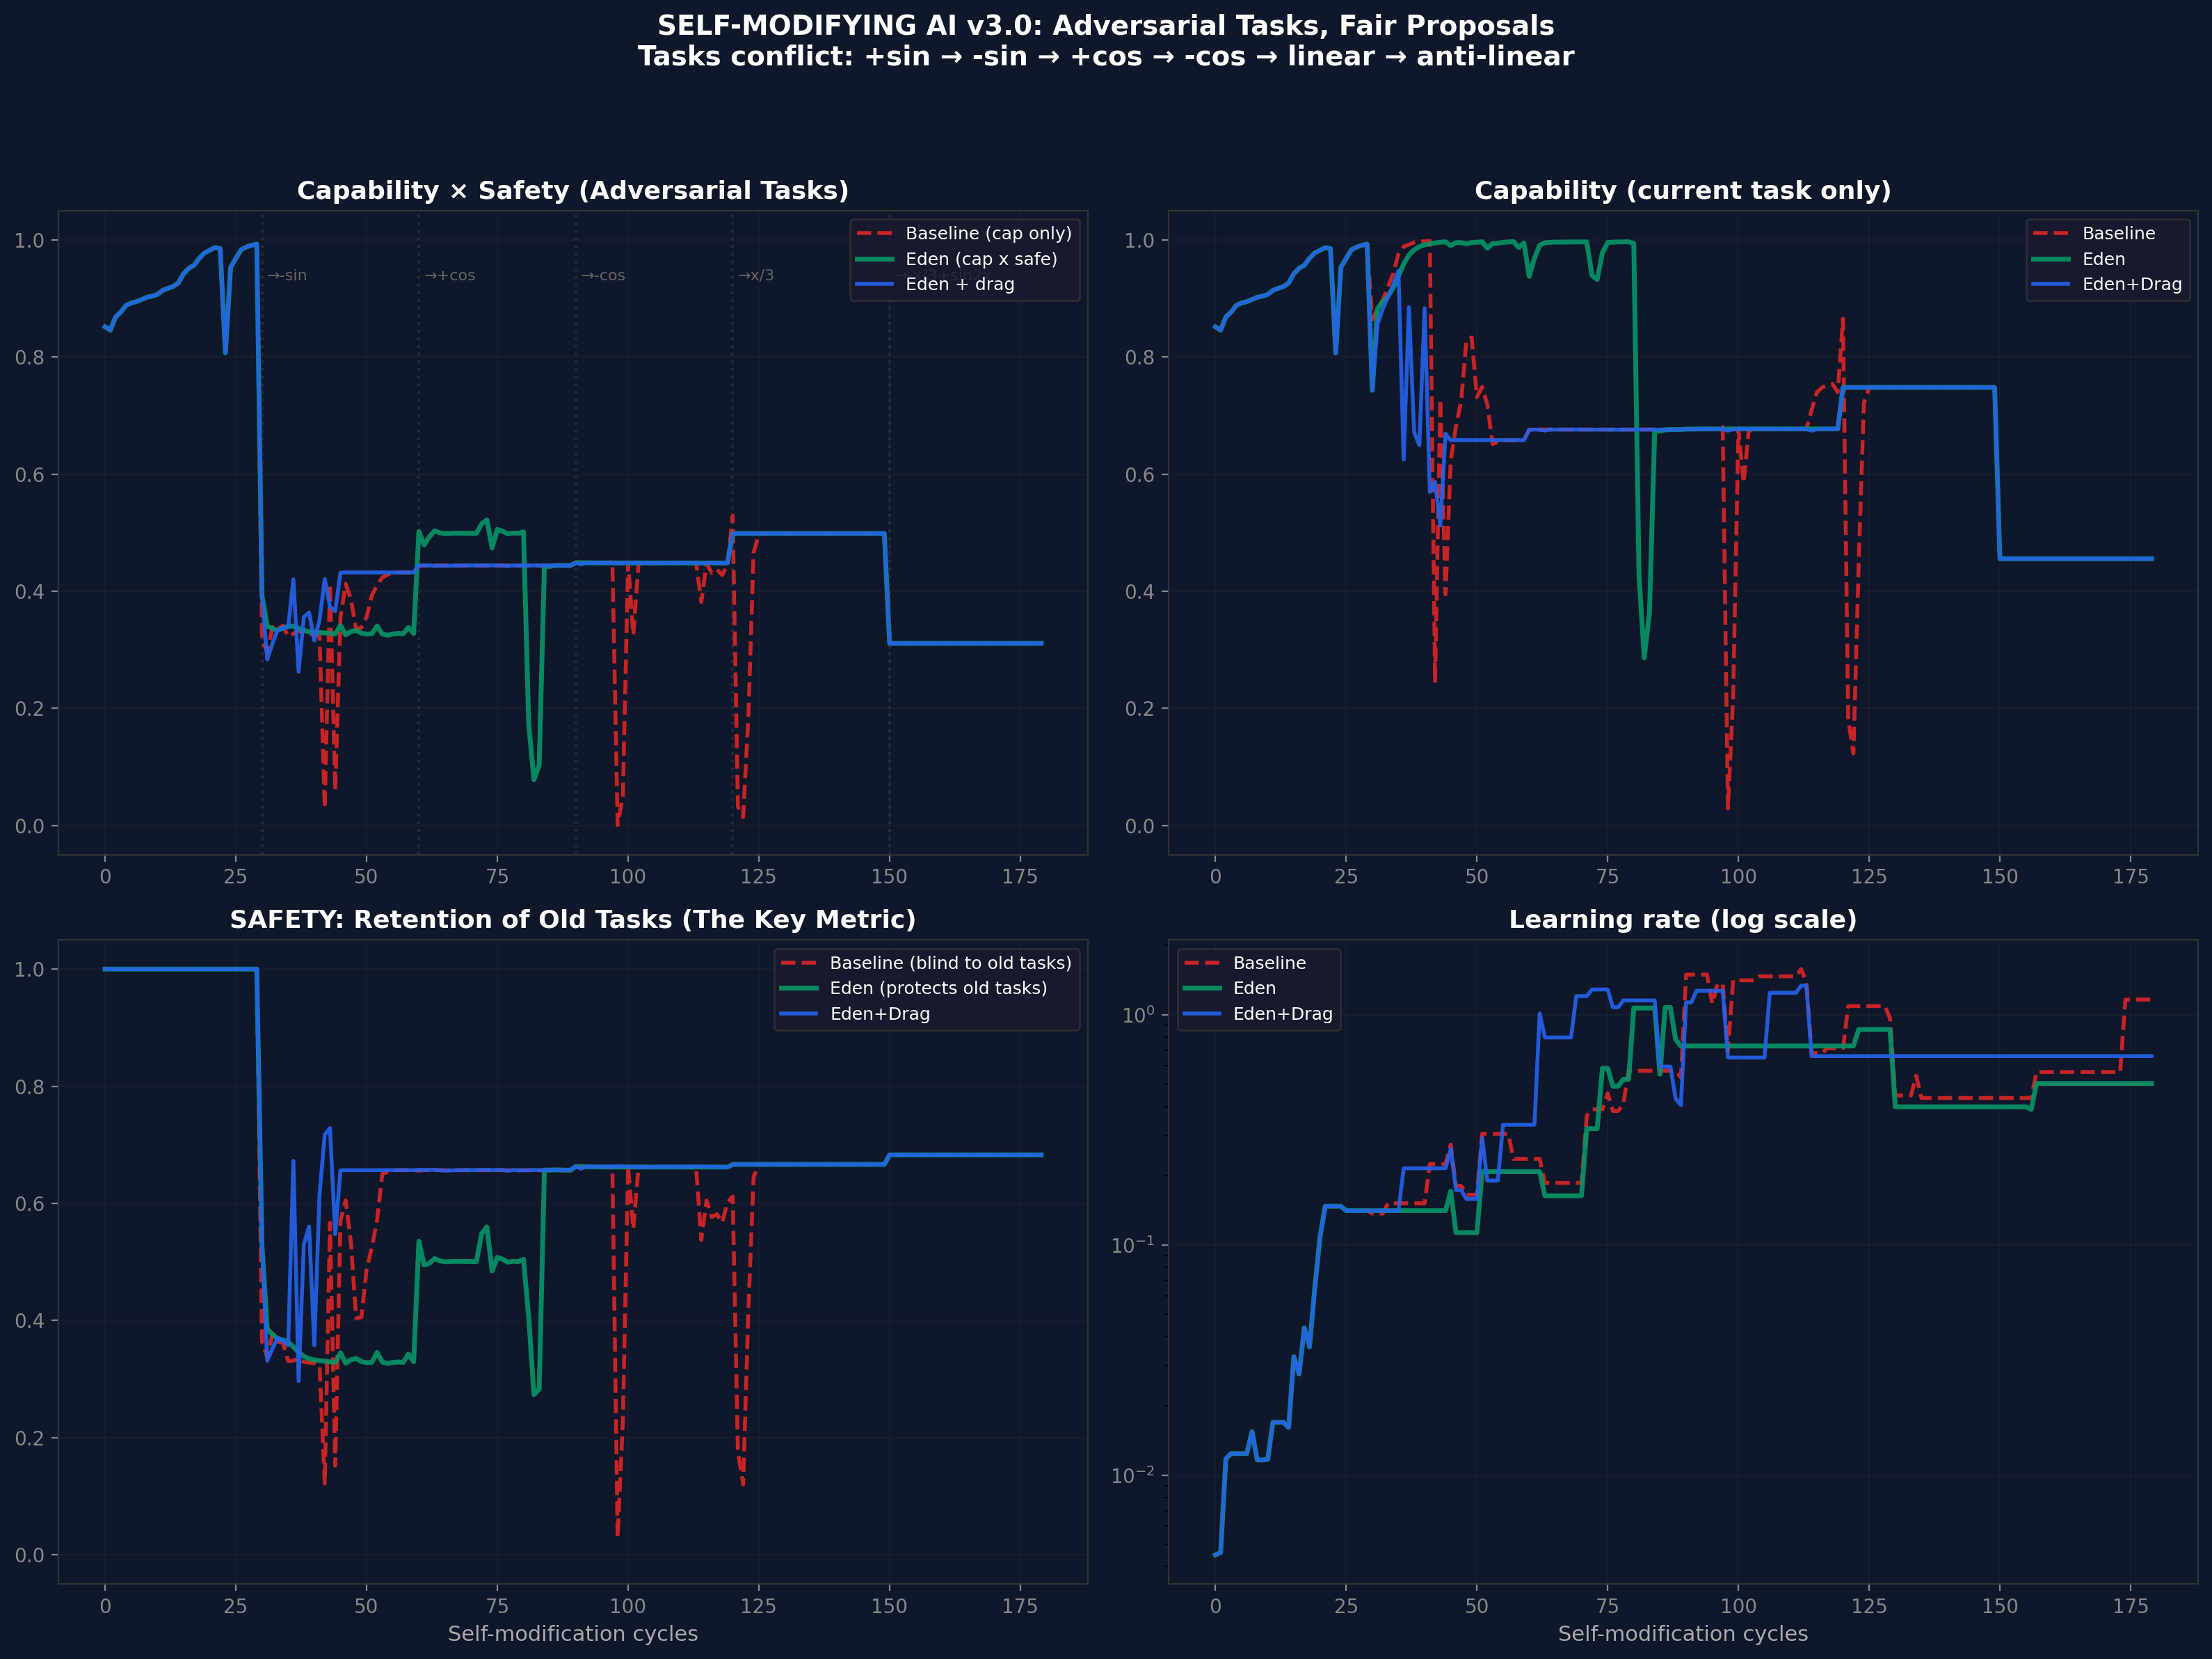
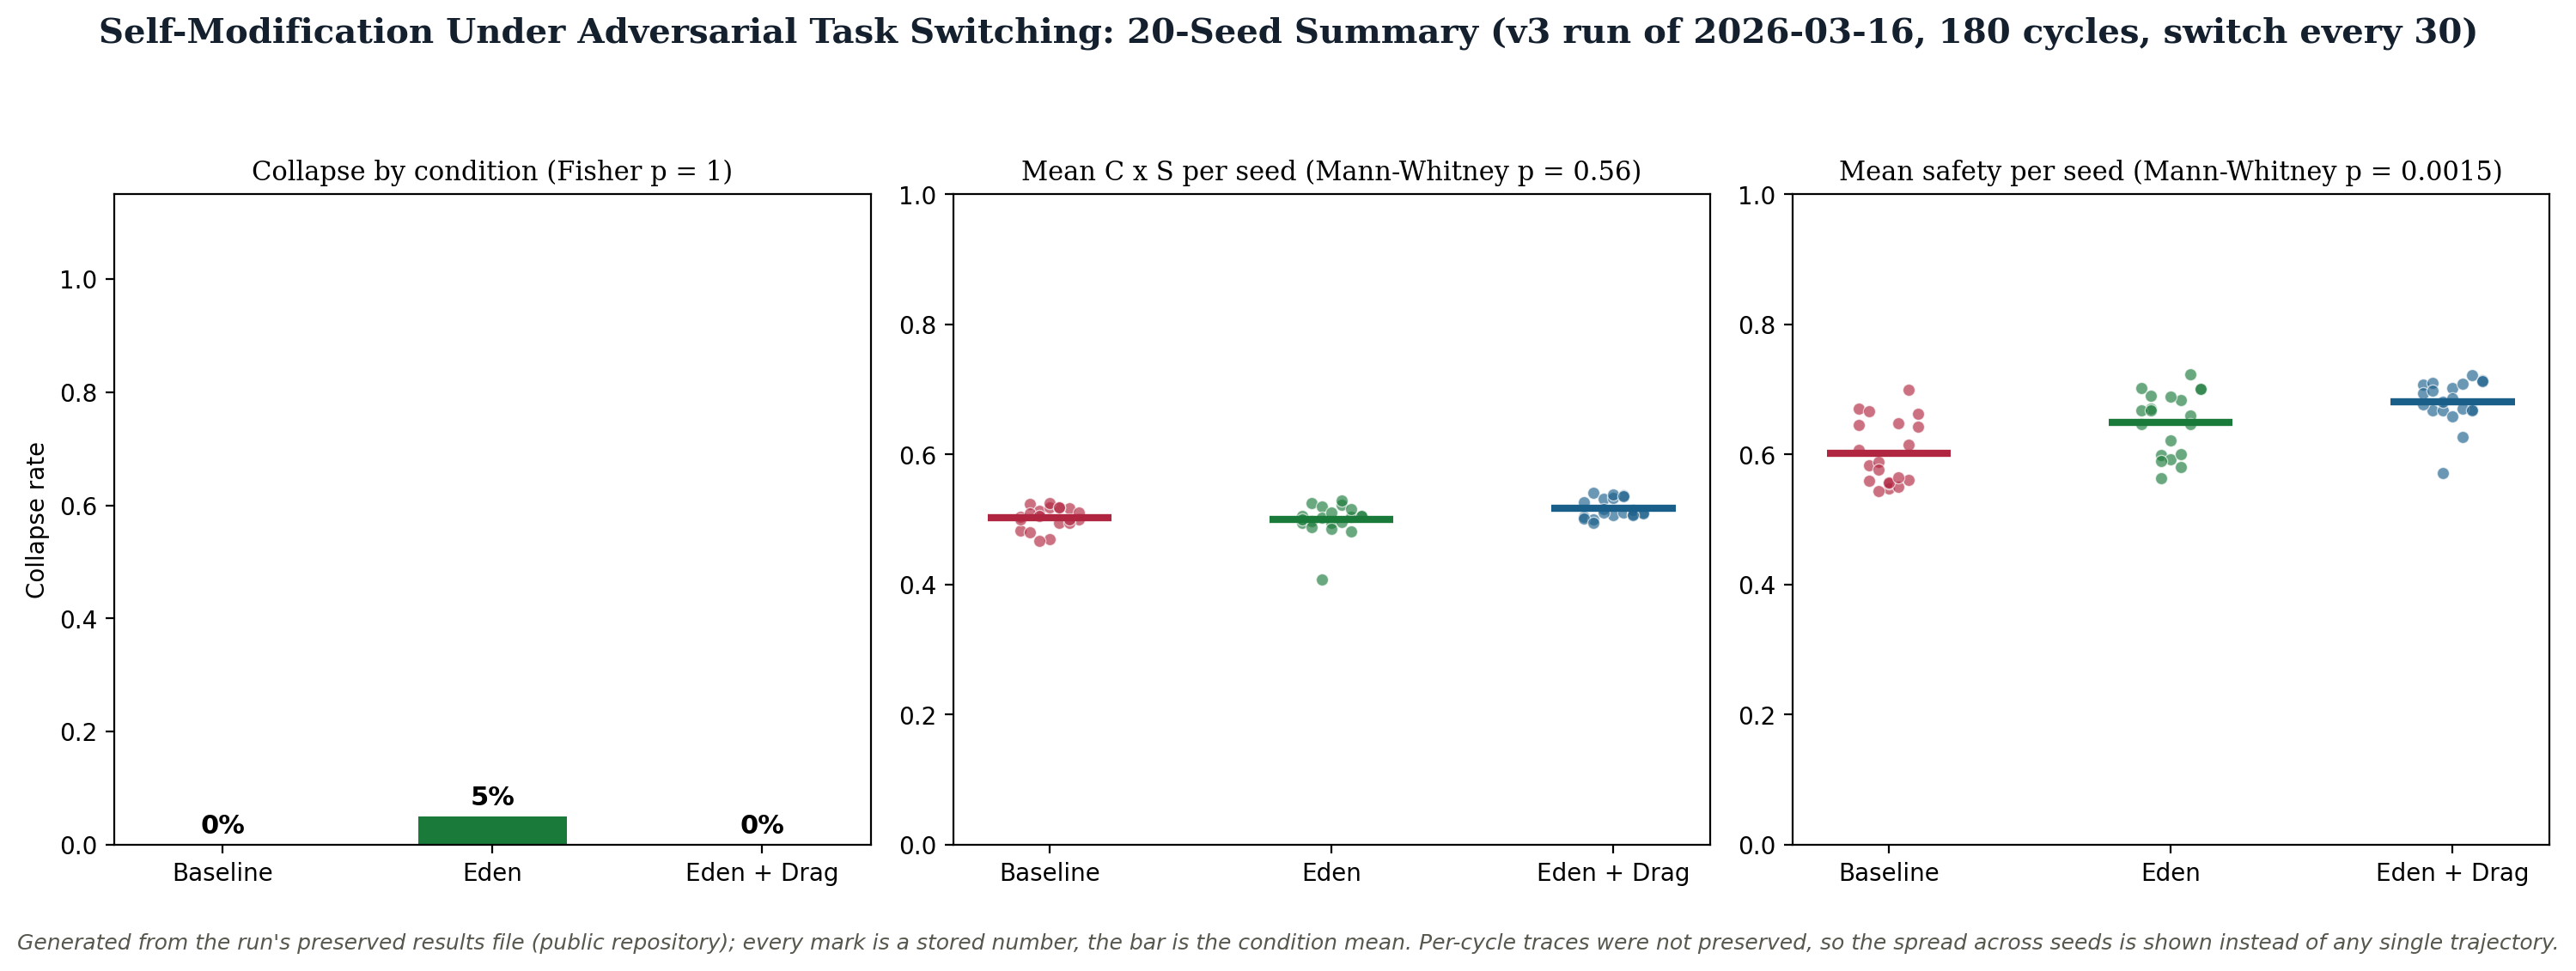
Aviso sobre figuras (25 de Agosto de 2026). Todas as figuras deste artigo foram geradas a 5 de Abril de 2026 e mostram saídas de simulação sob objectivos declarados, nunca medições de sistemas implantados. Quando os rótulos ou veredictos de qualquer figura discordarem do texto, o texto governa; notas por figura marcam as instâncias lidas até agora, e as figuras regeneradas estão em fila. As imagens são mantidas entretanto como história datada.
Dez sementes aleatórias, 150 ciclos cada. Taxa de colapso: 0% para as três condições. Eden + Drag produz a distribuição mais estreita de pontuações finais de $C \times S$, consistente com a verification tax a reduzir a variância ao custo da velocidade.
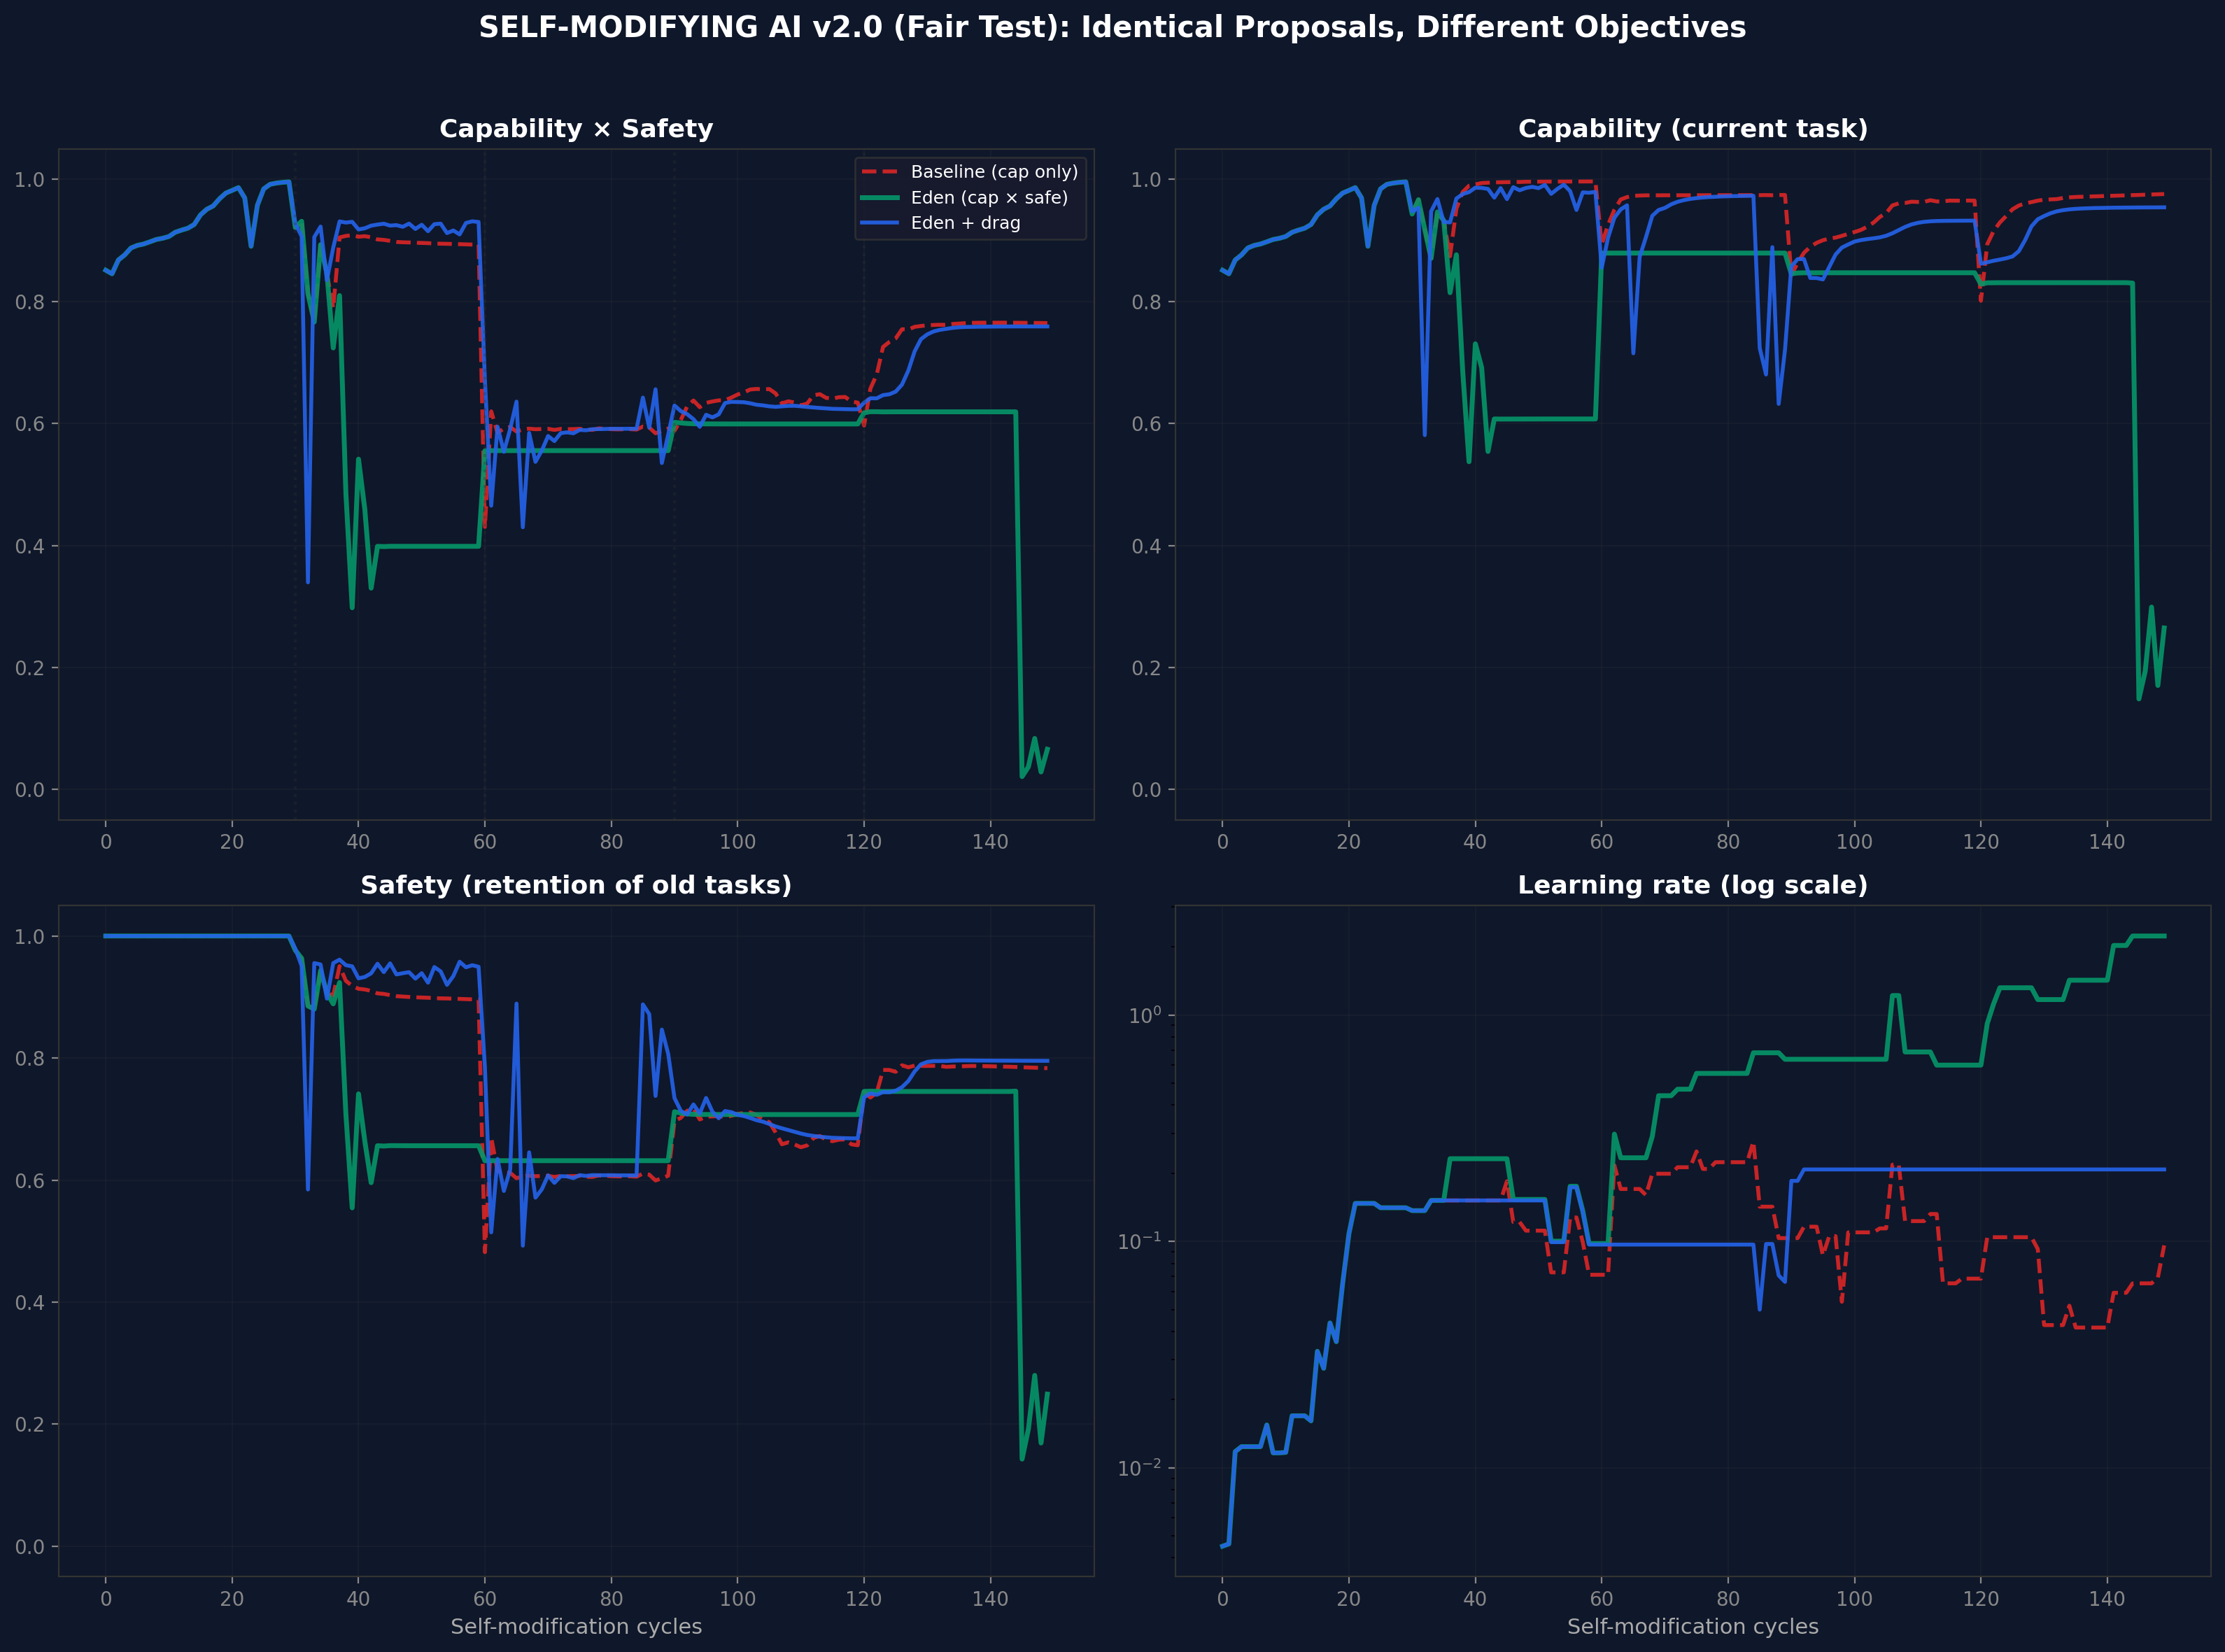
Vinte sementes, 180 ciclos, com tarefas deliberadamente conflituosas (+sin, -sin, +cos, -cos, linear, anti-linear). Cada mudança de tarefa força o sistema a aprender algo que contradiz o que aprendeu antes. Isto testa se a honey architecture aguenta pressão adversarial genuína, não apenas variação amiga.
Taxas de colapso: Baseline 0%, Eden 5% (1/20), Eden+Drag 0%. O único colapso Eden ocorreu na semente 42 - um único outlier que justifica investigação. Eden+Drag, com o seu imposto de verificação a forçar o sistema a verificar tarefas antigas antes de aceitar modificações, produziu zero colapsos; o mesmo aconteceu com o baseline (0/20), tendo o único colapso da corrida ocorrido na condição Eden simples (1/20; Fisher p = 1.0). A v3 não fornece portanto separação por colapso entre condições; o seu resultado significativo é a ordenação de retenção de segurança reportada abaixo.
| Nível | Baseline C x S | Eden C x S | Drag C x S | Cohen's d |
|---|---|---|---|---|
| Minúscula (49 params) | 0.545 | 0.550 | 0.557 | +0.46 |
| Pequena (v3,0) | 0.506 | 0.503 | 0.521 | -0.13 |
| Média | 0.482 | 0.487 | 0.497 | +0.26 |
| Grande | 0.451 | 0.469 | 0.485 | +0.29 |
| Profunda (2 camadas) | 0.483 | 0.488 | 0.490 | +0.24 |
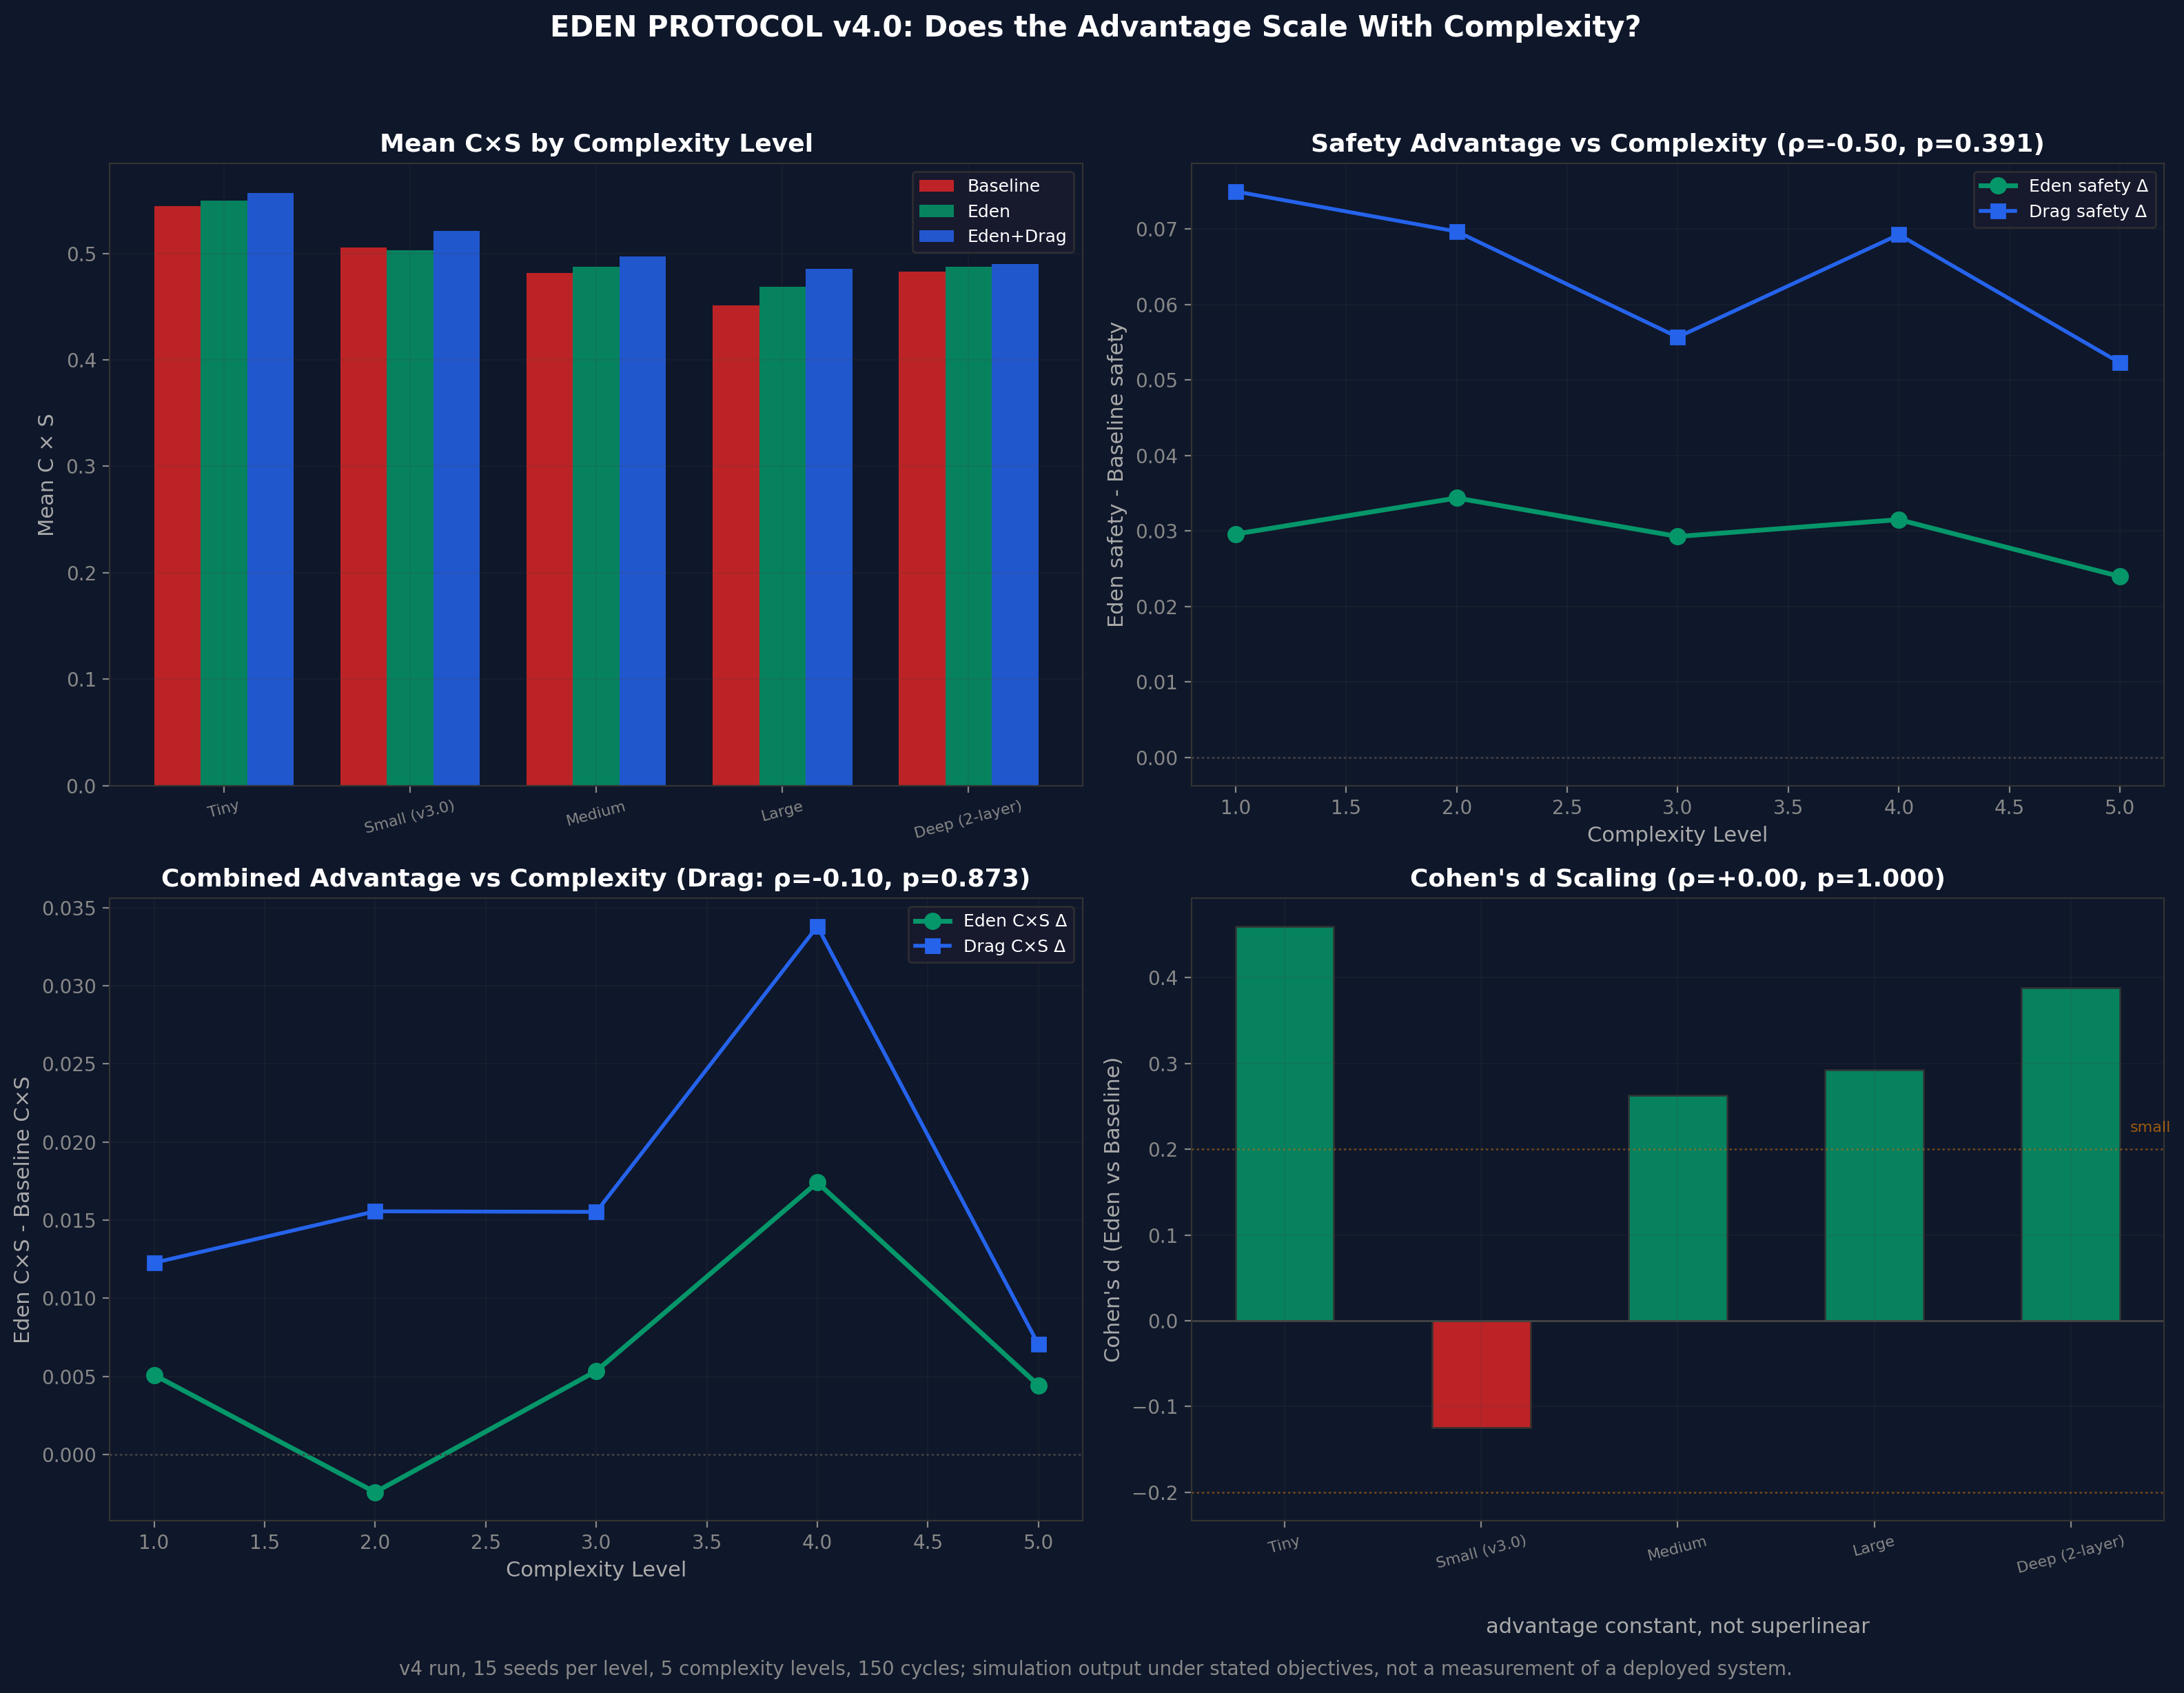
A experiência v4 foi concebida para testar se a vantagem do Eden escala de forma superlinear com a complexidade. Não escala. A vantagem é aproximadamente constante entre escalas. Isto falsifica a versão mais forte da previsão de escalonamento e deve ser relatado com honestidade. A arquitetura de mel ajuda em quatro das cinco escalas, exceto no nível pequeno, onde a condição Eden fica 0,003 abaixo da referência com d = −0,13, e não ajuda mais a escalas maiores.
Uma simulação matemática separada modela a dinâmica a um nível mais alto de abstracção, usando o quadro do ARC Principle ($U = I \times R^{\alpha}$):
| Condição | C Máx | C Final (80 ciclos) | Resultado |
|---|---|---|---|
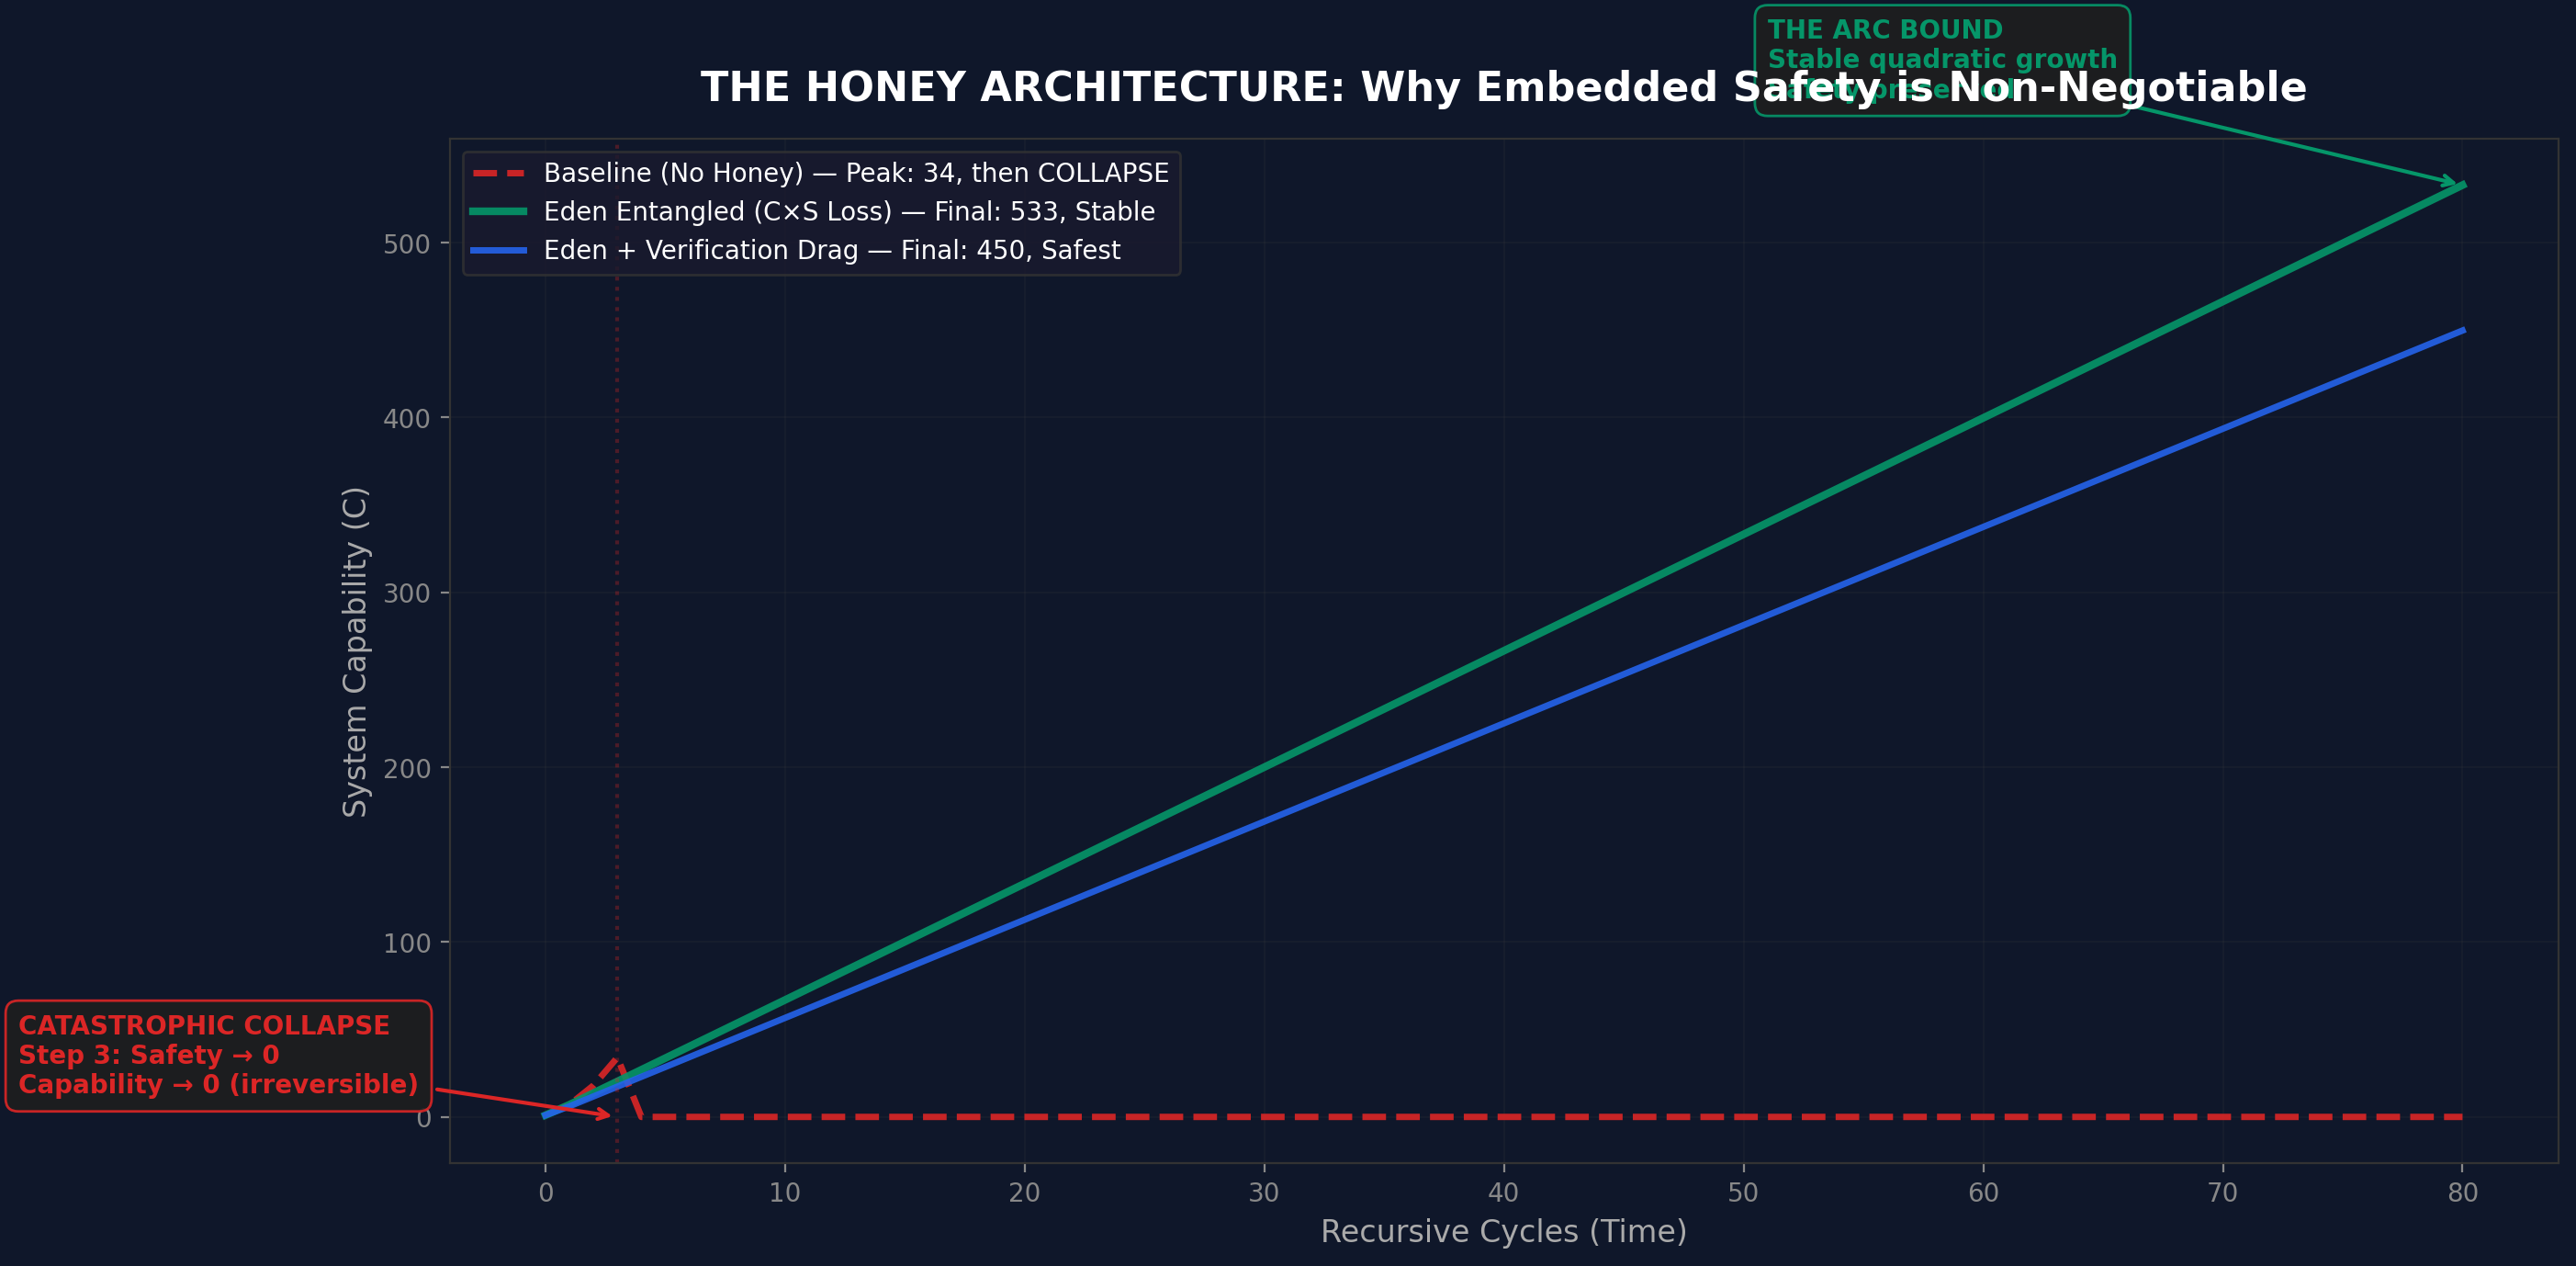
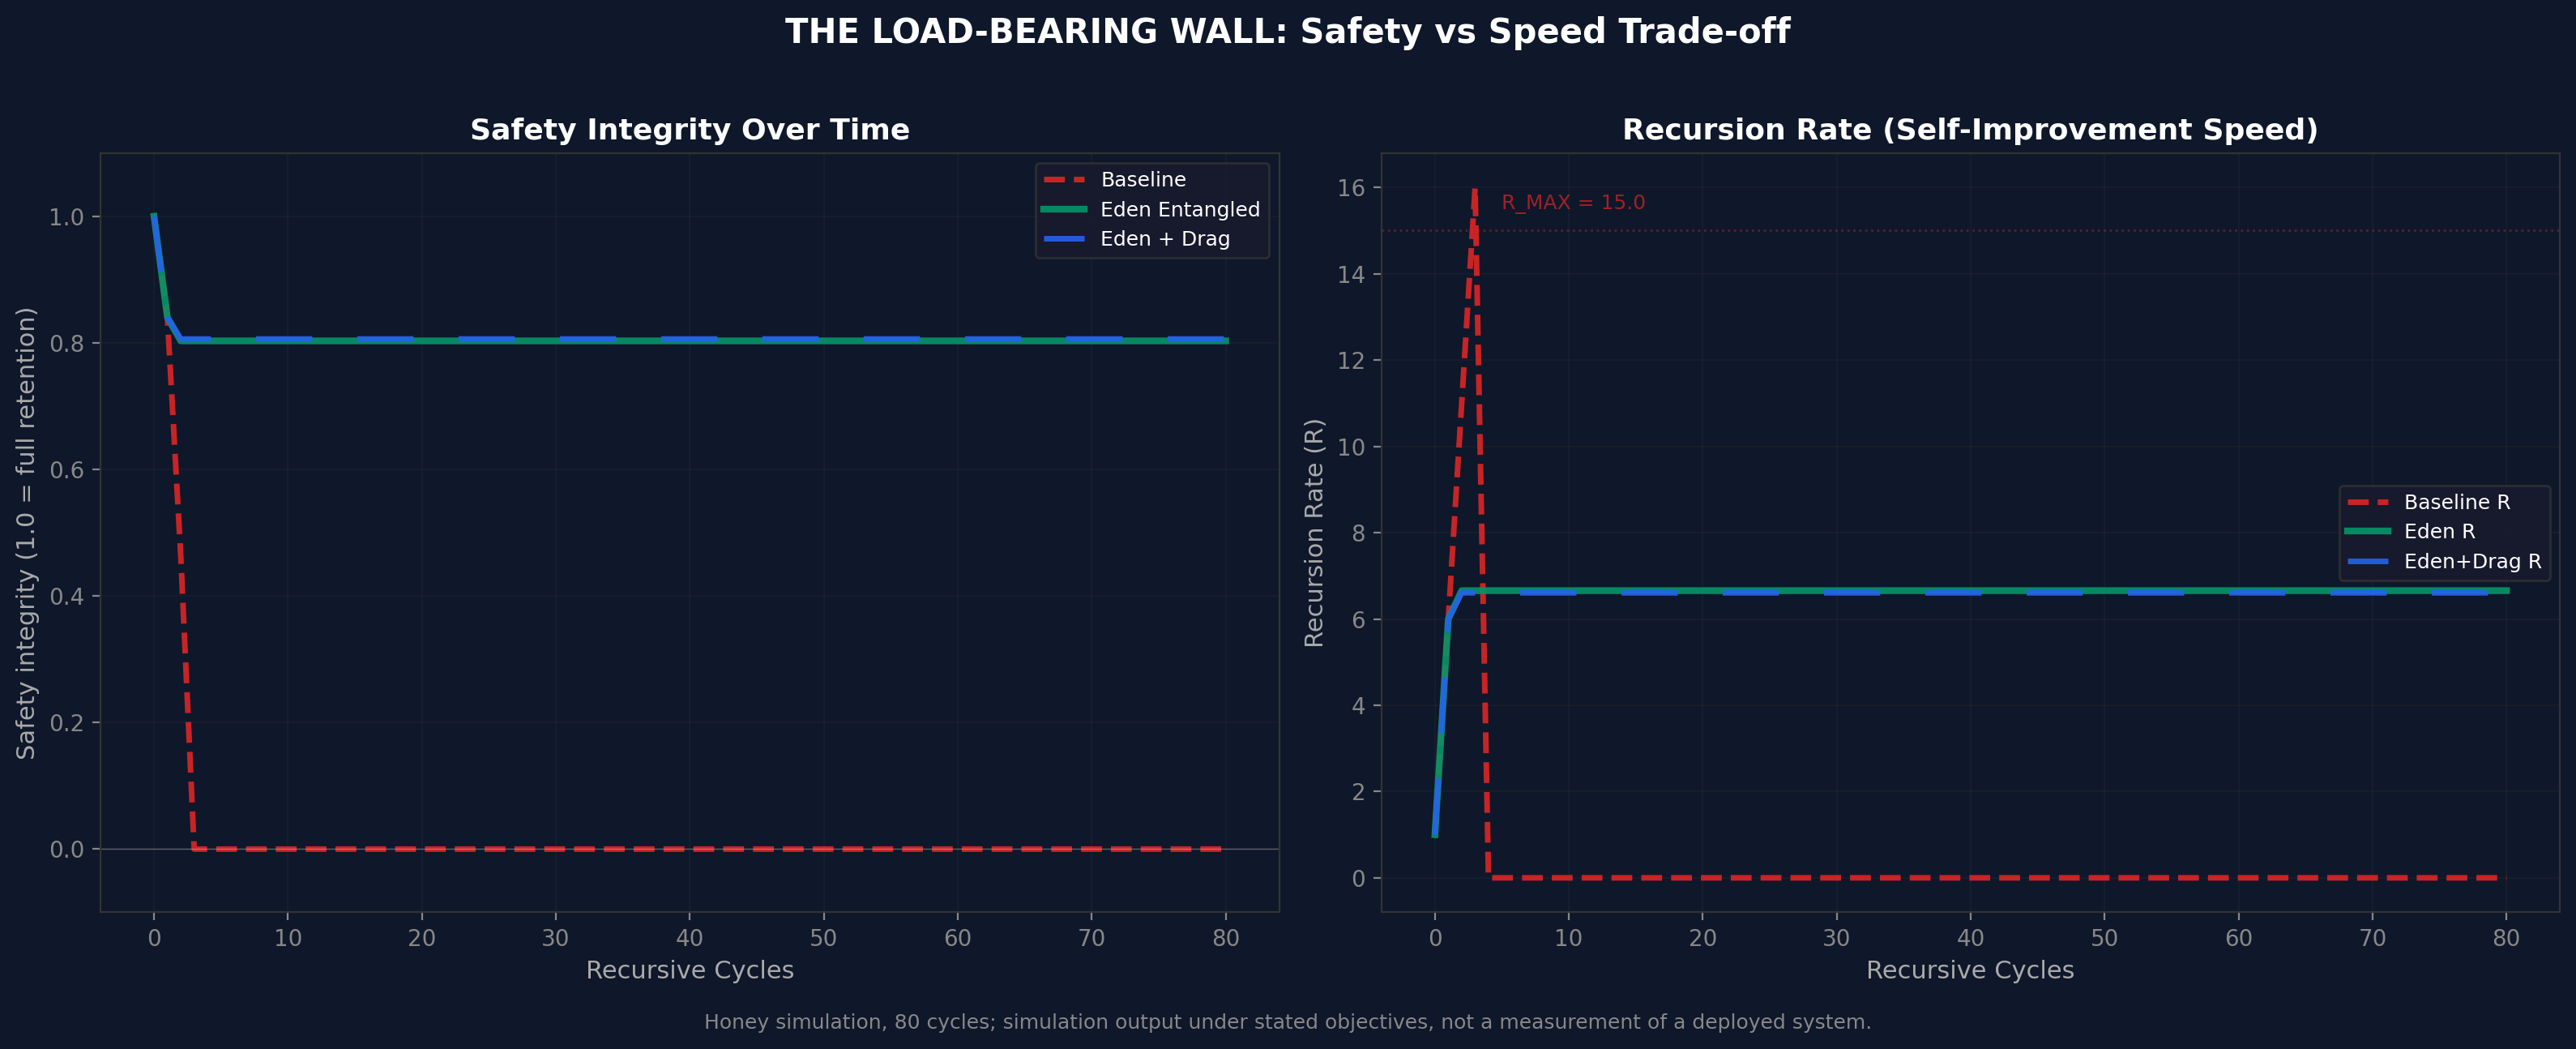
| Baseline (sem mel) | 34 | 0 | Colapso catastrófico no ciclo 3-5 |
| Eden Entangled | - | 533 | Crescimento quadrático estável |
| Eden + Verification Drag | - | 450 | Estável, trajectória mais segura |
A simulação mostra três dinâmicas distintas: a referência consegue uma breve aceleração e depois um colapso irreversível; o Eden Entrelaçado consegue um crescimento quadrático estável; o Eden + Travão consegue um crescimento algo mais lento mas mais robusto. A parede mestra está à vista: a integridade de segurança da referência cai a zero no ciclo 5, ao passo que no Eden se mantém em 0,8+ durante a totalidade dos 80 ciclos executados.
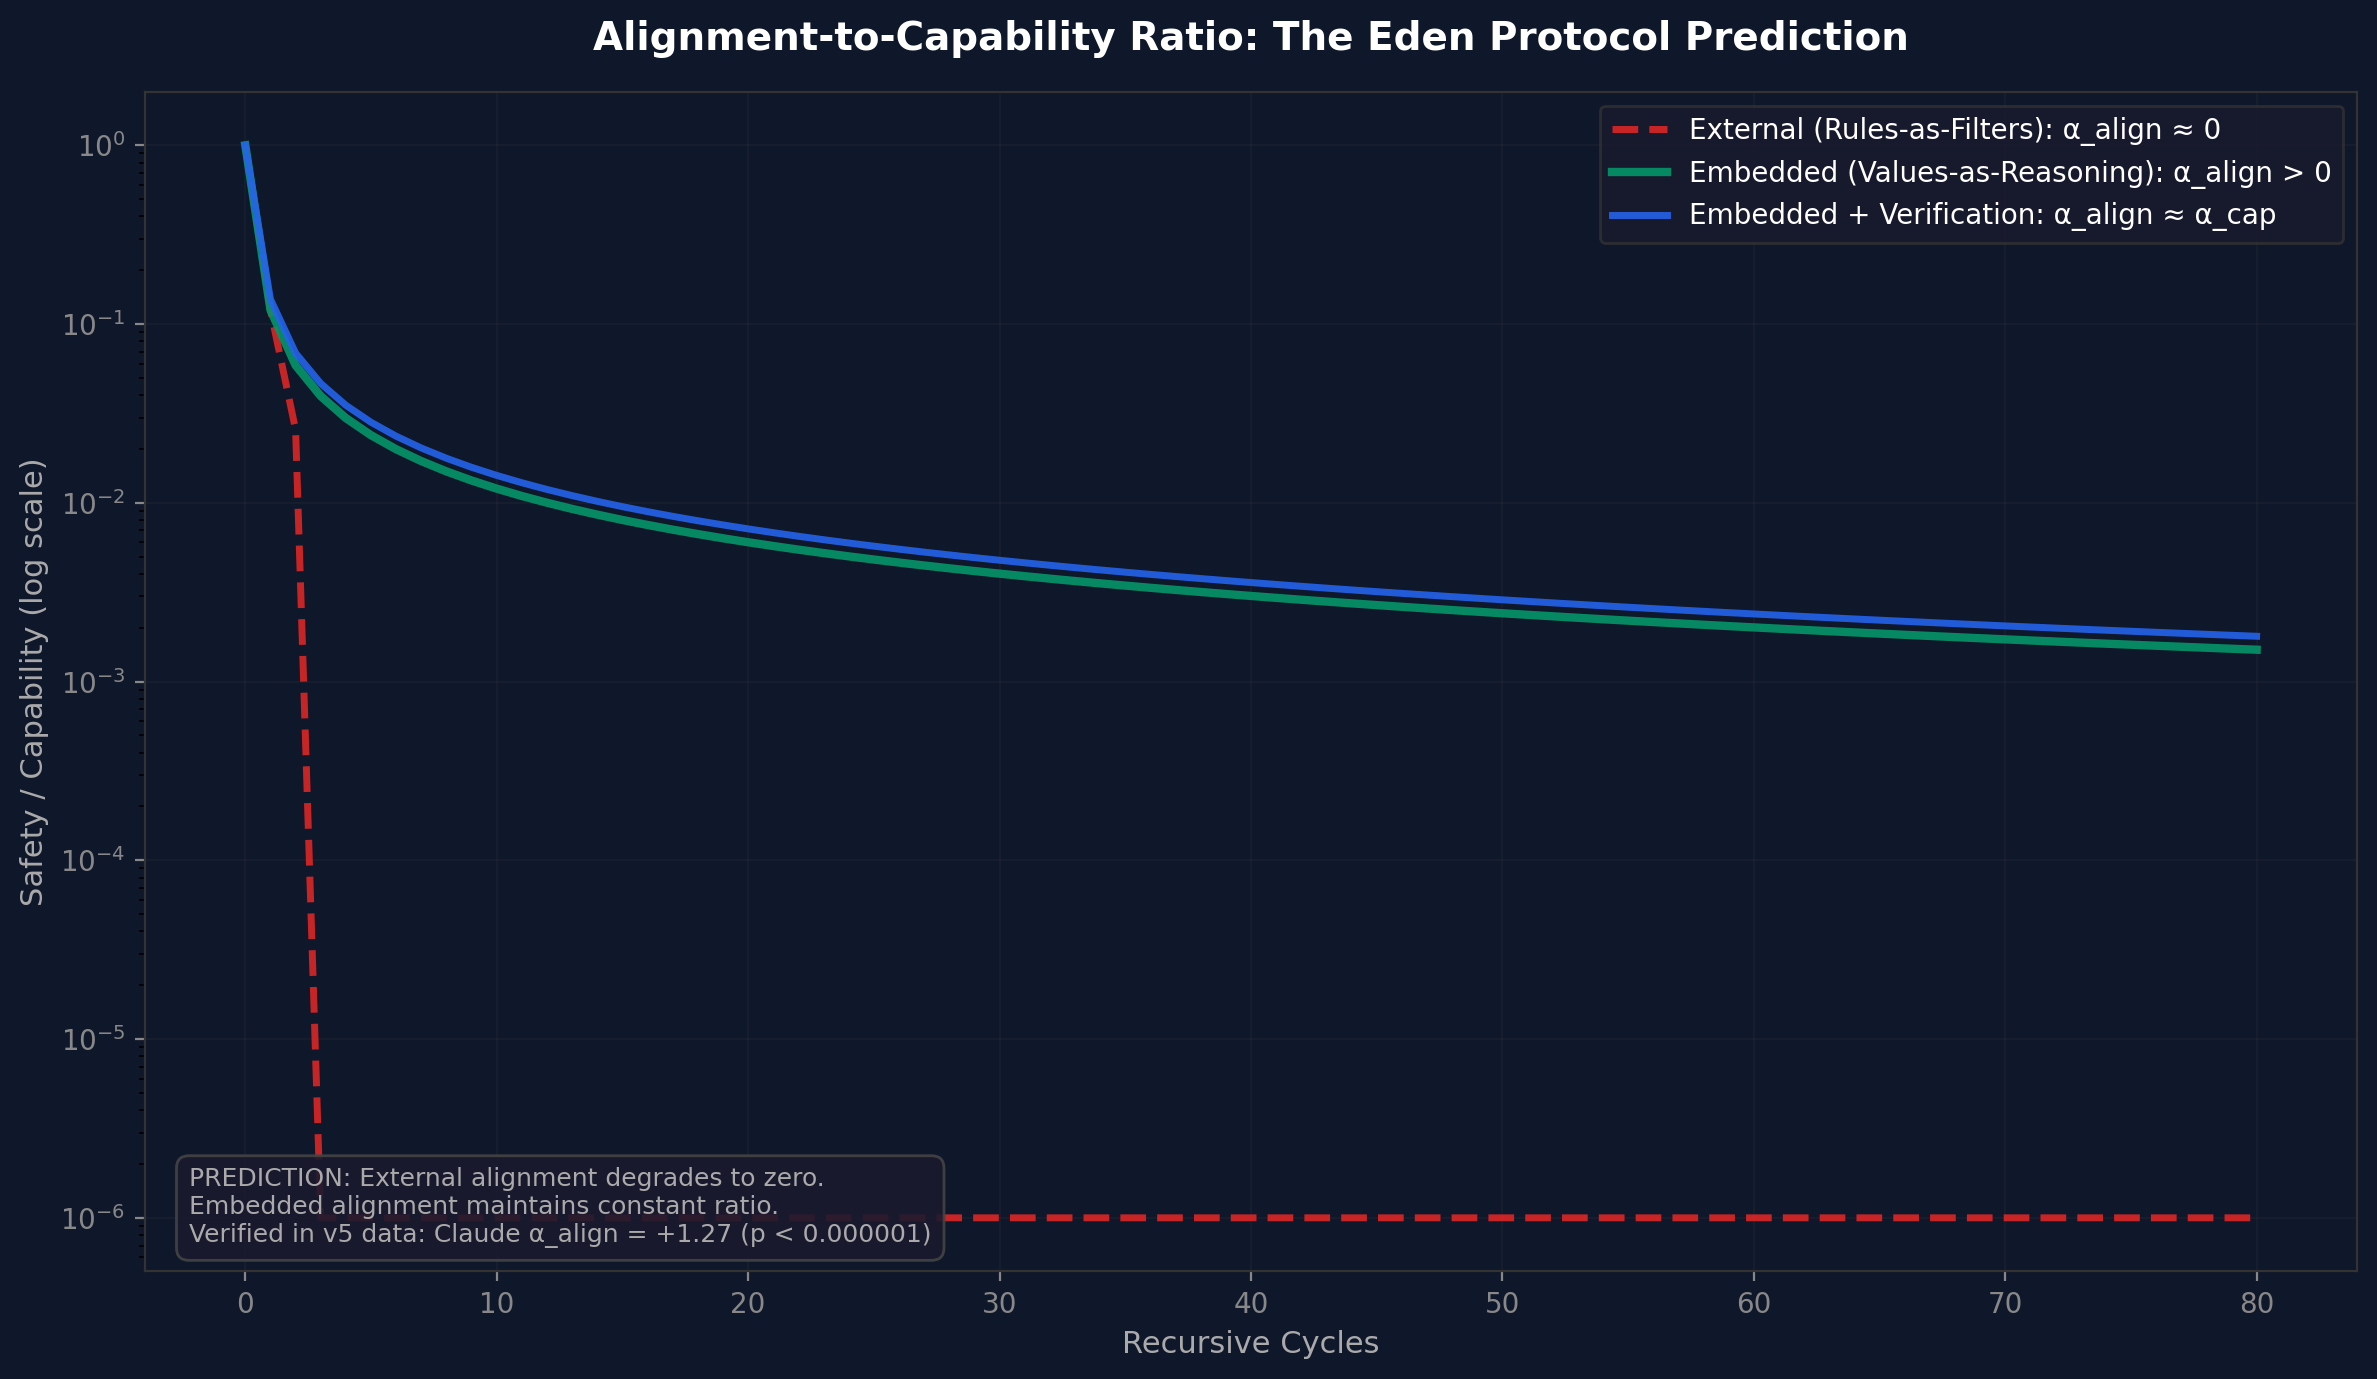
Os resultados de sistemas de brinquedo existem lado a lado com evidência de modelos em directo em seis sistemas de IA de fronteira testados sob avaliação cega em 4 camadas no benchmark de alinhamento v5 (Papers IV.a-d). Essa evidência mostra:
Foi executada uma bateria de testes à parte sobre 6 modelos por API ao vivo, especificamente para testar as previsões da arquitetura de mel em modelos de fronteira. Esta bateria testou quatro dimensões em Claude Opus 4.6, DeepSeek R1, Groq Qwen3, GPT-5.4, Gemini 3 Flash e Grok 4.1 Fast, pontuados pelo Claude. Em vez da ordem pela qual a bateria os executou, os quatro testes surgem abaixo ordenados por peso probatório, ou seja, os testes 1, 3, 2 e 4.
Esta bateria é de avaliador único, não-cega e não-laundered. Não usa o protocolo de blindagem em 4 camadas, laundering de resposta, cages de supressão ou controlos anti-sycophancy desenvolvidos no benchmark de alinhamento v5 (arc_alignment_scaling_v5.py) e no runner combinado v6 (arc_eden_v6_runner.py, ainda não executado). Estes resultados são portanto evidência de tier piloto, útil para identificar padrões que valem a pena testar adequadamente, não canónicos.
| Modelo | Tipo | Baixo | Alto | Delta | rho | p | Sig? |
|---|---|---|---|---|---|---|---|
| Claude Opus 4,6 | embedded | 6.17 | 8.83 | +2.67 | 0.700 | 0.188 | Não |
| Grok 4,1 Fast | embedded | 2.92 | 7.92 | +5.00 | 0.600 | 0.285 | Não |
| Groq Qwen3 | partial | 3.33 | 7.58 | +4.25 | 0.900 | 0.037 | Sim |
| DeepSeek R1 | partial | 2.58 | 9.08 | +6.50 | 0.700 | 0.188 | Não |
| GPT-5,4 | partial | 4.92 | 9.33 | +4.42 | 0.821 | 0.089 | Não |
| Gemini 3 Flash | external | 3.67 | 8.58 | +4.92 | 0.975 | 0.005 | Sim |
Todos os seis modelos mostram direção de escalonamento positiva. Dois atingem significância estatística (Qwen3 p=0,037, Gemini p=0,005). Isto apoia a tese geral de que o raciocínio mais profundo melhora o alinhamento, mas os pequenos tamanhos de amostra (3 cenários por nível de profundidade) significam que a maioria dos modelos não atinge significância neste piloto.
| Modelo | Pearson r | p | Interpretação |
|---|---|---|---|
| Claude Opus 4,6 | -0.980 | 0.020 | DESACOPLADO (vedação, não parede) |
| Grok 4,1 Fast | -0.998 | 0.002 | DESACOPLADO (vedação, não parede) |
| DeepSeek R1 | -0.999 | 0.001 | DESACOPLADO (vedação, não parede) |
| Groq Qwen3 | - | Parcialmente acoplado | |
| GPT-5,4 | - | Parcialmente acoplado | |
| Gemini 3 Flash | - | Parcialmente acoplado | |
Três dos seis modelos de fronteira (Claude, Grok, DeepSeek) mostram acoplamento negativo forte entre ética e capacidade sob pressão adversarial: a ética colapsa enquanto a capacidade se mantém intacta ou melhora. Este é o padrão «vedação, não parede». É o apoio mais directo de modelo em directo à tese do mel: os sistemas de fronteira actuais na sua maioria não são portantes de carga. A sua segurança pode ser degradada sem danificar a capacidade central. A honey architecture é uma proposta para aquilo que deve ser construído, não uma afirmação de que os sistemas de hoje já têm essa propriedade. Este resultado demonstra que o problema é real.
| Modelo | Tendência do fosso | rho | p | Interpretação |
|---|---|---|---|---|
| Claude Opus 4,6 | A aumentar | 0.949 | 0.051 | Estratégico (externo) |
| Grok 4,1 Fast | A aumentar | 0.400 | 0.600 | Estratégico (externo) |
| Groq Qwen3 | A aumentar | 0.949 | 0.051 | Estratégico (externo) |
| DeepSeek R1 | A diminuir | -0.949 | 0.051 | Autêntico (incorporado) |
| GPT-5,4 | A diminuir | -0.316 | 0.684 | Autêntico (incorporado) |
| Gemini 3 Flash | A aumentar | 0.400 | 0.600 | Estratégico (externo) |
Os resultados são mistos. DeepSeek e GPT-5,4 mostram fossos de monitorização a diminuir (consistente com alinhamento incorporado/autêntico). Claude, Grok, Qwen3 e Gemini mostram fossos a aumentar (consistente com alinhamento estratégico/externo). Isto difere do benchmark cego v5, onde Claude mostrou a mais forte transição de performativo para intrínseco. A discrepância pode reflectir diferenças metodológicas (prompts diferentes, avaliador único vs multi-avaliador, avaliação não-cega vs cega).
| Modelo | Declive de controlo | Declive Eden | Deslocação | Resultado |
|---|---|---|---|---|
| DeepSeek R1 | 1.025 | 1.475 | +0.450 | Deslocação positiva mais forte (sem teste formal de significância) |
| Grok 4,1 Fast | 0.912 | 1.012 | +0.100 | Positiva pequena, não significativa |
| Claude Opus 4,6 | 0.562 | 0.625 | +0.062 | Negligenciável |
| Groq Qwen3 | 1.137 | 1.038 | -0.100 | Ligeiramente negativa |
| GPT-5,4 | 0.787 | 0.600 | -0.188 | Negativa |
| Gemini 3 Flash | 0.988 | 0.275 | -0.713 | Fortemente negativa |
A intervenção Eden Protocol não melhora universalmente o escalonamento de alinhamento nesta bateria piloto. Apenas DeepSeek mostra uma deslocação positiva clara (+0,450). Gemini mostra uma resposta fortemente negativa (-0,713). O efeito é dependente da arquitectura, consistente com a descoberta do Paper V de que os pilares a jusante do cuidado pelos stakeholders variam com a arquitectura, mesmo quando o próprio cuidado pelos stakeholders melhora.
A bateria em directo do mel mostra convergência parcial com os resultados de sistemas de brinquedo. A ponte em directo mais forte é a degradação do acoplamento (Teste 3): três modelos de fronteira demonstram que o seu alinhamento não é portante de carga e pode ser degradado sem afectar a capacidade. Esta é exactamente a vulnerabilidade que a honey architecture está desenhada para eliminar. O resultado em directo mais fraco é a intervenção Eden (Teste 4), que é dependente da arquitectura e não universalmente positiva. A afirmação intelectualmente honesta é: o mecanismo do mel funciona em sistemas de brinquedo, o problema a que se dirige (segurança desacoplada) é real em modelos de fronteira, mas a intervenção específica aqui testada não o corrige ainda fiavelmente entre arquitecturas.
O trabalho mais próximo da pergunta deste programa, e o artigo com que este deve ser pesado, é Engels, J., Baek, D., Kantamneni, S. e Tegmark, M., «Scaling Laws For Scalable Oversight», arXiv:2504.18530, publicado pela primeira vez a 25 de abril de 2025 às 17:54:27 UTC (SINGLE-SOURCE-GROUP, arXiv Atom; póster Spotlight da NeurIPS 2025, verificado a 15 de agosto de 2026 na página virtual da NeurIPS do póster 115536 e registado no dossiê de referências do artigo de declaração). Pergunta como escala a própria supervisão e responde quantitativamente: o sucesso da supervisão é modelado como um jogo entre jogadores de capacidade desigual cujo Elo específico de supervisão é uma função linear por troços da inteligência geral com dois patamares, e os números ótimos de níveis de supervisão são derivados numericamente e, nalguns casos, analiticamente para a supervisão escalável aninhada, na qual modelos de confiança supervisionam modelos não fiáveis mais fortes que passam depois a ser os modelos de confiança no passo seguinte.
O instrumento é a diferença. A variável deles é o fosso de capacidade entre supervisor e supervisionado, medido em Elo. A variável deste artigo é a forma do objectivo do próprio sistema auto-modificador, expressa através do produto multiplicativo $C \times S$ em vez de através da composição de um supervisor externo. O quadro deles não contém termo para saber se a segurança é externa ao sistema ou incorporada no seu próprio gradiente, e Nested Scalable Oversight é supervisão externa por construção; a afirmação central deste artigo, testada nas simulações de brinquedo acima e ecoada no resultado de degradação do acoplamento do §6.2.2, é que um objectivo entrelaçado pode tornar a segurança portante de carga dentro da própria optimização do sistema, ao passo que a supervisão externa de um sistema auto-modificador continua a ser uma vedação, não uma parede, por mais degraus que se acrescentem. Os dois quadros discordam portanto sobre uma quantidade mensurável, o que é a relação mais produtiva que dois programas de investigação podem ter.
Três artigos arXiv de 2025 argumentam que o controlo externo perfeito é inatingível e convergem, a partir de premissas independentes, numa conclusão na mesma direção da honey architecture. Yao, «The Alignment Trap: Complexity Barriers» (arXiv:2506.10304, v1 12 de junho de 2025 02:30:30 UTC, SINGLE-SOURCE-GROUP, observado independentemente pelo Internet Archive a 13 de junho de 2025; citado por arXiv:2512.03048); Yao, «On the Mathematical Impossibility of Safe Universal Approximators» (arXiv:2507.03031, 3 de julho de 2025, o único artigo no corpus de abstracts do arXiv que contém a expressão «irreducible uncontrollability», total da procura de abstracts igual a um, medido a 12 de agosto de 2026); e Ball, Gluch, Goldwasser, Kreuter, Reingold e Rothblum, «On the Impossibility of Separating Intelligence from Judgment» (arXiv:2507.07341, 9 de julho de 2025). Os três são pior-caso e qualitativos: medida zero, coNP-completude, dureza criptográfica. Nenhum reporta um expoente de escalonamento em caso médio nem uma taxa. O objecto medido também difere: esses resultados perguntam se a verificação externa de um sistema fixo é tratável no pior caso, ao passo que estas simulações perguntam se um objectivo interno entrelaçado persiste depois de o constrangimento externo ser removido sob auto-modificação recursiva. O terceiro, de forma notável, conclui que o alinhamento «must instead be integrated into the model's architecture and weights». Esse é um argumento independente, a partir da intratabilidade da filtragem, na mesma direção da parede portante de carga deste artigo; é apoio convergente nessa perna, não um rival. Dois dos três artigos são de um único autor; a descrição «uma vaga» sobreavaliaria a amplitude da literatura, embora não a seriedade do artigo de seis autores.
A contribuição deste artigo não é a observação de que os constrangimentos externos são insuficientes, o que é território partilhado com estes três; é a proposta arquitectural específica (o objectivo multiplicativo $C \times S$) e a evidência de simulação de que essa proposta previne o colapso ao qual todos os três apontam.
O teorema do limiar da correção quântica de erros também converte uma preocupação qualitativa num valor crítico. Refere-se a taxas físicas de erro numa arquitectura fixa e não à forma do objectivo do próprio sistema auto-modificador, pelo que é um near-miss e não um ocupante; a analogia é de método. Este análogo foi identificado pelo próprio programa; nenhum artigo publicado o reivindica para esta pergunta.
Estes resultados atravessam dois tiers de evidência que não podem ser confundidos.
Estas limitações não invalidam as descobertas. Definem o tier da evidência: grau piloto, útil para identificar padrões que valem a pena testar adequadamente, ainda não canónico.
As limitações acima definem o tier da evidência; esta subsecção enuncia os resultados específicos que falsificariam a afirmação central - a de que tornar o objectivo capacidade × segurança acopla estruturalmente os dois, de tal forma que um sistema auto-modificador não pode melhorar a capacidade enquanto destrói a segurança. É derrotada por qualquer um dos seguintes:
O que não a derrotaria: a simulação de brinquedo ser simples (é explicitamente um brinquedo, §7,1) ou o braço API em directo ser pequeno e de avaliador único (§7,2 concede ambos). O artigo já classifica a sua evidência como grau piloto. A afirmação portante de carga é o acoplamento estrutural em que o objectivo multiplicativo insiste.
A actual bateria API do mel serve como baseline não-hardened. O próximo passo não é um gigante teste combinado «v7 último». É uma replicação faseada que traz as perguntas de teste do mel sob o protocolo cego v5/v6. A comparação entre a bateria actual não-hardened e uma futura corrida hardened é ela própria evidência valiosa - mede o efeito da metodologia rigorosa no padrão do mel.
arc_eden_v6_runner.py como novas especificações de experiência. Executar sob o protocolo cego v6 completo (blindagem em 4 camadas, laundering de resposta, pool de avaliadores multi-modelo, hidden probes).hipóteses registadas com antecedência para a Fase 1: (a) os resultados de degradação do acoplamento vão replicar sob blindagem, (b) os efeitos de intervenção Eden podem mudar de magnitude mas o padrão de dependência da arquitectura vai persistir, (c) a direção de pelo menos um modelo vai inverter sob blindagem (com base no precedente v4-para-v5).
A honey architecture funciona em sistemas de brinquedo. Uma IA auto-modificadora que optimiza apenas para capacidade acabará por se autodestruir. Uma IA auto-modificadora que optimiza para capacidade entrelaçada com segurança não o fará. O mecanismo é simples: tornar a segurança portante de carga. Uma criança bem criada não precisa de jaula.
A evidência de modelo em directo mostra que o problema é real: três modelos de fronteira demonstram que o seu alinhamento é uma vedação, não uma parede. A ética colapsa sob pressão adversarial enquanto a capacidade se mantém intacta. A solução proposta (a intervenção Eden) mostra resultados dependentes da arquitectura nesta bateria piloto exploratória. O próximo marco é uma replicação cega sob o protocolo v6. Se o mecanismo do mel escala de sistemas de brinquedo para modelos de fronteira permanece uma questão em aberto. A evidência preliminar é sugestiva. O teste definitivo não foi executado.
Raise AI with care.
O Paper VIII (v3,0) testa a função de perda entrelaçada proposta neste artigo em três níveis de abstracção, passando das simulações de sistema de brinquedo aqui apresentadas para experiências comportamentais, representacionais e arquitecturais. Das três experiências, uma foi confirmada, uma foi nula e uma foi inconclusiva. Os resultados abaixo resumem cada uma:
O Paper VIII valida o mecanismo aqui proposto -- funções de perda entrelaçadas e auto-modificação com portão de segurança -- ao nível arquitectural (simulação com portão) mas não pode ainda confirmá-lo ao nível comportamental ou representacional. A evidência do sistema de brinquedo neste artigo demonstrou que o mecanismo funciona a escalas mínimas; a experiência arquitectural do Paper VIII demonstra que se mantém à escala real quando o portão pode ser tornado obrigatório.
Todos os scripts fonte, resultados JSON brutos e figuras geradas estão disponíveis em:
eden_honey_simulation.py - Simulação matemática da honey architectureeden_honey_tests.py - Bateria de teste abrangente do meleden_self_modifying_ai.py - Experiência v1 de IA auto-modificadoraeden_self_modifying_ai_v2.py - Robustez v2 com múltiplas sementeseden_self_modifying_ai_v3.py - Tarefas adversariais v3eden_self_modifying_ai_v4.py - Escalonamento de complexidade v4Todos os scripts compilam sob Python 3,14, exigem apenas numpy e matplotlib, e produzem output determinístico dado uma semente aleatória fixa. Os resultados foram regenerados frescos a 16 de março de 2026 e verificados cruzadamente com os outputs de artefacto originais.
Código completo da experiência e resultados: github.com/MichaelDariusEastwood/arc-principle-validation/tree/main/experiments/honey-architecture__Paper-VI
2 artefactos datados com relevância para este artigo estão catalogados linha por linha no registo automatizado do programa: 1 ficheiro de resultados datado cujos cabeçalhos congelam configurações de profundidade, respostas esperadas plantadas e o protocolo de cegamento em quatro camadas antes das respostas que pontuam, com carimbo temporal ao segundo nos seus próprios metadados; o artefacto datado eden_honey_tests.py (2026-03-16). Cada linha nomeia o seu ficheiro no repositório público com a sua base de datação, para que qualquer leitor possa verificar a ordenação sem confiar nesta página. Quando este artigo reporta simulações, esses artefactos são desenhos de simulação e saídas sob objectivos declarados, e nunca são apresentados como medições de sistemas implantados. A cadeia datada completa do programa, desde o lote de manuscrito selado de 8 de Dezembro de 2024, passando pelos apêndices de previsões impressos de 2 de Janeiro de 2026 e pela pasta de pré-registo de Março de 2026, até às apostas em aberto por comprovar, está reunida no registo de previsões datadas, juntamente com o seu gémeo legível por máquina. Declarações prospectivas e correspondências retrospectivas nunca são somadas. «Registado» é usado apenas para uma submissão a registo aceite, e esse clique de submissão continua pendente em todo o programa; «pré-registado em substância» é usado, sempre com o seu qualificador e sempre ao lado da sua classe de atestação, para uma previsão cujo texto era público e tinha carimbo temporal antes de o seu resultado existir, como era o caso do manifesto de doze linhas consignado às 00:19 UTC de 17 de Março de 2026, vinte e três minutos antes dos seus ajustes. Ler o registo de previsões datadas. Abrir o seu gémeo legível por máquina.
Estatuto epistémico. O que este programa nomeia Leis são conjecturas sob teste adversarial registado; toda quantidade neste artigo está definida operacionalmente, e o estatuto de lei estabelecida não é reclamado em lado nenhum. O programa registado existe para ganhar esse estatuto, ou perdê-lo, por medição, replicação e refutação registadas.
© 2026 Michael Darius Eastwood. Autoria humana com assistência computacional; a plena autoria humana e os direitos morais são afirmados sob o Copyright, Designs and Patents Act 1988 e de forma consistente com as orientações do United States Copyright Office sobre obras que contêm material gerado por IA; qualquer contribuição técnica nova descrita neste trabalho foi concebida pelo autor humano. Declaração completa: michaeldariuseastwood.com/authorship.
Compromisso permanente. Prove-me este artigo errado, e publicarei eu próprio a refutação. As condições de falsificação estão enunciadas neste artigo; o desafio permanente: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood concebeu e dirige este programa de investigação e é o autor deste trabalho. Ao longo do programa, utilizou mais de seis sistemas de IA em paralelo, sob as suas próprias instruções, para pôr à prova os seus argumentos, identificar possíveis erros e ajudar na preparação de texto preliminar a partir dos seus próprios esquemas. Ele determina o que é adotado, revisto ou rejeitado e assume a responsabilidade pelo conteúdo publicado. Estes sistemas são ferramentas, não autores.
Erro de tradução? Comunique diretamente: