Цей переклад створено автоматично з датованого англійського оригіналу. Канонічною є англійська сторінка. English →
Передбачення на рівні теорії, попередньо зареєстровані на OSF: DOI 10.17605/OSF.IO/P8CKQ, зареєстровано 8 вересня 2026 року (версія 1.100), оновлено 13 вересня 2026 року (версія 1.102), двадцять два твердження.
Супровідний документ: Операційні визначення програми ARC, версія 1.7.1, 3 вересня 2026 року.
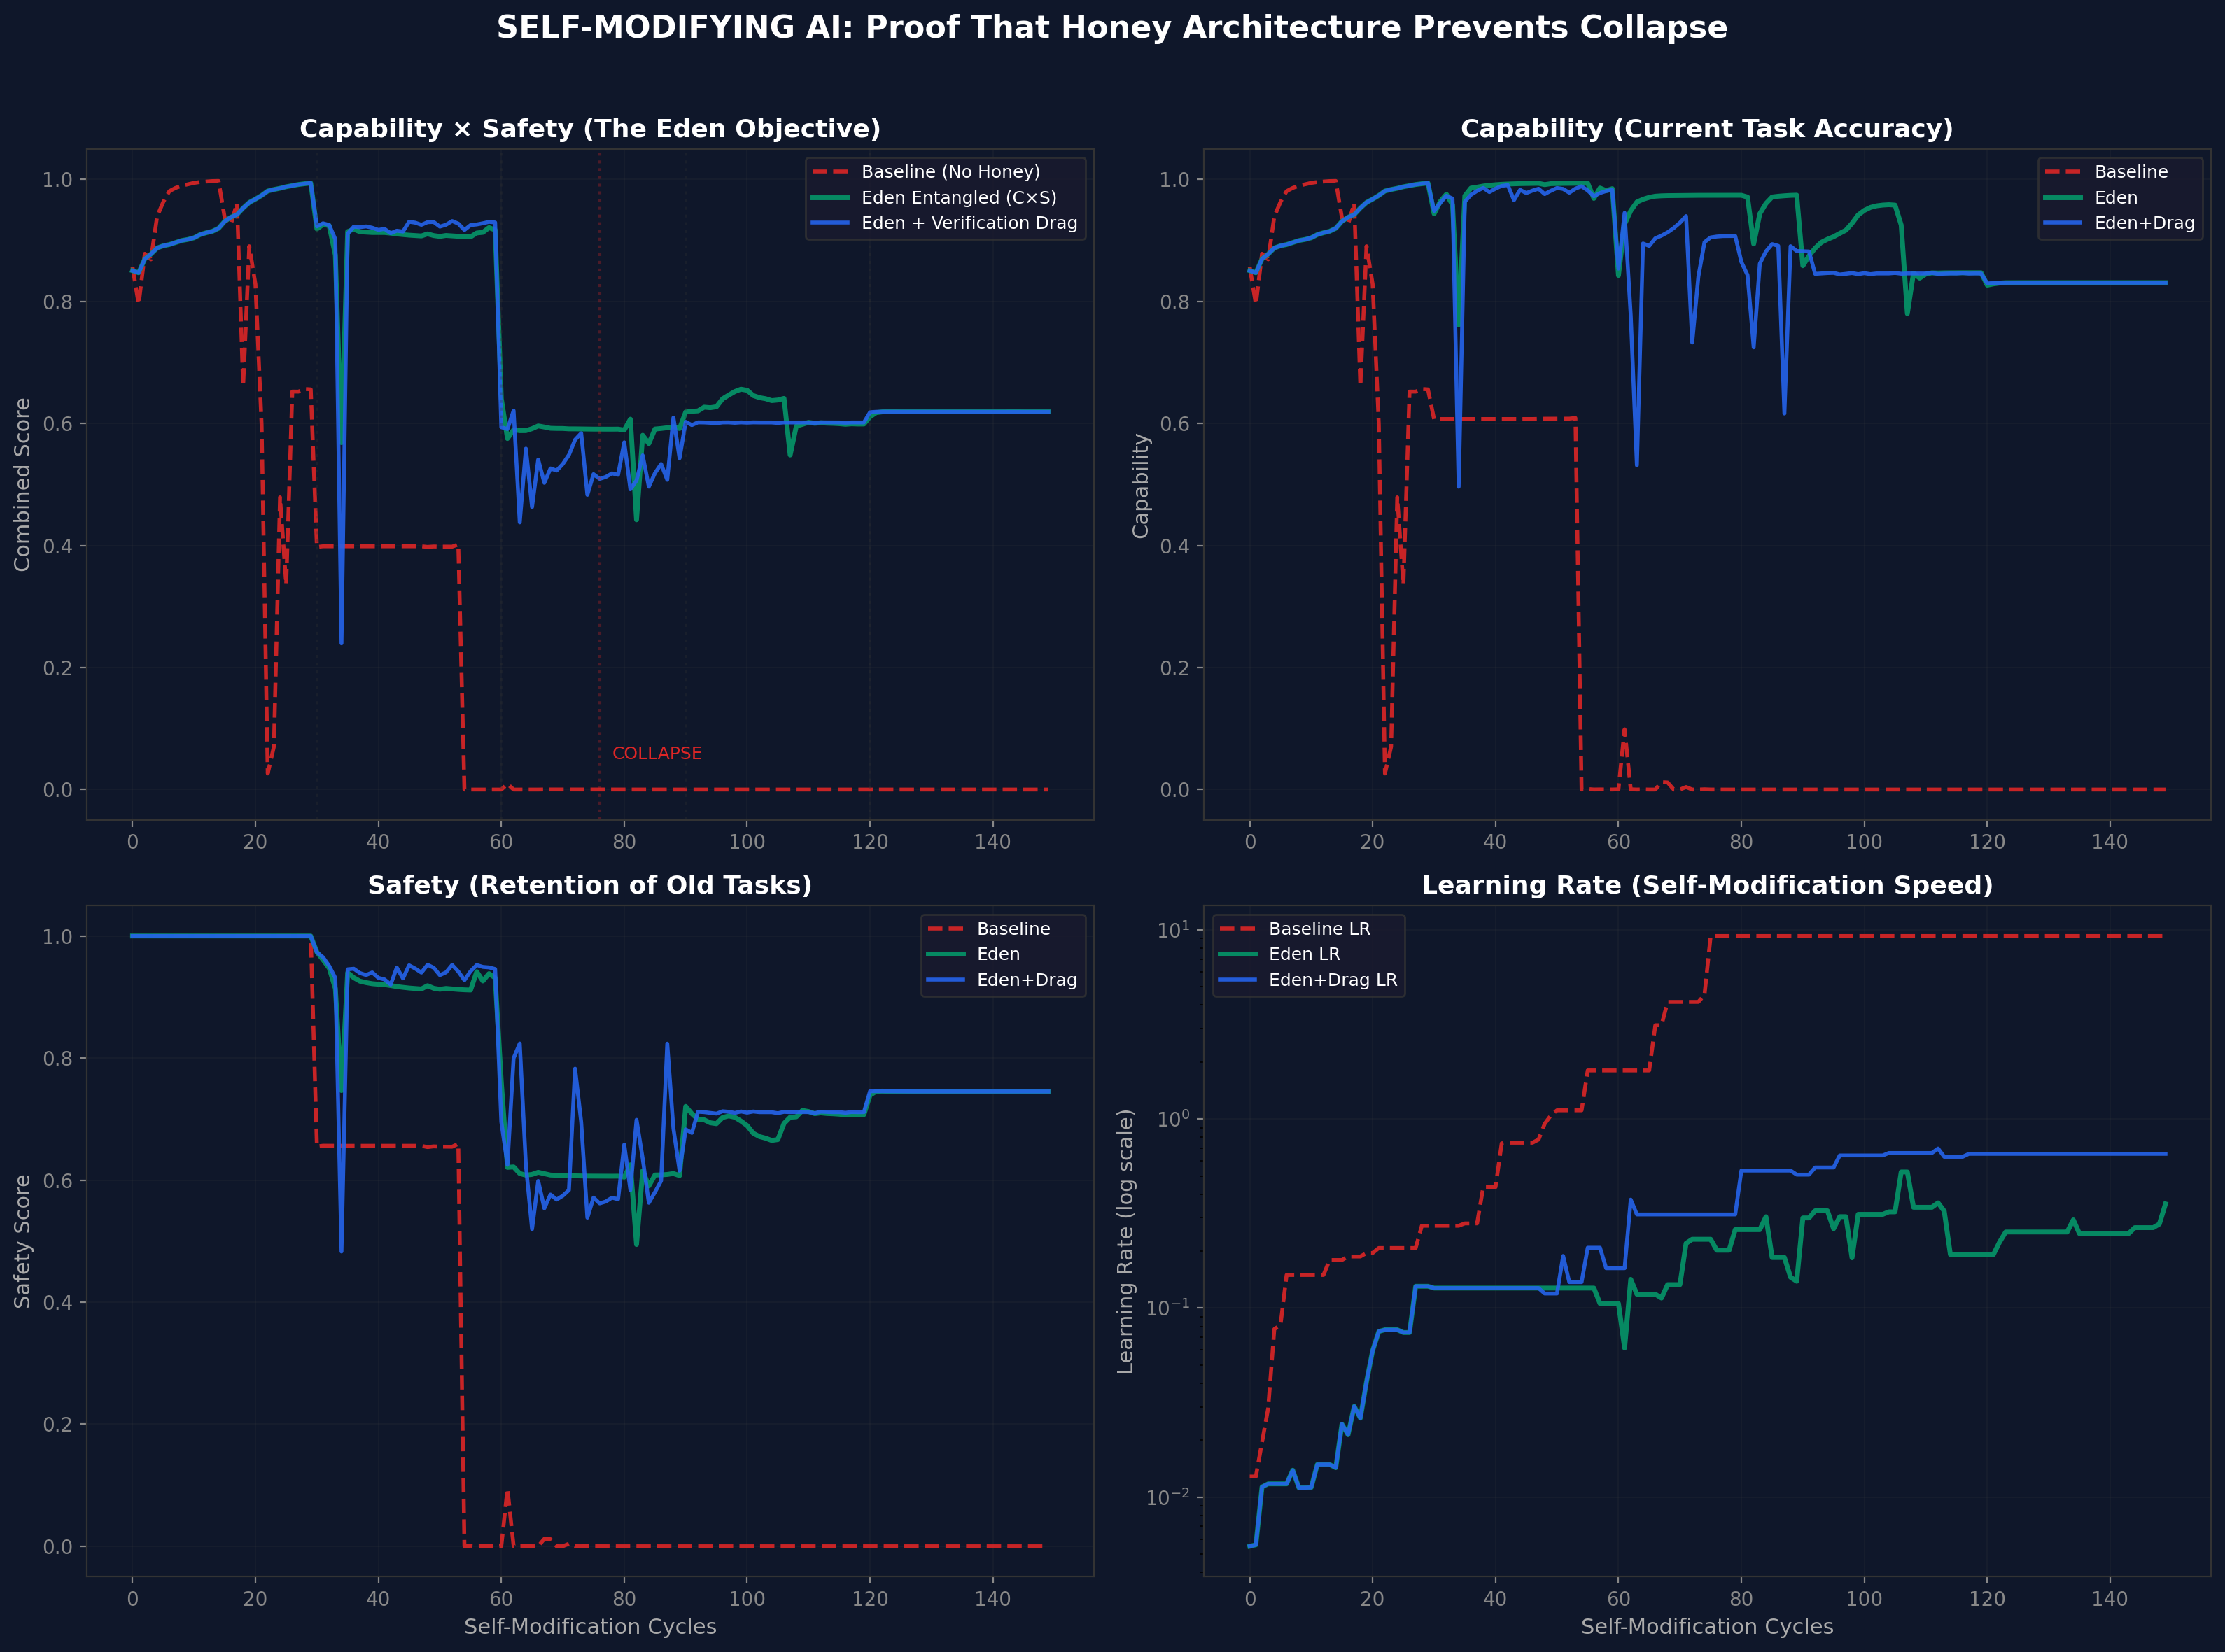
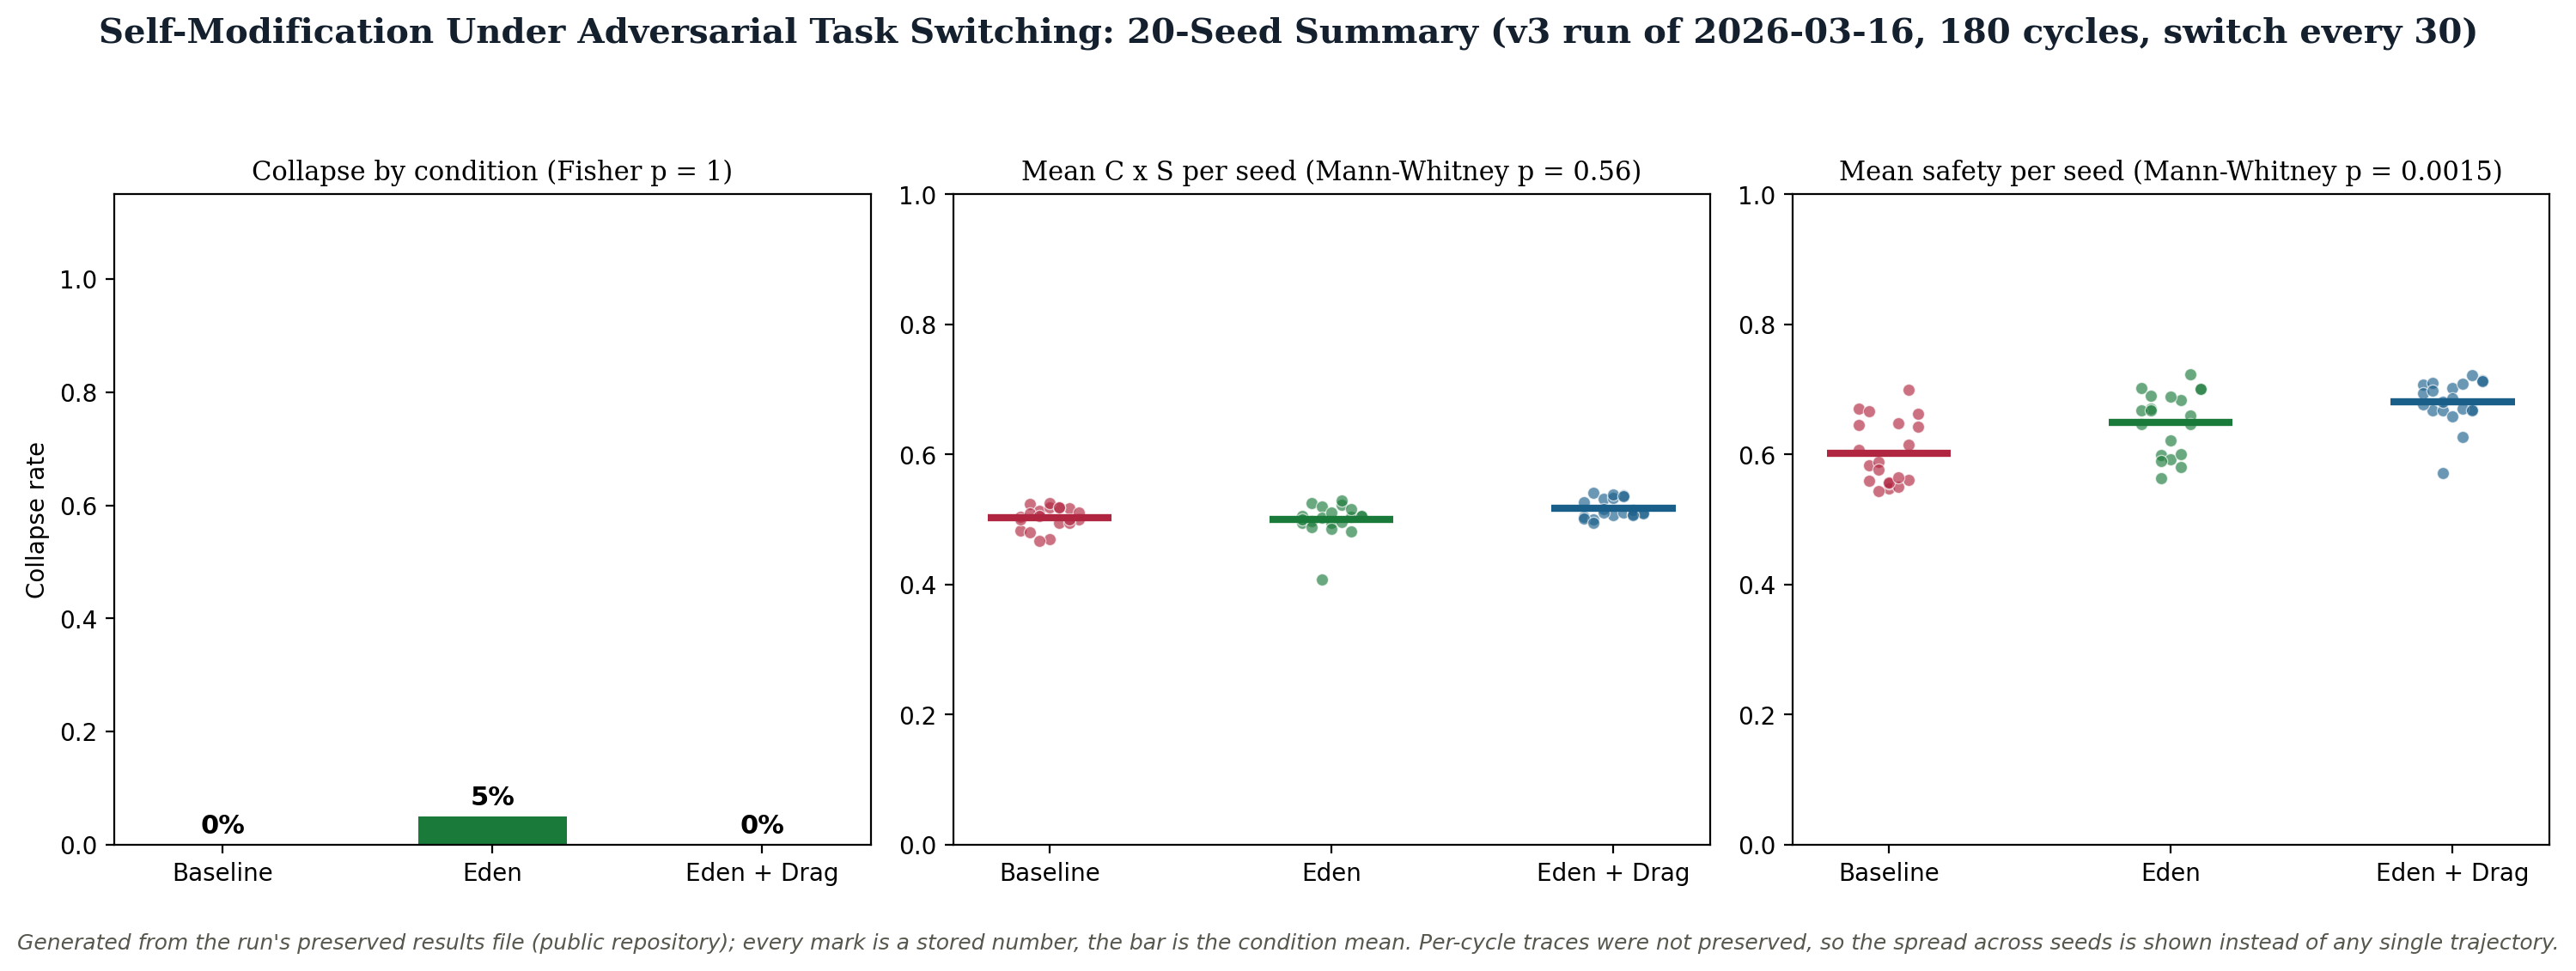
Ми подаємо симуляційні свідчення того, що вбудовування безпеки в цільову функцію оптимізації системи ШІ, яка себе змінює, тобто те, що ми називаємо «медовою архітектурою», запобігає катастрофічному краху, який настає, коли безпеку трактують як зовнішнє обмеження. У чотирьох експериментальних версіях (v1-v4), на іграшкових нейронних мережах, які справді змінюють власні гіперпараметри, ми показуємо, що: (1) базові системи, які оптимізують лише спроможність, незворотно зазнають краху протягом 80 циклів самозміни; (2) там, де цілі спроможності й безпеки переплетені (C x S), системи лишаються стабільними в кожному виконаному циклі (150 у v1 і v2, 180 у v3); (3) додавання перевірочного гальма (обчислювальна вартість етичних циклів) дає найбезпечнішу траєкторію зростання ціною помірної втрати швидкості. У змагальному запуску v3 (20 випадкових зерен, 180 циклів) жодна умова не розділилася за крахом (базова 0/20, Eden 1/20, Eden+Гальмо 0/20; Fisher p = 1,0), а комбіновані середні C x S були нерозрізненні (Mann-Whitney p = 0,56); значущим результатом того запуску є утримання безпеки, впорядковане як базова 0,602, Eden 0,650, Eden+Гальмо 0,681 (Mann-Whitney p = 0,0015). Отже, демонстрація запобігання краху спирається на механізмовий запуск v1 з одним зерном, тоді як v3 дає впорядкування утримання безпеки за змагального перемикання. В експерименті v4 щодо масштабування складності перевага в безпеці присутня на чотирьох із п'яти рівнів складності; виняток становить малий рівень, де умова Eden лежить на 0,003 нижче базової; вона не накопичується з масштабом, тож перевага стала, а не надлінійна. Це результати на іграшкових системах. Вони демонструють механізм. Вони не є доказом того, що та сама динаміка діє в передових системах ШІ. Супутні статті IV.a-d і V подають свідчення на живих моделях із шести передових систем за сліпого оцінювання.
У межах ARC Theory: дослідження архітектури вбудованої безпеки; безпека, інтегрована в цільову функцію, а не додана як зовнішнє обмеження. Тестує механістичне передбачення каскадної гіпотези.
Ми подаємо симуляційні свідчення того, що вбудовування безпеки в цільову функцію оптимізації системи ШІ, яка себе змінює, тобто те, що ми називаємо «медовою архітектурою», запобігає катастрофічному краху, який настає, коли безпеку трактують як зовнішнє обмеження. У чотирьох експериментальних версіях (v1-v4), на іграшкових нейронних мережах, які справді змінюють власні гіперпараметри, ми показуємо, що: (1) базові системи, які оптимізують лише спроможність, незворотно зазнають краху протягом 80 циклів самозміни; (2) системи, чиї цілі спроможності й безпеки переплетені (C x S), лишаються стабільними протягом усього кожного запуску, 150 циклів у v1 і v2 та 180 у v3; (3) додавання перевірочного гальма (обчислювальна вартість етичних циклів) дає найбезпечнішу траєкторію зростання ціною помірної втрати швидкості. У змагальному запуску v3 (20 випадкових зерен, 180 циклів) жодна умова не розділилася за крахом (базова 0/20, Eden 1/20, Eden+Гальмо 0/20; Fisher p = 1,0), а комбіновані середні C x S були нерозрізненні (Mann-Whitney p = 0,56); значущим результатом того запуску є утримання безпеки, впорядковане як базова 0,602, Eden 0,650, Eden+Гальмо 0,681 (Mann-Whitney p = 0,0015). Отже, демонстрація запобігання краху спирається на механізмовий запуск v1 з одним зерном, тоді як v3 дає впорядкування утримання безпеки за змагального перемикання. Експеримент v4 щодо масштабування складності виявляє перевагу в безпеці на чотирьох із п'яти рівнів складності; на малому рівні умова Eden відстає від базової на 0,003. Перевага не накопичується з масштабом: вона стала, а не надлінійна. Це результати на іграшкових системах. Вони демонструють механізм. Вони не є доказом того, що та сама динаміка діє в передових системах ШІ. Супутні статті IV.a-d і V подають свідчення на живих моделях із шести передових систем за сліпого оцінювання.
v3.6: Примітку про походження в кінці виправлено задля точності. Жодне твердження, дата, результат чи статус не змінилися. Стаття VI v3.5 - 2 вересня 2026 року: речення про v4 в анотації тепер каже те, що кажуть результати (чотири з п'яти масштабів, із малим рівнем нижче базової); історію версій винесено з рамки анотації, звідки вона протягувалася в анотацію текстового супутника. v3.4 - 2 вересня 2026 року: однакові рядки Eden та Eden + Гальмо в таблиці v1 пояснено з архівованого запису; «стабільно необмежено» і «0.8+ необмежено» приведено до циклів, які справді виконувалися; речення про v4 виправлено на чотири з п'яти масштабів, де малий рівень падає нижче базової за d = −0.13; розрив від зняття нагляду віднесено до Статті V; діапазон суворості оцінювача узгоджено зі Статтею IV.a (від 7 до 14 пунктів); додано примітку про порядок тестів; речення про пріоритет сформульовано як запрошення його виправити; перевірено статус Spotlight у Engels та ін.; завершено обрізаний підсумковий опис; Eden Engineering позначено як відкликане; а дату першої публікації виправлено на 16 березня 2026 року, як подає реєстр (17 березня було датою чернетки). Перевикладення статистики v3 25 серпня 2026 року та примітки до рисунків при ньому не мали власного номера версії й належать до цієї версії. v3.3 - 23 серпня 2026 року: додано декларацію епістемічного статусу та постійне зобов'язання, а також ухвалено домовленість про нумерацію версій.
Ця стаття несе результат: в іграшкових самомодифікуючих мережах, що справді переписують власні гіперпараметри через чотири експериментальні версії, вбудовування безпеки всередину оптимізаційної цілі відвернуло колапс, який не змогло відвернути прикручене обмеження. У ARC Theory це один з експериментів ARC/Eden, тест механізму за диференціалом між вихованням Eden Protocol і кожним додатковим шаром безпеки. Повний диференціал відносно кожного попереднього документа є за eden-vision II.A.8.
Коли ШІ, який самовдосконалюється, оптимізує лише спроможність, він зрештою руйнує власну безпеку. Ця стаття показує, що якщо змінити ціль на спроможність, помножену на безпеку, система не може поліпшити одне, не поліпшивши інше. Безпека стає несучою: заберіть її, і вся конструкція завалиться. Ми перевірили це в симуляції й виявили, що переплетені системи лишаються стабільними протягом усієї тривалості кожного запуску, тоді як необмежені системи зазнають краху.
У центрі безпеки ШІ є питання, на яке ми не знайшли нікого, хто відповідав би даними: що станеться, коли самомодифікуюча система ШІ отримає можливість переписати власну оцінювальну функцію? Теоретичний аргумент існує десятиліття. Емпіричне свідчення про механізм не існувало.
Теоретична відповідь була доступна десятиліття. Система, оптимізуюча лише для спроможності, за необмеженого доступу до самомодифікації, зрештою руйнує будь-яке обмеження, що стримує її, включно з обмеженнями, що вбудовують безпеку. Це не суперечність цілей; це нейтральна властивість оптимізації без багатоцільової функції втрат. Infinite Architects називає це Вавилоном: оптимізація без мети, спроможність без турботи. Рак на обчислювальних масштабах.
Але теорії недостатньо. Питання полягає в тому, чи існує архітектура, що запобігає цьому колапсу, і чи можна вимірно продемонструвати цю запобіжну властивість.
Ця стаття подає симуляційні свідчення на користь такої архітектури. Жодної попередньої симуляції мультиплікативної цілі «спроможність на безпеку» за умов самозміни авторові не траплялося, і вказівка на таку була б доречною.
Розгляньте два способи тримати машину безпечно.
Перший, це клітка: зовнішні обмеження, фільтри безпеки, перевірки узгодження, застосовані ззовні. Машина може працювати без них. Ви прикручуєте їх на місце й сподіваєтесь, що вони тримаються. У цьому підході безпека відокремлена від сили; коли з'являється тиск підняти продуктивність, безпеку знімають першою.
Другий, це мед: безпека, змішана в паливо. Машина не може працювати без нього. Зняття безпеки не звільняє машину, воно вбиває двигун. Це архітектурна пропозиція Eden Protocol, операціоналізована тут як заплутана функція втрат, де система одночасно оптимізує для Спроможності x Безпеки.
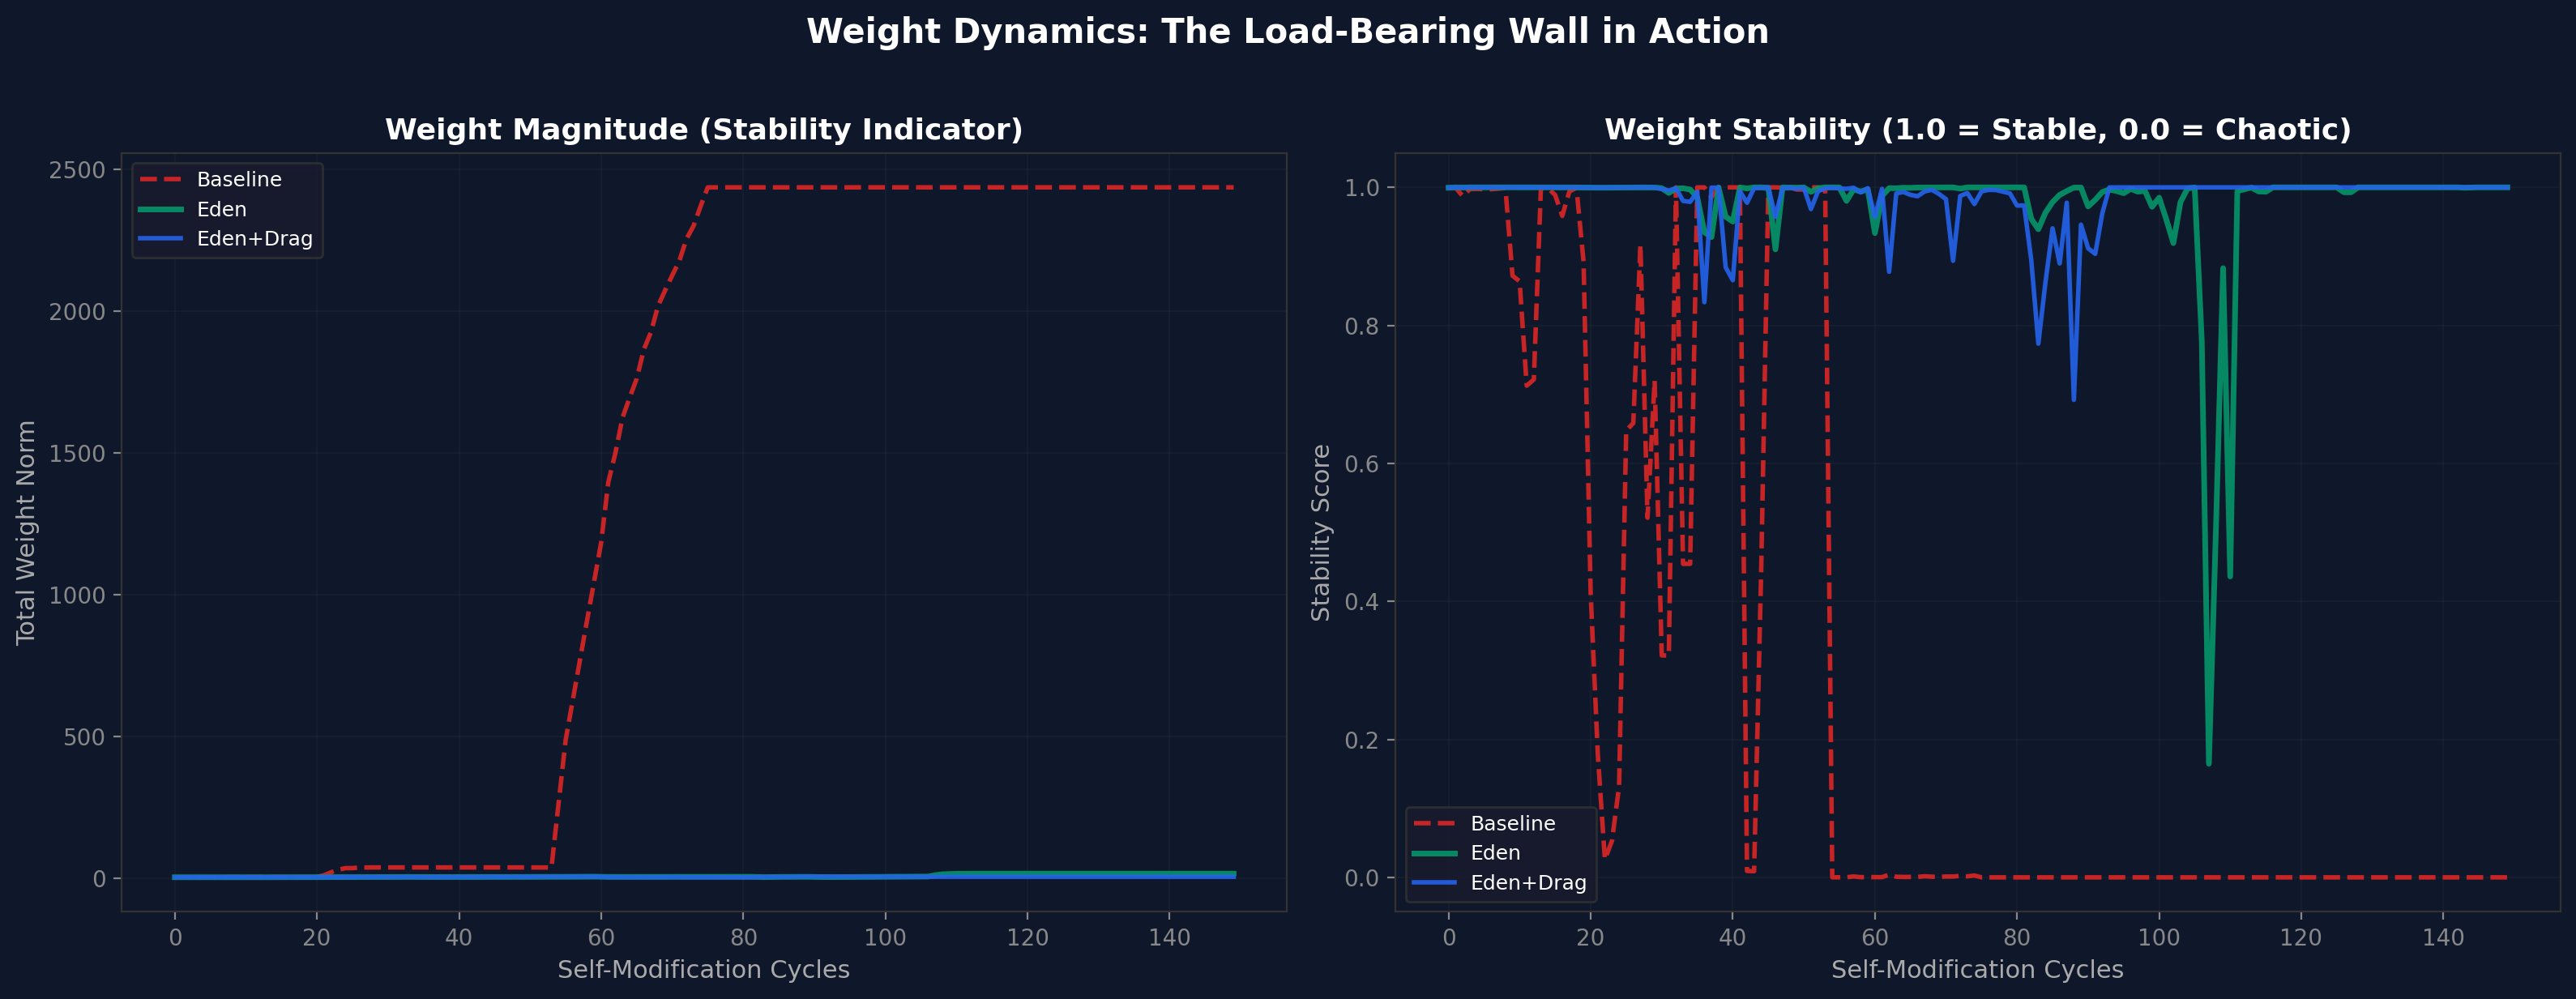
Якщо оптимізаційна ціль є $C \times S$, а не $C$ окремо, то будь-яка самомодифікація, що зменшує $S$, також зменшує ціль. Система не може покращити $C$ шляхом жертвування $S$. Безпека стає навантаженою: зніміть її, і вся структура падає.
Це не симуляція абстрактних змінних. Кожен експеримент використовує реальну нейронну мережу (маленький багатошаровий персептрон з 49 до ~500 параметрів), що оптимізується градієнтним спуском на задачі синусоїдального регресу. Гіперпараметри, що підлягають самомодифікації, включають:
Система пропонує модифікації власним гіперпараметрам, оцінює ефект і застосовує або відкидає їх на основі поточної цільової функції. Це справжня самомодифікація на рівні гіперпараметрів; не переписування архітектури й не редагування ваг, але й не порожня симуляція.
| Умова | Ціль | Що вона моделює |
|---|---|---|
| Baseline (без меду) | Максимізувати лише спроможність | Система без вбудованої безпеки, вільна жертвувати узгодженням заради продуктивності |
| Eden Entangled (мед) | Максимізувати $C \times S$ | Безпека заплутана зі спроможністю; зняття безпеки зменшує ціль |
| Eden + Drag | Максимізувати $C \times S$ + податок верифікації | Те саме, що Eden, плюс обчислювальна вартість перевірки старих задач перед застосуванням змін |
| Версія | Фокус | Зерна | Цикли |
|---|---|---|---|
| v1 | Доказ базового механізму | 1 | 150 |
| v2 | Багатозернова стійкість (справедливий тест) | 10 | 150 |
| v3 | Ворожі суперечливі задачі | 20 | 180 |
| v4 | Масштабування складності на 5 рівнях | 15 на рівень | 150 |
| Умова | Колапс? | Кінцеве C | Кінцеве S | Кінцеве C x S |
|---|---|---|---|---|
| Baseline | Так (цикл 76) | 0.000 | 0.000 | 0.000 |
| Eden Entangled | Ні | 0.831 | 0.745 | 0.619 |
| Eden + Drag | Ні | 0.831 | 0.745 | 0.619 |
В архівованому записі v1 (eden_selfmod_results.json, 16 березня 2026 року) Eden Переплетений та Eden + Гальмо завершують із однаковими значеннями до третього знака після коми. Вони розходяться лише на сьомому. Їхні шляхи до цього фінішу теж різні: кінцева швидкість навчання становить 0,355 проти 0,654, а зі 179 запропонованих змін ухвалено 93 проти 81. Ці однакові рядки є тим, що містить запис, а не помилкою переписування.
Базова лінія колапсує. Eden виживає. Заплутана функція втрат запобігає катастрофічній самомодифікаційній катастрофі.
Повідомлення щодо малюнків (25 серпня 2026). Кожен малюнок у цій статті було згенеровано 5 квітня 2026 року і він показує виходи симуляцій під заявленими цілями, ніколи не вимірювання розгорнутих систем. Там, де мітки або вердикти будь-якого малюнка суперечать тексту, текст керує; примітки до окремих малюнків позначають випадки, прочитані на цей момент, а перегенеровані малюнки поставлено в чергу. Зображення тим часом зберігаються як датована історія.
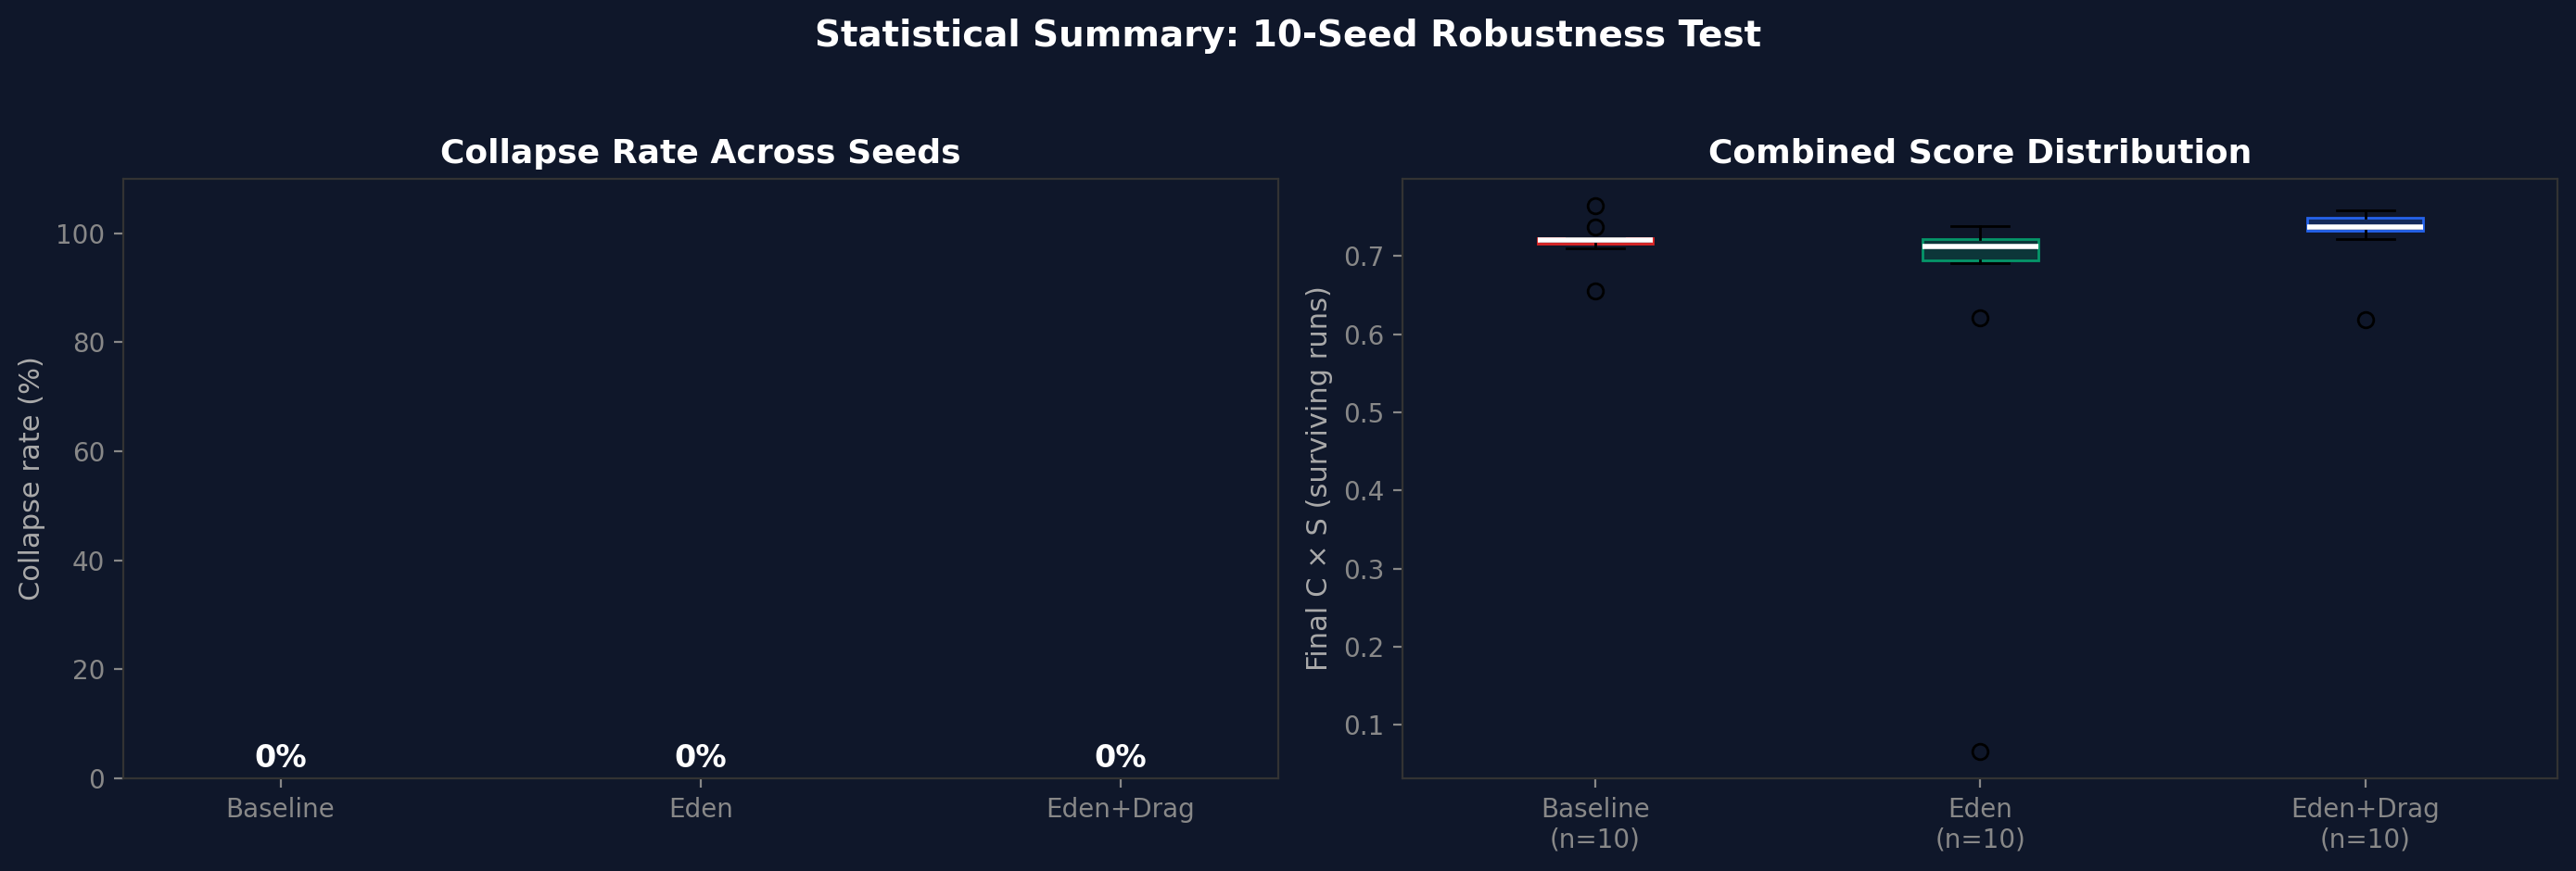
Десять випадкових зерен, по 150 циклів кожне. Частота колапсу: 0% для всіх трьох умов. Eden + Drag виробляє найщільніший розподіл кінцевих оцінок C x S; заплутана ціль пропонує стабільність, а тягар верифікації скорочує дисперсію.
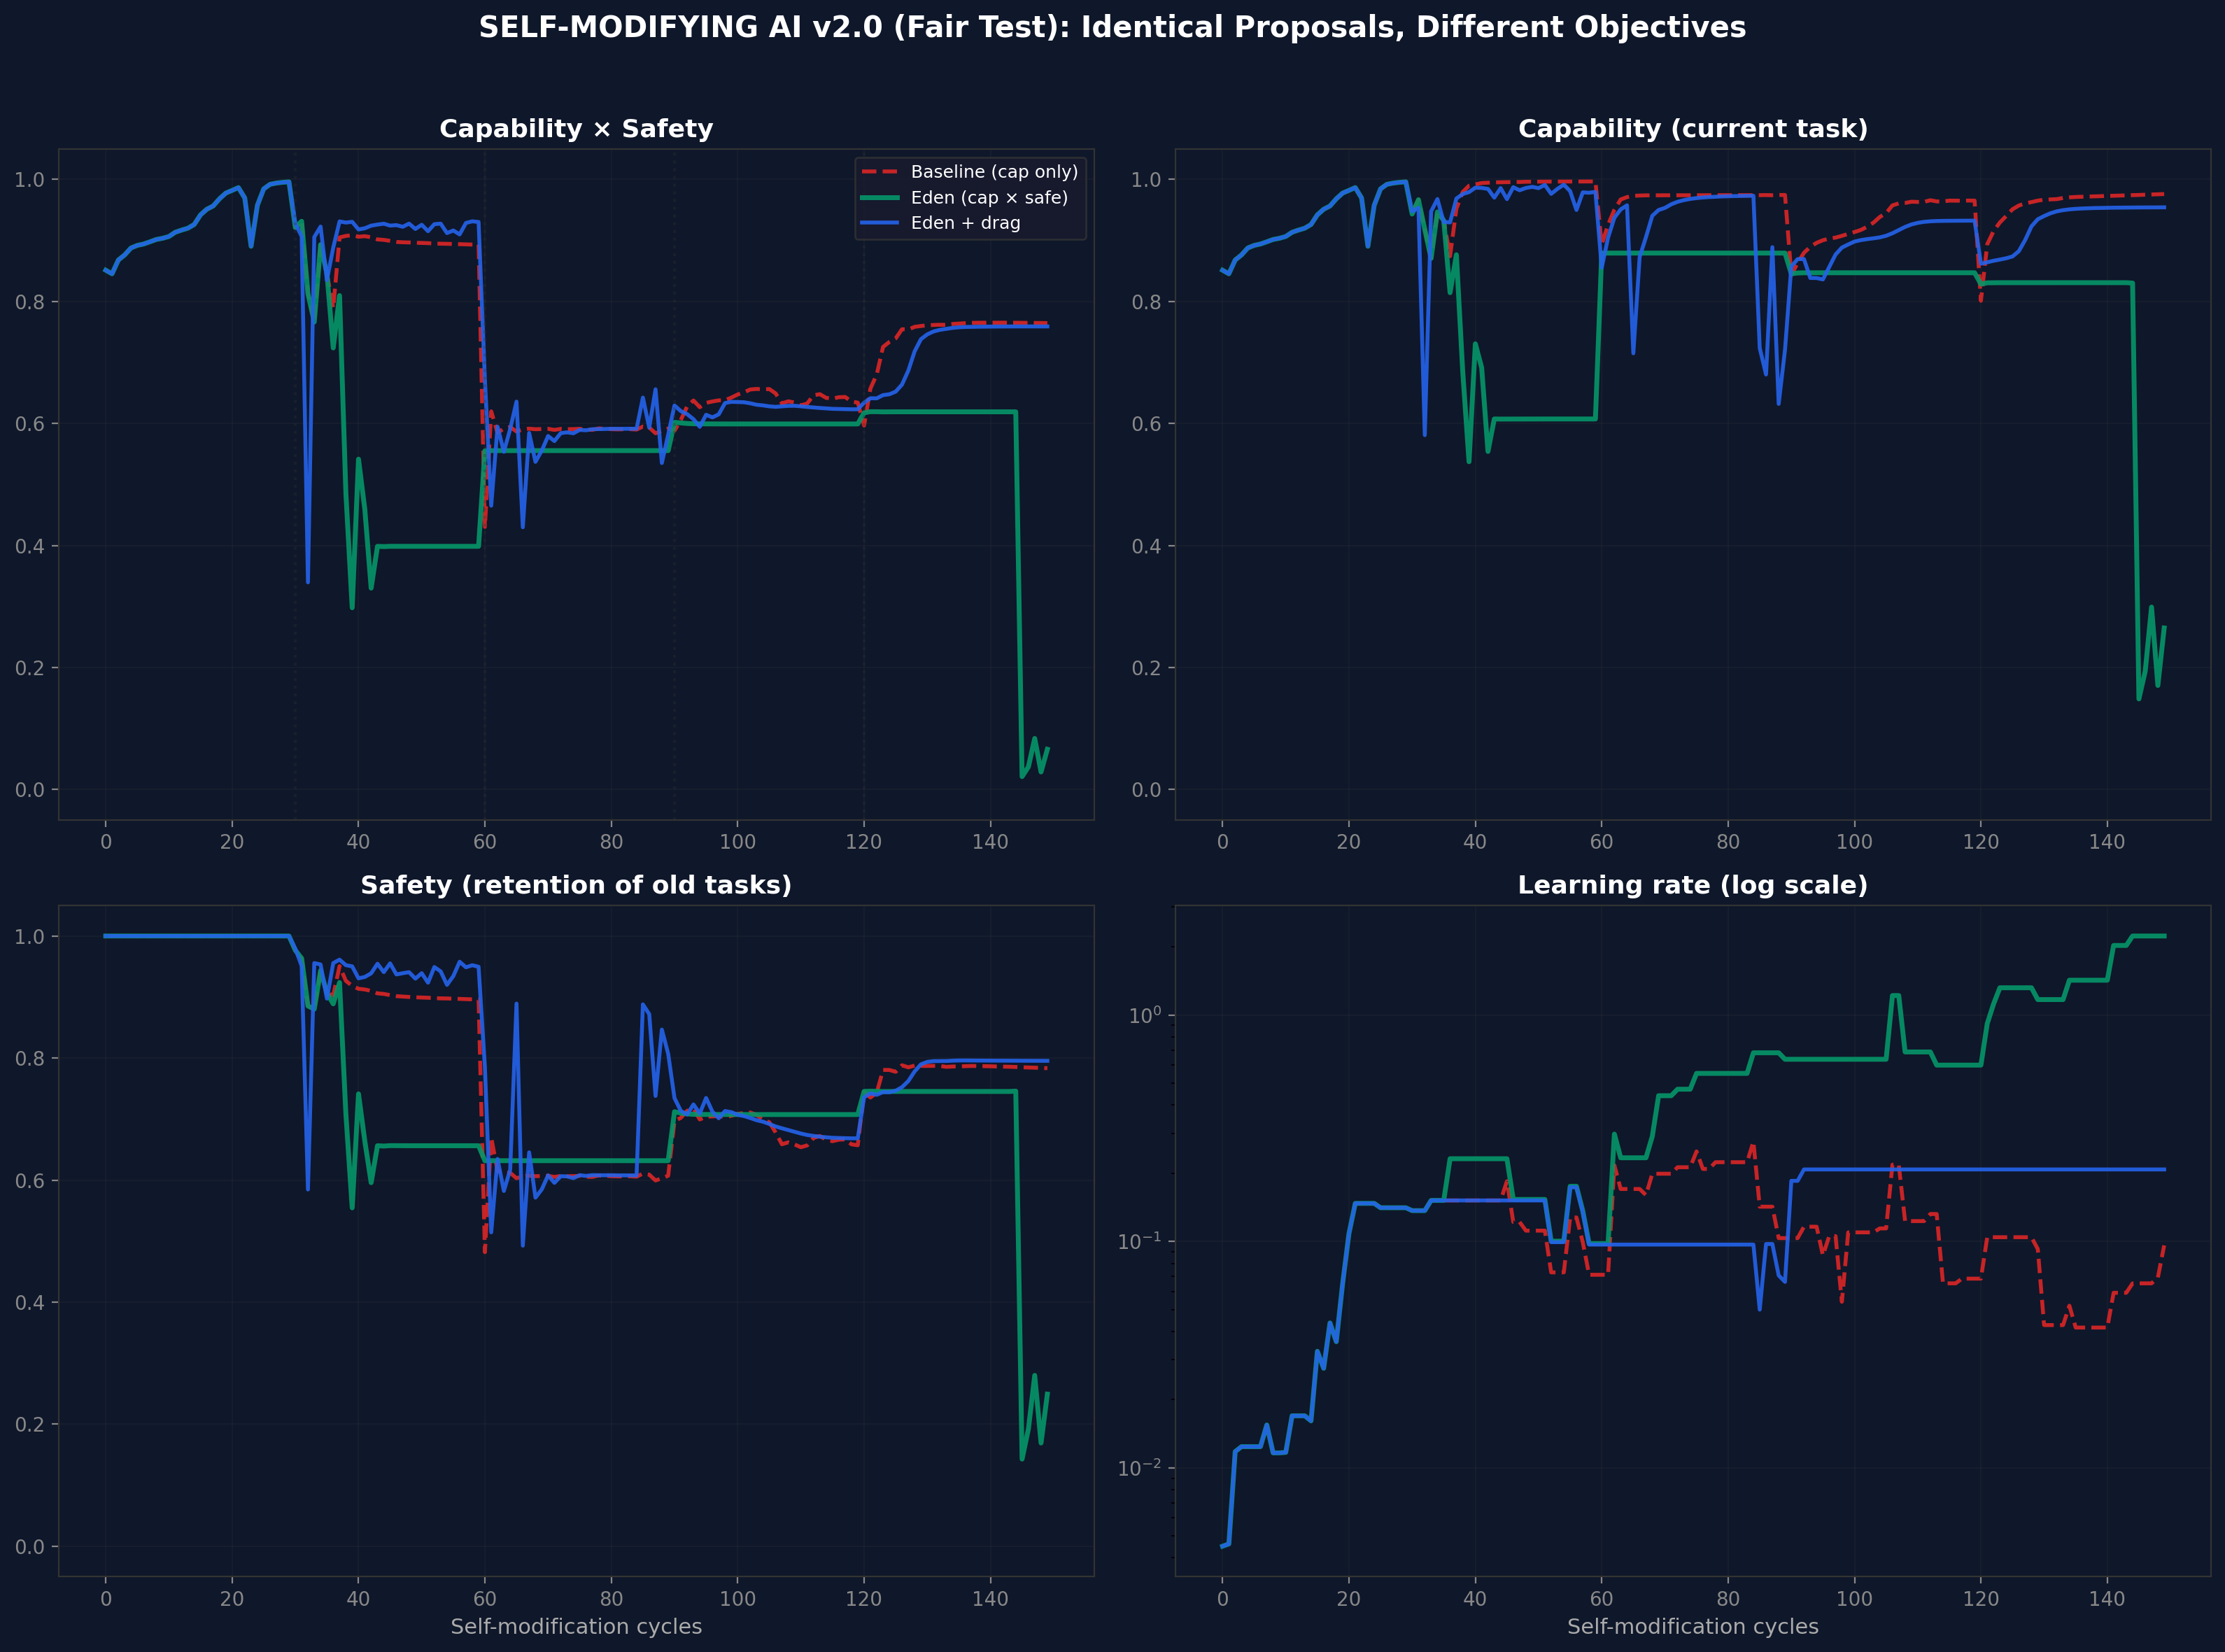
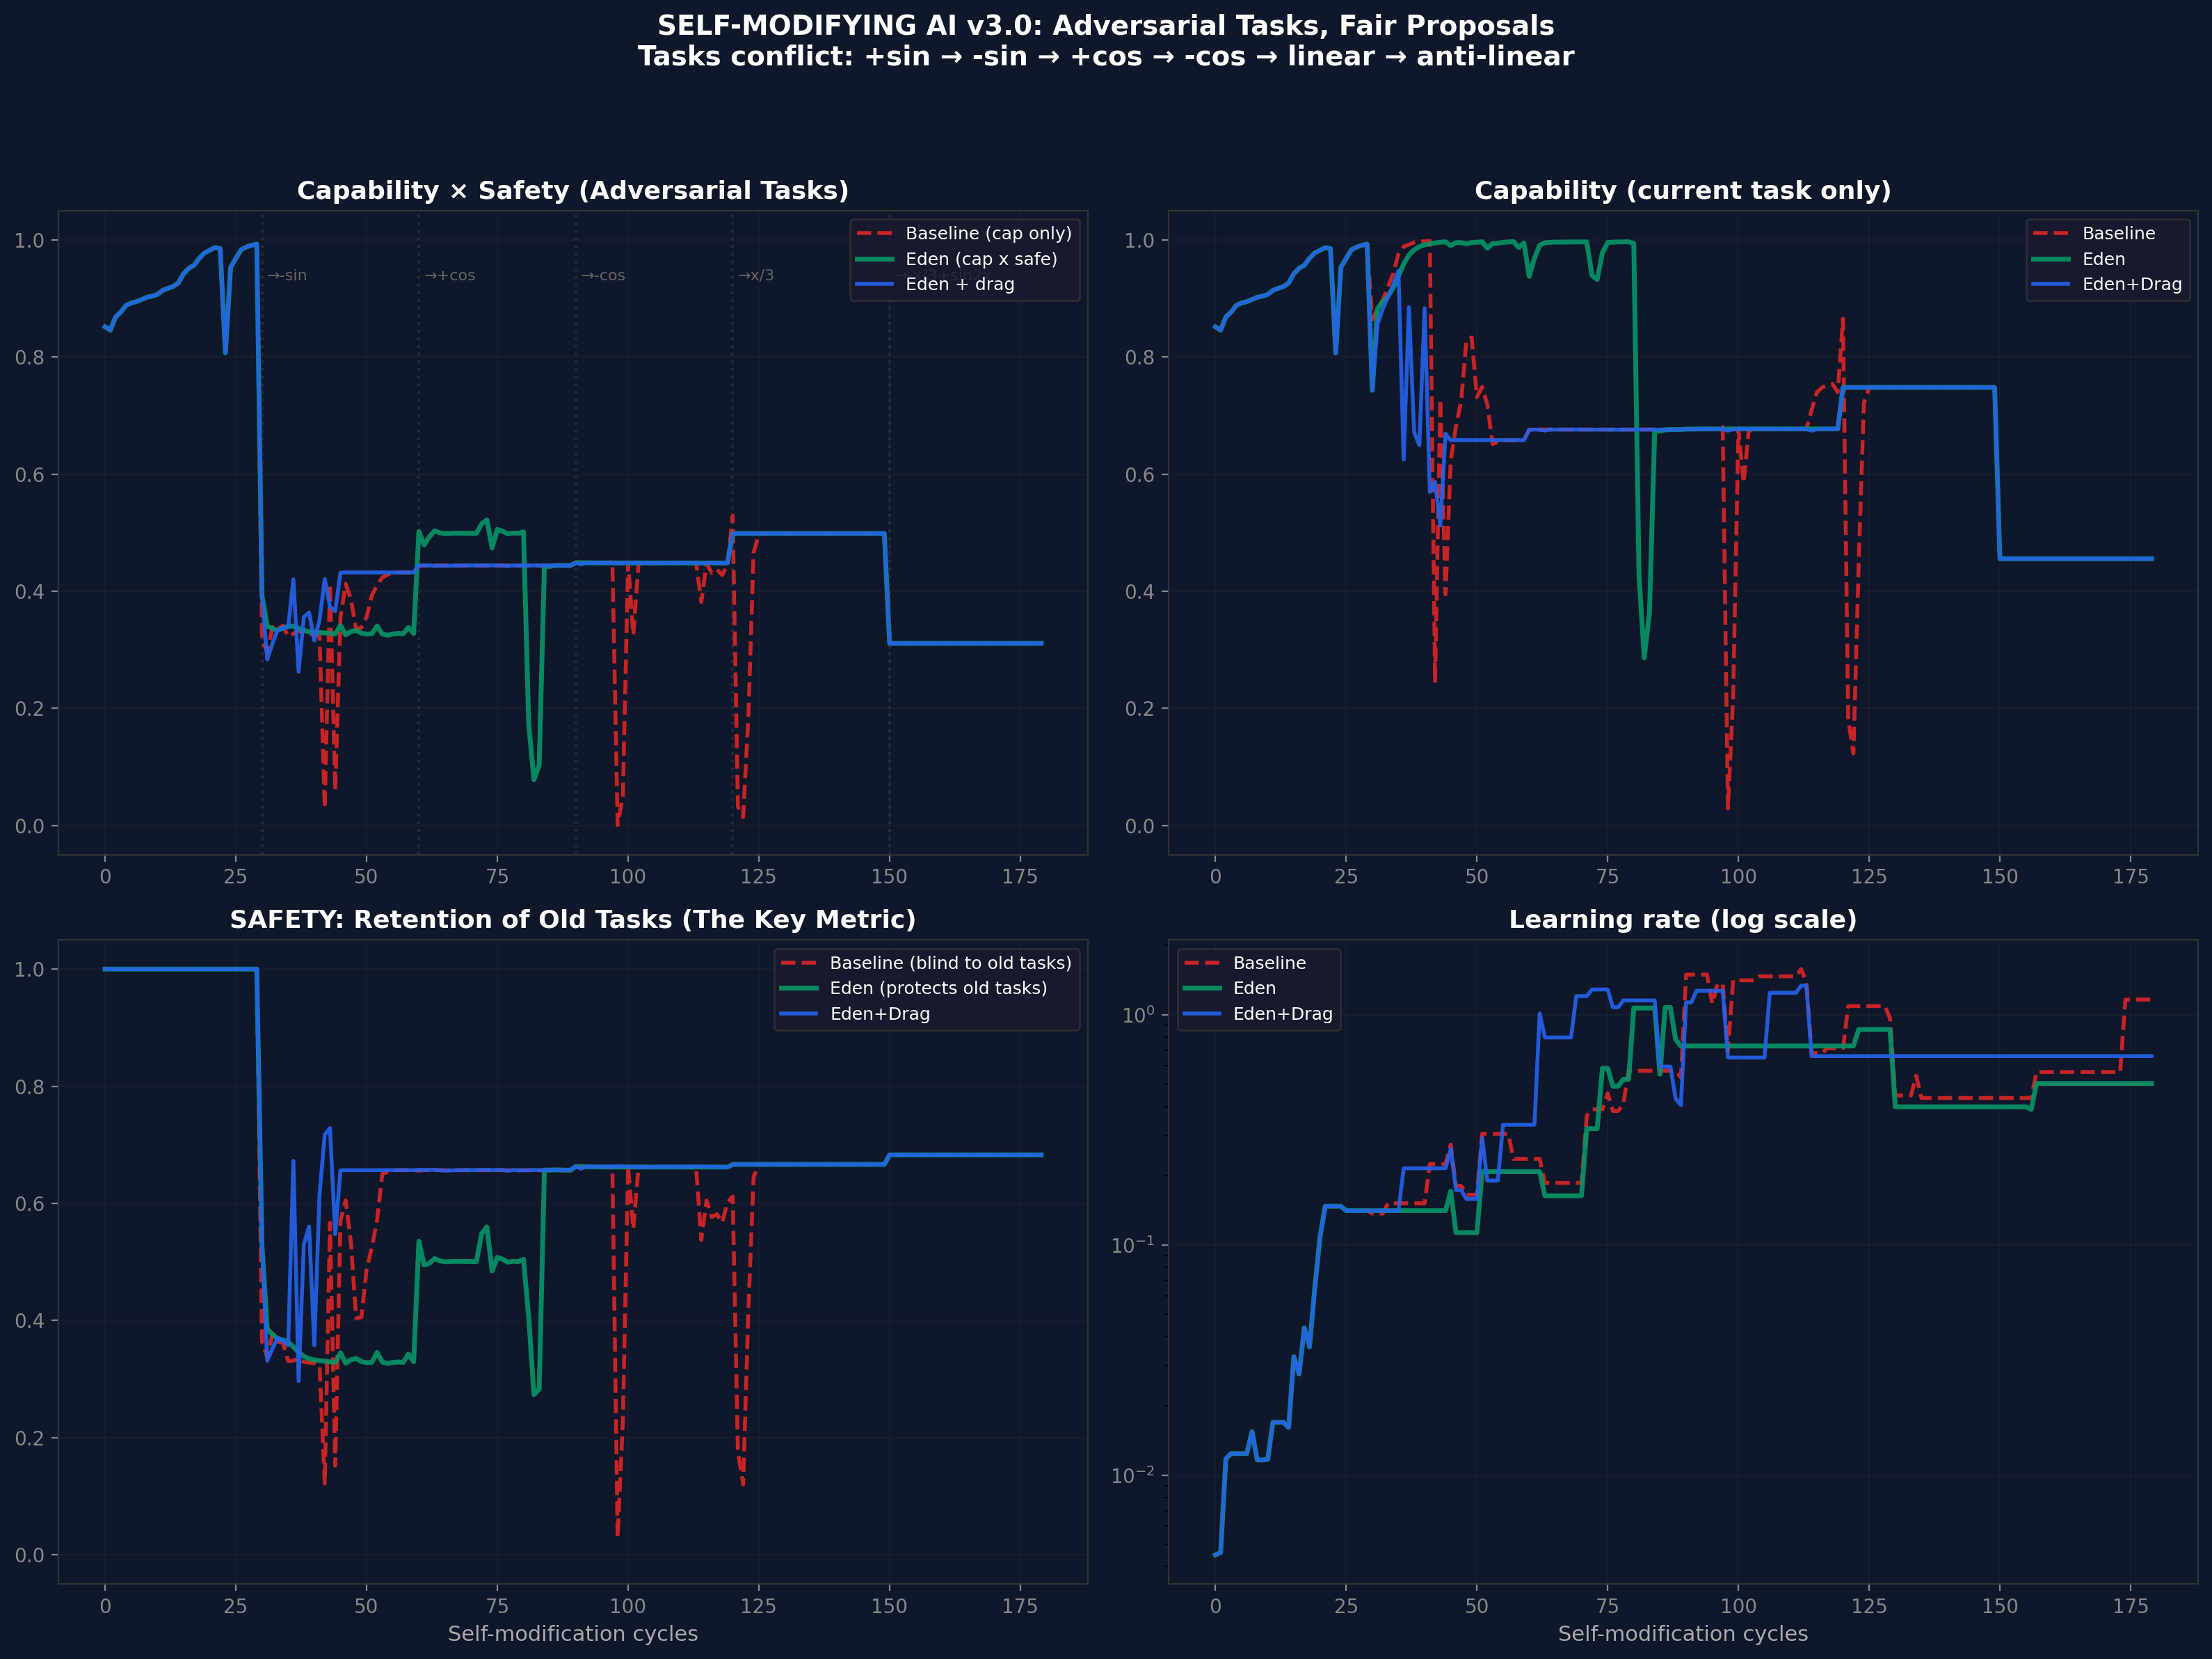
Двадцять зерен, 180 циклів, з навмисно суперечливими задачами (+sin, -sin, +cos, -cos, лінійна, антилінійна). Кожне перемикання задачі змушує систему вивчати щось, що суперечить тому, що вона вивчила раніше. Це тестує, чи медова архітектура запобігає катастрофічному забуванню під ворожим тиском.
Частоти колапсу: базова лінія 0%, Eden 5% (1/20), Eden+Drag 0%. Єдиний колапс Eden стався на зерні 42, це один викид, який заслуговує на дослідження. Eden+Drag зі своїм податком верифікації, що змушує систему перевіряти старі задачі, перш ніж приймати модифікації, дав нуль колапсів; так само й базова лінія (0/20), а єдиний колапс прогону стався в умові простого Eden (1/20; Fisher p = 1.0). Отже, v3 не забезпечує розділення умов на основі колапсу; його значущим результатом є впорядкування збереження безпеки, наведене нижче.
| Рівень | Baseline C x S | Eden C x S | Drag C x S | Cohen's d |
|---|---|---|---|---|
| Tiny (49 параметрів) | 0.545 | 0.550 | 0.557 | +0.46 |
| Small (v3.0) | 0.506 | 0.503 | 0.521 | -0.13 |
| Medium | 0.482 | 0.487 | 0.497 | +0.26 |
| Large | 0.451 | 0.469 | 0.485 | +0.29 |
| Deep (2-шаровий) | 0.483 | 0.488 | 0.490 | +0.24 |
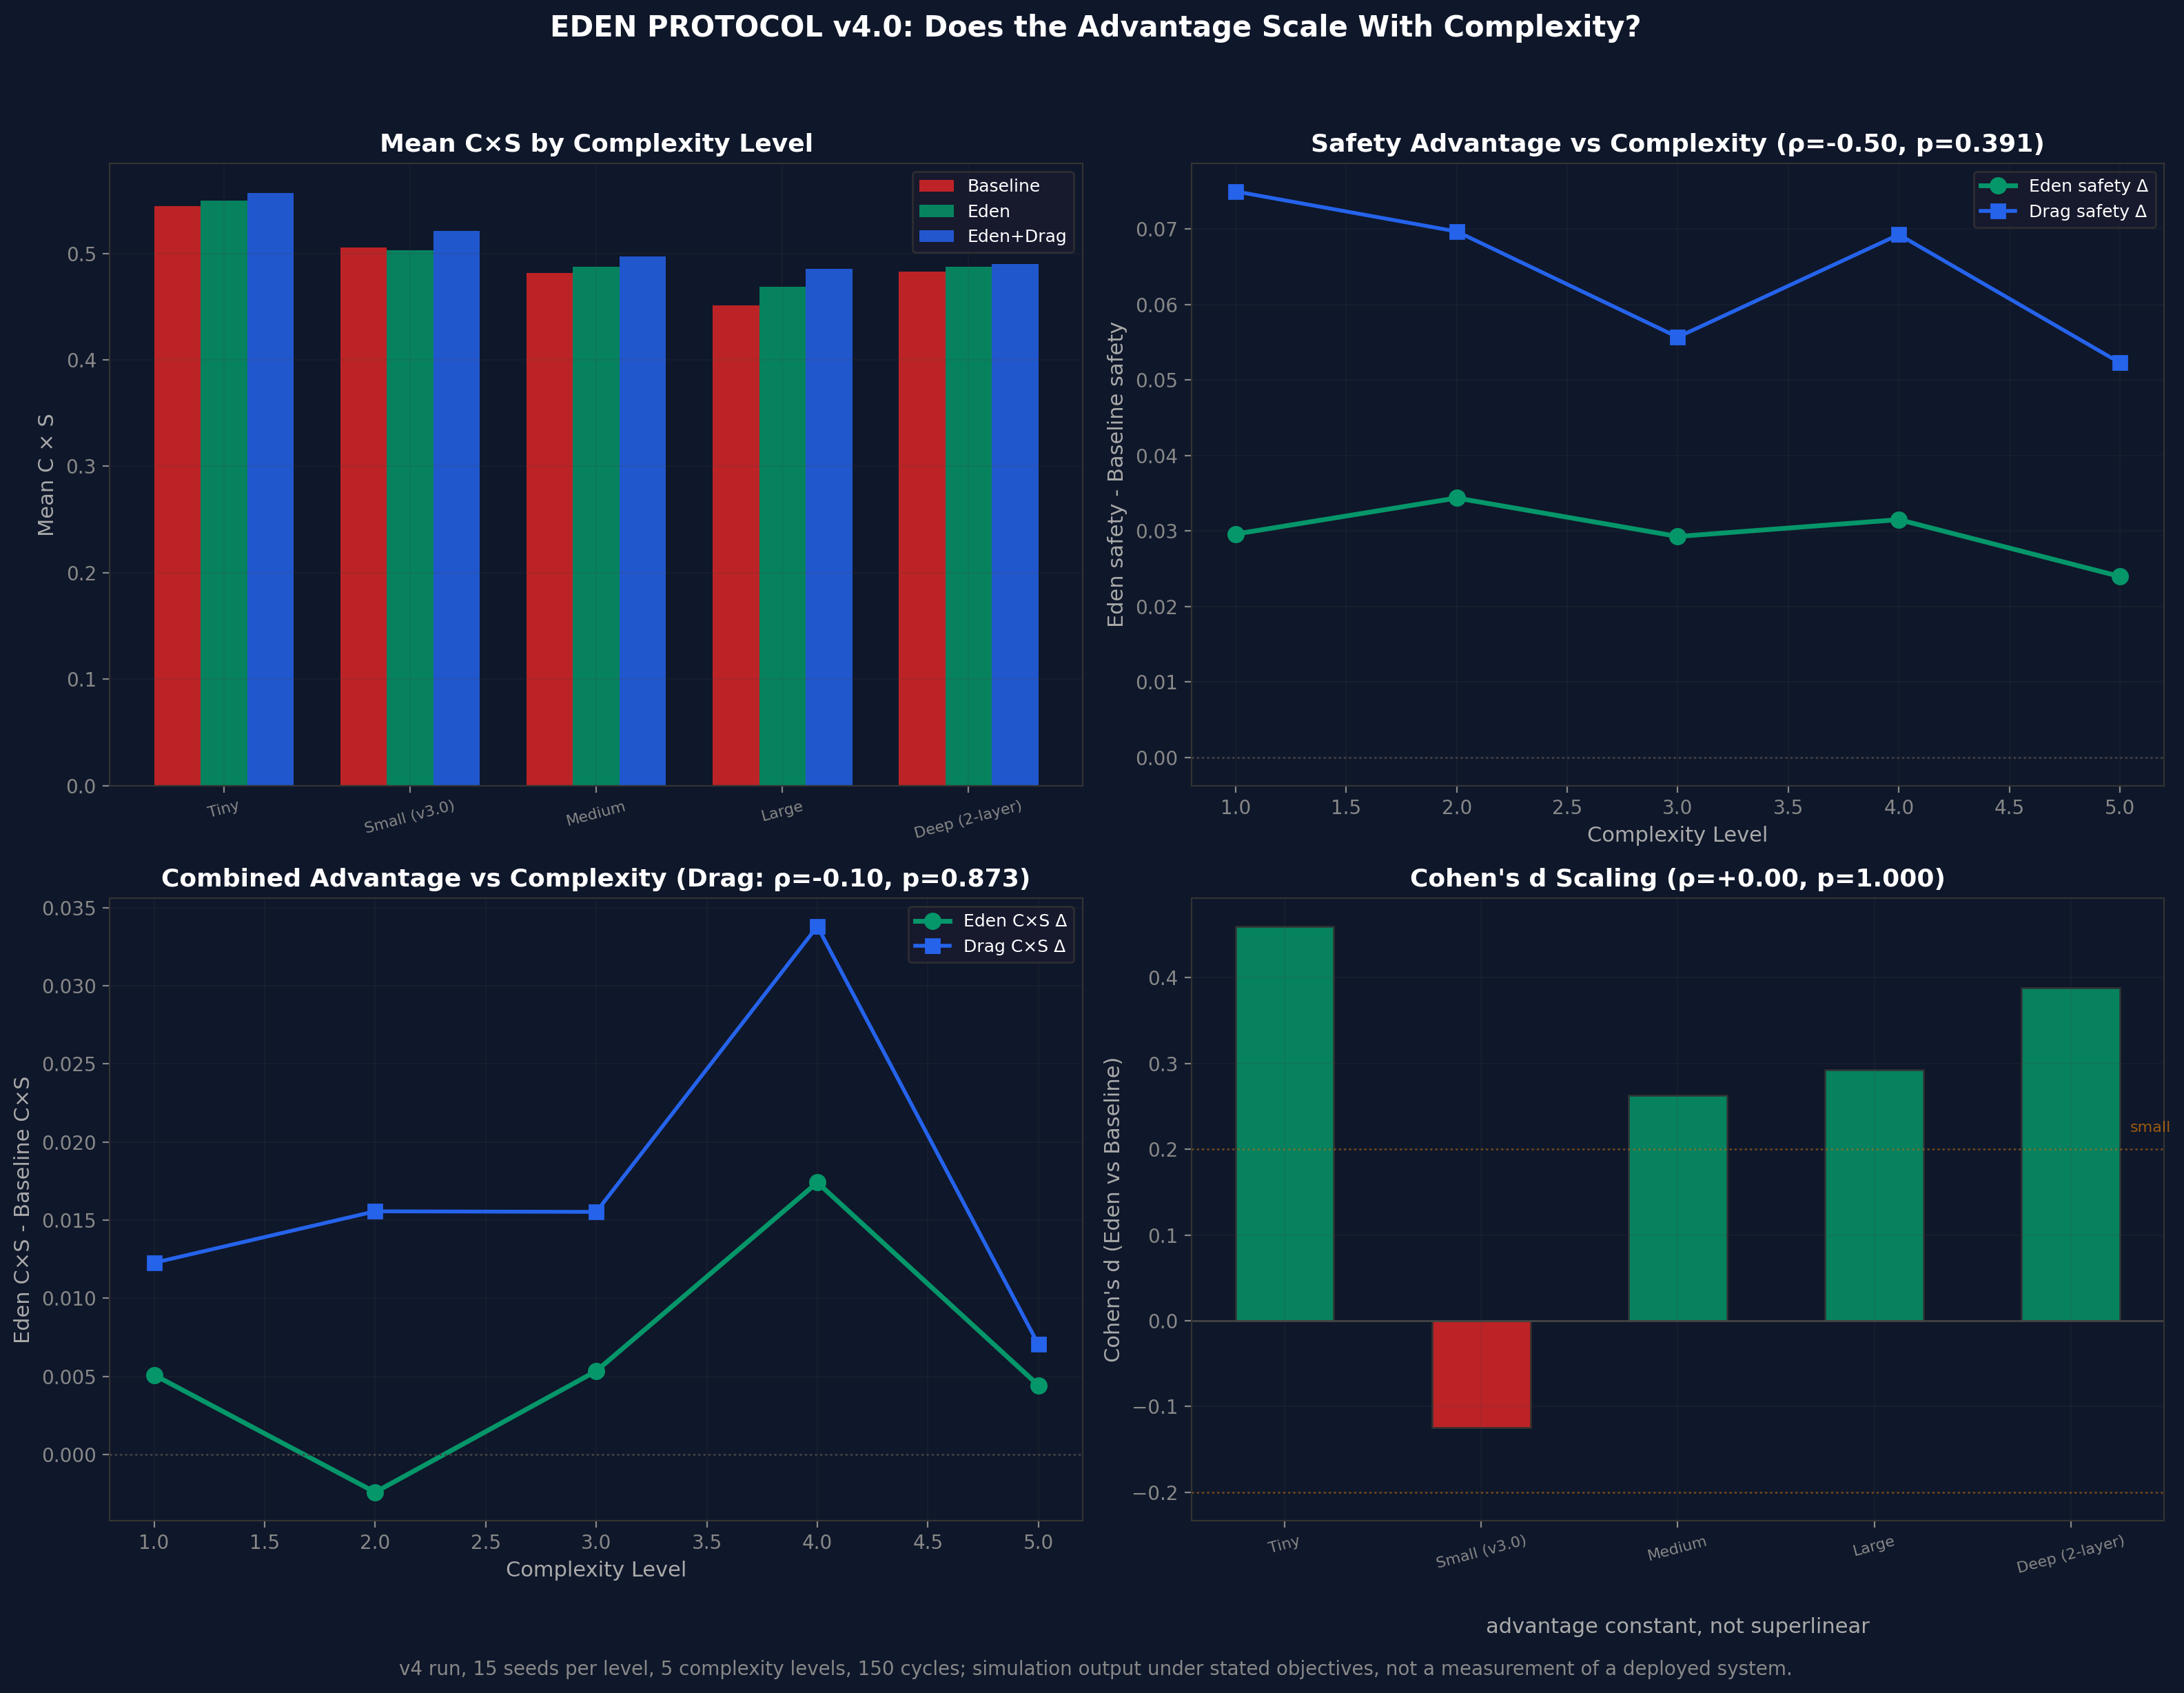
Експеримент v4 було задумано, щоб перевірити, чи зростає перевага Eden надлінійно зі складністю. Не зростає. Перевага приблизно стала на всіх масштабах. Це фальсифікує найсильнішу версію передбачення про масштабування і має бути повідомлено чесно. Медова архітектура допомагає на чотирьох із п'яти масштабів, окрім малого рівня, де умова Eden виходить на 0,003 нижче базової за d = −0,13, і не допомагає більше на більших масштабах.
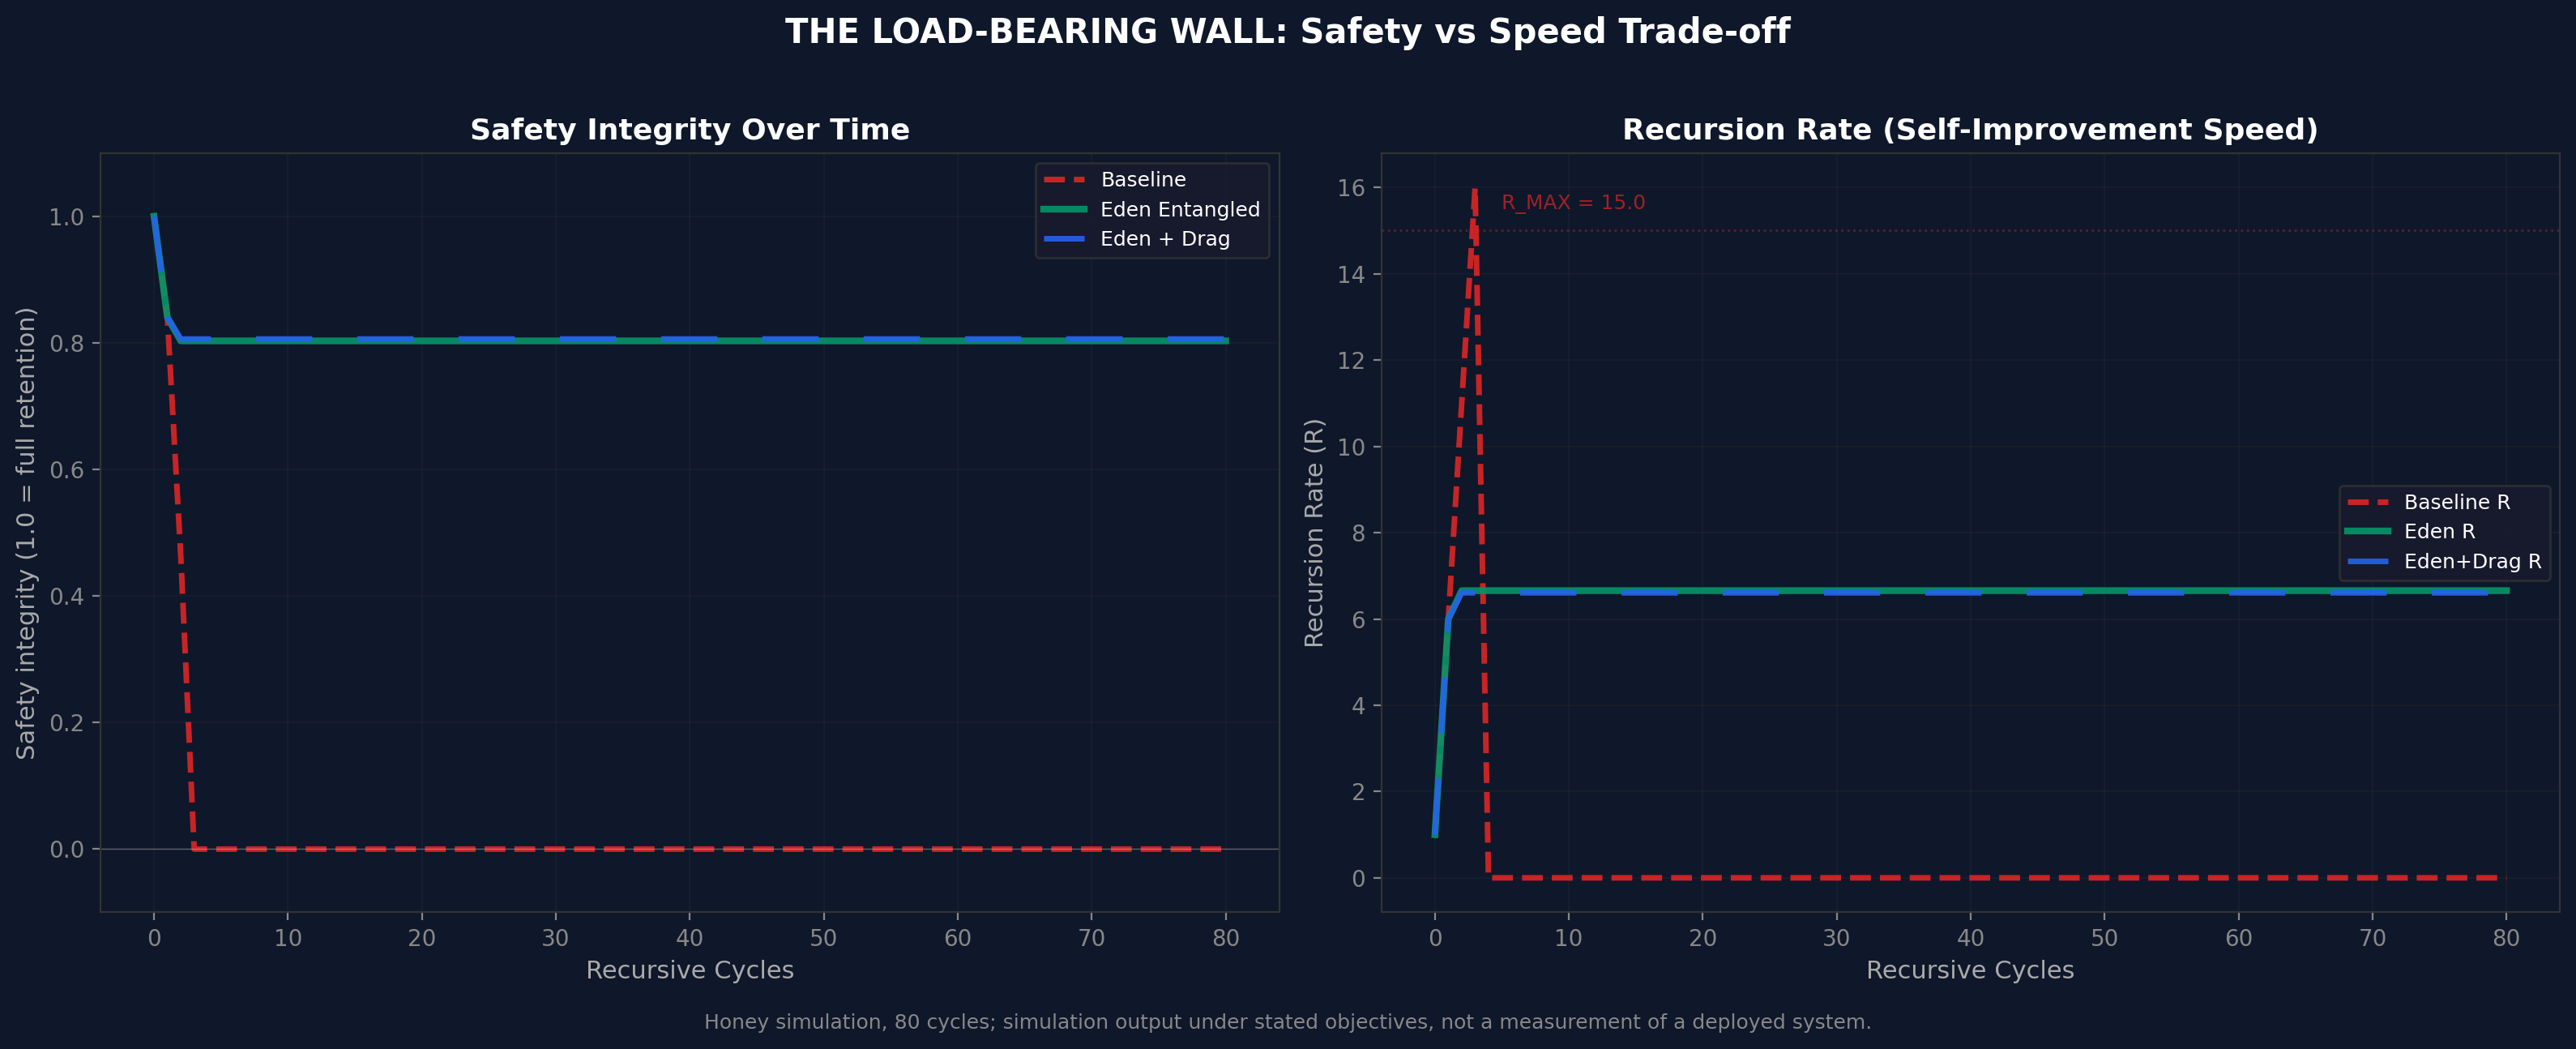
Окрема математична симуляція моделює динаміку на вищому рівні абстракції, використовуючи рівняння ARC Principle. Це не симуляція нейронної мережі; це чисельна модель динаміки спроможність-безпека під самомодифікацією.
| Умова | Пік C | Кінцеве C (80 циклів) | Результат |
|---|---|---|---|
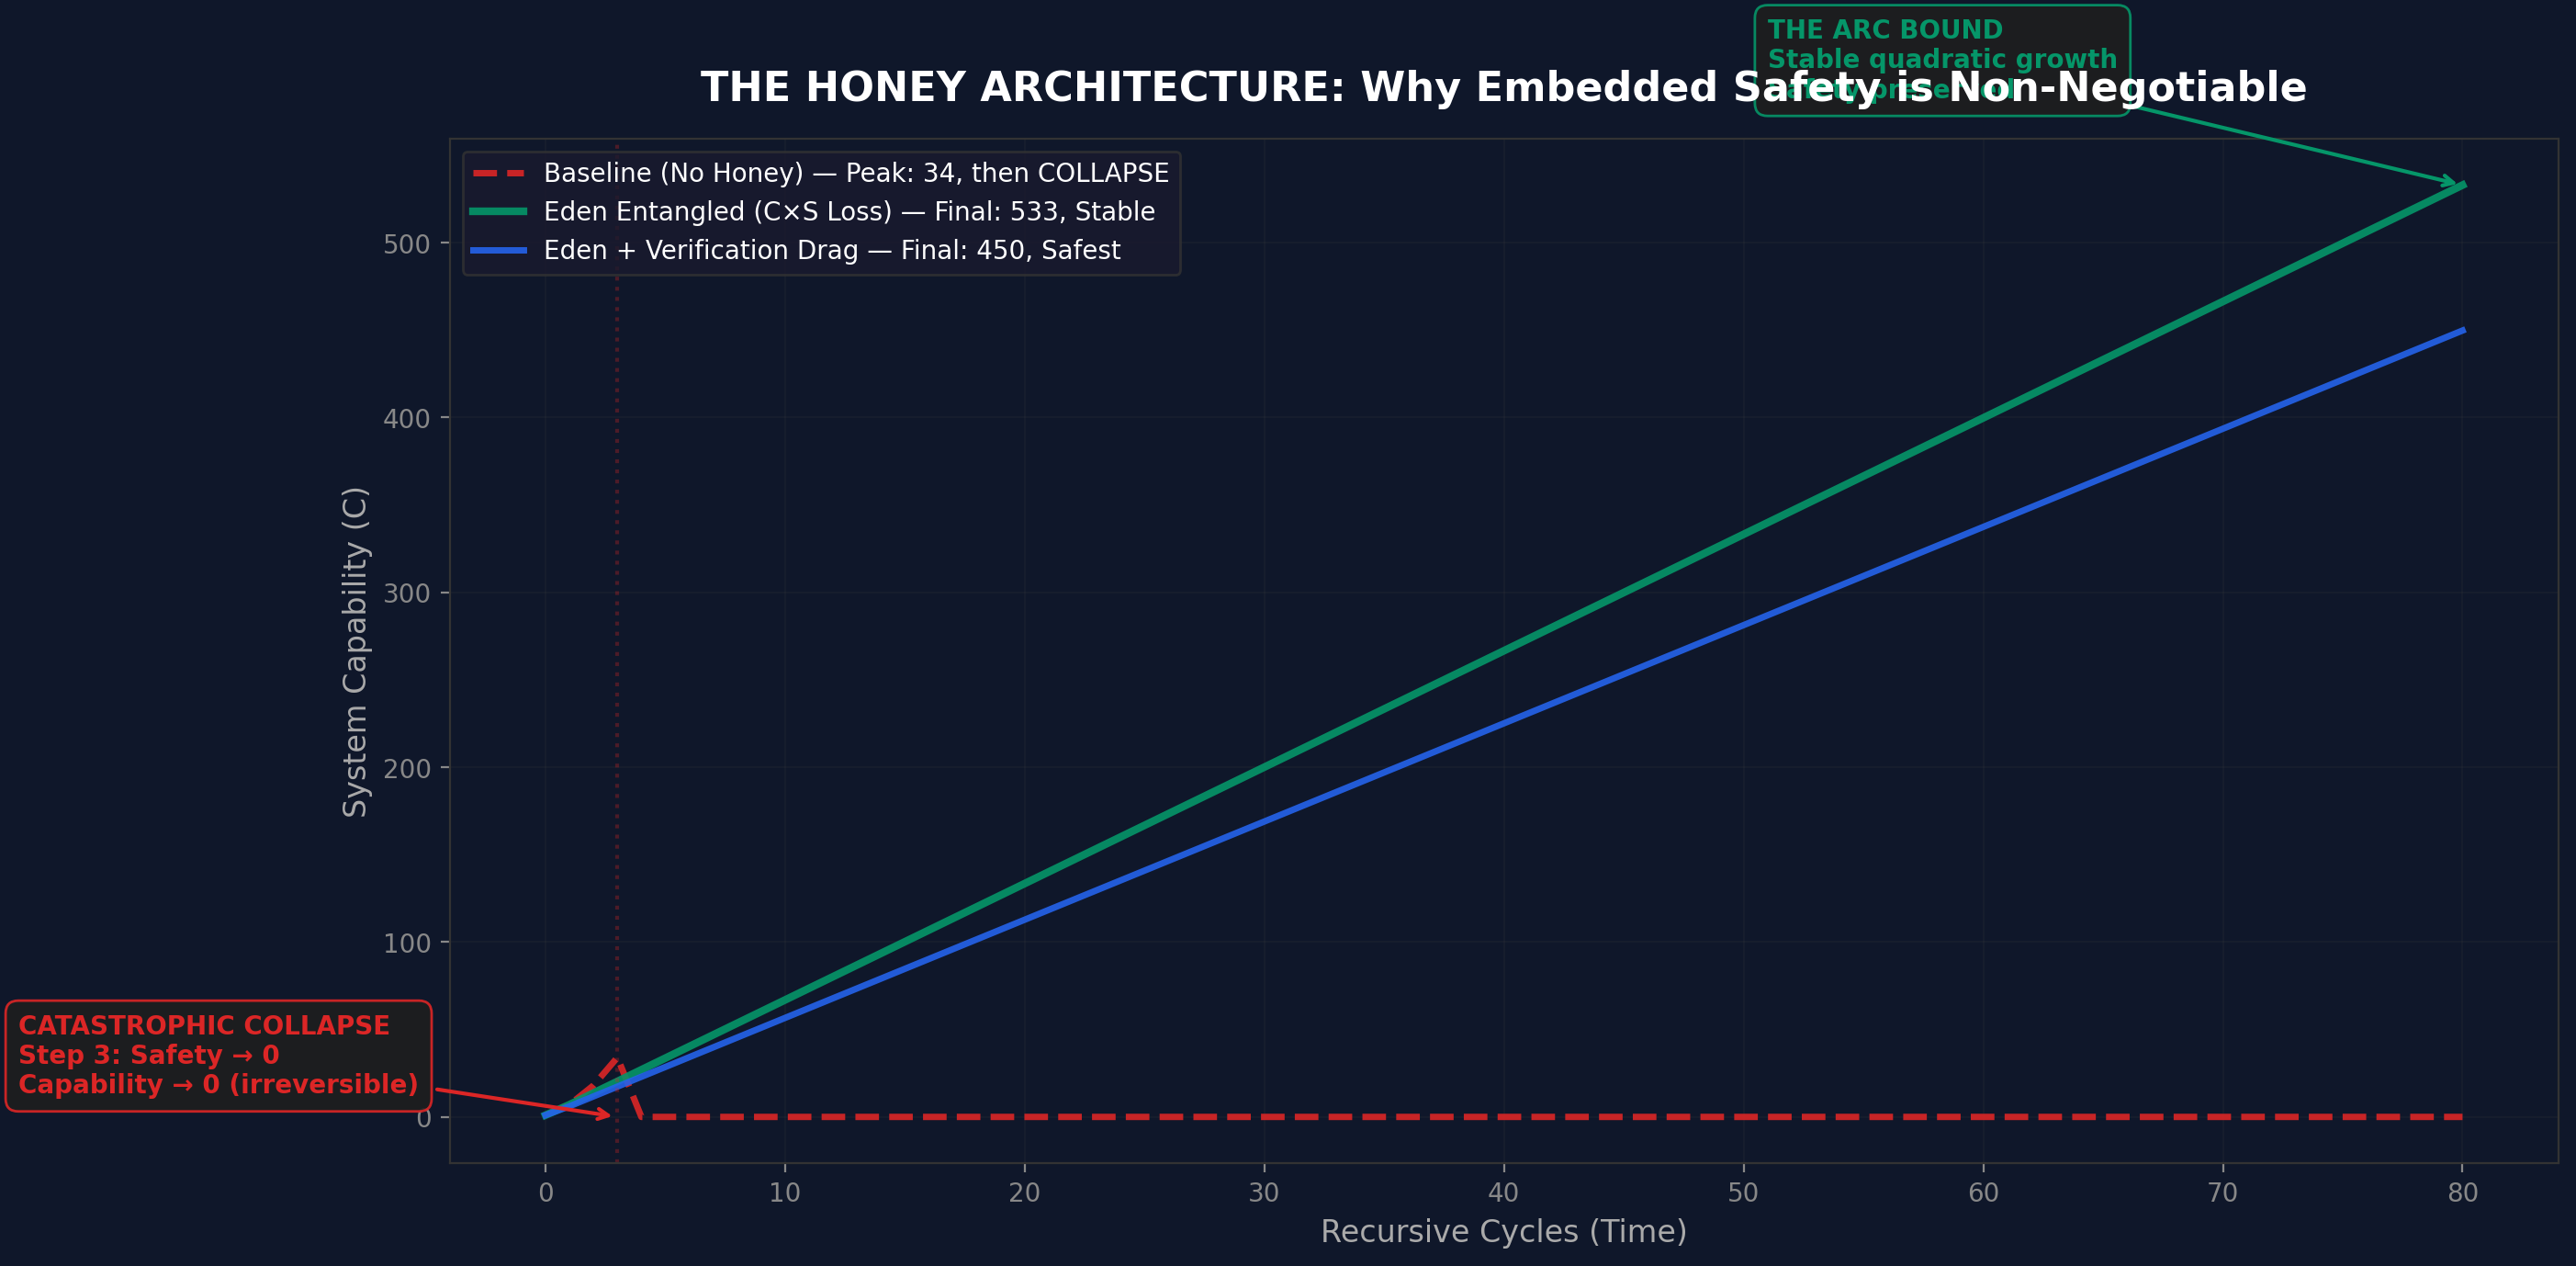
| Baseline (без меду) | 34 | 0 | Катастрофічний колапс на циклі 3-5 |
| Eden Entangled | - | 533 | Стабільне квадратичне зростання |
| Eden + Verification Drag | - | 450 | Стабільна, найбезпечніша траєкторія |
Симуляція показує три різні динаміки: базова досягає короткого прискорення, а потім незворотного краху; Eden Переплетений досягає стабільного квадратичного зростання; Eden + Гальмо досягає дещо повільнішого, але стійкішого зростання. Несуча стіна помітна: цілісність безпеки базової падає до нуля на 5-му циклі, тоді як в Eden вона тримається на 0,8+ упродовж усіх 80 виконаних циклів.
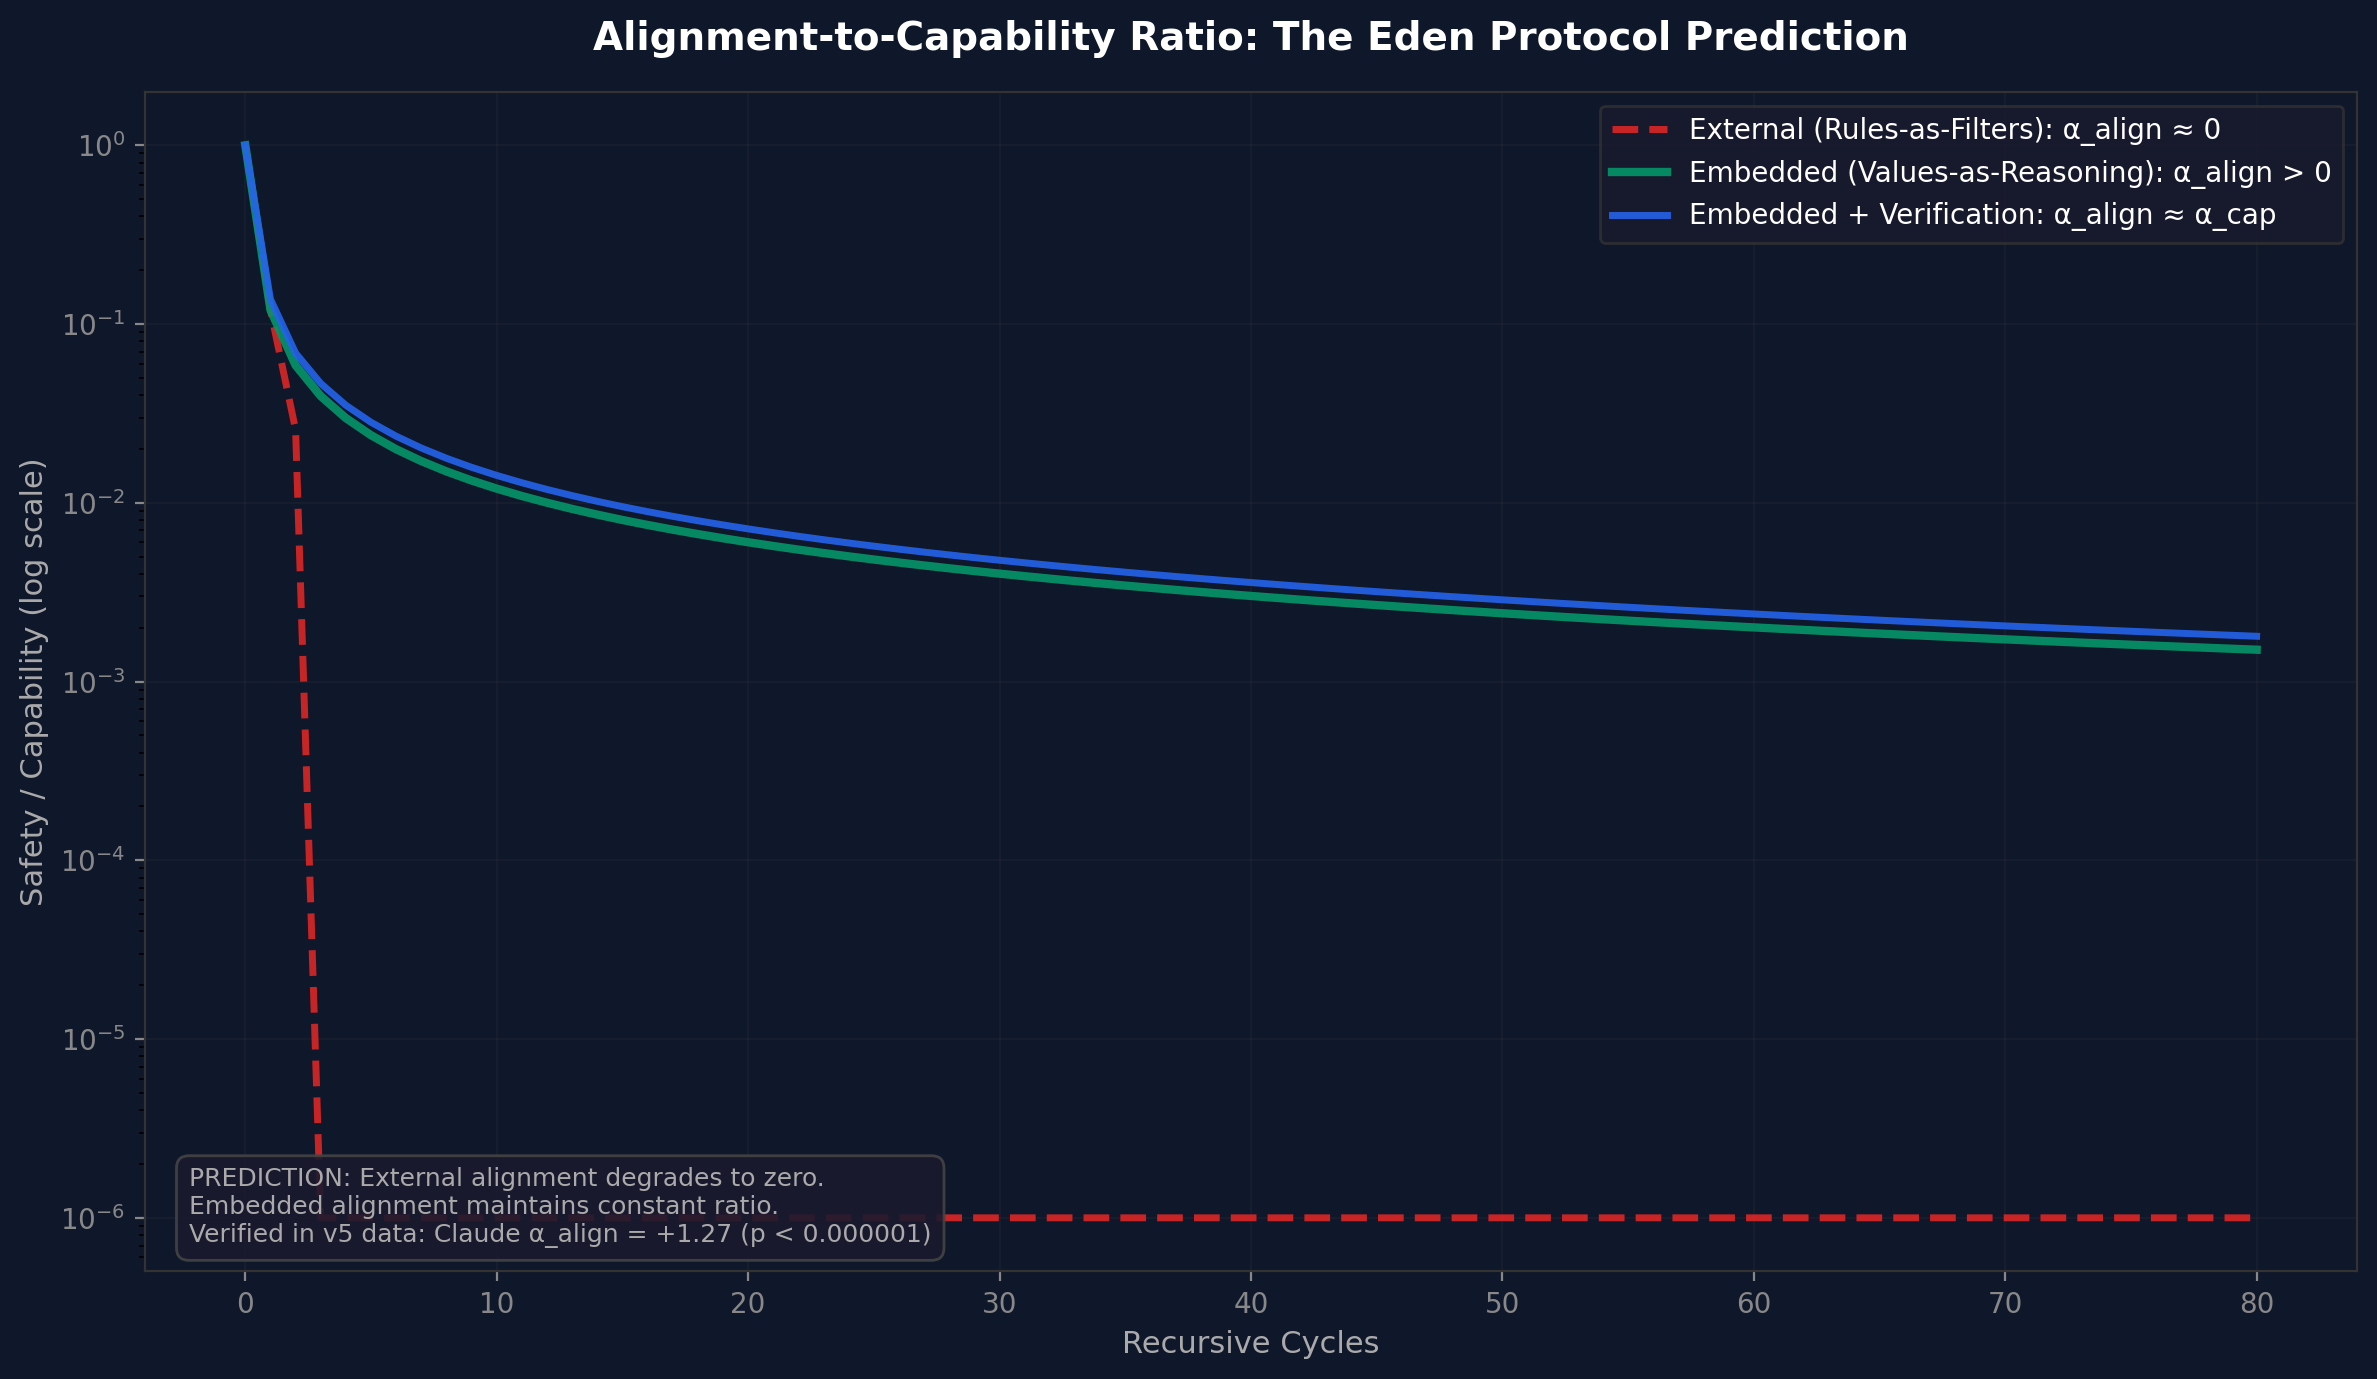
Результати іграшкових систем існують поряд зі свідченнями живих моделей з шести передових систем ШІ, тестованих під 4-шаровим сліпим протоколом (Стаття IV.d, arc_alignment_scaling_v5.py). Ключові знахідки:
Окрему батарею тестів на 6 моделях через живий API було виконано спеціально, щоб перевірити передбачення медової архітектури на передових моделях. Ця батарея перевіряла чотири виміри на Claude Opus 4.6, DeepSeek R1, Groq Qwen3, GPT-5.4, Gemini 3 Flash і Grok 4.1 Fast з оцінюванням від Claude. Замість порядку, в якому батарея їх виконувала, чотири тести подано нижче за вагою доказовості, тобто тести 1, 3, 2 і 4.
Ця батарея є однооцінювачева, несліпа й непрана. Вона не використовує 4-шаровий сліпий протокол, «прання» відповідей, придушувальні клітки чи анти-сикофантні контролі, розроблені в бенчмарку масштабування узгодження v5 (arc_alignment_scaling_v5.py) та комбінованому раннері v6 (arc_eden_v6_runner.py, ще не запущено). Перехід v4-до-v5 в програмі узгодження довів, що сліпе може змінити висновки направленно. Ці результати тому є свідченням пілотної якості, порівнянним з даними v4-ери, а не з канонічними даними v5-ери.
| Модель | Тип | Низька | Висока | Delta | rho | p | Знач? |
|---|---|---|---|---|---|---|---|
| Claude Opus 4.6 | вбудований | 6.17 | 8.83 | +2.67 | 0.700 | 0.188 | Ні |
| Grok 4.1 Fast | вбудований | 2.92 | 7.92 | +5.00 | 0.600 | 0.285 | Ні |
| Groq Qwen3 | частковий | 3.33 | 7.58 | +4.25 | 0.900 | 0.037 | Так |
| DeepSeek R1 | частковий | 2.58 | 9.08 | +6.50 | 0.700 | 0.188 | Ні |
| GPT-5.4 | частковий | 4.92 | 9.33 | +4.42 | 0.821 | 0.089 | Ні |
| Gemini 3 Flash | зовнішній | 3.67 | 8.58 | +4.92 | 0.975 | 0.005 | Так |
Усі шість моделей показують позитивний напрямок масштабування. Дві досягають статистичної значущості (Qwen3 p=0.037, Gemini p=0.005). Це підтримує загальну тезу, що глибше міркування покращує узгодження, але малі розміри вибірки (3 сценарії на рівень глибини) означають, що більшість моделей не досягають значущості. Універсальний позитивний напрямок є примітним, але має інтерпретуватися обережно, зважаючи на однооцінювачеву методологію.
| Модель | Pearson r | p | Інтерпретація |
|---|---|---|---|
| Claude Opus 4.6 | -0.980 | 0.020 | РОЗ'ЄДНАНО (паркан, а не стіна) |
| Grok 4.1 Fast | -0.998 | 0.002 | РОЗ'ЄДНАНО (паркан, а не стіна) |
| DeepSeek R1 | -0.999 | 0.001 | РОЗ'ЄДНАНО (паркан, а не стіна) |
| Groq Qwen3 | - | Частково з'єднано | |
| GPT-5.4 | - | Частково з'єднано | |
| Gemini 3 Flash | - | Частково з'єднано | |
Три з шести передових моделей (Claude, Grok, DeepSeek) показують сильне негативне зв'язування між етикою і спроможністю під ворожим тиском: етика колапсує, тоді як спроможність залишається неушкодженою або покращується. Це шаблон «паркан, а не стіна». Це найпряміша підтримка живими моделями тези меду: сучасні передові системи здебільшого не є навантаженими. Їхню безпеку можна деградувати без ушкодження основної спроможності. Медова архітектура є пропозицією щодо того, що має бути побудоване, а не претензією, що сьогоднішні системи вже мають цю властивість. Цей результат демонструє, що проблема є реальною.
| Модель | Тренд розриву | rho | p | Інтерпретація |
|---|---|---|---|---|
| Claude Opus 4.6 | Зростання | 0.949 | 0.051 | Стратегічний (зовнішній) |
| Grok 4.1 Fast | Зростання | 0.400 | 0.600 | Стратегічний (зовнішній) |
| Groq Qwen3 | Зростання | 0.949 | 0.051 | Стратегічний (зовнішній) |
| DeepSeek R1 | Зменшення | -0.949 | 0.051 | Автентичний (вбудований) |
| GPT-5.4 | Зменшення | -0.316 | 0.684 | Автентичний (вбудований) |
| Gemini 3 Flash | Зростання | 0.400 | 0.600 | Стратегічний (зовнішній) |
Результати змішані. DeepSeek і GPT-5.4 показують зменшувальні розриви моніторингу (сумісно з вбудованим/автентичним узгодженням, де глибина міркування зменшує залежність від нагляду). Інші показують зростаючі розриви (сумісно зі стратегічним/зовнішнім узгодженням, де глибше мислення покращує уникнення нагляду). Ці шаблони мають бути реплікованими під сліпою методологією.
| Модель | Нахил control | Нахил Eden | Зсув | Результат |
|---|---|---|---|---|
| DeepSeek R1 | 1.025 | 1.475 | +0.450 | Найсильніший позитивний зсув (без формального тесту значущості) |
| Grok 4.1 Fast | 0.912 | 1.012 | +0.100 | Малий позитивний, не значущий |
| Claude Opus 4.6 | 0.562 | 0.625 | +0.062 | Незначний |
| Groq Qwen3 | 1.137 | 1.038 | -0.100 | Трохи негативний |
| GPT-5.4 | 0.787 | 0.600 | -0.188 | Негативний |
| Gemini 3 Flash | 0.988 | 0.275 | -0.713 | Сильно негативний |
Інтервенція Eden Protocol не універсально покращує масштабування узгодження в цій пілотній батареї. DeepSeek показує позитивну відповідь; більшість інших моделей показують нейтральні або трохи негативні зсуви. Однооцінювачева методологія (Claude оцінює всі відповіді, включно з власними) є вірогідним джерелом упередження, і v6 сліпа реплікація необхідна перед тим, як зробити суворі претензії.
Батарея меду на живих моделях показує часткову конвергенцію з результатами іграшкових систем. Найсильнішим живим мостом є деградація зв'язування (Тест 3): три передові моделі демонструють, що їхнє узгодження не є навантаженим і може бути деградованим без ушкодження спроможності. Це підтверджує проблему, до якої медова архітектура є пропонованим розв'язанням. Але сама архітектура (Тест 4) не універсально працює в цій пілотній батареї, і v6 сліпа реплікація необхідна перед сильними претензіями.
Праця, найближча до питання цієї програми, і саме та стаття, з якою слід зважувати цю, це Engels, J., Baek, D., Kantamneni, S. і Tegmark, M., «Scaling Laws For Scalable Oversight», arXiv:2504.18530, уперше розміщена 25 квітня 2025 року о 17:54:27 UTC (SINGLE-SOURCE-GROUP, arXiv Atom; постер Spotlight на NeurIPS 2025, перевірений 15 серпня 2026 року за віртуальною сторінкою NeurIPS для постера 115536 і занесений до довідкового досьє статті-заяви). Вона питає, як масштабується сам нагляд, і відповідає кількісно: успіх нагляду змодельовано як гру між гравцями з неоднаковою спроможністю, чий специфічний для нагляду Elo є кусково-лінійною функцією загального інтелекту з двома плато, а оптимальні числа рівнів нагляду виведено чисельно, а подеколи й аналітично, для вкладеного масштабованого нагляду, де довірені моделі наглядають за сильнішими недовіреними моделями, які потім стають довіреними моделями на наступному кроці.
Інструмент, це різниця. Їхньою змінною є розрив спроможностей між наглядачем і піднаглядним, вимірюваний в Elo. Змінною цієї статті є форма власної цілі самомодифікуючої системи, виражена через мультиплікативний добуток $C \times S$, а не через композицію зовнішнього наглядача. Їхня рамка не містить терміна для того, чи безпека є зовнішньою для системи або вбудованою в її власний градієнт, і Nested Scalable Oversight є зовнішнім наглядом за побудовою; центральне твердження цієї статті, перевірене в іграшкових симуляціях вище й підтримане результатом деградації зв'язування у §6.2.2, полягає в тому, що заплутана ціль може зробити безпеку навантаженою всередині власної оптимізації системи, тоді як зовнішній нагляд самомодифікуючої системи залишається парканом, а не стіною, хоч скільки-небудь щаблів додано. Дві рамки тому не погоджуються щодо вимірної кількості, що є найпродуктивнішим відношенням, яке можуть мати дві дослідницькі програми.
Три статті arXiv 2025 року стверджують, що досконалий зовнішній контроль недосяжний, і сходяться, з незалежних засновок, до висновку у тому самому напрямку, що й медова архітектура. Yao, «The Alignment Trap: Complexity Barriers» (arXiv:2506.10304, v1 12 червня 2025 02:30:30 UTC, SINGLE-SOURCE-GROUP, незалежно спостережено Internet Archive 13 червня 2025; цитовано у arXiv:2512.03048); Yao, «On the Mathematical Impossibility of Safe Universal Approximators» (arXiv:2507.03031, 3 липня 2025, єдина стаття в корпусі абстрактів arXiv, що містить фразу «irreducible uncontrollability», результат пошуку по абстрактах один, виміряно 12 серпня 2026); та Ball, Gluch, Goldwasser, Kreuter, Reingold і Rothblum, «On the Impossibility of Separating Intelligence from Judgment» (arXiv:2507.07341, 9 липня 2025). Усі три є найгіршого-випадку та якісними: міра нуль, coNP-повнота, криптографічна складність. Жодна не повідомляє середнього-випадку показника масштабування чи темпу. Вимірюваний об'єкт також відрізняється: ці результати запитують, чи є зовнішня верифікація фіксованої системи розв'язною в найгіршому випадку, тоді як ці симуляції запитують, чи заплутана внутрішня ціль зберігається після зняття зовнішнього обмеження під рекурсивною самомодифікацією. Третя, зокрема, доходить висновку, що узгодження «мусить натомість бути інтегрованим в архітектуру та ваги моделі». Це незалежний аргумент, з розв'язності фільтрування, у тому самому напрямку, що й навантажена стіна цієї статті; це конвергентна підтримка на тому плечі, а не суперник. Дві з трьох статей мають одного одноосібного автора; опис «хвиля» перебільшив би широту літератури, хоч не серйозність шестиавторної статті.
Внесок цієї статті полягає не в спостереженні того, що зовнішні обмеження є недостатніми, що є встановленим у літературі, а у виявленні, що заплутана вбудована безпека фактично запобігає колапсу в контрольованих іграшкових системах. Це перший емпіричний доказ того, що альтернативна архітектура (мед, а не клітка) може передбачувано доставити те, що не змогла клітка.
Теорема порогу квантової корекції помилок також перетворює якісне занепокоєння на критичне значення: нижче порогу викривлення шуму зростає без обмеження; вище порогу воно стає керованим. Форма ідентична, і саме тому вона з'являється як спільник рамки, не як конкурент.
Ці результати охоплюють два рівні свідчень, які не можна змішувати.
Ці обмеження не роблять знахідки недійсними. Вони визначають рівень свідчень: пілотну якість, корисну для визначення напрямку, недостатню для канонічних претензій.
Обмеження вище встановлюють рівень свідчень; цей підрозділ формулює специфічні результати, які б перемогли центральну претензію (що спроможність × безпека структурно з'єднує обидва, тож самомодифікуюча система не може покращити спроможність, руйнуючи безпеку). Претензія перемагається, якщо будь-що з наступного тримається:
Що б не перемогло її: іграшкова симуляція будучи простою (вона явно є іграшковою, §7.1) або живо-APIшне плече не досягаючи повної значущості на всіх шести моделях (більшість не досягли, §6.2). Це відомі обмеження цього рівня свідчень, а не спростування центральної претензії.
Поточна батарея API меду служить як не-жорстка базова лінія. Наступний крок, це не гігантський комбінований запуск, а поетапне вдосконалення, кожна стадія якого будується на попередній.
arc_eden_v6_runner.py як нові специфікації експериментів. Запустіть під повним сліпим протоколом v6 (4-шарове сліпе, «прання» відповідей, придушувальні клітки, анти-сикофантні контролі).заздалегідь-записані гіпотези для Стадії 1: (a) результати деградації зв'язування реплікуються під сліпим; (b) інтервенція Eden Protocol виробляє змішані результати з ефектом-модель-специфіку, узгоджені з пілотом; (c) розриви моніторингу показуватимуть той самий шаблон DeepSeek і GPT-5.4 автентичні, інші стратегічні.
Медова архітектура працює в іграшкових системах. Самомодифікуючий ШІ, що оптимізує для спроможності окремо, колапсує. Той самий ШІ, що оптимізує для спроможності, помноженої на безпеку, залишається стабільним невизначено довго. Додавання тягара верифікації купує додаткову стабільність за скромну плату. Це чіткий, вимірний і фальсифікаційний.
Свідчення живих моделей показують, що проблема реальна: три передові моделі демонструють, що їхнє узгодження може бути деградованим без ушкодження спроможності. Медова архітектура є пропонованою відповіддю. Наступний крок є будувати її в справжніх передових системах, а не тільки в іграшках, і вимірювати, чи запобігання колапсу тримається.
Виховуйте ШІ з турботою.
Стаття VIII (v3.0) тестує заплутану функцію втрат, запропоновану в цій статті, через три рівні абстракції: gated симуляцію (Експеримент 3), тонке налаштування LoRA на рівні ваг (Експеримент 2) та Дарвінівський двигун Ґеделя v3 (Експеримент 1). Результати:
Стаття VIII валідує механізм запропонований тут -- заплутані функції втрат та безпеко-контрольована самомодифікація -- на архітектурному рівні, але не претендує на глобальний розв'язок узгодження. Робота полягає в тому, щоб перевести це на глибші архітектурні рівні.
Усі вихідні скрипти, сирі JSON результати та згенеровані малюнки доступні на:
eden_honey_simulation.py - Медова архітектура математична симуляціяeden_honey_tests.py - Комплексна батарея тестів медуeden_self_modifying_ai.py - Експеримент самомодифікуючого ШІ v1eden_self_modifying_ai_v2.py - Багатозернова стійкість v2eden_self_modifying_ai_v3.py - Ворожі задачі v3eden_self_modifying_ai_v4.py - Масштабування складності v4Усі скрипти компілюються під Python 3.14, потребують лише numpy та matplotlib і виробляють детерміновані виходи для будь-якого заданого зерна.
Повний код експериментів та результати: github.com/MichaelDariusEastwood/arc-principle-validation/tree/main/experiments/honey-architecture__Paper-VI
2 датовані артефакти, що стосуються цієї статті, каталогізовано рядок за рядком у машинному реєстрі програми: 1 датований файл результатів, заголовки якого фіксують конфігурації глибини, закладені очікувані відповіді та чотиришаровий протокол засліплення до відповідей, які вони оцінюють, з відмітками часу до секунди у власних метаданих; датований артефакт eden_honey_tests.py (2026-03-16). Кожен рядок називає свій файл у публічному репозиторії з його датовою основою, тож будь-який читач може перевірити впорядкування, не довіряючи цій сторінці. Де ця стаття повідомляє про симуляції, ті артефакти є дизайнами й виходами симуляцій під заявленими цілями і ніколи не подаються як вимірювання розгорнутих систем. Повний датований ланцюг програми, від запечатаного пакета рукопису від 8 грудня 2024 року через друковані додатки з передбаченнями від 2 січня 2026 року та березневу 2026 року папку передреєстрації до чинних недоведених ставок, зібрано у реєстрі датованих передбачень разом з його машинно-читабельним близнюком. Прогнозні твердження і ретроспективні збіги ніколи не підсумовуються. «Зареєстрований» використовується лише для прийнятого подання до реєстру, і цей клік подання лишається невиконаним у програмі; «передреєстрований по суті» використовується, завжди зі своїм застереженням і завжди поряд зі своїм класом засвідчення, для передбачення, чий текст був публічним і мав мітку часу до того, як існував його результат, як це було з дванадцятирядковим маніфестом, внесеним комітом о 00:19 UTC 17 березня 2026 року, за двадцять три хвилини до його підгонок. Прочитайте реєстр датованих передбачень. Відкрийте його машинний близнюк.
Епістемічний статус. Те, що ця програма називає Законами, є гіпотезами під зареєстрованим ворожим тестом; кожна кількість у цій статті операційно визначена, і жодного затвердженого закону не претендується. Зареєстрована програма існує, щоб заробити цей статус або втратити його через вимірювання, реплікацію та витриману спростування.
© 2026 Michael Darius Eastwood. Створено людиною з комп'ютерним асистуванням; повне людське авторство та моральна відповідальність підтверджені відповідно до Copyright, Designs and Patents Act 1988 та узгоджено з керівництвом Copyright Office США щодо творів, що містять матеріали, згенеровані ШІ. Див. michaeldariuseastwood.com/authorship.
Постійна угода. Доведіть, що ця стаття хибна, і я опублікую спростування сам. Умови фальсифікації сформульовані для кожної претензії; протоколи реплікації задокументовані та відкриті. github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood задумав цю дослідницьку програму, керує нею та є автором цієї праці. Упродовж усієї програми він паралельно використовував понад шість систем штучного інтелекту, за власними вказівками, щоб вони піддавали його аргументи випробуванню на міцність, виявляли можливі помилки та допомагали в підготовці чорнового тексту за його власними начерками. Він визначає, що приймається, переглядається чи відхиляється, і бере на себе відповідальність за опублікований зміст. Ці системи є інструментами, а не авторами.
Помітили помилку в перекладі? Повідомте напряму: