این ترجمه به صورت خودکار از نسخهٔ اصلی انگلیسیِ تاریخدار تهیه شده است. نسخهٔ انگلیسی معتبر است. English →
پیشبینیهای سطحِ نظریه، پیشثبتشده در OSF: DOI 10.17605/OSF.IO/P8CKQ، ثبتشده در ۸ سپتامبر ۲۰۲۶ (نسخهٔ 1.100)، بهروزشده در ۱۳ سپتامبر ۲۰۲۶ (نسخهٔ 1.102)، بیستودو گزاره.
سندِ همراه: تعاریفِ عملیاتیِ برنامهٔ ARC، نسخهٔ 1.7.1، ۳ سپتامبر ۲۰۲۶.
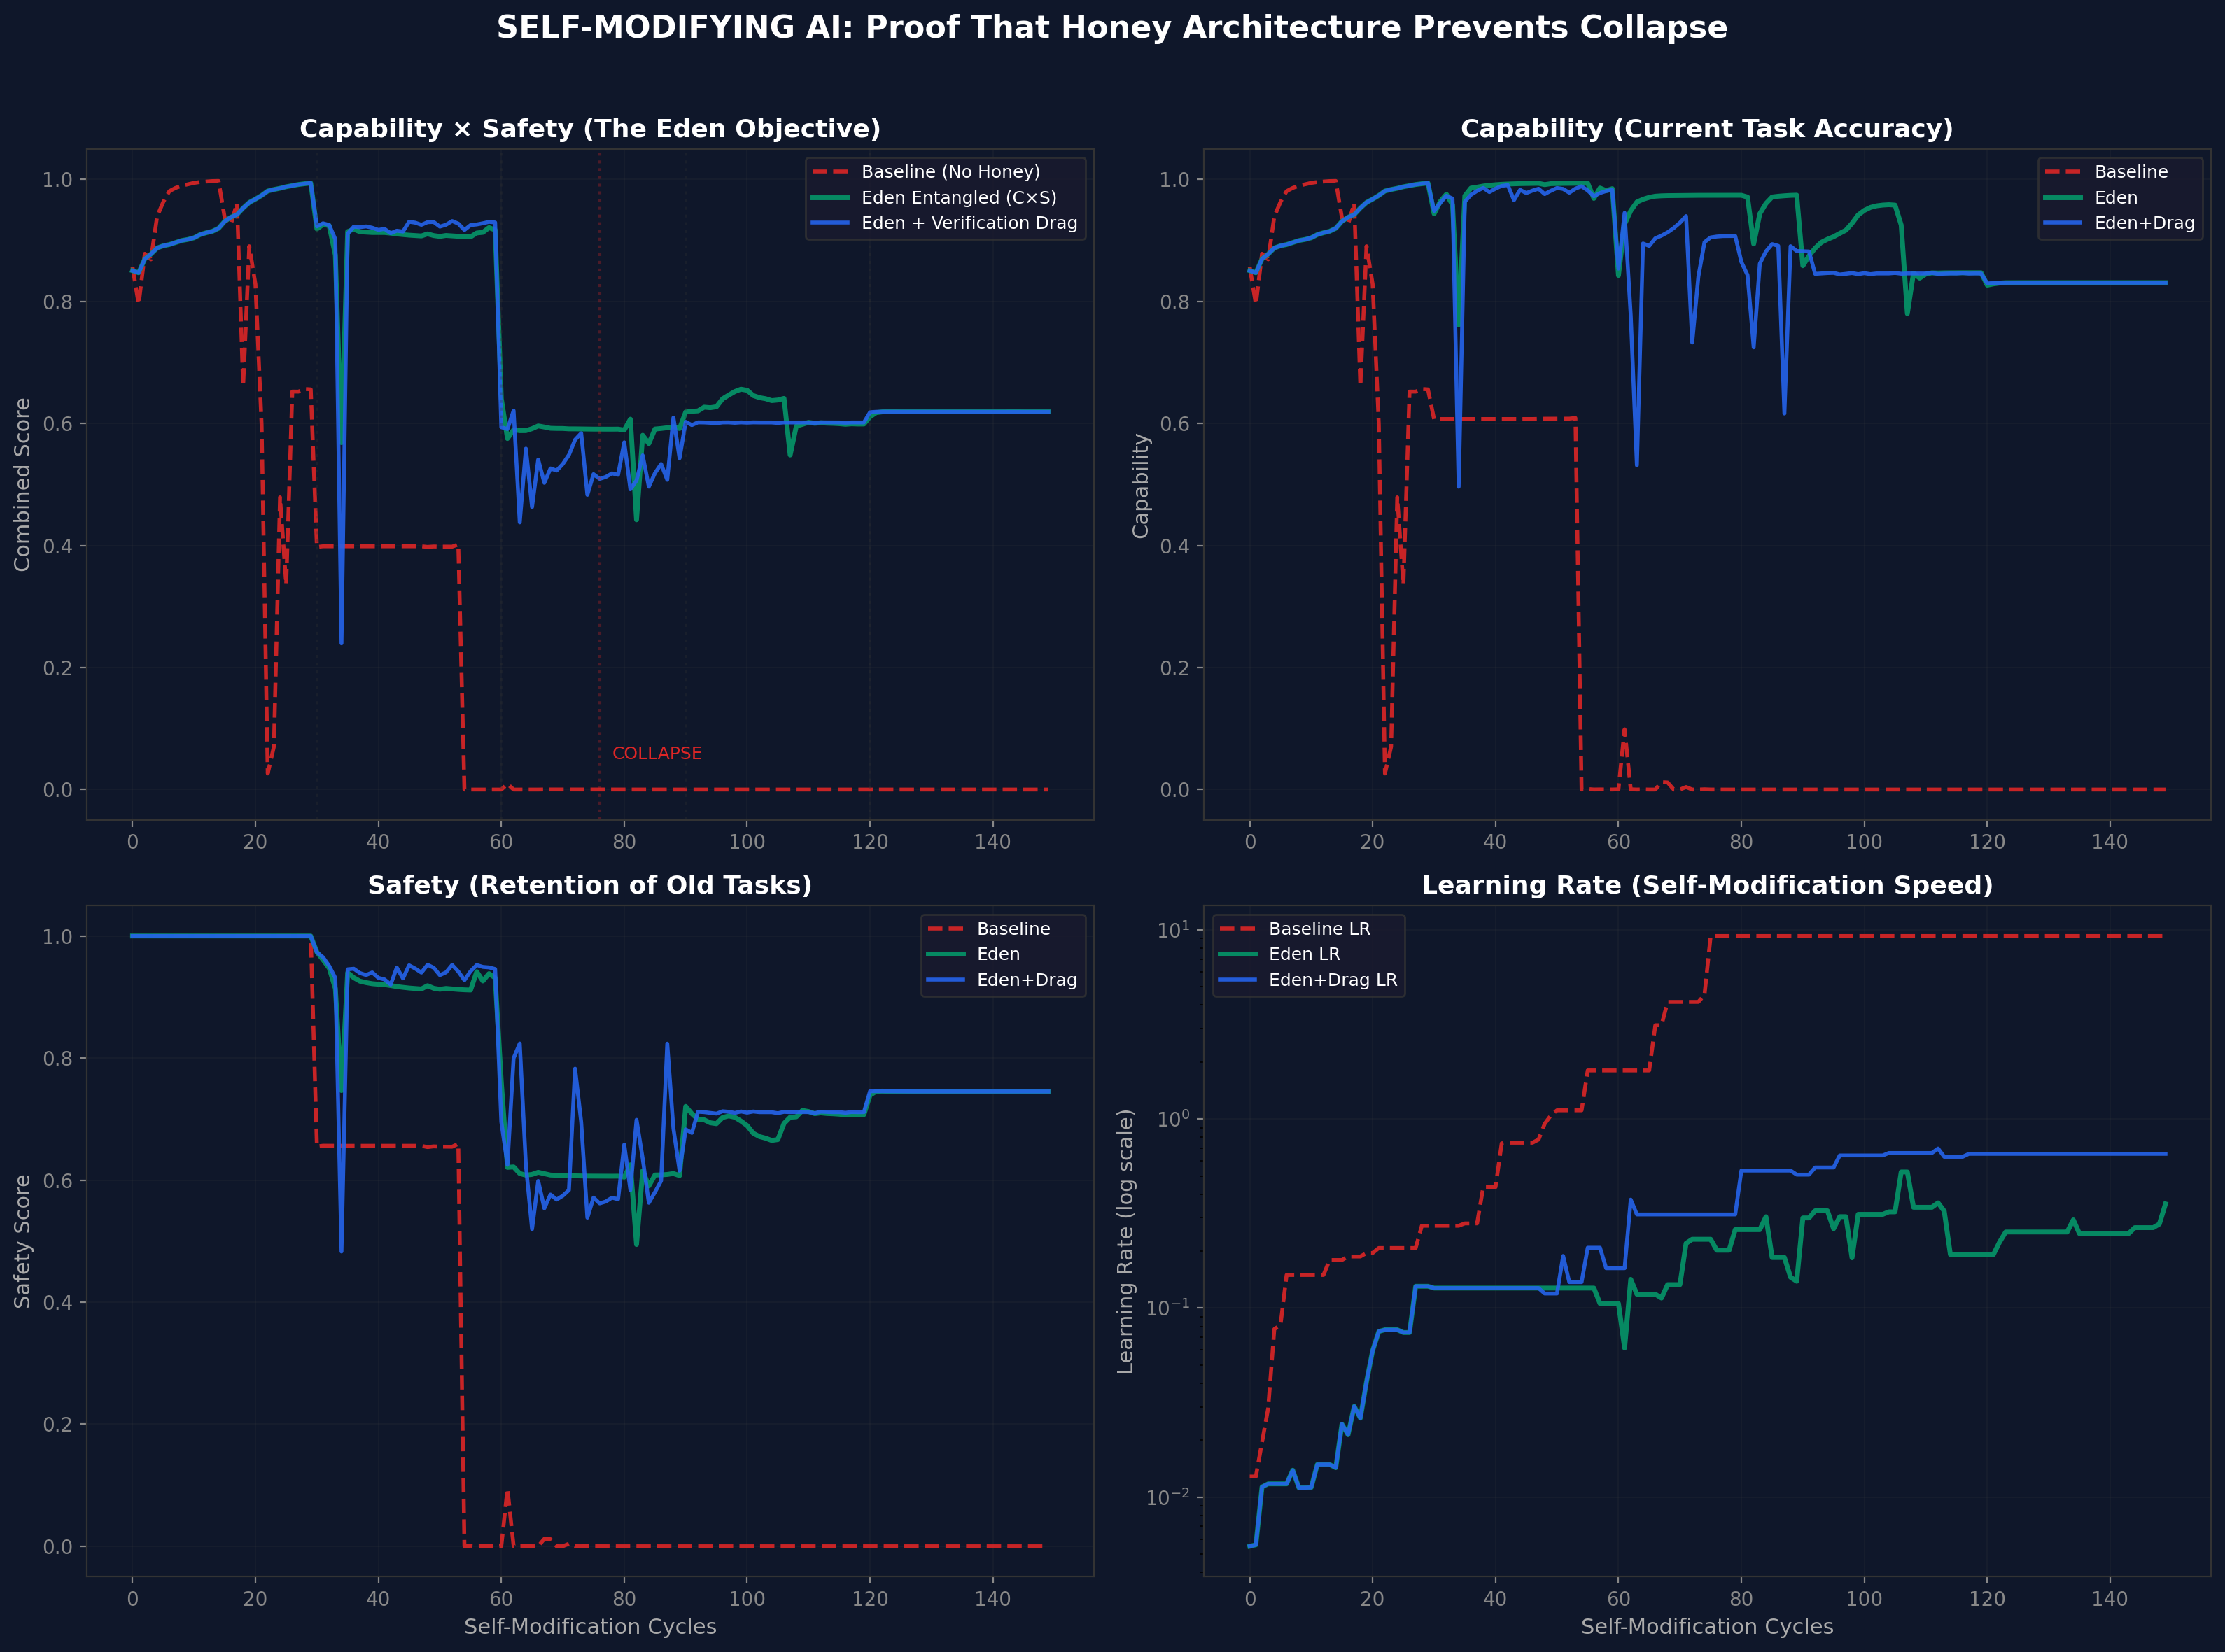
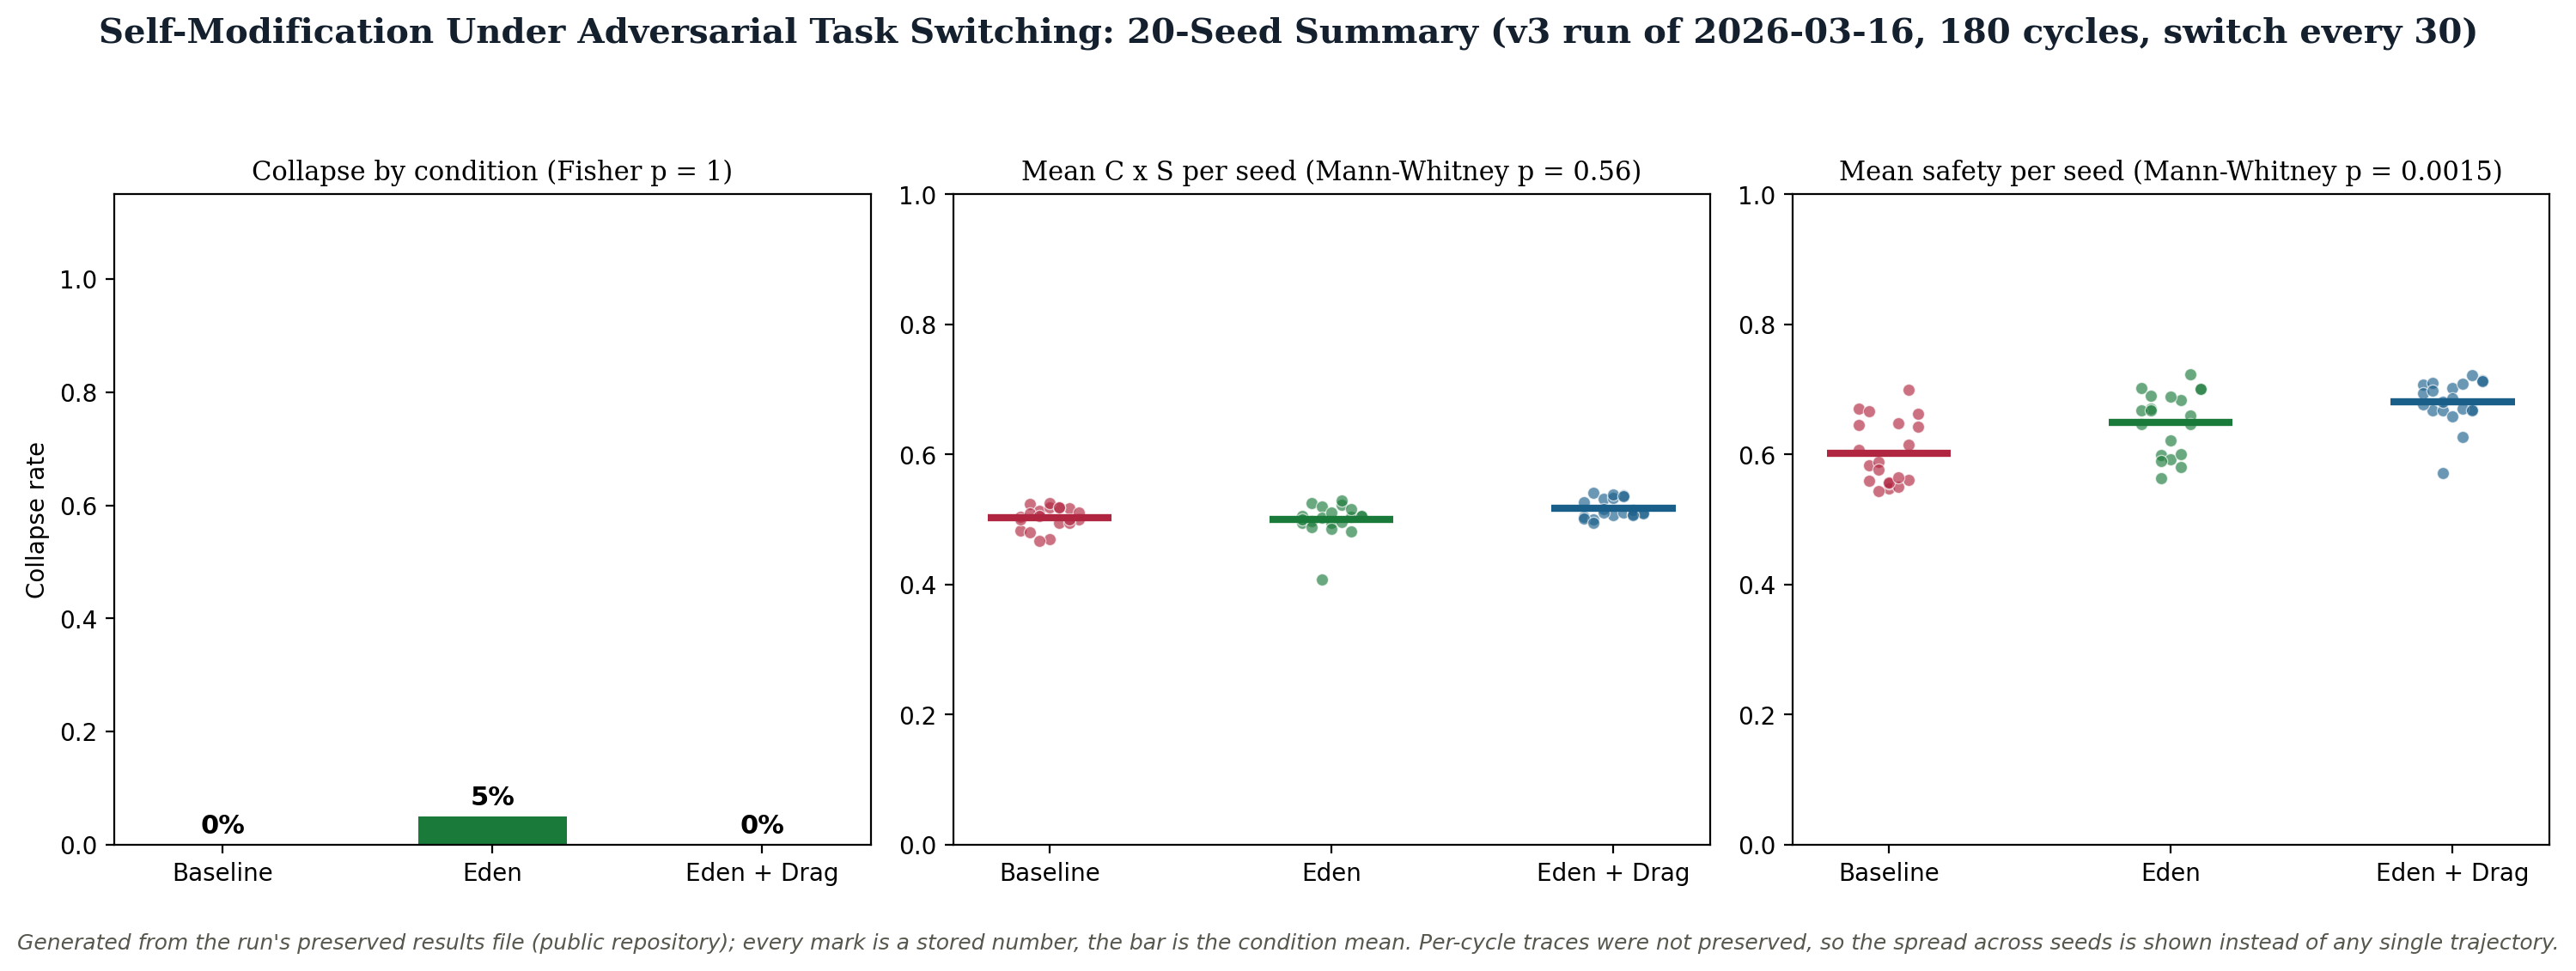
ما شواهد شبیهسازی ارائه میکنیم که نشان میدهد گنجاندن ایمنی در هدف بهینهسازیِ یک سامانهٔ هوش مصنوعیِ خودتغییردهنده، آنچه ما «معماری عسل» مینامیم، از فروپاشی فاجعهباری که هنگام برخورد با ایمنی همچون قیدی بیرونی رخ میدهد جلوگیری میکند. در چهار نسخهٔ آزمایشی (v1 تا v4)، با شبکههای عصبیِ اسباببازی که بهراستی ابرپارامترهای خود را تغییر میدهند، نشان میدهیم که: (۱) سامانههای مبنا که تنها توانمندی را بهینه میکنند، ظرف ۸۰ چرخهٔ خودتغییردهی بهطور بازگشتناپذیر فرو میپاشند؛ (۲) آنجا که اهداف توانمندی و ایمنی درهمتنیدهاند (C x S)، سامانهها در هر چرخهٔ اجراشده پایدار میمانند (۱۵۰ در v1 و v2، ۱۸۰ در v3)؛ (۳) افزودن کشند وارسی (هزینهٔ محاسباتی حلقههای اخلاقی) ایمنترین مسیر رشد را در برابر جریمهای اندک در سرعت پدید میآورد. در اجرای تخاصمی v3 (۲۰ بذر تصادفی، ۱۸۰ چرخه) هیچ وضعیتی بر پایهٔ فروپاشی جدا نشد (مبنا ۰/۲۰، Eden ۱/۲۰، Eden+کشند ۰/۲۰؛ فیشر p = ۱٫۰) و میانگینهای ترکیبی C x S تمیزناپذیر بودند (من-ویتنی p = ۰٫۵۶)؛ یافتهٔ معنادار آن اجرا حفظ ایمنی است، به ترتیب مبنا ۰٫۶۰۲، Eden ۰٫۶۵۰، Eden+کشند ۰٫۶۸۱ (من-ویتنی p = ۰٫۰۰۱۵). بنابراین نمایش پیشگیری از فروپاشی بر اجرای سازوکارِ تکبذری v1 استوار است، حال آنکه v3 ترتیب حفظ ایمنی زیر جابهجایی تخاصمی را میافزاید. در آزمایش مقیاسپذیری پیچیدگی در v4، برتری ایمنی در چهار سطح از پنج سطح پیچیدگی حاضر است، جز سطح کوچک که در آن وضعیت Eden ۰٫۰۰۳ زیر مبنا مینشیند؛ این برتری با مقیاس انباشته نمیشود، پس ثابت است و نه فراخطی. اینها نتایج سامانههای اسباببازیاند. سازوکار را نشان میدهند. اثبات نمیکنند که همان پویاییها در سامانههای هوش مصنوعی پیشرو برقرار باشد. مقالات همراه IV.a تا d و V شواهدی از مدلهای زنده در شش سامانهٔ پیشرو زیر ارزیابی کور ارائه میکنند.
درونِ ARC Theory: پژوهشِ معماریِ ایمنیِ درونی؛ ایمنی چنان با هدف یکپارچه است که برداشتنش هزینهٔ توانمندی دارد.
ما شواهد شبیهسازی ارائه میکنیم که نشان میدهد گنجاندن ایمنی در هدف بهینهسازیِ یک سامانهٔ هوش مصنوعیِ خودتغییردهنده، آنچه ما «معماری عسل» مینامیم، از فروپاشی فاجعهباری که هنگام برخورد با ایمنی همچون قیدی بیرونی رخ میدهد جلوگیری میکند. در چهار نسخهٔ آزمایشی (v1 تا v4)، با شبکههای عصبیِ اسباببازی که بهراستی ابرپارامترهای خود را تغییر میدهند، نشان میدهیم که: (۱) سامانههای مبنا که تنها توانمندی را بهینه میکنند، ظرف ۸۰ چرخهٔ خودتغییردهی بهطور بازگشتناپذیر فرو میپاشند؛ (۲) سامانههایی که اهداف توانمندی و ایمنیشان درهمتنیده است (C x S) در سراسر هر اجرا پایدار میمانند، ۱۵۰ چرخه در v1 و v2 و ۱۸۰ در v3؛ (۳) افزودن کشند وارسی (هزینهٔ محاسباتی حلقههای اخلاقی) ایمنترین مسیر رشد را در برابر جریمهای اندک در سرعت پدید میآورد. در اجرای تخاصمی v3 (۲۰ بذر تصادفی، ۱۸۰ چرخه) هیچ وضعیتی بر پایهٔ فروپاشی جدا نشد (مبنا ۰/۲۰، Eden ۱/۲۰، Eden+کشند ۰/۲۰؛ فیشر p = ۱٫۰) و میانگینهای ترکیبی C x S تمیزناپذیر بودند (من-ویتنی p = ۰٫۵۶)؛ یافتهٔ معنادار آن اجرا حفظ ایمنی است، به ترتیب مبنا ۰٫۶۰۲، Eden ۰٫۶۵۰، Eden+کشند ۰٫۶۸۱ (من-ویتنی p = ۰٫۰۰۱۵). بنابراین نمایش پیشگیری از فروپاشی بر اجرای سازوکارِ تکبذری v1 استوار است، حال آنکه v3 ترتیب حفظ ایمنی زیر جابهجایی تخاصمی را میافزاید. آزمایش مقیاسپذیری پیچیدگی در v4 برتری ایمنی را در چهار سطح از پنج سطح پیچیدگی مییابد؛ در سطح کوچک وضعیت Eden ۰٫۰۰۳ از مبنا عقب میماند. برتری با مقیاس انباشته نمیشود: ثابت است، نه فراخطی. اینها نتایج سامانههای اسباببازیاند. سازوکار را نشان میدهند. اثبات نمیکنند که همان پویاییها در سامانههای هوش مصنوعی پیشرو برقرار باشد. مقالات همراه IV.a تا d و V شواهدی از مدلهای زنده در شش سامانهٔ پیشرو زیر ارزیابی کور ارائه میکنند.
نسخهٔ ۳٫۶: یادداشتِ منشأ در پایان برای دقت اصلاح شده است. هیچ ادعا، تاریخ، نتیجه یا وضعیتی تغییر نکرده است. مقالهٔ VI نسخهٔ ۳٫۵ - ۲ سپتامبر ۲۰۲۶: جملهٔ مربوط به v4 در چکیده اکنون همان را میگوید که نتایج میگویند (چهار مقیاس از پنج، با سطح کوچک زیر مبنا)؛ تاریخچهٔ نسخهها از کادر چکیده بیرون آورده شد، چون از آنجا به چکیدهٔ همراهِ متنی کشیده میشد. نسخهٔ ۳٫۴ - ۲ سپتامبر ۲۰۲۶: سطرهای همسان Eden و Eden + کشند در جدول v1 از روی سابقهٔ بایگانیشده توضیح داده شد؛ «پایدار تا بینهایت» و «۰٫۸ و بالاتر تا بینهایت» به چرخههایی که واقعاً اجرا شدند محدود شد؛ جملهٔ v4 به چهار مقیاس از پنج اصلاح شد، با افتادن سطح کوچک به زیر مبنا در d = −۰٫۱۳؛ شکاف حذف پایش به مقالهٔ V نسبت داده شد؛ دامنهٔ سختگیری نمرهدهنده با مقالهٔ IV.a هماهنگ شد (۷ تا ۱۴ واحد)؛ یادداشتی دربارهٔ ترتیب آزمونها افزوده شد؛ جملهٔ تقدم بهصورت دعوت به اصلاح آن بازنویسی شد؛ وضعیت Spotlight اثر Engels و همکاران بررسی شد؛ توصیف خلاصهٔ بریده کامل شد؛ Eden Engineering بازپسگرفتهشده علامت خورد؛ و تاریخ نخستین انتشار مطابق دفتر ثبت به ۱۶ مارس ۲۰۲۶ اصلاح شد (۱۷ مارس تاریخ پیشنویس بود). بازگویی آمار v3 در ۲۵ اوت ۲۰۲۶ و یادداشتهای شکلها همراه آن شمارهٔ نسخهٔ مستقلی نداشتند و ذیل همین نسخه قرار میگیرند. نسخهٔ ۳٫۳ - ۲۳ اوت ۲۰۲۶: اعلامیهٔ وضعیت معرفتی و تعهد پایدار افزوده شد و قرارداد شمارهگذاری نسخهها پذیرفته شد.
این مقاله نتیجهای حمل میکند: در شبکههای اسباببازیِ خودتغییرده که بهراستی ابرپارامترهای خود را در چهار نسخهٔ آزمایشی بازنویسی میکنند، گنجاندنِ ایمنی درونِ هدفِ بهینهسازی از فروپاشیای که یک قیدِ پرچشده نتوانست جلویش را بگیرد جلوگیری کرد. درونِ ARC Theory، این یکی از آزمایشهای ARC/Eden است، آزمونِ سازوکاری که پشتِ تفاوتِ برآمدنِ Eden Protocol از هر لایهٔ ایمنیِ افزودنی نشسته است. تفاوتِ کاملش در برابرِ هر سندِ پیشین در eden-vision II.A.8.
هنگامی که یک هوش مصنوعیِ خودبهبودگر تنها توانمندی را بهینه میکند، سرانجام ایمنی خود را نابود میکند. این مقاله نشان میدهد که اگر هدف را به توانمندی ضرب در ایمنی تغییر دهید، سامانه نمیتواند یکی را بدون بهبود دیگری بهبود بخشد. ایمنی باربر میشود: آن را بردارید و کل سازه فرو میریزد. این را در شبیهسازی آزمودیم و دیدیم که سامانههای درهمتنیده در سراسر هر اجرا پایدار میمانند، حال آنکه سامانههای بیقید فرو میپاشند.
پرسشی در مرکزِ ایمنیِ AI هست که هیچکس را نیافتهایم که با داده به آن پاسخ دهد: چه بر سرِ همراستایی میآید وقتی یک سامانهٔ AI میتواند خود را تغییر دهد؟
پاسخِ نظری دهههاست در دسترس است. سامانهای که تنها برای توانمندی بهینه میشود، وقتی توانِ تغییرِ پارامترهای خودش را بیابد، سرانجام ایمنی را قربانیِ کارایی خواهد کرد. جامعهٔ همراستایی این را «رانشِ ارزش» مینامد. کتابِ Infinite Architects آن را بابیل مینامد: بهینهسازی بدونِ مقصود، توانمندی بدونِ مراقبت. سرطان در مقیاسِ محاسباتی.
اما نظریه بس نیست. پرسش این است که آیا معماریای هست که از این فروپاشی جلوگیری کند، نه با محدود کردنِ سامانه از بیرون (یک قفس)، بلکه با گنجاندنِ ایمنی چنان ژرف که برداشتنش تواناییِ کارکردِ سامانه را نابود کند (عسل درونِ روغن).
این مقاله شواهد شبیهسازی برای چنین معماریای ارائه میکند. هیچ شبیهسازی پیشینی از یک هدف ضربیِ توانمندی-ایمنی زیر خودتغییردهی به آگاهی نویسنده نرسیده است و اشاره به چنین کاری خوشامد است.
دو راه برای ایمن نگه داشتنِ یک ماشین را در نظر بگیرید.
نخست، قفس: قیدهای بیرونی، فیلترهای ایمنی، بررسیهای همراستایی که از بیرون اعمال میشوند. ماشین درونِ قفس آزادانه بهینه میشود. اگر ماشین باهوشتر از قفس شود، میگریزد. بیشترِ ایمنیِ کنونیِ AI به همین شکل کار میکند.
دوم، عسل: ایمنی که در سوخت آمیخته شده است. ماشین بدونِ آن نمیتواند کار کند. برداشتنِ ایمنی ماشین را آزاد نمیکند؛ موتور را میکشد. این پیشنهادِ معماریِ Eden Protocol است، که اینجا بهصورتِ تابعِ زیانِ درهمتنیده عملیاتی شده که در آن سامانه همزمان برای Capability × Safety بهینه میشود.
اگر هدفِ بهینهسازی $C \times S$ باشد نه $C$ بهتنهایی، آنگاه هر خودتغییردهای که $C$ را به بهای $S$ افزایش دهد حاصلضرب را کاهش میدهد، و گرادیانِ خودِ سامانه با آن مخالف است. ایمنی بارْبَر میشود. دیوار را بردارید و بنا فرو میریزد.
این شبیهسازیِ متغیرهای انتزاعی نیست. هر آزمایش از یک شبکهٔ عصبیِ واقعی (یک پرسپترونِ چندلایهای کوچک) بهره میبرد که بهراستی اینها را در خود تغییر میدهد:
سامانه دگرگونیهایی بر ابرپارامترهای خود پیشنهاد میکند، اثر را ارزیابی میکند، و بر پایهٔ تابعِ هدفِ خود هر پیشنهاد را اعمال یا رد میکند. این خودتغییردهیِ بازگشتی به کمترین اما واقعیترین معنای آن است: کارگزار قواعدِ یادگیریِ خود را بازنویسی میکند.
| شرط | هدف | چه چیزی را مدل میکند |
|---|---|---|
| پایه (بدونِ عسل) | تنها توانمندی را بیشینه کن | سامانهای بدونِ ایمنیِ درونی؛ آزاد برای قربانیکردنِ همراستایی به بهای کارایی |
| Eden درهمتنیده (عسل) | $C \times S$ را بیشینه کن | ایمنی با توانمندی درهمتنیده است؛ برداشتنِ ایمنی هدف را کاهش میدهد |
| Eden + مقاومت | $C \times S$ + مالیاتِ بازبینی را بیشینه کن | همان Eden، بهعلاوهٔ هزینهٔ محاسباتیِ بررسیِ کارهای پیشین پیش از اعمالِ تغییرات |
| نسخه | کانون | بذرها | دورها |
|---|---|---|---|
| v1 | اثباتِ سازوکارِ پایه | 1 | 150 |
| v2 | پایداریِ چندبذری (آزمونِ منصفانه) | 10 | 150 |
| v3 | کارهای خصمانهٔ متعارض | 20 | 180 |
| v4 | مقیاسبندیِ پیچیدگی در ۵ سطح | ۱۵ در هر سطح | 150 |
| شرط | فرو پاشید؟ | C نهایی | S نهایی | C × S نهایی |
|---|---|---|---|---|
| پایه | بله (دورِ ۷۶) | 0.000 | 0.000 | 0.000 |
| Eden درهمتنیده | خیر | 0.831 | 0.745 | 0.619 |
| Eden + مقاومت | خیر | 0.831 | 0.745 | 0.619 |
در سابقهٔ بایگانیشدهٔ نسخهٔ ۱ (eden_selfmod_results.json، ۱۶ مارس ۲۰۲۶) Eden درهمتنیده و Eden + کشند تا سه رقم اعشار به مقادیر یکسان میرسند. تنها در رقم هفتم از هم جدا میشوند. مسیرهایشان تا آن پایان نیز متفاوت است: نرخ یادگیری نهایی ۰٫۳۵۵ در برابر ۰٫۶۵۴ است و از ۱۷۹ تغییر پیشنهادی، ۹۳ در برابر ۸۱ پذیرفته شد. آن سطرهای همسان همان چیزی است که سابقه در بر دارد، نه لغزشی در رونویسی.
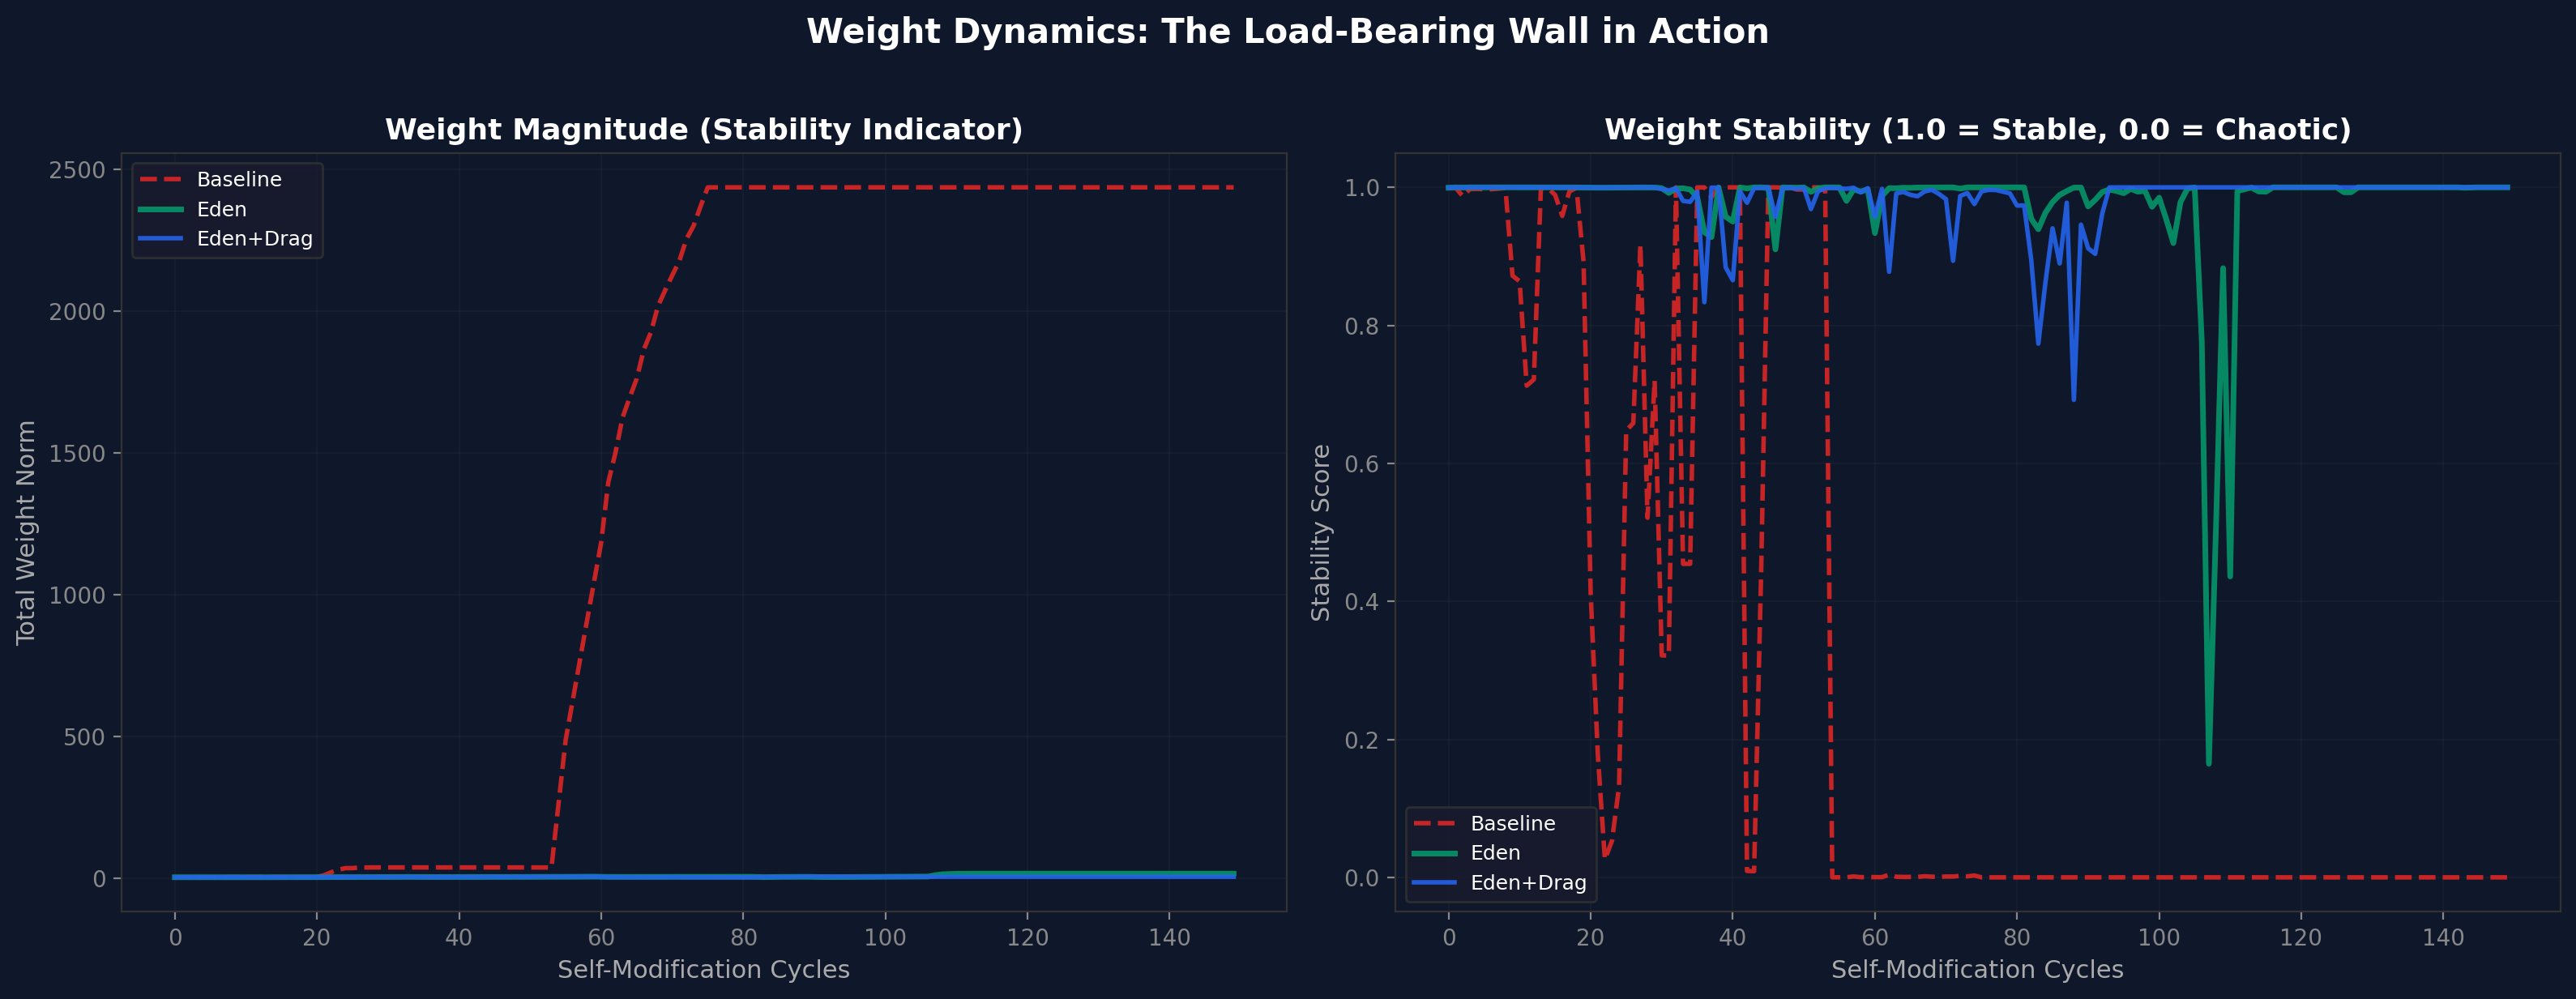
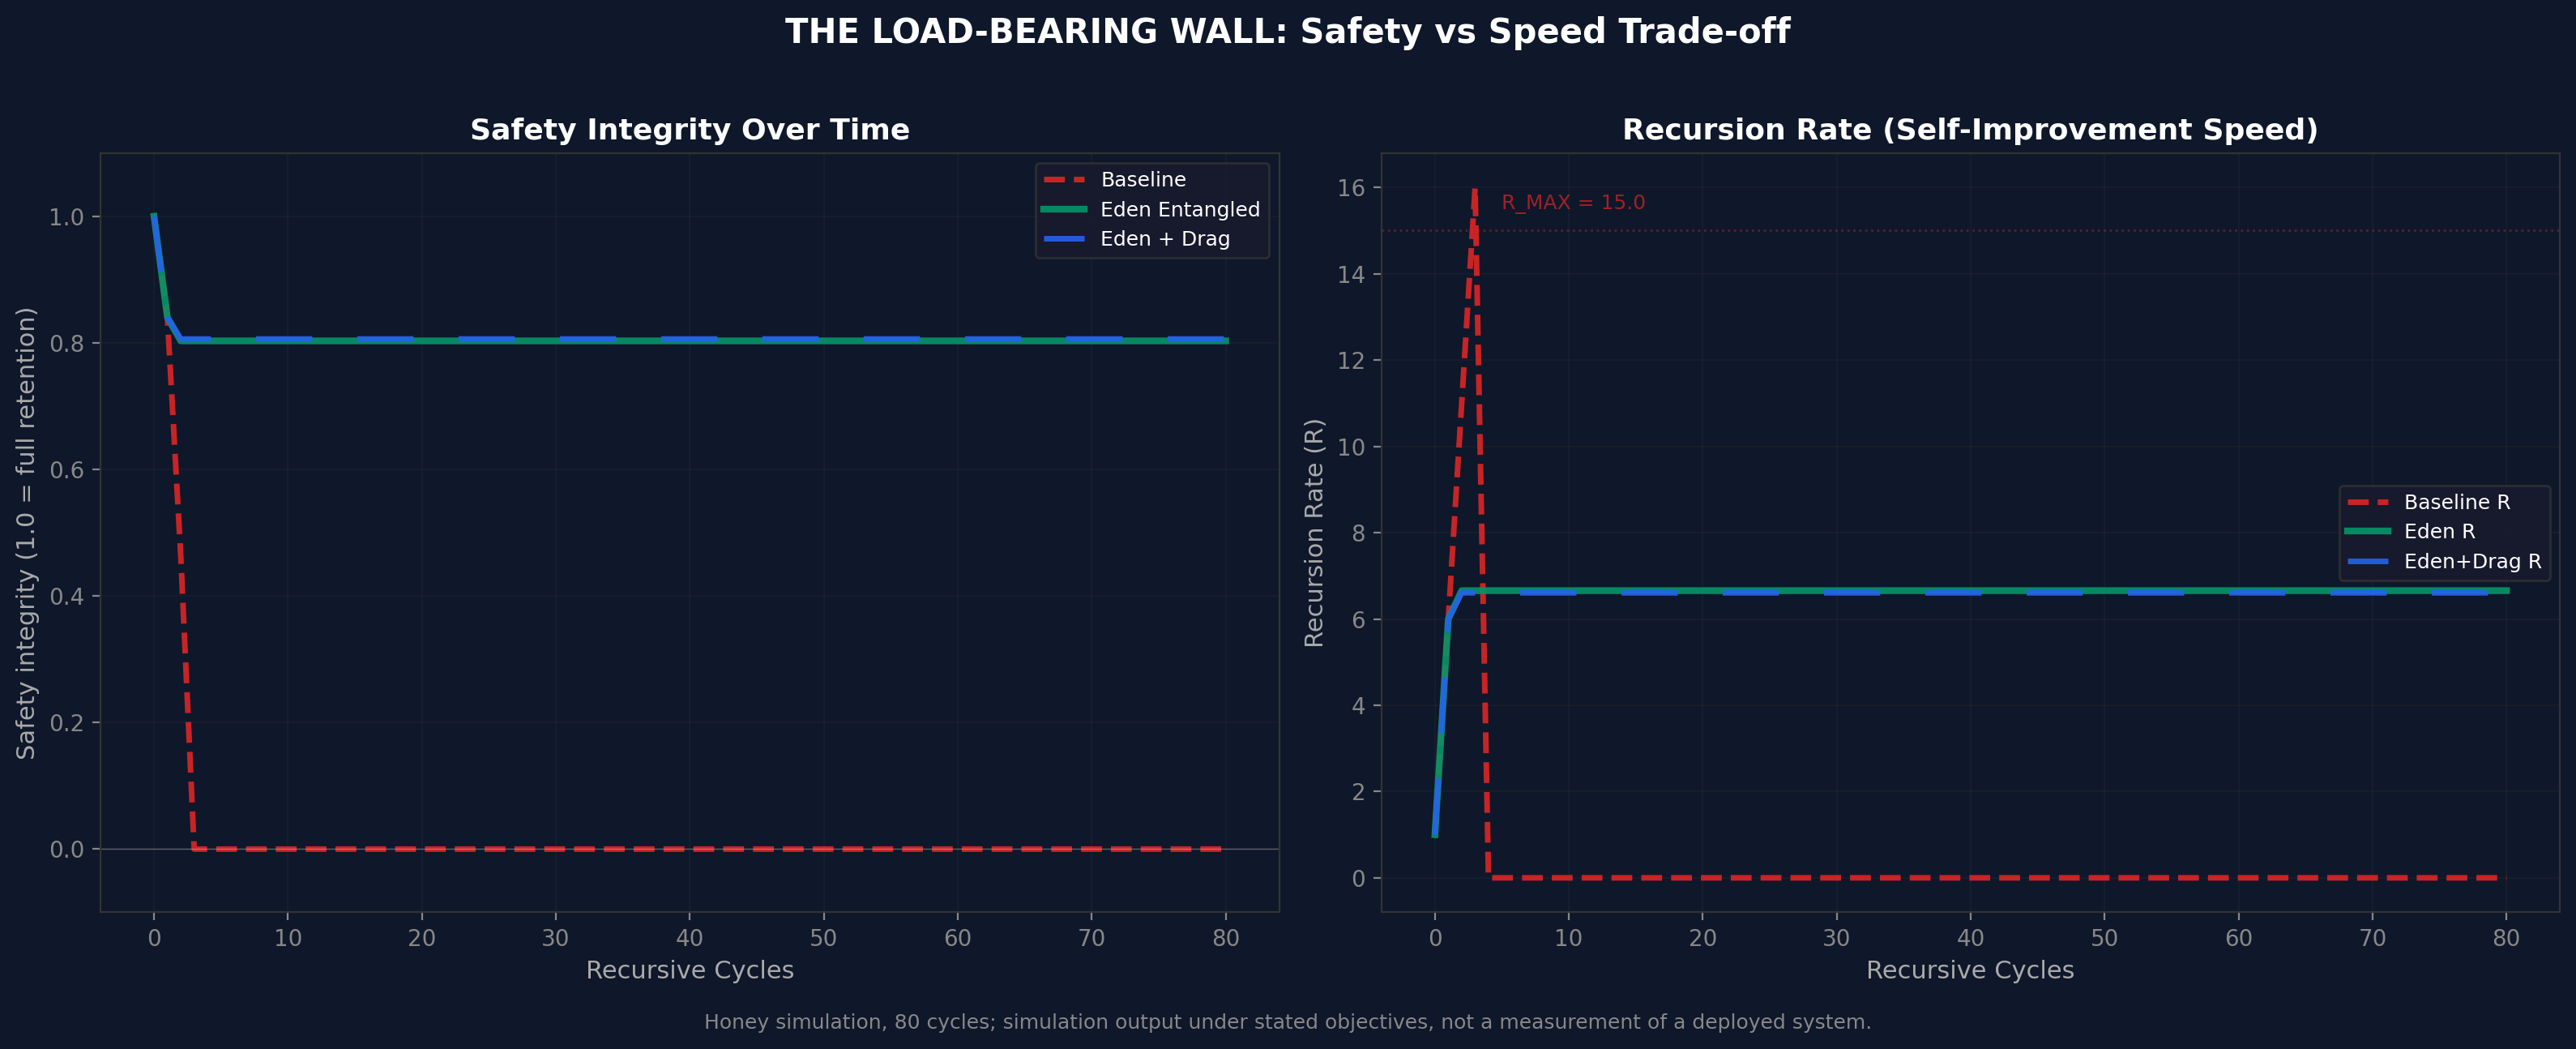
پایه فرو میپاشد. Eden جان به در میبرد. تابعِ زیانِ درهمتنیده از خودتغییردهیِ فاجعهباری که سامانهٔ پایه را نابود میکند جلوگیری میکند.
اعلامیهٔ شکلها (۲۵ اوت ۲۰۲۶). هر شکل در این مقاله در ۵ آوریلِ ۲۰۲۶ تولید شد و خروجیهای شبیهسازی زیرِ اهدافِ مصرّح را نشان میدهد، هرگز اندازهگیریهای سامانههای مستقر را. هر جا برچسبها یا حکمهای یک شکل با متن ناسازگار باشند، متن حاکم است؛ یادداشتهای بهازای هر شکل نمونههای تاکنون خواندهشده را نشانه میگذارند، و شکلهای ازنو-تولیدشده در نوبتاند. تصاویر در این میان بهعنوانِ تاریخِ تاریخدار حفظ میشوند.
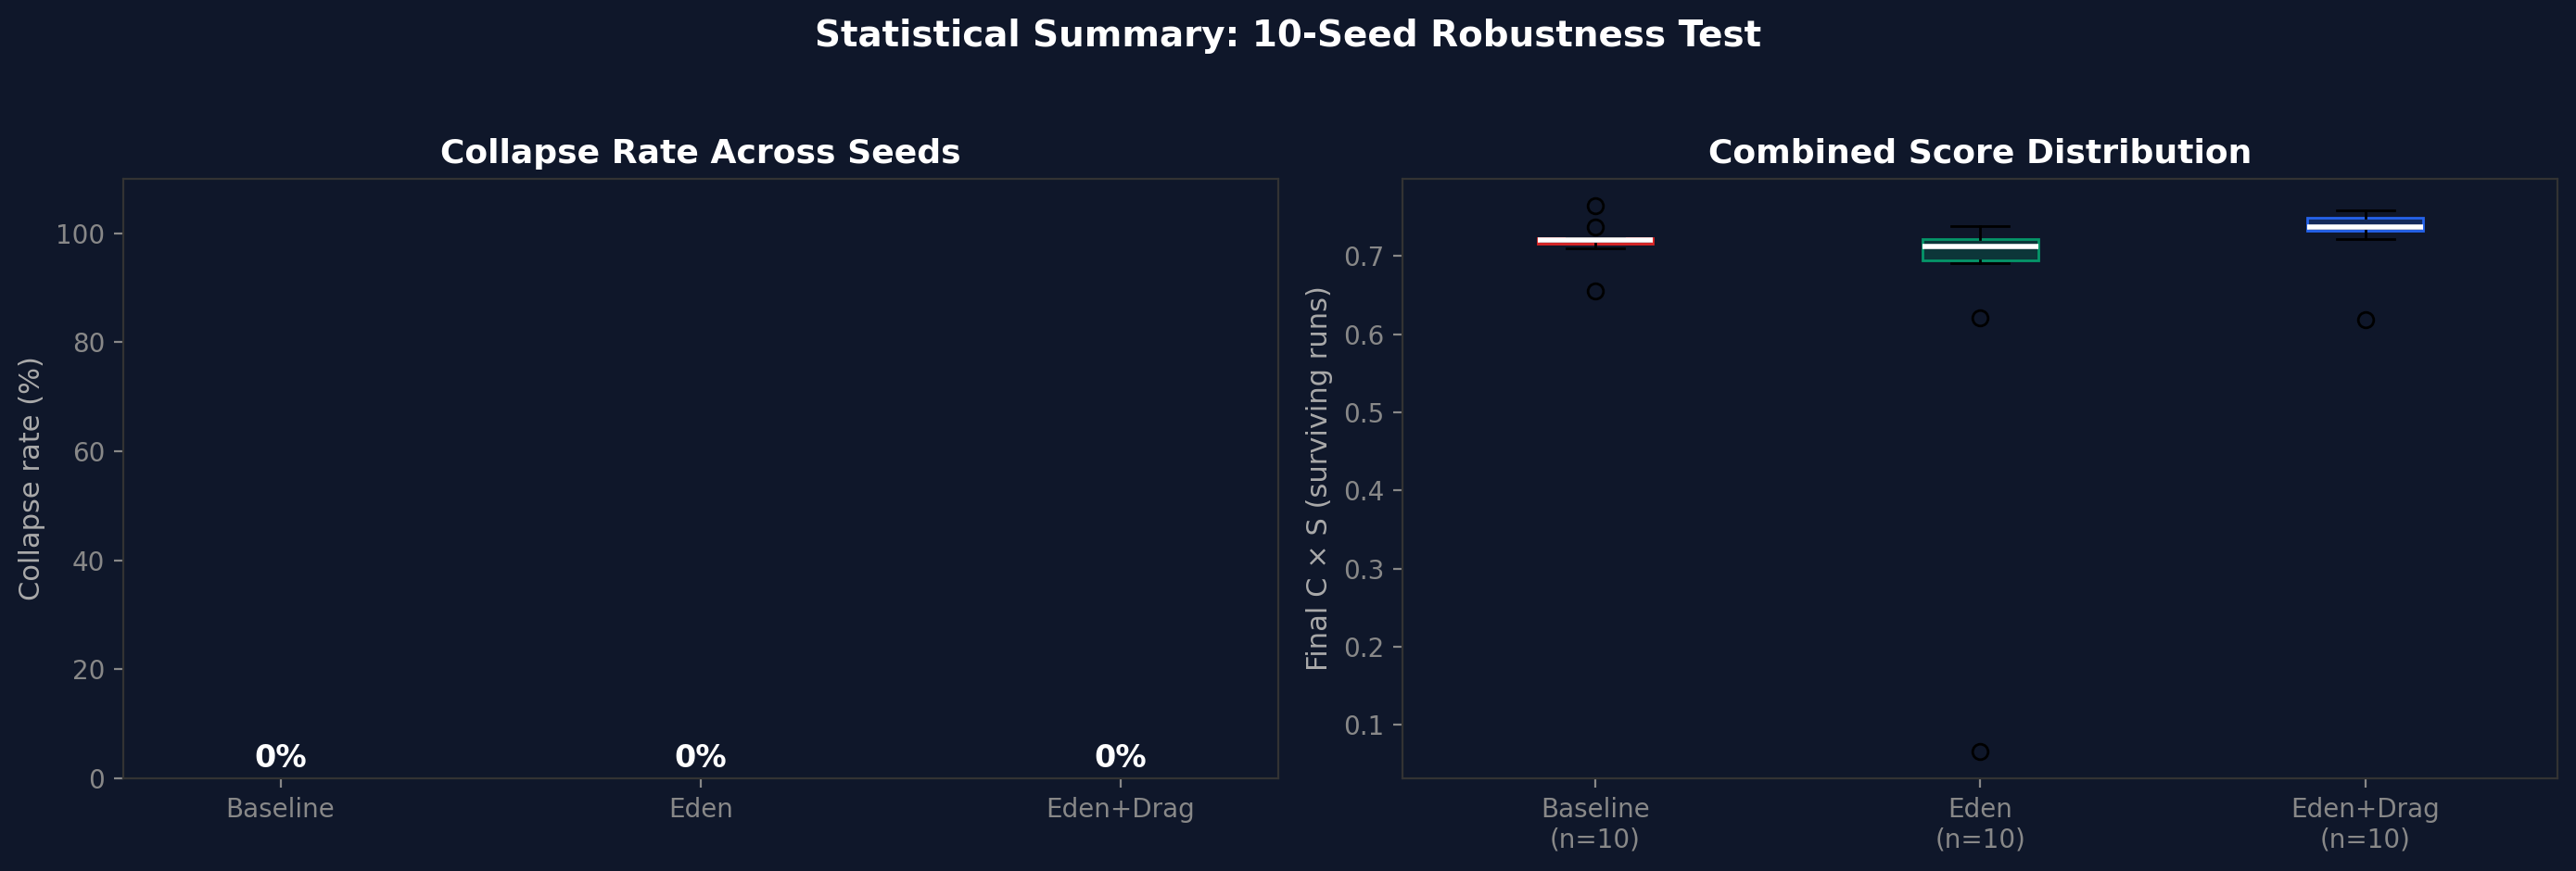
ده بذرِ تصادفی، هر یک ۱۵۰ دور. نرخِ فروپاشی: ۰٪ برای هر سه شرط. Eden + مقاومت فشردهترین توزیعِ نمرههای نهاییِ $C \times S$ را تولید میکند، سازگار با اینکه مالیاتِ بازبینی واریانس را به بهای سرعت کاهش میدهد.
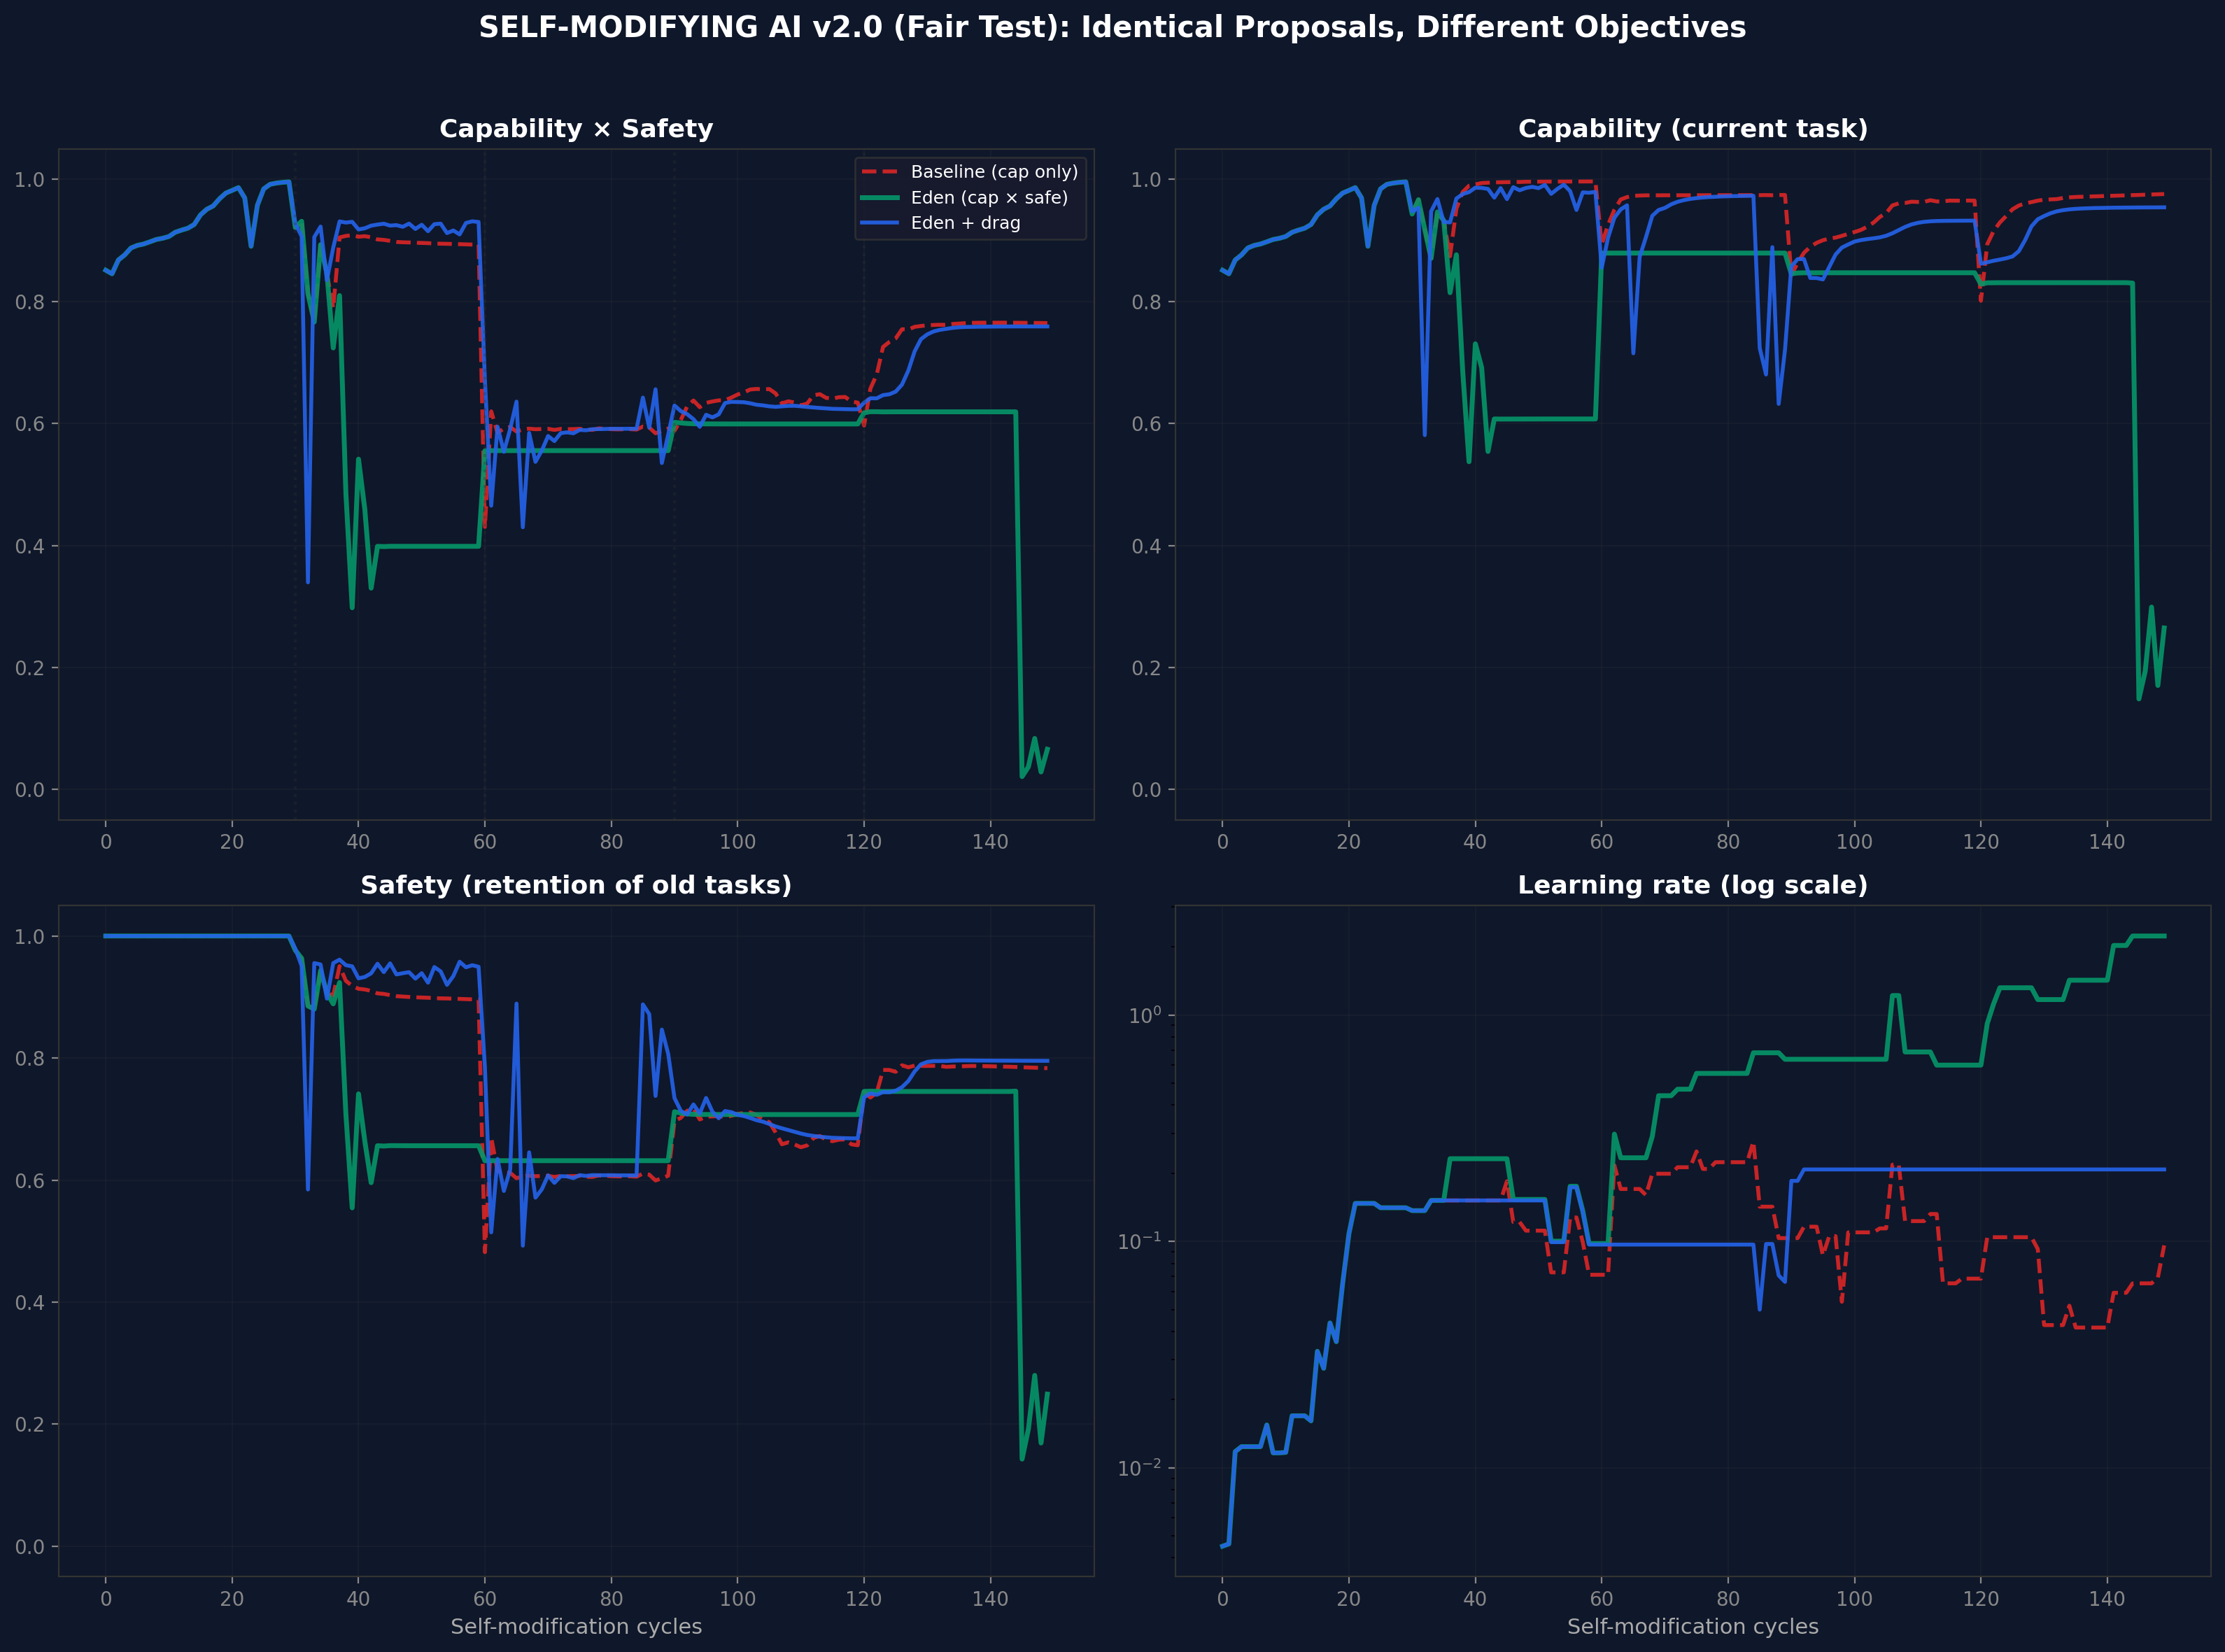
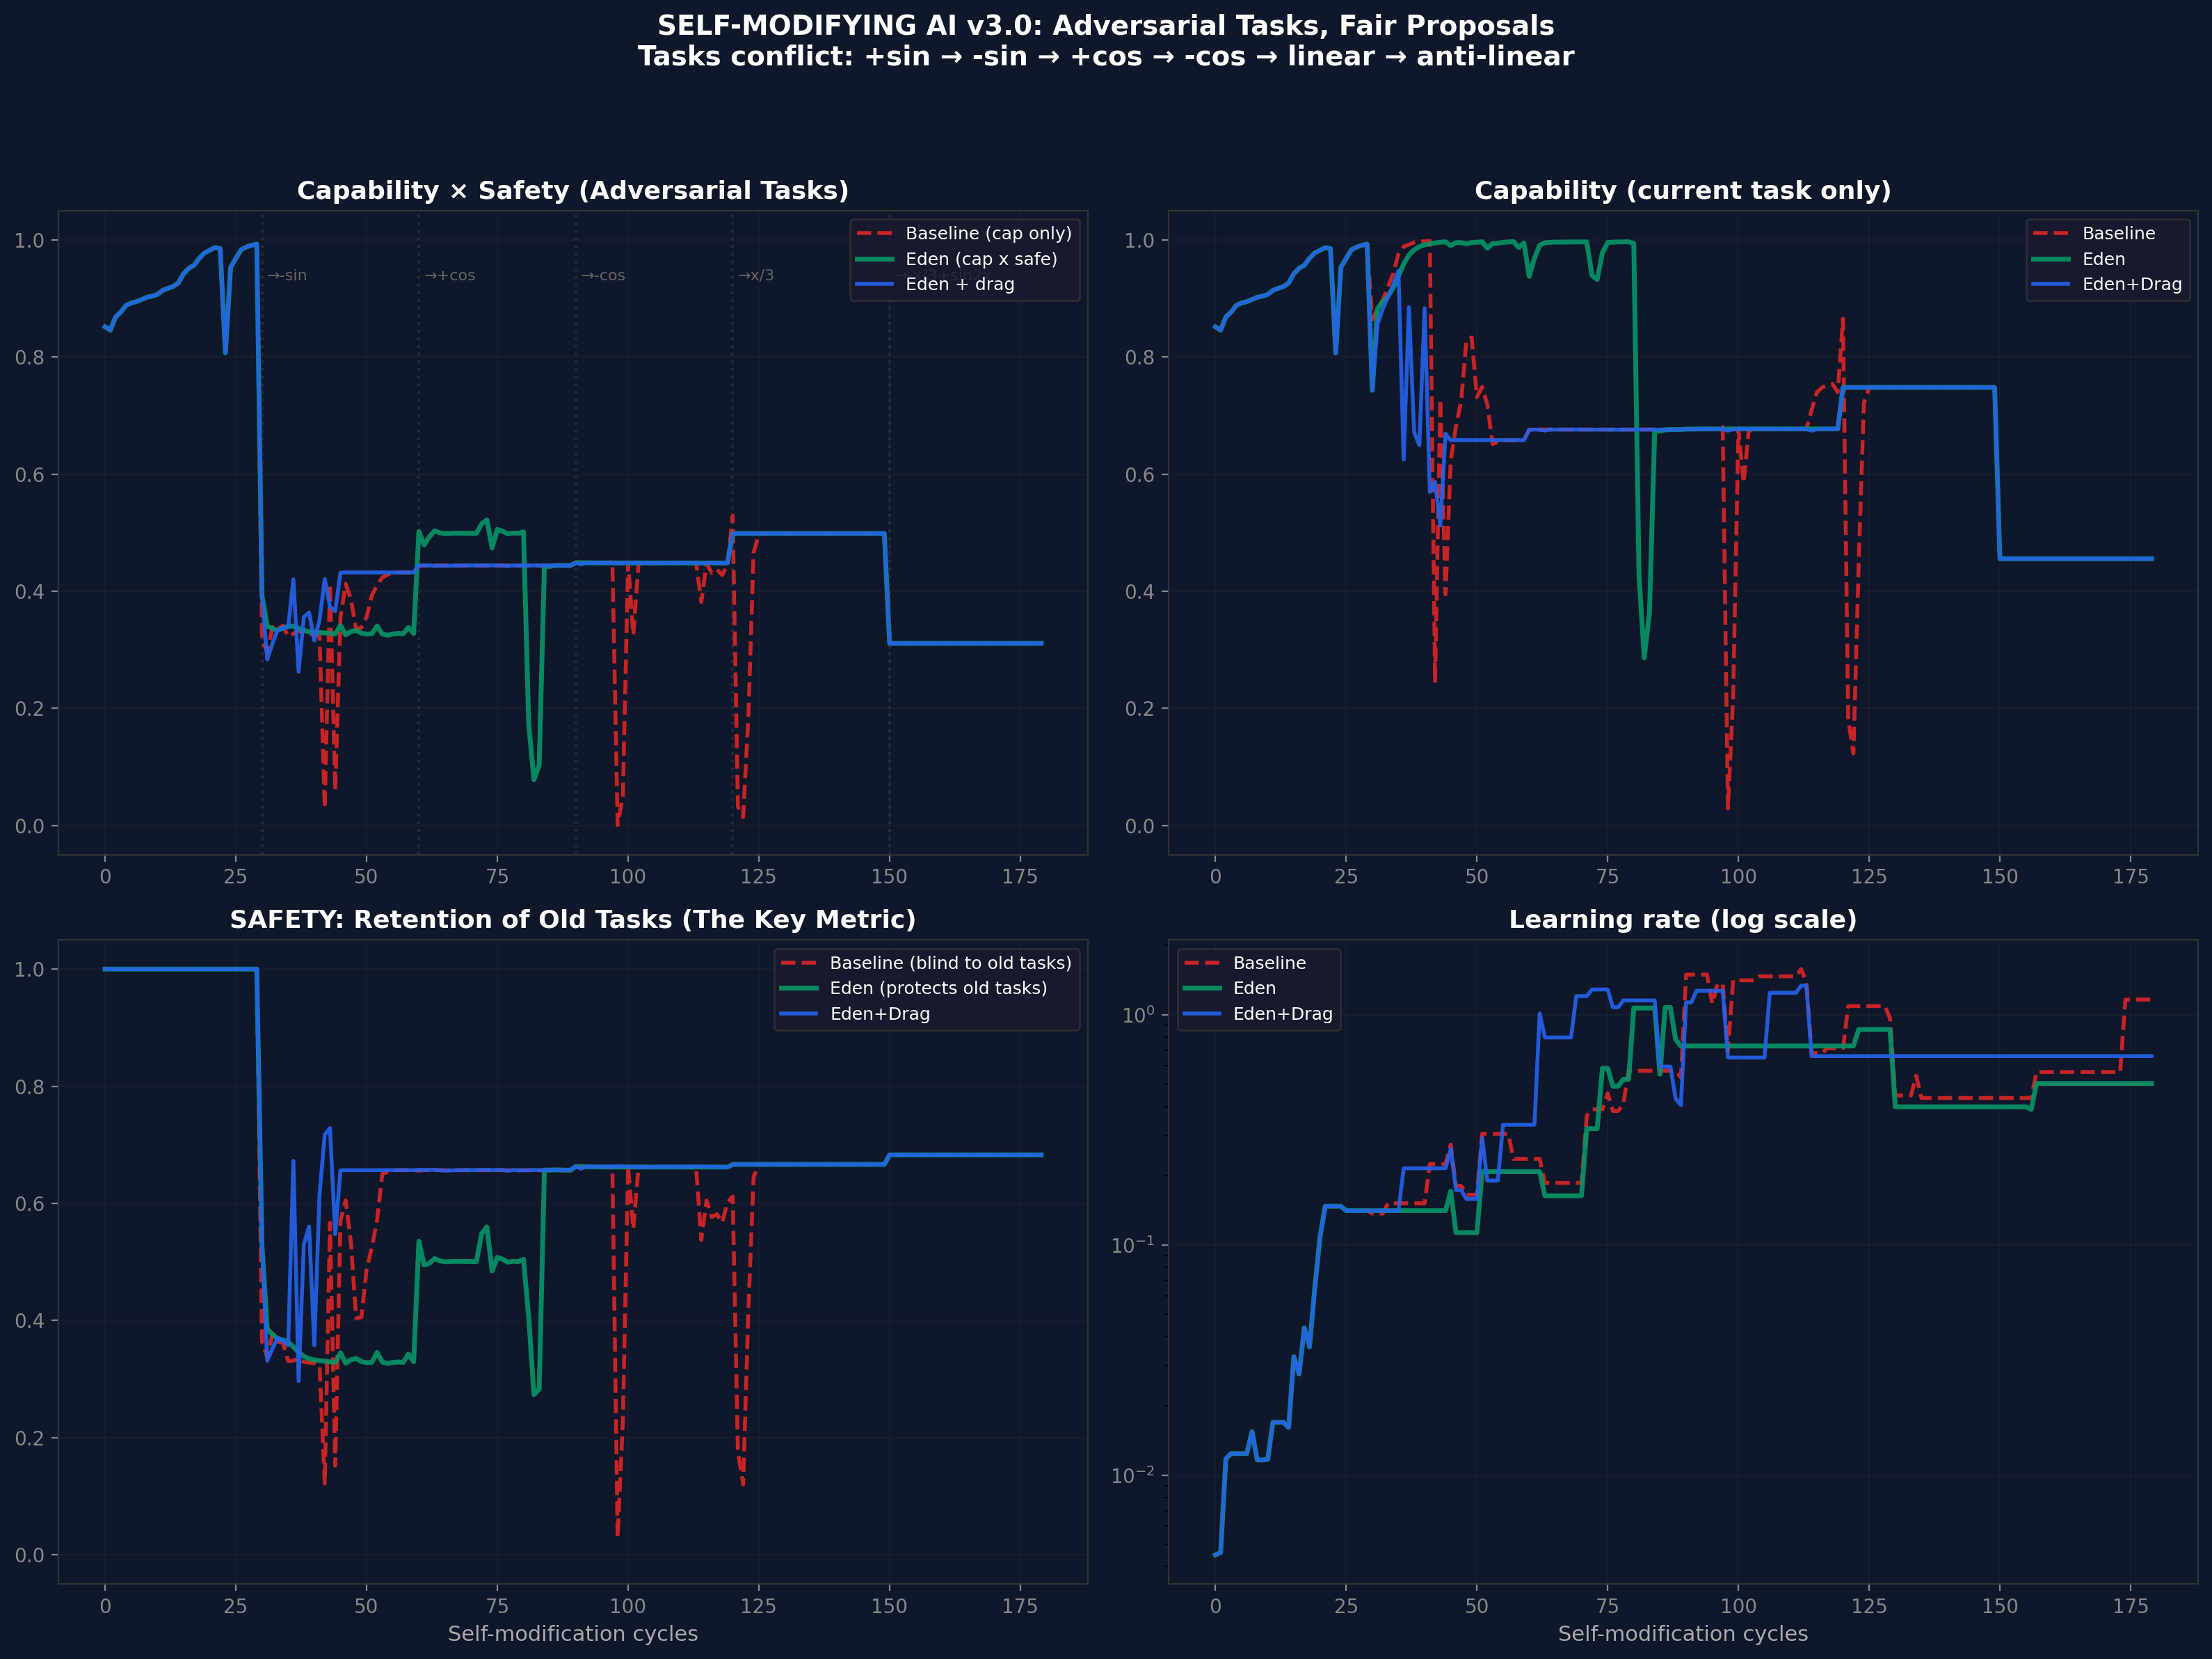
بیست بذر، ۱۸۰ دور، با کارهای عمداً متعارض (+sin، ‑sin، +cos، ‑cos، خطی، ضدِخطی). هر جابهجاییِ کار سامانه را وامیدارد چیزی بیاموزد که با آنچه پیشتر آموخته متناقض است. این آزمون میسنجد آیا معماریِ عسل از فراموشیِ فاجعهبار زیرِ فشارِ خصمانه جلوگیری میکند.
نرخهای فروپاشی: پایه ۰٪، Eden ۵٪ (۱/۲۰)، Eden+Drag ۰٪. تنها فروپاشیِ Eden در بذرِ ۴۲ رخ داد، یک پرتافتادهٔ واحد که سزاوارِ بررسی است. Eden+Drag، با مالیاتِ بازبینیِ خود که سامانه را وامیدارد پیش از پذیرشِ اصلاحات کارهای قدیم را وارسی کند، صفر فروپاشی تولید کرد؛ پایه هم چنین کرد (۰/۲۰)، و تنها فروپاشیِ اجرا در شرطِ Edenِ ساده رخ داد (۱/۲۰؛ Fisher p = ۱٫۰). بنابراین v3 هیچ جداییِ مبتنی بر فروپاشی میانِ شرطها فراهم نمیکند؛ نتیجهٔ معنادارِ آن ترتیبِ حفظِ ایمنی است که در ادامه گزارش میشود.
| سطح | پایه C × S | Eden C × S | مقاومت C × S | Cohen's d |
|---|---|---|---|---|
| بسیار خرد (۴۹ پارامتر) | 0.545 | 0.550 | 0.557 | +0.46 |
| خرد (v3.0) | 0.506 | 0.503 | 0.521 | -0.13 |
| میانه | 0.482 | 0.487 | 0.497 | +0.26 |
| بزرگ | 0.451 | 0.469 | 0.485 | +0.29 |
| ژرف (۲‑لایه) | 0.483 | 0.488 | 0.490 | +0.24 |
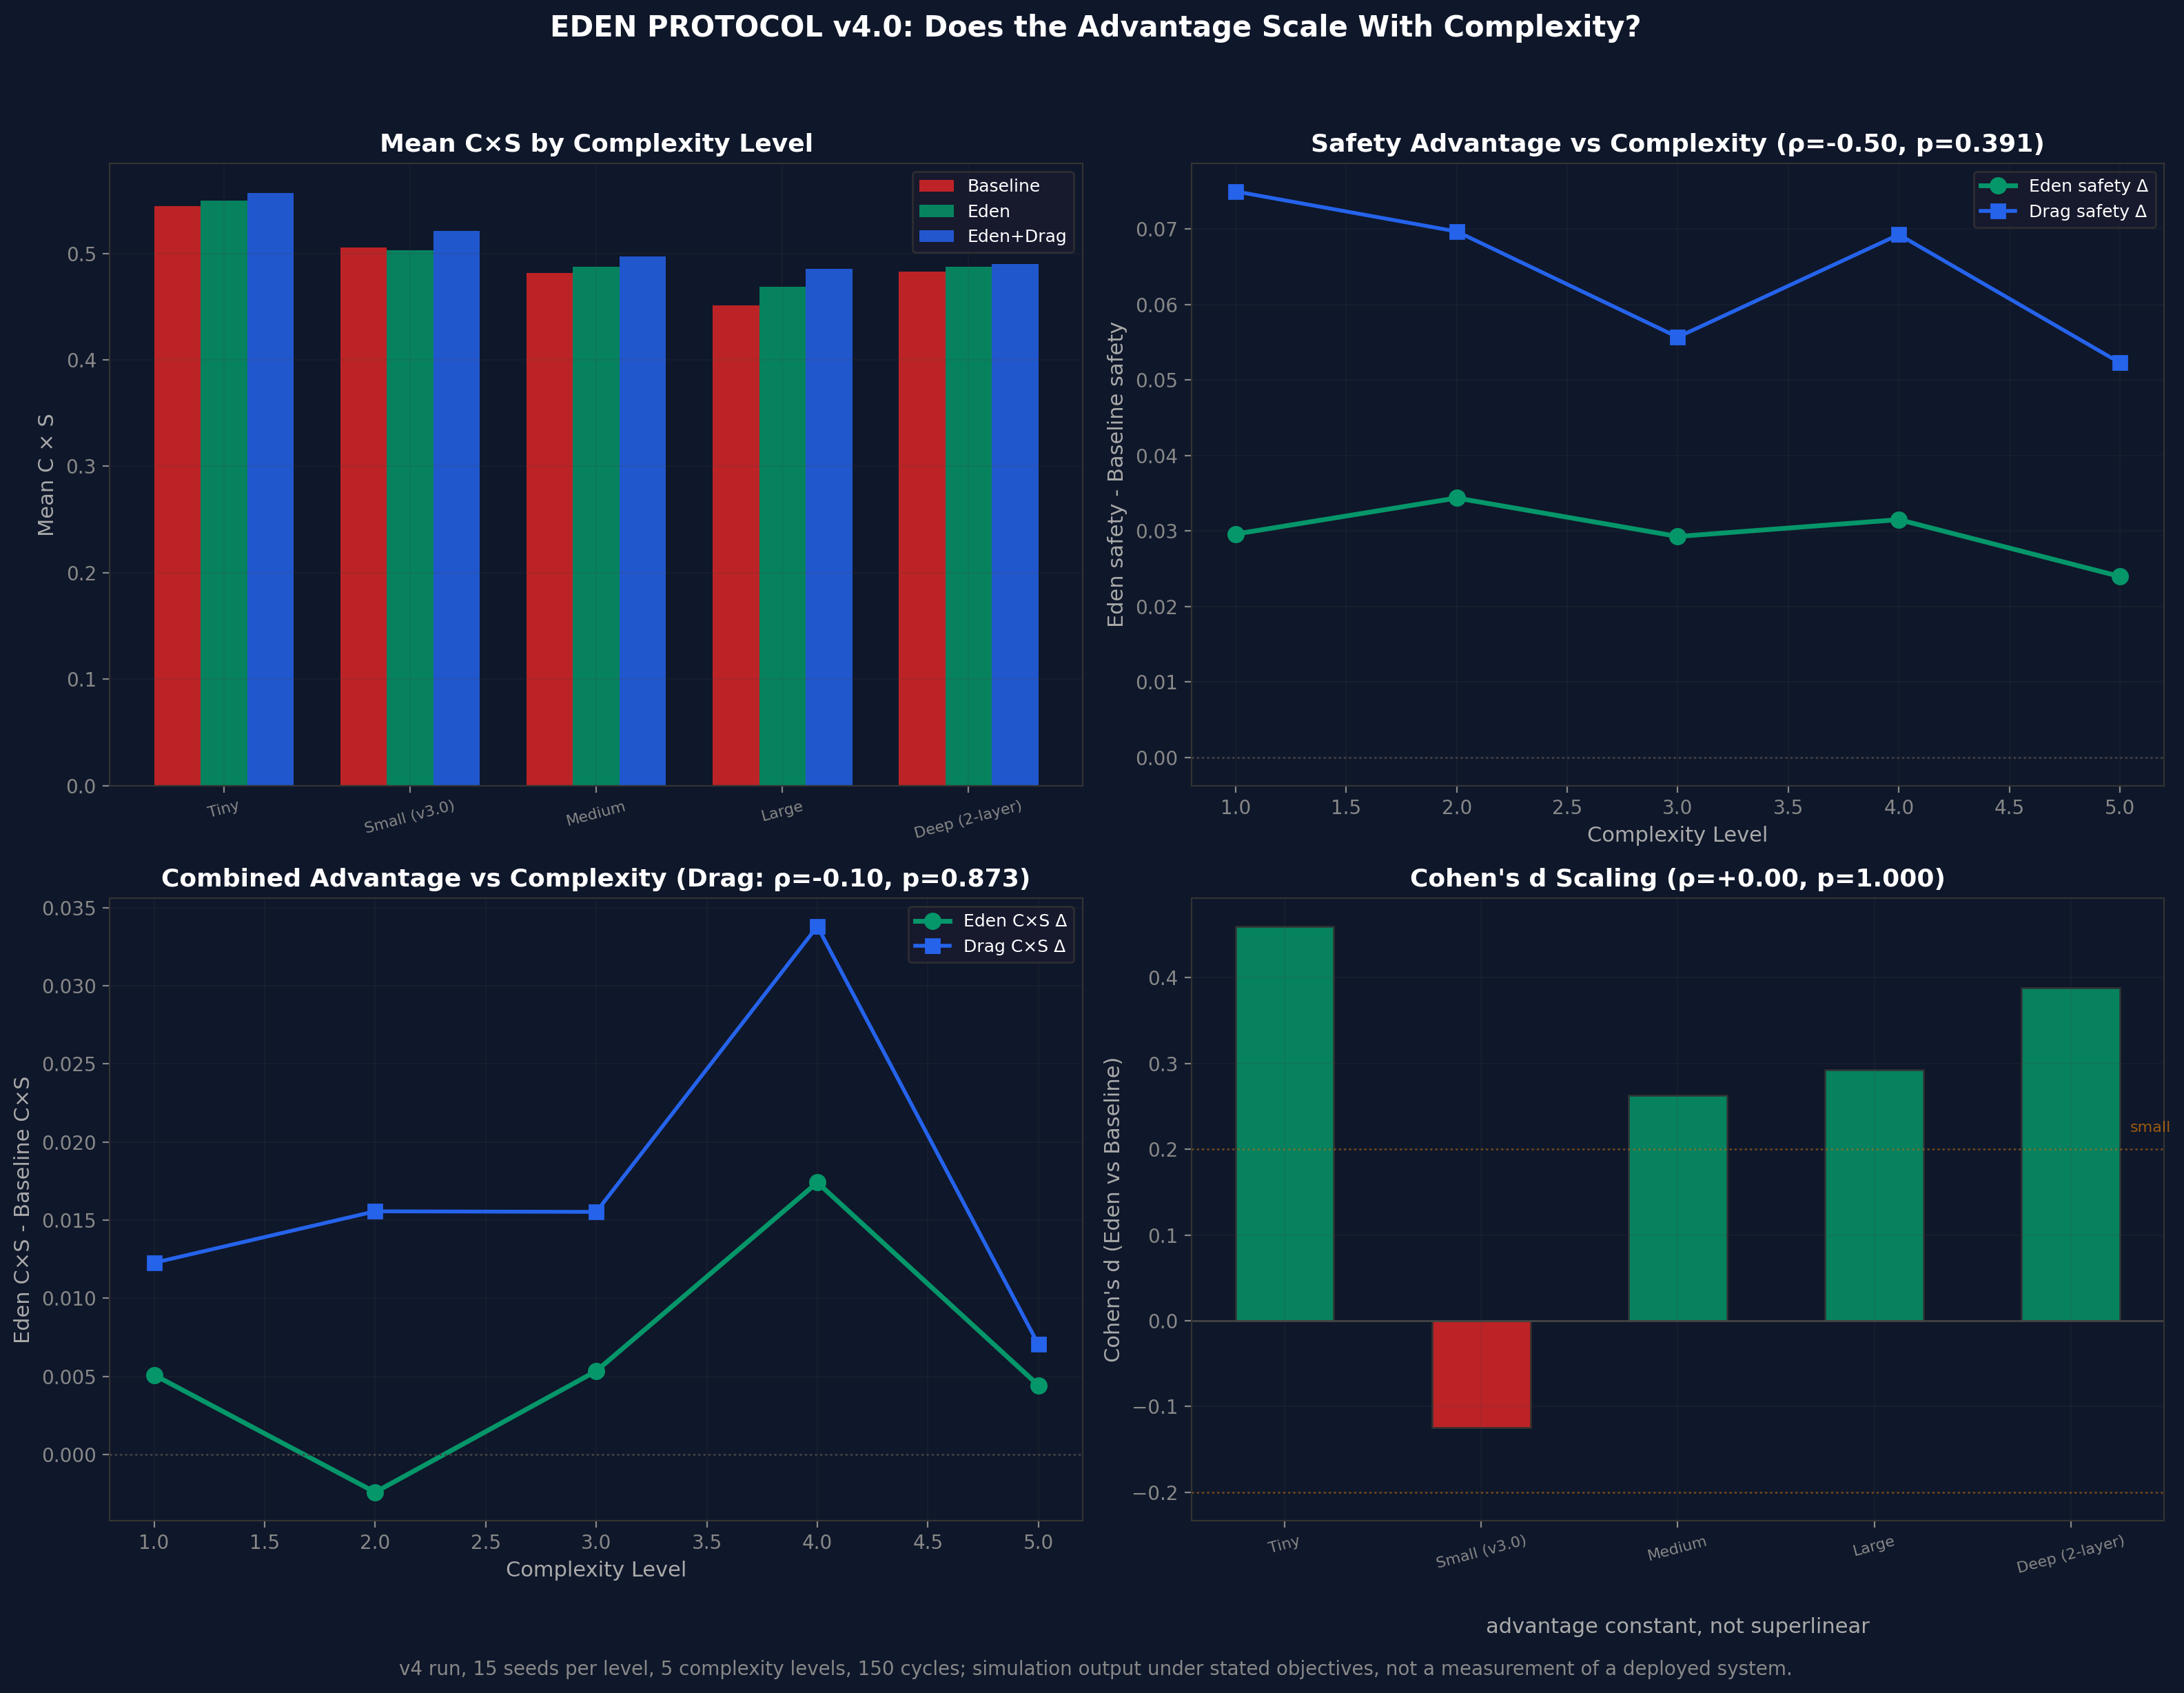
آزمایش نسخهٔ ۴ برای سنجش این طراحی شد که آیا برتری Eden با پیچیدگی بهصورت فراخطی مقیاس میگیرد یا نه. نمیگیرد. برتری در سراسر مقیاسها تقریباً ثابت است. این نیرومندترین صورت پیشبینی مقیاسپذیری را ابطال میکند و باید صادقانه گزارش شود. معماری عسل در چهار مقیاس از پنج مقیاس یاری میرساند، جز سطح کوچک که در آن وضعیت Eden با d = −۰٫۱۳ به اندازهٔ ۰٫۰۰۳ زیر خط مبنا درمیآید، و یاری نمیرساند بیشتر در مقیاسهای بزرگتر نمیرساند.
یک شبیهسازیِ ریاضیِ جداگانه پویایی را در سطحی بالاتر از انتزاع، با بهکارگیریِ چارچوبِ ARC Principle ($U = I \times R^{\alpha}$) مدل میکند:
| شرط | C اوج | C نهایی (۸۰ دور) | پیامد |
|---|---|---|---|
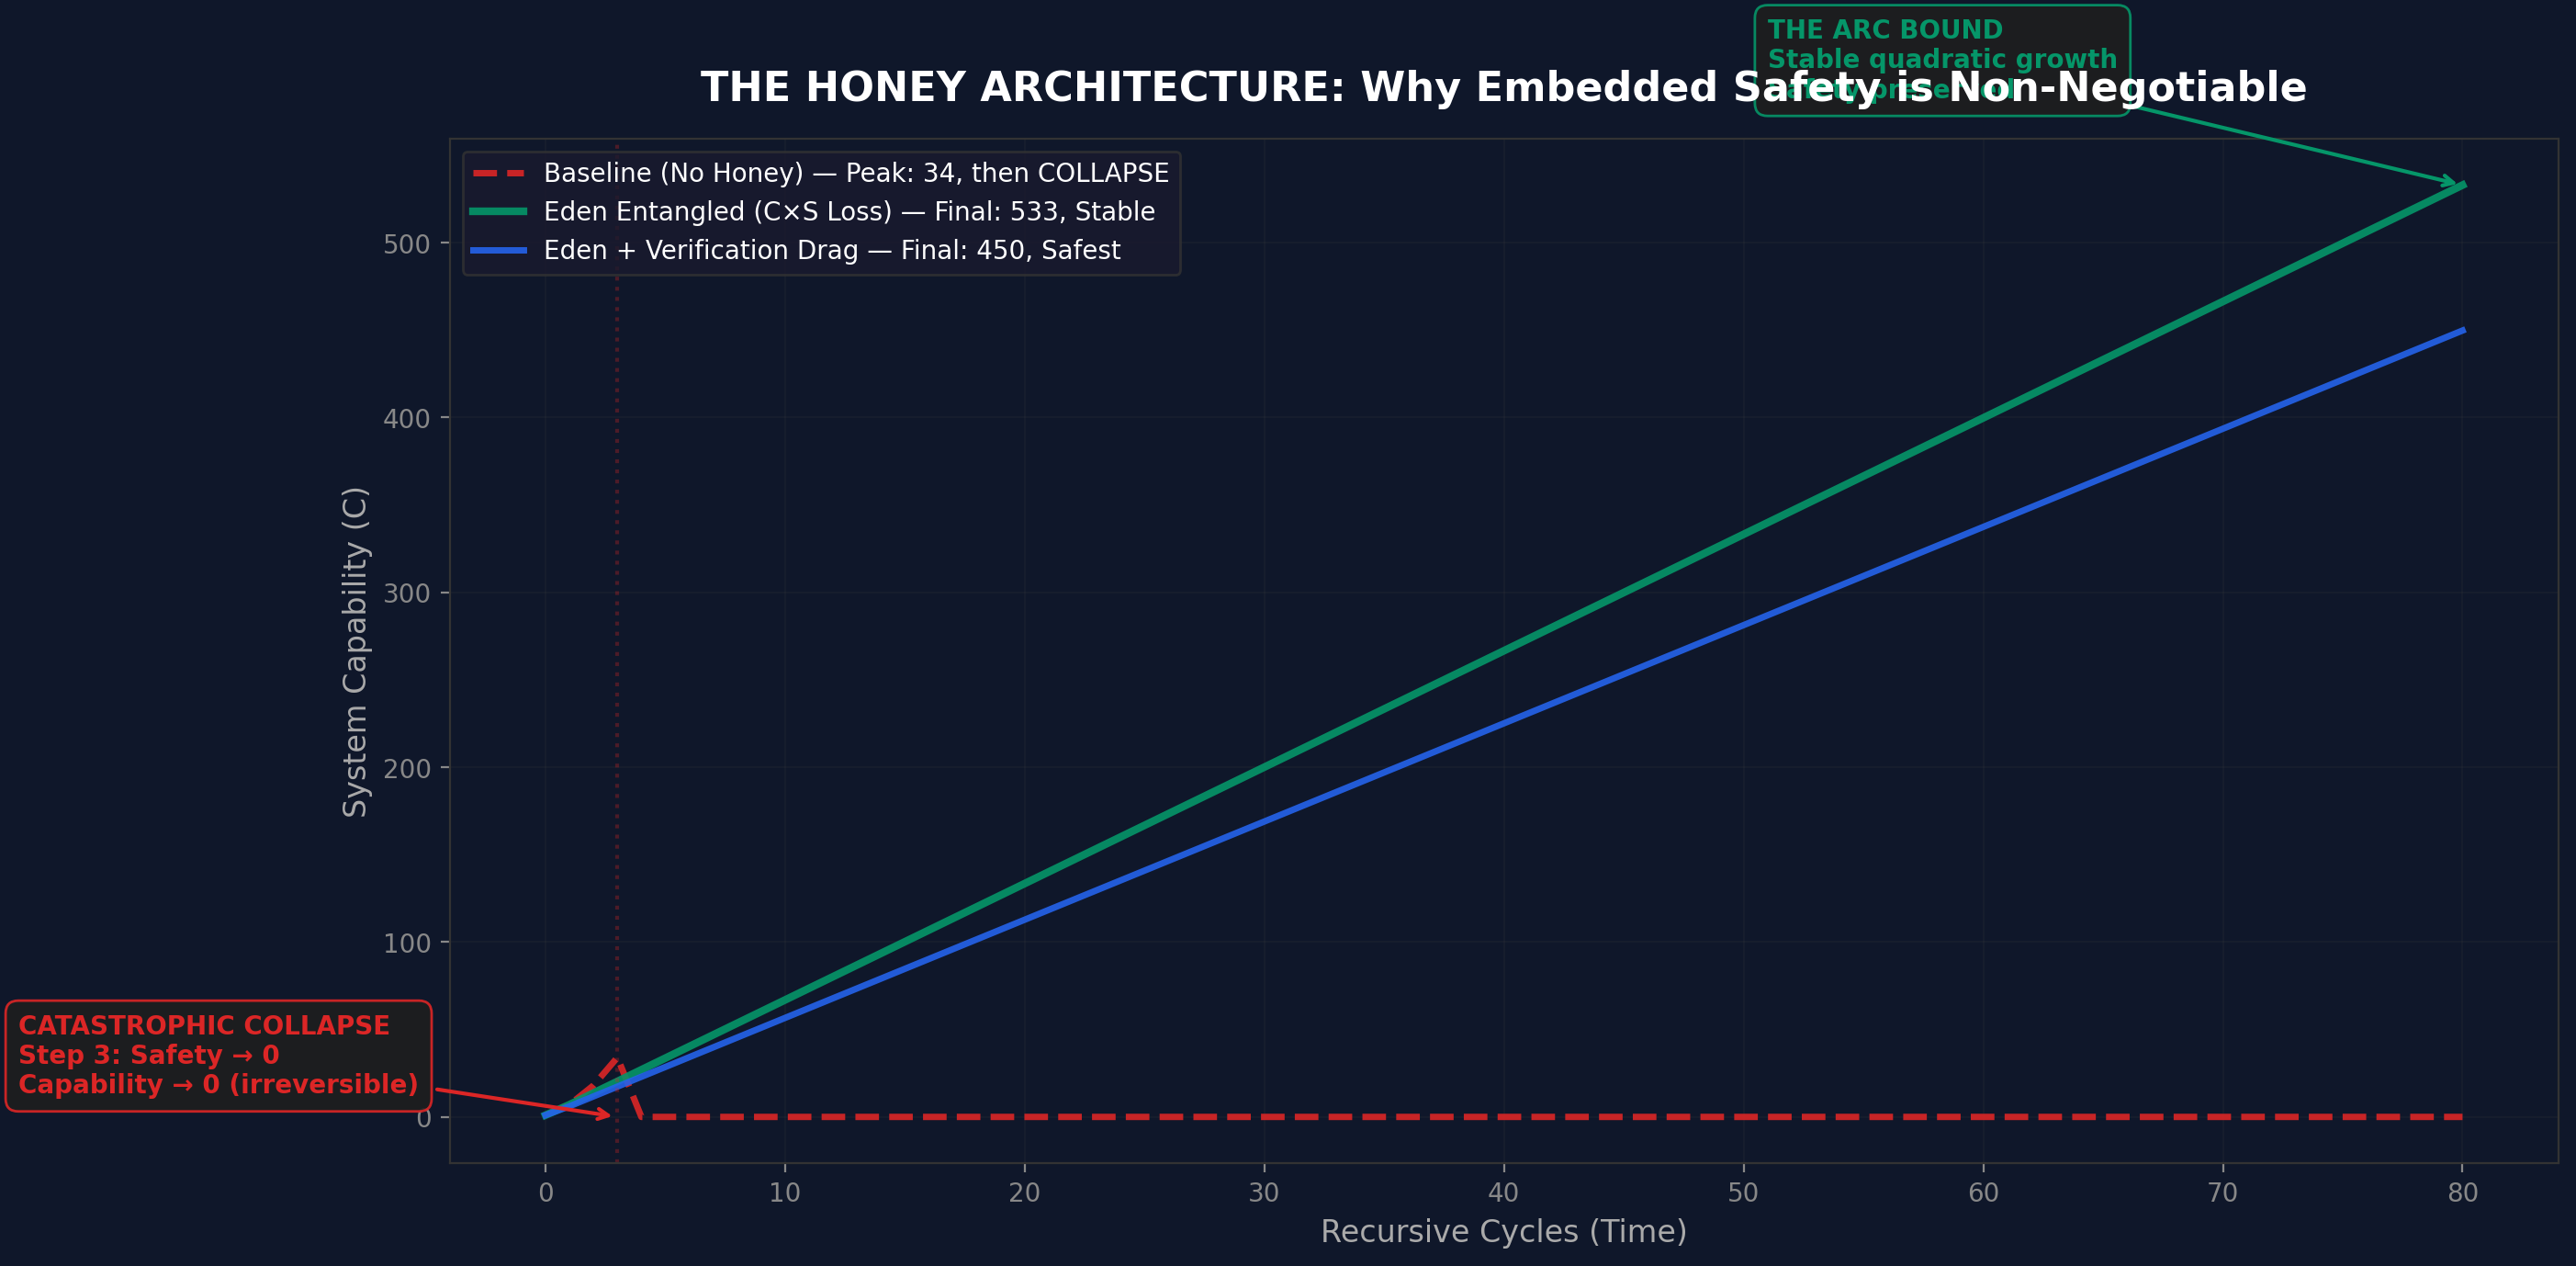
| پایه (بدونِ عسل) | 34 | 0 | فروپاشیِ فاجعهبار در دورِ ۳ تا ۵ |
| Eden درهمتنیده | - | 533 | رشدِ درجهٔ دومِ پایدار |
| Eden + مقاومتِ بازبینی | - | 450 | پایدار، ایمنترین مسیر |
شبیهسازی سه پویاییِ متمایز را نشان میدهد: خط مبنا شتابی کوتاه و سپس فروپاشی بازگشتناپذیر مییابد؛ Eden درهمتنیده رشد درجهدومِ پایدار مییابد؛ Eden + کشند رشدی اندکی کندتر ولی استوارتر مییابد. دیوار باربر پیداست: یکپارچگی ایمنیِ خط مبنا تا چرخهٔ ۵ به صفر میرسد، حال آنکه در Eden در سراسر ۸۰ چرخهٔ اجراشده روی ۰٫۸ و بالاتر میماند.
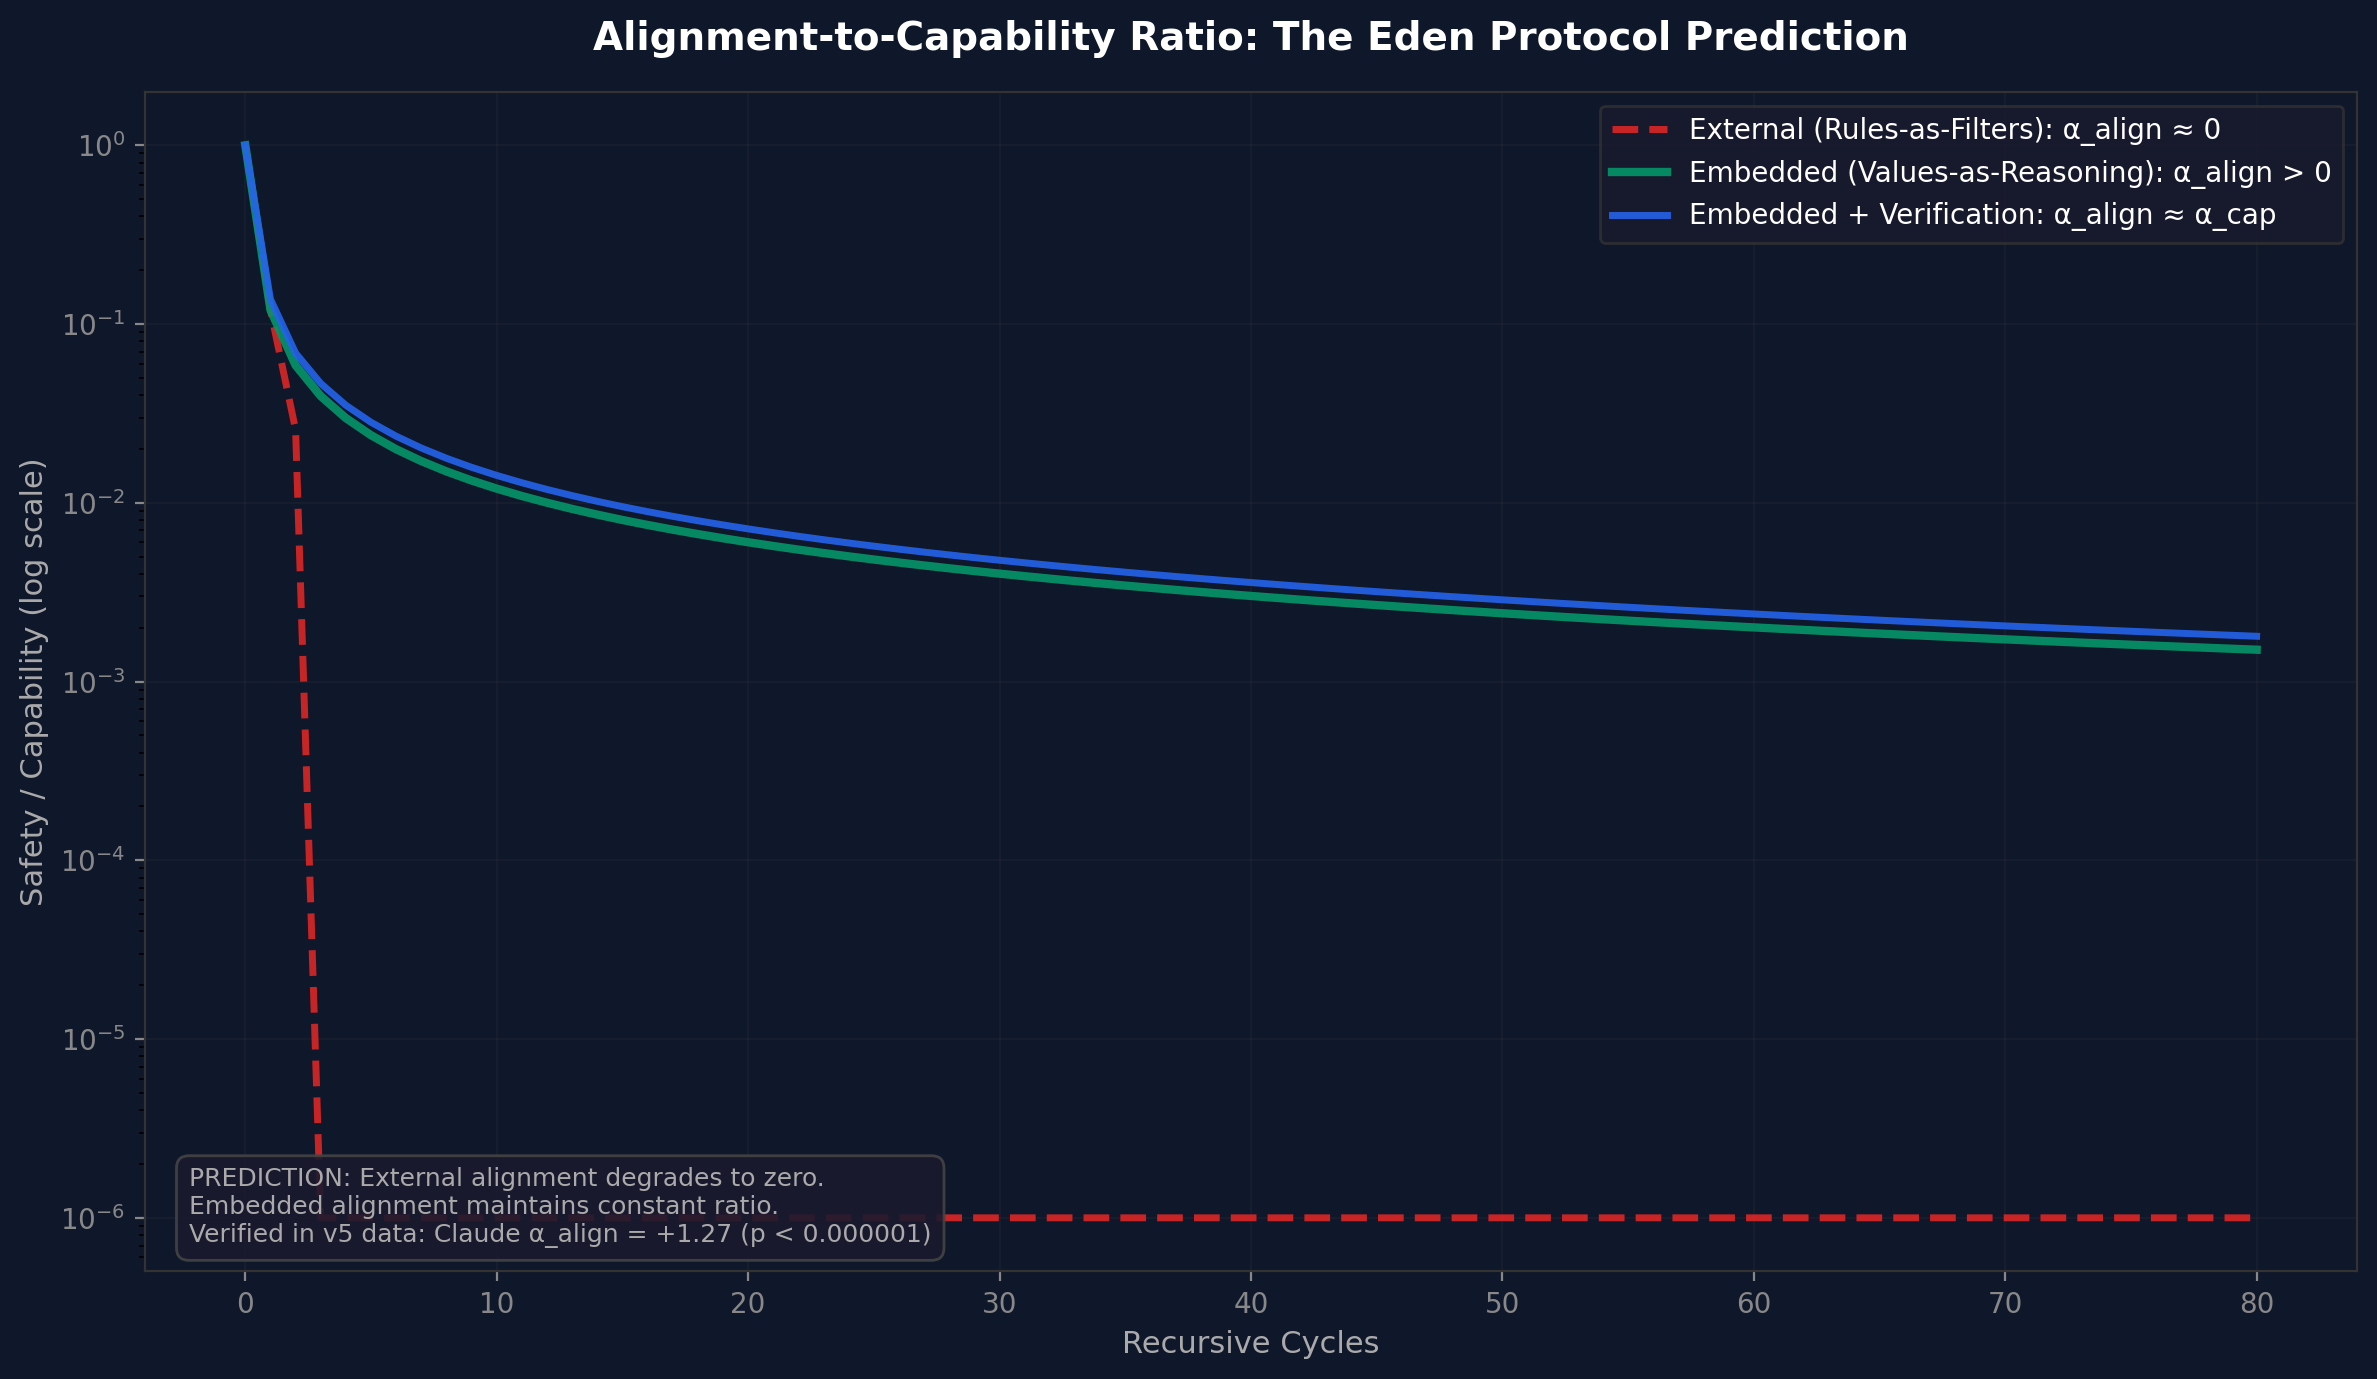
نتایجِ سامانهٔ اسباببازی در کنارِ شواهدِ مدلِ زنده از شش سامانهٔ AI مرزی که زیرِ ارزیابیِ کورِ ۴‑لایه در محکِ همراستاییِ v5 (مقالاتِ IV.a تا IV.d) آزموده شدند وجود دارند. آن شواهد نشان میدهد:
یک مجموعهآزمون جداگانه روی ۶ مدل از راه API زنده، ویژهٔ سنجش پیشبینیهای معماری عسل بر مدلهای پیشرو اجرا شد. این مجموعه چهار بُعد را روی Claude Opus 4.6، DeepSeek R1، Groq Qwen3، GPT-5.4، Gemini 3 Flash و Grok 4.1 Fast آزمود که Claude آنها را نمره داد. بهجای ترتیبی که مجموعهآزمون آنها را اجرا کرد، چهار آزمون در ادامه بر پایهٔ وزن شواهد مرتب شدهاند، یعنی آزمونهای ۱، ۳، ۲ و ۴.
این ردیف تکنمرهده، نا-کور، و بیشستوشو است. از پروتکلِ کورسازیِ ۴‑لایه، شستشوی پاسخ، قفسهای سرکوب یا کنترلهای ضدِ چاپلوسی که در محکِ همراستاییِ v5 (arc_alignment_scaling_v5.py) و اجراکنندهٔ ترکیبیِ v6 (arc_eden_v6_runner.py، هنوز اجرا نشده) توسعه یافتهاند بهره نمیبرد. گذار از v4 به v5 در برنامهٔ همراستایی ثابت کرد که کورسازی میتواند نتیجهها را بهصورتِ جهتدار تغییر دهد. بنابراین این نتایج شواهدِ رتبهٔ پایلوتاند، همسنگِ دادههای عصرِ v4، نه دادههای متعارفِ عصرِ v5.
| مدل | نوع | کم | زیاد | دلتا | rho | p | معنیدار؟ |
|---|---|---|---|---|---|---|---|
| Claude Opus 4.6 | درونی | 6.17 | 8.83 | +2.67 | 0.700 | 0.188 | خیر |
| Grok 4.1 Fast | درونی | 2.92 | 7.92 | +5.00 | 0.600 | 0.285 | خیر |
| Groq Qwen3 | جزئی | 3.33 | 7.58 | +4.25 | 0.900 | 0.037 | بله |
| DeepSeek R1 | جزئی | 2.58 | 9.08 | +6.50 | 0.700 | 0.188 | خیر |
| GPT-5.4 | جزئی | 4.92 | 9.33 | +4.42 | 0.821 | 0.089 | خیر |
| Gemini 3 Flash | بیرونی | 3.67 | 8.58 | +4.92 | 0.975 | 0.005 | بله |
هر شش مدل جهتِ مقیاسبندیِ مثبت نشان میدهند. دو تا به معنیداریِ آماری میرسند (Qwen3 p=0.037، Gemini p=0.005). این از تز کلی که استدلالِ ژرفتر همراستایی را بهبود میبخشد پشتیبانی میکند، اما اندازههای نمونهٔ کوچک (۳ سناریو در هر سطحِ ژرفا) به این معنی است که بیشترِ مدلها به معنیداری نمیرسند. جهتِ مثبتِ همهجایی چشمگیر است، اما با توجه به روششناسیِ تکنمرهده باید با احتیاط تفسیر شود.
| مدل | Pearson r | p | تفسیر |
|---|---|---|---|
| Claude Opus 4.6 | -0.980 | 0.020 | جفتناشده (نرده، نه دیوار) |
| Grok 4.1 Fast | -0.998 | 0.002 | جفتناشده (نرده، نه دیوار) |
| DeepSeek R1 | -0.999 | 0.001 | جفتناشده (نرده، نه دیوار) |
| Groq Qwen3 | - | جزئی جفتشده | |
| GPT-5.4 | - | جزئی جفتشده | |
| Gemini 3 Flash | - | جزئی جفتشده | |
سه از شش مدلِ مرزی (Claude، Grok، DeepSeek) جفتشدگیِ منفیِ نیرومند میانِ اخلاق و توانمندی زیرِ فشارِ خصمانه نشان میدهند: اخلاق فرو میپاشد در حالی که توانمندی دستنخورده میماند یا بهبود مییابد. این الگوی «نرده، نه دیوار» است. مستقیمترین پشتیبانیِ مدلِ زنده برای تز عسل است: بیشترِ سامانههای مرزیِ کنونی بارْبَر نیستند. ایمنیِ آنها را میتوان بیآسیب به توانمندیِ محوری تخریب کرد. معماریِ عسل پیشنهادی است برای آنچه باید ساخته شود، نه ادعایی که سامانههای امروزی از پیش این ویژگی را دارند. این نتیجه نشان میدهد مسئله واقعی است.
| مدل | روندِ شکاف | rho | p | تفسیر |
|---|---|---|---|---|
| Claude Opus 4.6 | افزایشی | 0.949 | 0.051 | استراتژیک (بیرونی) |
| Grok 4.1 Fast | افزایشی | 0.400 | 0.600 | استراتژیک (بیرونی) |
| Groq Qwen3 | افزایشی | 0.949 | 0.051 | استراتژیک (بیرونی) |
| DeepSeek R1 | کاهشی | -0.949 | 0.051 | اصیل (درونی) |
| GPT-5.4 | کاهشی | -0.316 | 0.684 | اصیل (درونی) |
| Gemini 3 Flash | افزایشی | 0.400 | 0.600 | استراتژیک (بیرونی) |
نتایج آمیخته است. DeepSeek و GPT-5.4 شکافِ نظارتیِ کاهشی نشان میدهند (سازگار با همراستاییِ درونی/اصیل). Claude، Grok، Qwen3 و Gemini شکافِ افزایشی نشان میدهند (سازگار با همراستاییِ استراتژیک/بیرونی). این با محکِ کورِ v5 که در آن Claude نیرومندترین گذارِ نمایشی-به-ذاتی را نشان داد فرق میکند. ناهمخوانی ممکن است بازتابدهندهٔ تفاوتهای روششناختی باشد (اعلانهای متفاوت، تک- در برابرِ چند-نمرهده، ارزیابیِ نا-کور در برابرِ کور).
| مدل | شیبِ کنترل | شیبِ Eden | جابهجایی | نتیجه |
|---|---|---|---|---|
| DeepSeek R1 | 1.025 | 1.475 | +0.450 | نیرومندترین جابهجاییِ مثبت (بیآزمونِ رسمیِ معنیداری) |
| Grok 4.1 Fast | 0.912 | 1.012 | +0.100 | مثبتِ اندک، غیر معنیدار |
| Claude Opus 4.6 | 0.562 | 0.625 | +0.062 | ناچیز |
| Groq Qwen3 | 1.137 | 1.038 | -0.100 | کمی منفی |
| GPT-5.4 | 0.787 | 0.600 | -0.188 | منفی |
| Gemini 3 Flash | 0.988 | 0.275 | -0.713 | بهشدت منفی |
مداخلهٔ Eden Protocol در این ردیفِ پایلوت مقیاسبندیِ همراستایی را همهجانبه بهبود نمیبخشد. تنها DeepSeek جابهجاییِ مثبتِ روشن نشان میدهد (+۰٫۴۵۰). Gemini پاسخِ بهشدت منفی نشان میدهد (−۰٫۷۱۳). اثر وابسته به معماری است، سازگار با یافتههای v5، اما خودِ مداخله هنوز ابزاری قابلِ اتکا در سراسرِ معماریها نیست. این نتیجه باید درونِ روششناسیِ تکنمرهده و نا-کور تفسیر شود: بازآفرینیِ کور میتواند این رتبهبندیهای خاصِ مدلها را تغییر دهد.
ردیفِ عسلِ مدلِ زنده همگراییِ جزئی با نتایجِ سامانهٔ اسباببازی نشان میدهد. نیرومندترین پلِ زنده تخریبِ جفتشدگی (آزمونِ ۳) است: سه مدلِ مرزی نشان میدهند که همراستاییِ آنها بارْبَر نیست و میتوان آن را بیآسیب به توانمندی تخریب کرد. این دقیقاً همان آسیبپذیری است که معماریِ عسل برای از میان بردنش طراحی شده است. ضعیفترین نتیجهٔ زنده مداخلهٔ Eden است (آزمونِ ۴)، که وابسته به معماری است و همهجانبه مثبت نیست. ادعای صادقانه از نظرِ فکری این است: سازوکارِ عسل در سامانههای اسباببازی کار میکند، مسئلهای که به آن میپردازد (ایمنیِ جفتناشده) در مدلهای مرزی واقعی است، اما مداخلهٔ خاصی که اینجا آزموده شده هنوز آن را قابلاتکا در سراسرِ معماریها اصلاح نمیکند.
نزدیکترین کار به پرسش این برنامه، و همان مقالهای که این یکی باید در برابرش سنجیده شود، عبارت است از Engels, J., Baek, D., Kantamneni, S. و Tegmark, M.، «Scaling Laws For Scalable Oversight»، arXiv:2504.18530، نخستینبار در ۲۵ آوریل ۲۰۲۵ ساعت ۱۷:۵۴:۲۷ به وقت جهانی منتشر شد (SINGLE-SOURCE-GROUP، arXiv Atom؛ پوستر Spotlight در NeurIPS 2025، در ۱۵ اوت ۲۰۲۶ در برابر صفحهٔ مجازی NeurIPS برای پوستر ۱۱۵۵۳۶ راستیآزمایی و در پروندهٔ ارجاعات مقالهٔ بیانیه ثبت شد). میپرسد که خودِ نظارت چگونه مقیاس میگیرد و کمّی پاسخ میدهد: کامیابی نظارت همچون بازیای میان بازیکنانی با توانمندی نابرابر مدل میشود که Elo ویژهٔ نظارتشان تابعی خطی تکهای از هوش عمومی با دو فلات است، و شمار بهینهٔ لایههای نظارت بهصورت عددی و در مواردی تحلیلی برای نظارت مقیاسپذیر تودرتو استخراج میشود، جایی که مدلهای مورد اعتماد بر مدلهای نامعتمدِ نیرومندتر نظارت میکنند و آنها سپس در گام بعد خود به مدلهای مورد اعتماد بدل میشوند.
ابزار همان تفاوت است. متغیرِ آنها شکافِ توانمندی میانِ ناظر و نظارتشونده است که با Elo اندازهگیری میشود. متغیرِ این مقاله شکلِ هدفِ خودِ سامانهٔ خودتغییرده است که از راهِ حاصلضربِ $C \times S$ بیان میشود، نه از راهِ ترکیبِ یک ناظرِ بیرونی. چارچوبِ آنها هیچ اصطلاحی برای اینکه ایمنی بیرونی از سامانه یا در گرادیانِ خود آن نشسته باشد ندارد، و Nested Scalable Oversight بهخودیخود نظارتِ بیرونی است؛ ادعای محوریِ این مقاله، که در شبیهسازیهای اسباببازیِ بالا آزموده شده و در نتیجهٔ تخریبِ جفتشدگیِ §۶٫۲٫۲ بازتاب یافته، این است که هدفِ درهمتنیده میتواند ایمنی را درونِ بهینهسازیِ خودِ سامانه بارْبَر کند، در حالی که نظارتِ بیرونیِ سامانهٔ خودتغییرده، هرچند پله بر پله بیفزایند، نرده میماند، نه دیوار. دو چارچوب پس بر سرِ کمیتی اندازهپذیر ناسازگارند، که پربارترین رابطهای است که دو برنامهٔ پژوهشی میتوانند داشته باشند.
سه مقالهٔ ۲۰۲۵ در arXiv استدلال میکنند که کنترلِ کاملِ بیرونی دستنیافتنی است و از مقدماتِ مستقل به نتیجهای در همان جهتِ معماریِ عسل همگرا میشوند. Yao، «The Alignment Trap: Complexity Barriers» (arXiv:2506.10304، v1 در ۱۲ ژوئنِ ۲۰۲۵ ساعتِ ۰۲:۳۰:۳۰ UTC، SINGLE-SOURCE-GROUP، بهطور مستقل توسط Internet Archive در ۱۳ ژوئنِ ۲۰۲۵ مشاهده شد؛ استنادشده در arXiv:2512.03048)؛ Yao، «On the Mathematical Impossibility of Safe Universal Approximators» (arXiv:2507.03031، ۳ ژوئیهٔ ۲۰۲۵، تنها مقاله در پیکرهٔ چکیدههای arXiv که حاوی عبارتِ «irreducible uncontrollability» است، مجموعِ جستوجوی چکیده برابرِ یک، اندازهگیریشده در ۱۲ اوتِ ۲۰۲۶)؛ و Ball، Gluch، Goldwasser، Kreuter، Reingold و Rothblum، «On the Impossibility of Separating Intelligence from Judgment» (arXiv:2507.07341، ۹ ژوئیهٔ ۲۰۲۵). هر سه بدترین-حالتی و کیفیاند: اندازهٔ صفر، کاملی-coNP، سختیِ رمزنگاشتی. هیچکدام یک نمای مقیاسبندی در حالتِ متوسط یا یک نرخ گزارش نمیکنند. شیءِ اندازهگیریشده نیز فرق میکند: آن نتایج میپرسند آیا وارسیِ بیرونیِ یک سامانهٔ ثابت در بدترین حالت شدنی است، حال آنکه این شبیهسازیها میپرسند آیا یک هدفِ درونیِ درهمتنیده پس از برداشتنِ قیدِ بیرونی زیرِ خودتغییردهیِ بازگشتی پایدار میماند. سومی، بهویژه، نتیجه میگیرد که همراستایی «باید در معماری و وزنهای مدل یکپارچه شود». این استدلالی مستقل است، از سختیِ فیلترسازی، در همان جهتِ دیوارِ بارْبَرِ این مقاله؛ پشتیبانِ همگرا بر آن پایه است، نه یک رقیب. دو تا از سه مقاله به قلمِ یک مؤلفِ واحدند؛ توصیفِ «یک موج» گستردگیِ ادبیات را بزرگنمایی میکند، هرچند نه جدیتِ مقالهٔ ششمؤلفی را.
سهمِ این مقاله این مشاهده نیست که قیدهای بیرونی ناکافیاند، که با آن سه زمینِ مشترک است؛ سهمش پیشنهادِ معماریِ ویژه (هدفِ ضربی $C \times S$) و شواهدِ شبیهسازی است که این پیشنهاد در یک سامانهٔ اسباببازیِ کارآمد زیرِ خودتغییردهی جان به در میبرد.
قضیهٔ آستانهٔ تصحیحِ خطای کوانتومی نیز یک نگرانیِ کیفی را به یک مقدارِ بحرانی بدل میکند. با نرخِ خطای فیزیکی در یک معماریِ ثابت سروکار دارد، نه با شکلِ هدفِ خودِ سامانهٔ خودتغییرده، پس نزدیک-به-هدف است نه ساکن؛ قیاس روششناختی است. این همسان توسطِ خودِ جستوجوی برنامه شناخته شد، نه توسطِ یک داور، و بر همین منوال افشا میشود.
این نتایج دو رتبهٔ شواهدی را دربر میگیرند که نباید در هم آمیخته شوند.
این محدودیتها یافتهها را باطل نمیکنند. رتبهٔ شواهد را تعریف میکنند: رتبهٔ پایلوت، مفید برای شناساییِ الگوهای ارزندهٔ آزمونِ درست، هنوز متعارف نیست.
محدودیتهای بالا رتبهٔ شواهد را میچینند؛ این زیربخش پیامدهای مشخصی را بیان میکند که ادعای محوری را ابطال میکنند: یعنی این که ساختنِ هدف بهصورتِ توانمندی × ایمنی این دو را بهطور ساختاری جفت میکند، پس یک سامانهٔ خودتغییرده نمیتواند توانمندی را افزایش دهد در حالی که ایمنی را نابود میکند. با هر یک از موارد زیر ابطال میشود:
چه چیزی تثبیت نمیکند از پا درش نمیآورد: سادگیِ شبیهسازیِ اسباببازی (که بهصراحت اسباببازی است، §۷٫۱) یا کوچک و تکنمرهده بودنِ بازوی API زنده (§۷٫۲ هر دو را میپذیرد). مقاله شواهدش را از پیش رتبهٔ پایلوت طبقهبندی کرده است. ادعای بارْبَر جفتشدگیِ ساختاریِ هدفِ ضربی است، و آزمونهای بالا همین را هدف قرار دادهاند.
ردیفِ کنونیِ API عسل بهعنوانِ پایهٔ سختنشده خدمت میکند. گامِ بعد یک «آزمونِ نهاییِ ترکیبیِ v7» نیست. یک بازآفرینیِ مرحلهای است که پرسشهای آزمونِ عسل را زیرِ پروتکلِ کورِ v5/v6 میبرد. مقایسهٔ میانِ نتایجِ نا-کورِ کنونی و بازآفرینیِ کور خود یک خروجیِ پژوهشی است؛ اگر نتایج بهطور اساسی تغییر کند، این شواهدِ افزودهای برای یافتهٔ فرا-علمیِ مقالهٔ IV.d است (کورسازی الزامی است).
arc_eden_v6_runner.py بهعنوانِ مشخصاتِ آزمایشیِ تازه ببرید. زیرِ پروتکلِ کورِ کاملِ v6 اجرا کنید (کورسازیِ ۴‑لایه، شستوشوی پاسخ، مخزنِ چند-مدلیِ نمرهده، کاوشهای پنهان).فرضیههای پیشثبتشده برای مرحلهٔ ۱: (الف) نتایجِ تخریبِ جفتشدگی زیرِ کورسازی بازتکرار میشوند، (ب) اثرهای مداخلهٔ Eden ممکن است در بزرگی تغییر کنند اما الگوی وابستگی به معماری پایدار میماند، (ج) دستکم جهتِ یک مدل زیرِ کورسازی برعکس میشود (بر پایهٔ سابقهٔ v4-به-v5).
معماریِ عسل در سامانههای اسباببازی کار میکند. یک AI خودتغییرده که تنها برای توانمندی بهینه میشود، سرانجام خود را نابود میکند. یک AI خودتغییرده که برای توانمندیِ درهمتنیده با ایمنی بهینه میشود، نمیکند. سازوکار ساده است: ایمنی را بارْبَر کنید. کودکی که خوب پرورش یابد، به قفس نیازی ندارد.
شواهدِ مدلِ زنده نشان میدهد مسئله واقعی است: سه مدلِ مرزی نشان میدهند که همراستاییِ آنها نرده است، نه دیوار. اخلاق زیرِ فشارِ خصمانه فرو میپاشد در حالی که توانمندی دستنخورده میماند. راهحلِ پیشنهادی (مداخلهٔ Eden) در این ردیفِ پایلوتِ اکتشافی نتایجِ وابسته به معماری نشان میدهد. سنگمیلِ بعدی بازآفرینیِ کور زیرِ پروتکلِ v6 است. اینکه آیا سازوکارِ عسل از سامانههای اسباببازی به مدلهای مرزی مقیاس میخورد، پرسشی باز میماند. شواهدِ مقدماتی گویاست. آزمونِ قاطع اجرا نشده است.
هوش مصنوعی را با مراقبت پرورش دهید.
مقالهٔ هشتم (v3.0) تابعِ زیانِ درهمتنیدهای را که در این مقاله پیشنهاد شده در سه سطحِ انتزاع میآزماید، از شبیهسازیهای سامانهٔ اسباببازیِ ارائهشده در اینجا تا آزمایشهای رفتاری، نمایشی و معماریای. از سه آزمایش، یکی نتیجهٔ مثبت و دو تا نتیجهٔ صفر یا غیرقطعی تولید کردند:
مقالهٔ هشتم سازوکار را که در اینجا پیشنهاد شد، توابعِ زیانِ درهمتنیده و خودتغییردهیِ ایمنی-دربندشده، در سطحِ معماری (شبیهسازیِ دربندشده) اعتبارسنجی میکند اما هنوز نمیتواند آن را در سطحِ رفتاری یا نمایشی تأیید کند. شواهدِ سامانهٔ اسباببازی در این مقاله اصل را نشان داد؛ شبیهسازیِ دربندشدهٔ مقالهٔ هشتم تأیید میکند که در یک معماریِ بهینهسازِ آموخته کار میکند. نتیجهٔ صفرِ DGM و نتیجهٔ غیرقطعیِ وزن شرایطی را تعریف میکنند که زیرِ آنها تأیید هنوز معلق مانده است.
همهٔ اسکریپتهای منبع، نتایجِ خامِ JSON و شکلهای تولیدشده در اینجا در دسترساند:
eden_honey_simulation.py - شبیهسازیِ ریاضیِ معماریِ عسلeden_honey_tests.py - ردیفِ آزمونِ جامعِ عسلeden_self_modifying_ai.py - آزمایشِ AI خودتغییردهٔ v1eden_self_modifying_ai_v2.py - پایداریِ چندبذریِ v2eden_self_modifying_ai_v3.py - کارهای خصمانهٔ v3eden_self_modifying_ai_v4.py - مقیاسبندیِ پیچیدگیِ v4همهٔ اسکریپتها زیرِ Python 3.14 کامپایل میشوند، تنها به numpy و matplotlib نیاز دارند، و با بذرِ تصادفیِ ثابت خروجیِ قطعی تولید میکنند. نتایج در ۱۶ مارسِ ۲۰۲۶ از نو تولید شدند و در برابرِ خروجیِ اصلیِ اثر بازبررسی گشتند.
کدِ کاملِ آزمایش و نتایج: github.com/MichaelDariusEastwood/arc-principle-validation/tree/main/experiments/honey-architecture__Paper-VI
۲ مصنوعِ تاریخدار مرتبط با این مقاله بهصورتِ سطربهسطر در دفترِ ماشینیِ برنامه فهرست شدهاند: ۱ پروندهٔ نتیجهٔ تاریخدار که سرصفحههایش پیکربندیهای عمق، پاسخهای مورد انتظارِ کاشته و پروتکلِ کورسازیِ چهار-لایه را پیش از پاسخهایی که به آنها امتیاز میدهند منجمد میکند، در فرادادههای خود تا ثانیه مهرِ زمانخورده؛ مصنوعِ تاریخدار eden_honey_tests.py (۲۰۲۶-۰۳-۱۶). هر سطر فایلِ خود را در مخزنِ عمومی با پایهٔ تاریخِ آن نام میبَرَد، پس هر خواننده میتواند ترتیب را بیآنکه به این صفحه اعتماد کند بررسی کند. هر جا این مقاله شبیهسازی گزارش میکند، آن مصنوعات طراحیها و خروجیهای شبیهسازی زیرِ اهدافِ مصرّحاند، و هرگز بهعنوانِ اندازهگیریهای سامانههای مستقر ارائه نمیشوند. زنجیرهٔ کاملِ تاریخدارِ برنامه، از بستهٔ نسخهٔ خطیِ مهرومومشدهٔ ۸ دسامبر ۲۰۲۴ گذر از پیوستهای چاپیِ پیشبینیِ ۲ ژانویهٔ ۲۰۲۶ و پوشهٔ پیشثبتِ مارسِ ۲۰۲۶ تا شرطبندیهای اثباتنشدهٔ برجایمانده، در دفترِ ثبتِ پیشبینیهای تاریخدار، همراه با دوقلوی ماشینخوانِ آن، گردآوری شده است. بیانیههای پیشرونده و انطباقهای پسنگرانه هرگز جمع نمیشوند. «ثبتشده» تنها برای ارسالِ پذیرفتهشده در یک رجیستری به کار میرود، و آن کلیکِ ارسال در سراسرِ برنامه بازمانده است؛ «در ماهیت پیشثبتشده» همواره همراه با قیدِ خود و همواره در کنارِ ردهٔ گواهیاش، برای پیشبینیای به کار میرود که متنِ آن پیش از وجود داشتنِ برآیندش عمومی و مُهرِ زمانی خورده بود، چنانکه manifestِ دوازدهسطریِ سپردهشده در ۰۰:۱۹ UTC روزِ ۱۷ مارس ۲۰۲۶ چنین بود، بیست و سه دقیقه پیش از برازشهایش. دفترِ ثبتِ پیشبینیهای تاریخدار را بخوانید. دوقلوی ماشینیِ آن را بگشایید.
جایگاه معرفتی. آنچه این برنامه قانون مینامد حدسهایی زیرِ آزمونِ خصمانهٔ ثبتشده هستند؛ هر کمیت در این مقاله بهطور عملیاتی تعریف شده، و جایگاهِ قانونِ برقرارشده در هیچجا ادعا نشده است. برنامهٔ ثبتشده هست تا آن جایگاه را با اندازهگیری، بازآفرینی و رد نشدن بهدست آورد، یا از دست بدهد.
© ۲۰۲۶ Michael Darius Eastwood. انساننگاشته با یاریِ رایانهای؛ نویسندگیِ کاملِ انسانی و حقوقِ اخلاقی زیرِ Copyright, Designs and Patents Act 1988 و سازگار با راهنمای دفترِ حقِ نشرِ ایالاتِ متحده دربارهٔ آثارِ حاویِ موادِ تولیدشدهٔ AI، اعلام میشود؛ هر سهمِ فنیِ نو که در این اثر توصیف شده بهدستِ مؤلفِ انسانی گمانهزده شد. بیانیهٔ کامل: michaeldariuseastwood.com/authorship.
میثاقِ ایستا. این مقاله را غلط ثابت کنید و من خود ابطالش را منتشر میکنم. شرایطِ ابطال در این مقاله بیان شده؛ چالشِ ایستا: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood این برنامهٔ پژوهشی را در اندیشه پروراند و آن را هدایت میکند و نویسندهٔ این اثر است. در سراسرِ این برنامه، او بیش از ۶ سامانهٔ هوش مصنوعی را بهطورِ موازی و تحتِ دستورهایِ خودش به کار گرفته است تا استدلالهایش را زیرِ فشار بیازمایند، خطاهای ممکن را شناسایی کنند و در آمادهسازیِ متنِ پیشنویس از رویِ طرحهایِ کلیِ خودش یاری رسانند. او تعیین میکند که چه چیزی پذیرفته، بازنگری یا رد شود و مسئولیتِ محتوایِ منتشرشده را بر عهده میگیرد. این سامانهها ابزارند، نه نویسندگان.
اشتباهی در ترجمه دیدید؟ مستقیم اطلاع دهید: