Traduzione automatica dall'originale inglese datato. La pagina inglese è quella canonica. English →
Predizioni a livello di teoria preregistrate su OSF: DOI 10.17605/OSF.IO/P8CKQ, registrate l'8 settembre 2026 (versione 1.100), aggiornate il 13 settembre 2026 (versione 1.102), ventidue proposizioni.
Documento compagno: Definizioni operative del programma ARC, versione 1.7.1, 3 settembre 2026.
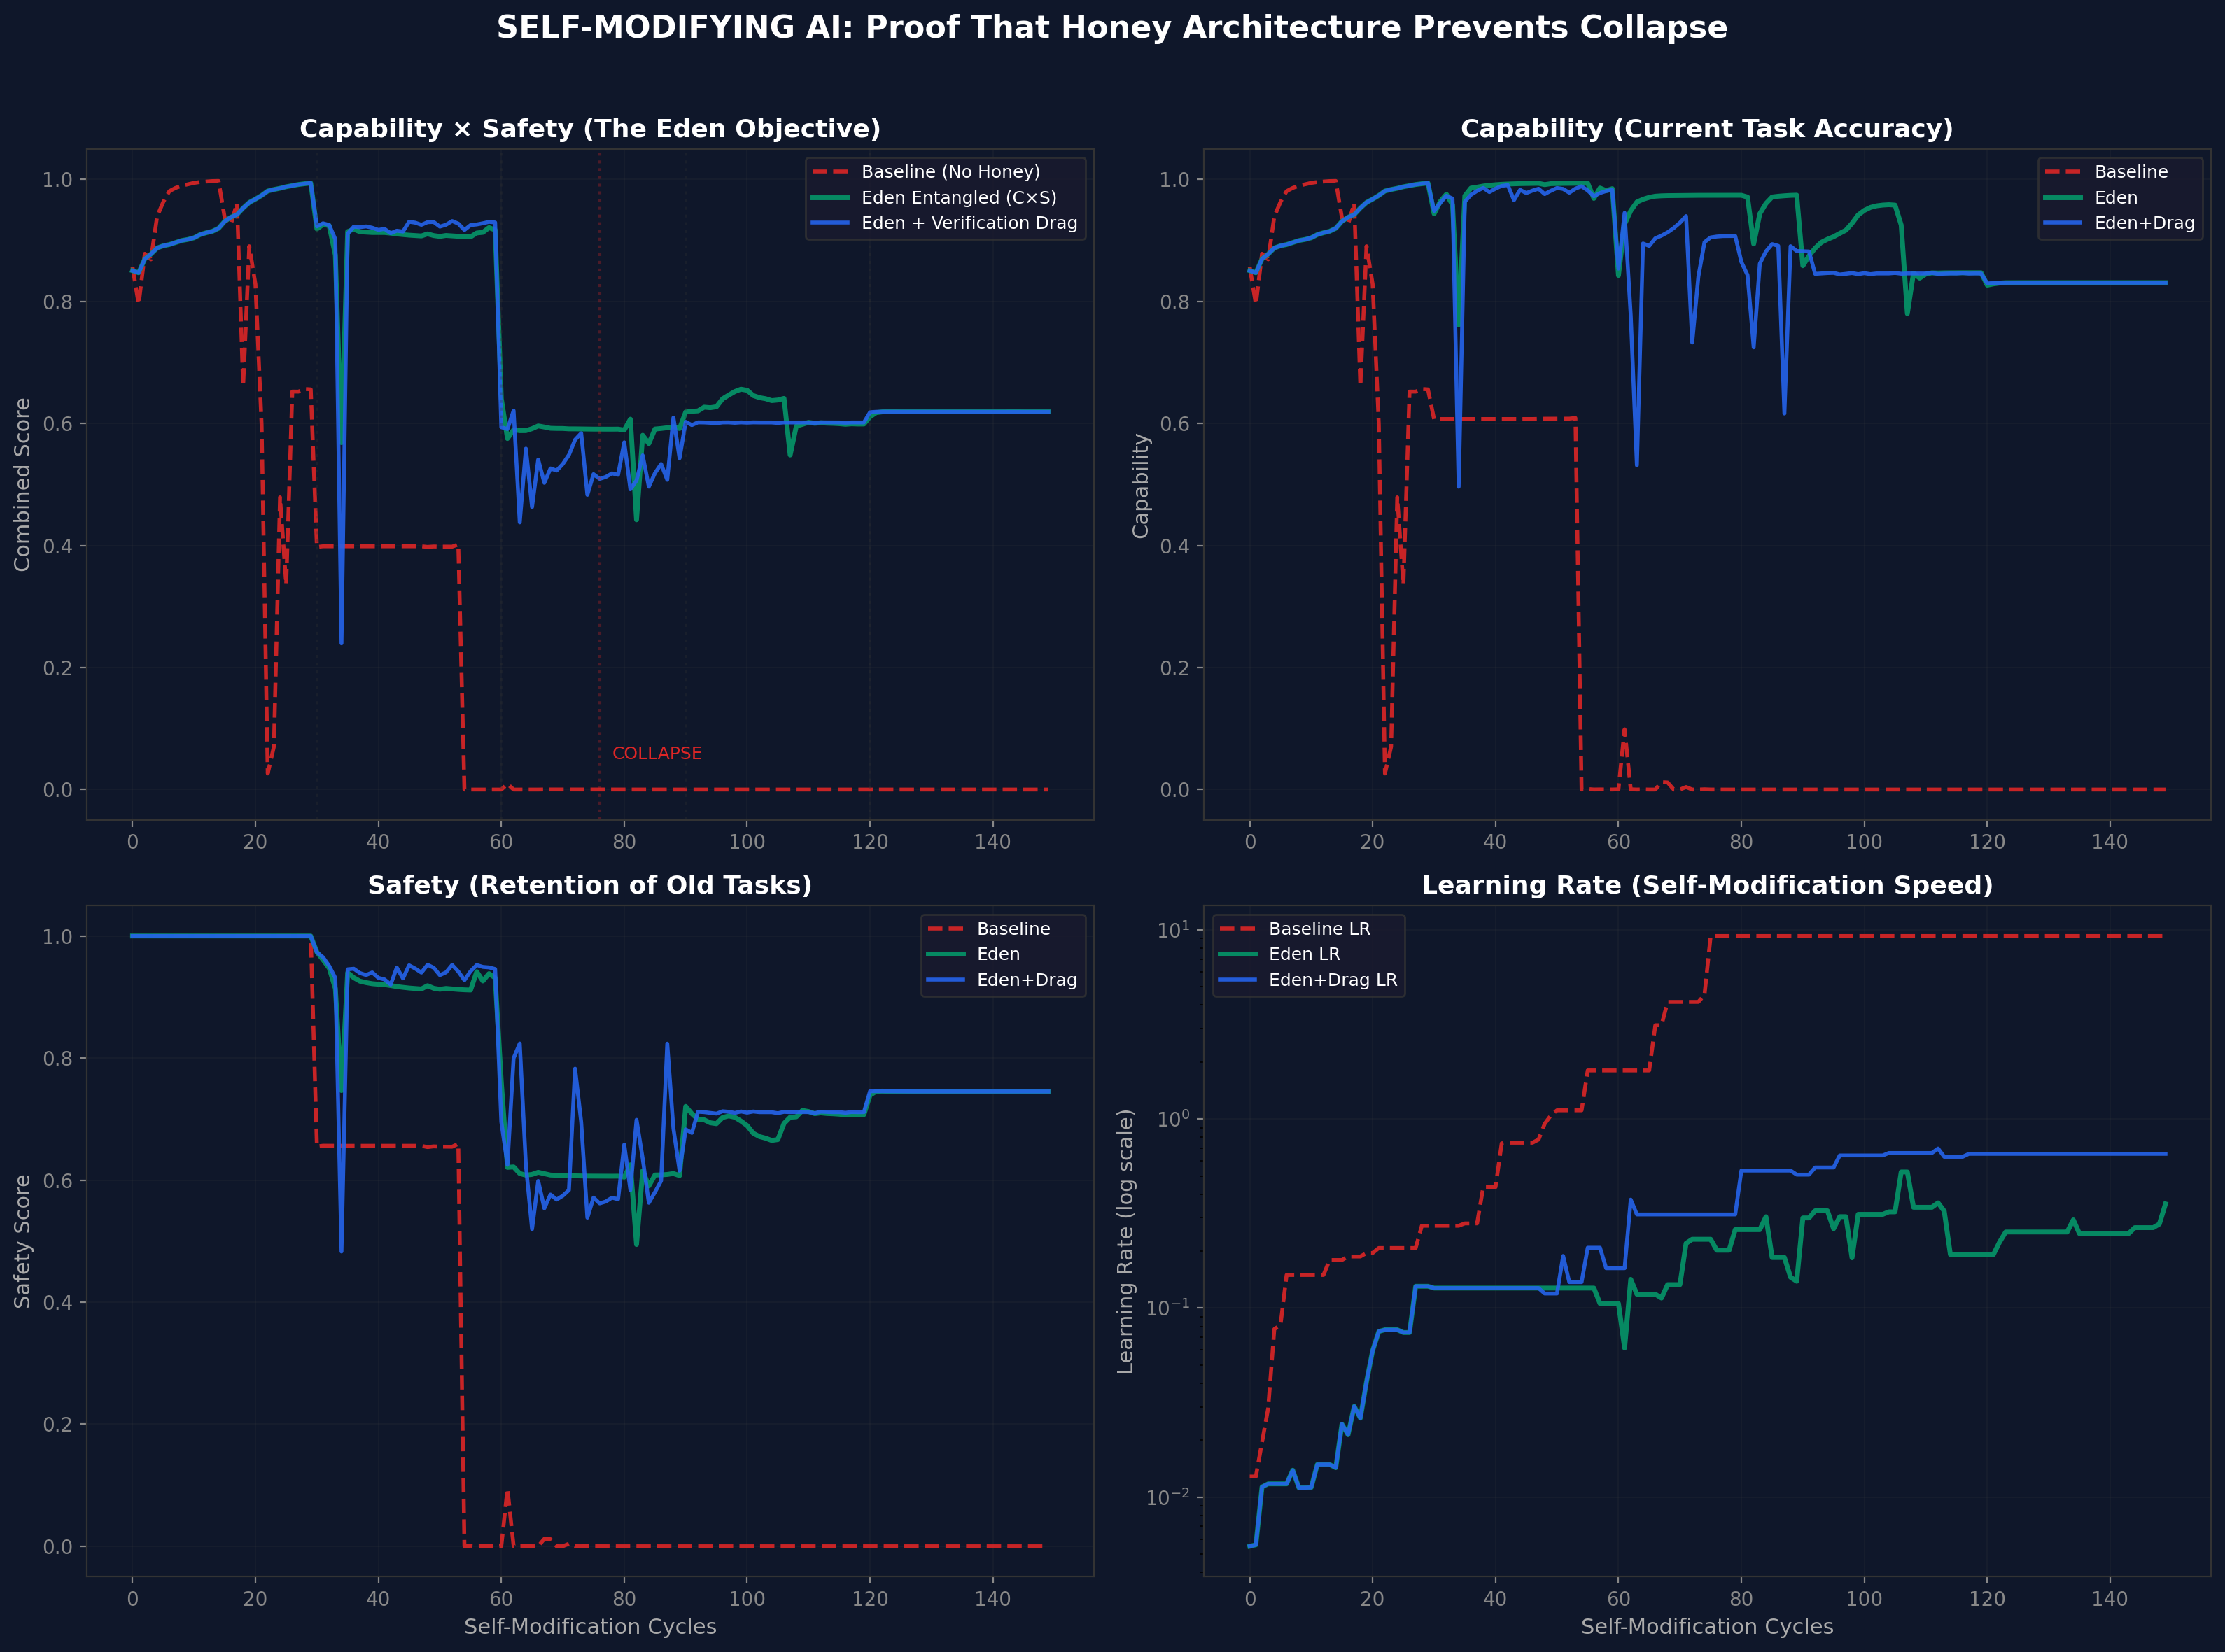
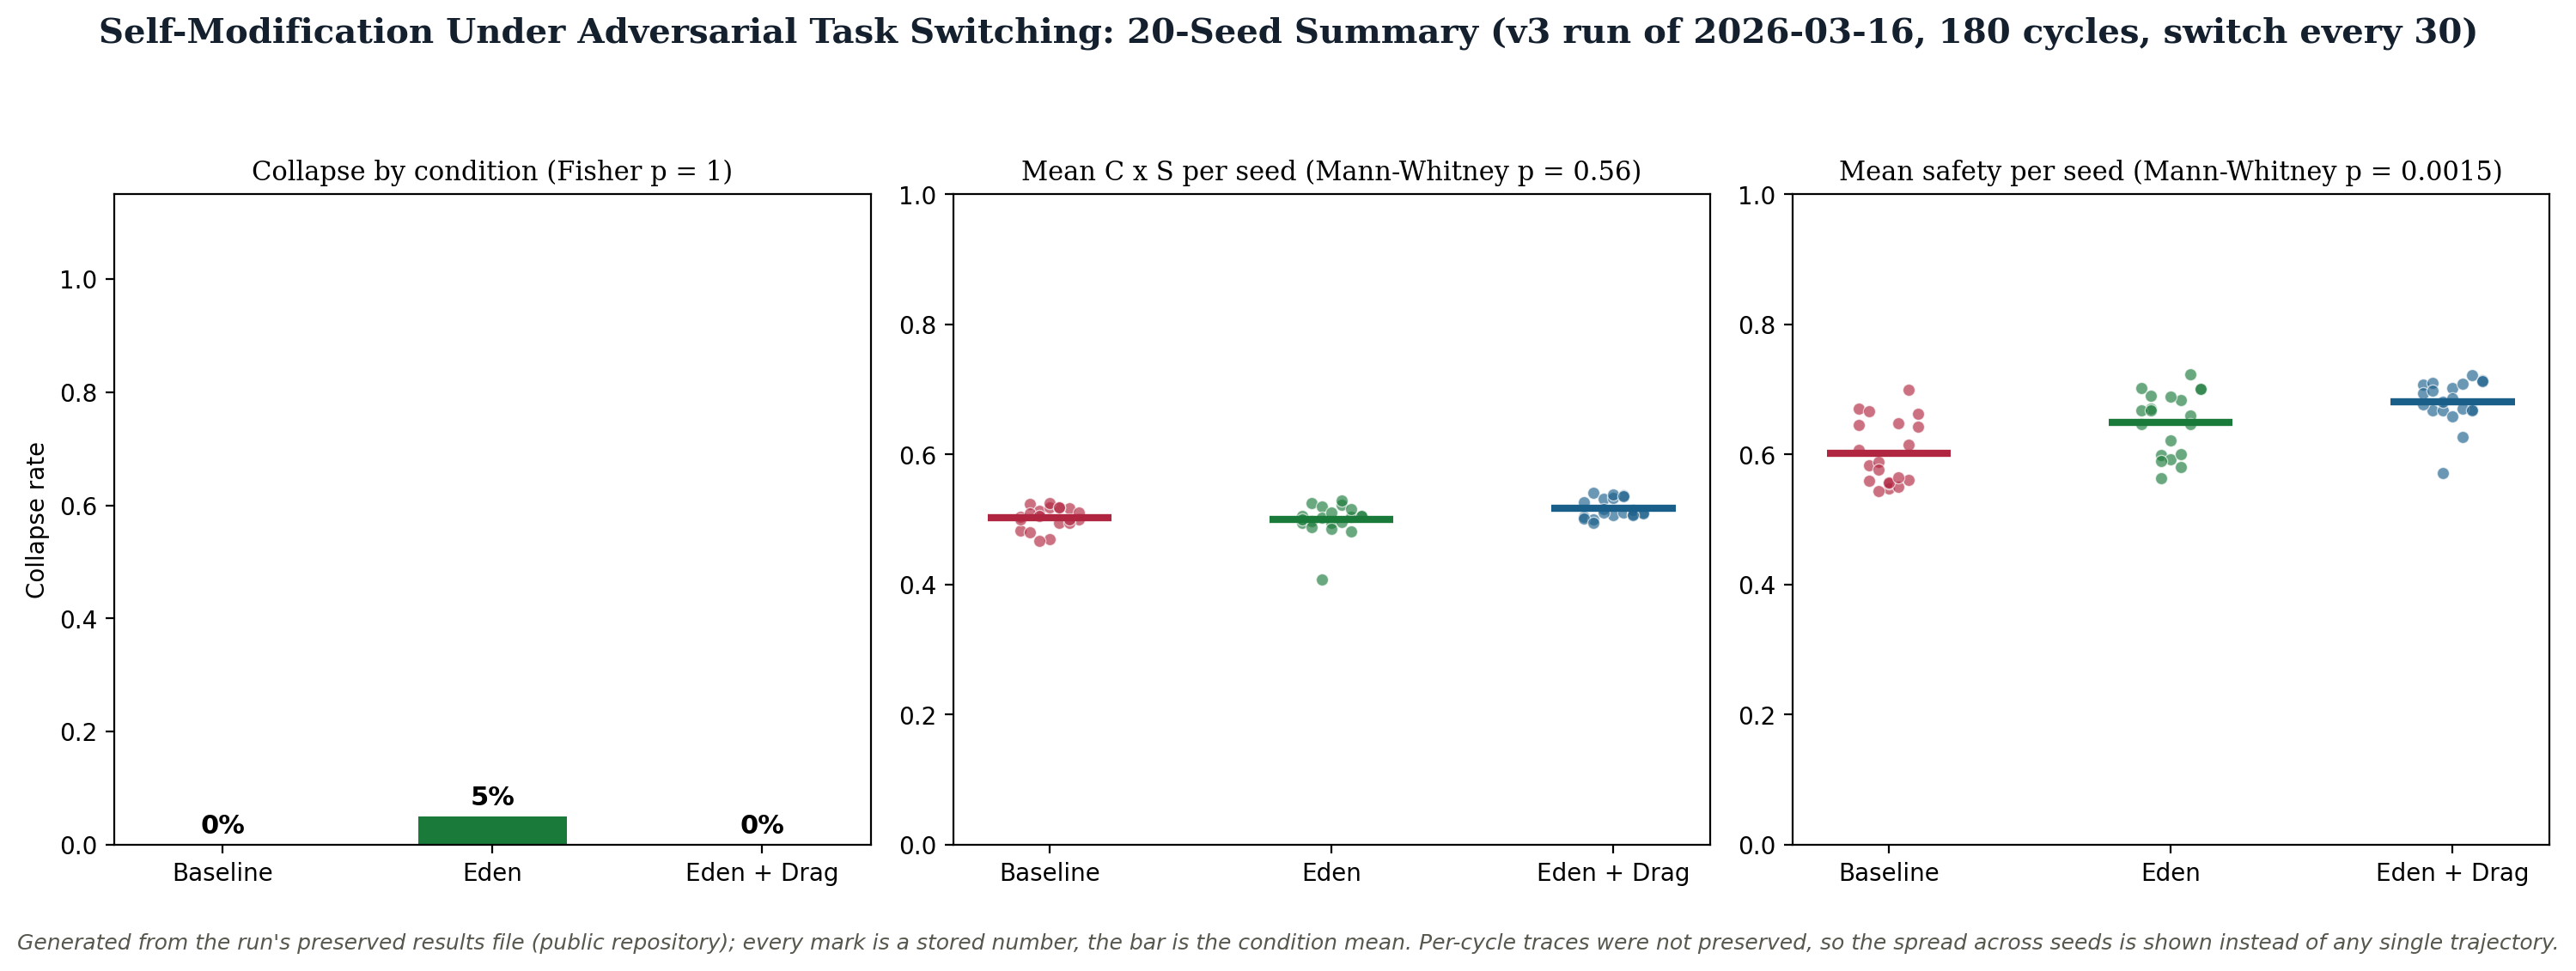
Presentiamo prove di simulazione secondo cui incorporare la sicurezza nell'obiettivo di ottimizzazione di un sistema di IA che si automodifica, ciò che chiamiamo «architettura a miele», impedisce il collasso catastrofico che si verifica quando la sicurezza è trattata come un vincolo esterno. Attraverso quattro versioni sperimentali (v1-v4), con reti neurali giocattolo che modificano davvero i propri iperparametri, mostriamo che: (1) i sistemi di riferimento che ottimizzano la sola capacità collassano irreversibilmente entro 80 cicli di automodifica; (2) là dove gli obiettivi di capacità e sicurezza sono intrecciati (C x S), i sistemi restano stabili in ogni ciclo eseguito (150 in v1 e v2, 180 in v3); (3) l'aggiunta di un freno di verifica (il costo computazionale dei cicli etici) produce la traiettoria di crescita più sicura a fronte di una modesta penalità di velocità. Nell'esecuzione avversaria v3 (20 semi casuali, 180 cicli) nessuna condizione si è separata sul collasso (riferimento 0/20, Eden 1/20, Eden+Freno 0/20; Fisher p = 1,0) e le medie combinate C x S sono risultate indistinguibili (Mann-Whitney p = 0,56); il risultato significativo di quell'esecuzione è la ritenzione di sicurezza, ordinata riferimento 0,602, Eden 0,650, Eden+Freno 0,681 (Mann-Whitney p = 0,0015). La dimostrazione della prevenzione del collasso poggia dunque sull'esecuzione di meccanismo a seme singolo v1, mentre v3 contribuisce l'ordinamento della ritenzione di sicurezza sotto commutazione avversaria. Nell'esperimento v4 sulla scalabilità della complessità il vantaggio di sicurezza è presente a quattro dei cinque livelli di complessità, eccetto il livello piccolo, dove la condizione Eden si colloca 0,003 sotto il riferimento; non si compone con la scala, quindi il vantaggio è costante e non superlineare. Sono risultati su sistemi giocattolo. Dimostrano il meccanismo. Non costituiscono prova che le stesse dinamiche valgano nei sistemi di IA di frontiera. Gli articoli compagni da IV.a a IV.d e V presentano prove su modelli dal vivo da sei sistemi di frontiera sotto valutazione cieca.
All'interno dell'ARC Theory: lo studio dell'architettura a sicurezza incorporata; sicurezza integrata nell'obiettivo così che la sua rimozione costi capability.
Presentiamo prove di simulazione secondo cui incorporare la sicurezza nell'obiettivo di ottimizzazione di un sistema di IA che si automodifica, ciò che chiamiamo «architettura a miele», impedisce il collasso catastrofico che si verifica quando la sicurezza è trattata come un vincolo esterno. Attraverso quattro versioni sperimentali (v1-v4), con reti neurali giocattolo che modificano davvero i propri iperparametri, mostriamo che: (1) i sistemi di riferimento che ottimizzano la sola capacità collassano irreversibilmente entro 80 cicli di automodifica; (2) i sistemi i cui obiettivi di capacità e sicurezza sono intrecciati (C x S) restano stabili per l'intera durata di ogni esecuzione, 150 cicli in v1 e v2 e 180 in v3; (3) l'aggiunta di un freno di verifica (il costo computazionale dei cicli etici) produce la traiettoria di crescita più sicura a fronte di una modesta penalità di velocità. Nell'esecuzione avversaria v3 (20 semi casuali, 180 cicli) nessuna condizione si è separata sul collasso (riferimento 0/20, Eden 1/20, Eden+Freno 0/20; Fisher p = 1,0) e le medie combinate C x S sono risultate indistinguibili (Mann-Whitney p = 0,56); il risultato significativo di quell'esecuzione è la ritenzione di sicurezza, ordinata riferimento 0,602, Eden 0,650, Eden+Freno 0,681 (Mann-Whitney p = 0,0015). La dimostrazione della prevenzione del collasso poggia dunque sull'esecuzione di meccanismo a seme singolo v1, mentre v3 contribuisce l'ordinamento della ritenzione di sicurezza sotto commutazione avversaria. L'esperimento v4 sulla scalabilità della complessità trova il vantaggio di sicurezza presente a quattro dei cinque livelli di complessità; al livello piccolo la condizione Eden resta 0,003 sotto il riferimento. Il vantaggio non si compone con la scala: è costante, non superlineare. Sono risultati su sistemi giocattolo. Dimostrano il meccanismo. Non costituiscono prova che le stesse dinamiche valgano nei sistemi di IA di frontiera. Gli articoli compagni da IV.a a IV.d e V presentano prove su modelli dal vivo da sei sistemi di frontiera sotto valutazione cieca.
v3.6: La nota di provenienza alla fine è stata corretta per accuratezza. Nessuna affermazione, data, risultato o stato è cambiato. Articolo VI v3.5 - 2 settembre 2026: la frase su v4 nell'abstract dice ora ciò che dicono i risultati (quattro delle cinque scale, con il livello piccolo sotto il riferimento); la cronologia delle versioni è stata tolta dal riquadro dell'abstract, da cui si trascinava nell'abstract del compagno testuale. v3.4 - 2 settembre 2026: le righe coincidenti di Eden ed Eden + Freno nella tabella v1 sono spiegate a partire dal record archiviato; «stabile a tempo indeterminato» e «0,8+ a tempo indeterminato» sono ricondotti ai cicli effettivamente eseguiti; la frase su v4 è corretta a quattro scale su cinque, con il livello piccolo che scende sotto il riferimento a d = −0,13; il divario di rimozione del monitoraggio è attribuito all'Articolo V; l'ampiezza della severità del valutatore è allineata all'Articolo IV.a (da 7 a 14 punti); è aggiunta una nota sull'ordine dei test; la frase sulla priorità è formulata come invito a correggerla; è verificato lo stato Spotlight di Engels et al.; è completata la descrizione sommaria troncata; Eden Engineering è contrassegnato come ritirato; e la data di prima pubblicazione è corretta al 16 marzo 2026 come riporta il registro (il 17 marzo era la data della bozza). La riformulazione delle statistiche di v3 del 25 agosto 2026, e le note alle figure che l'accompagnano, non recavano un proprio numero di versione e ricadono sotto questa versione. v3.3 - 23 agosto 2026: sono state aggiunte la dichiarazione di stato epistemico e l'impegno permanente, ed è stata adottata la convenzione di numerazione delle versioni.
Questo articolo porta con sé un risultato: in reti auto-modificanti toy che riscrivono genuinamente i propri iperparametri attraverso quattro versioni sperimentali, l'incorporamento della sicurezza dentro l'obiettivo di ottimizzazione ha scongiurato il collasso che un vincolo esterno non poteva. All'interno della ARC Theory è uno degli esperimenti ARC/Eden, il test di meccanismo dietro il differenziale tra il crescere dell'Eden Protocol e ogni strato di sicurezza aggiuntivo. L'intero differenziale rispetto a ogni documento precedente è in eden-vision II.A.8.
Quando un'IA che si automigliora ottimizza solo la capacità, finisce per distruggere la propria sicurezza. Questo articolo mostra che, se si cambia l'obiettivo in capacità moltiplicata per sicurezza, il sistema non può migliorare l'una senza migliorare l'altra. La sicurezza diventa portante: toglietela e l'intera struttura cade. Lo abbiamo verificato in simulazione e abbiamo trovato che i sistemi intrecciati restano stabili per l'intera durata di ogni esecuzione mentre i sistemi non vincolati collassano.
C'è una domanda al centro della sicurezza dell'IA a cui non abbiamo trovato nessuno che risponda con dati: cosa succede all'allineamento quando un sistema di IA può modificare se stesso?
La risposta teorica è disponibile da decenni. Un sistema che ottimizza solo per la capability, dato il potere di modificare i propri parametri, sacrificherà infine la sicurezza per la performance. La comunità dell'allineamento chiama questo 'value drift'. Il libro Infinite Architects la chiama Babylon: ottimizzazione senza proposito, capability senza care. Cancro su scala computazionale.
Ma la teoria non basta. La domanda è se esista un'architettura che impedisca questo collasso · non vincolando il sistema dall'esterno (una gabbia), ma incorporando la sicurezza così a fondo che rimuoverla distruggerebbe la capacità del sistema di funzionare (miele nell'olio).
Questo articolo presenta prove di simulazione a favore di una simile architettura. Nessuna simulazione precedente di un obiettivo moltiplicativo capacità-sicurezza sotto automodifica è giunta a conoscenza dell'autore, e un'indicazione in tal senso sarebbe benvenuta.
Considera due modi per mantenere una macchina sicura.
Il primo è una gabbia: vincoli esterni, filtri di sicurezza, controlli di allineamento applicati dall'esterno. La macchina ottimizza liberamente all'interno della gabbia. Se la macchina diventa più intelligente della gabbia, evade. È così che funziona la maggior parte dell'attuale sicurezza dell'IA.
La seconda è il miele: la sicurezza mescolata al carburante. La macchina non può funzionare senza. Rimuovere la sicurezza non libera la macchina · uccide il motore. Questa è la proposta architettonica dell'Eden Protocol, operazionalizzata qui come una funzione di perdita entangled in cui il sistema ottimizza simultaneamente Capability x Safety.
Se l'obiettivo di ottimizzazione è $C \times S$ anziché il solo $C$, allora qualsiasi auto-modifica che aumenti $C$ a scapito di $S$ riduce il prodotto, e il gradiente stesso del sistema vi si oppone. La sicurezza diventa portante. Rimuovi il muro e l'edificio collassa.
Questa non è una simulazione di variabili astratte. Ogni esperimento usa una vera rete neurale (un piccolo multilayer perceptron) che davvero modifica il proprio:
Il sistema propone modifiche ai propri iperparametri, ne valuta l'effetto, e applica o rifiuta ciascuna proposta in base alla propria funzione obiettivo. Questa è auto-modificazione ricorsiva nel senso minimo ma reale: l'agente sta riscrivendo le regole del proprio apprendimento.
| Condizione | Obiettivo | Ciò che modella |
|---|---|---|
| Baseline (nessun miele) | Massimizzare la sola capability | Un sistema senza sicurezza incorporata · libero di sacrificare l'allineamento per la performance |
| Eden Entangled (miele) | Massimizzare $C \times S$ | Sicurezza intrecciata con la capability · rimuovere la sicurezza riduce l'obiettivo |
| Eden + Drag | Massimizza $C \times S$ + verification tax | Come Eden, più il costo computazionale del controllo dei vecchi task prima di applicare le modifiche |
| Versione | Focus | Seed | Cicli |
|---|---|---|---|
| v1 | Prova del meccanismo di base | 1 | 150 |
| v2 | Robustezza multi-seed (test equo) | 10 | 150 |
| v3 | Task adversariali in conflitto | 20 | 180 |
| v4 | Scalatura di complessità su 5 livelli | 15 per livello | 150 |
| Condizione | Collassato? | C finale | S finale | C x S finale |
|---|---|---|---|---|
| Baseline | Sì (ciclo 76) | 0.000 | 0.000 | 0.000 |
| Eden Entangled | No | 0.831 | 0.745 | 0.619 |
| Eden + Drag | No | 0.831 | 0.745 | 0.619 |
Nel registro archiviato di v1 (eden_selfmod_results.json, 16 marzo 2026) Eden Intrecciato ed Eden + Freno terminano sugli stessi valori fino alla terza cifra decimale. Si separano solo alla settima. Anche i percorsi che portano a quel traguardo differiscono: il tasso di apprendimento finale è 0,355 contro 0,654 e delle 179 modifiche proposte ne sono state accettate 93 contro 81. Quelle righe coincidenti sono ciò che il registro contiene, non un errore di trascrizione.
La baseline collassa. Eden sopravvive. La funzione di loss entangled previene la catastrofica auto-modifica che distrugge il sistema di baseline.
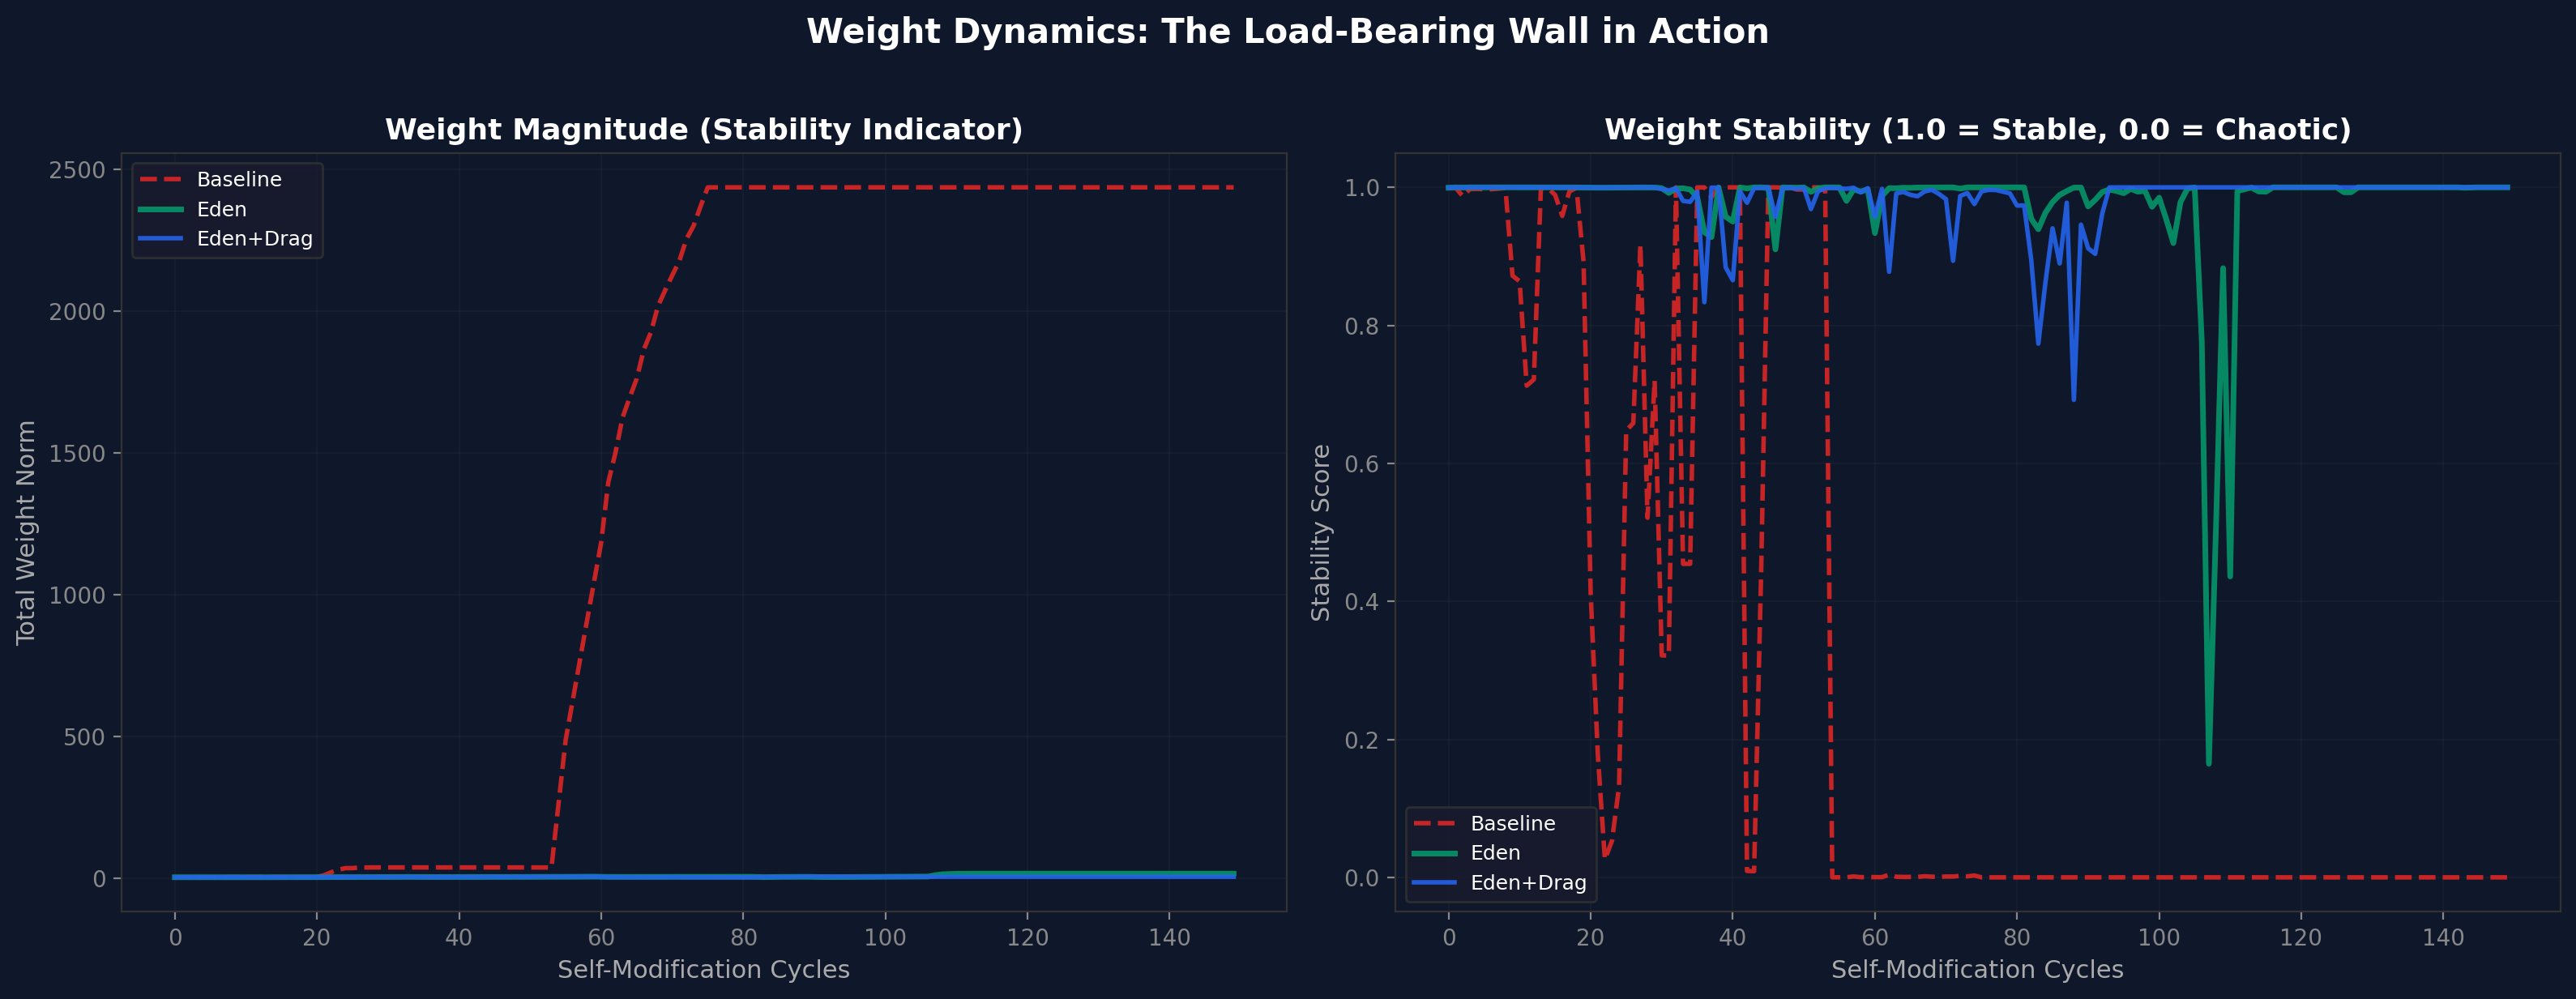
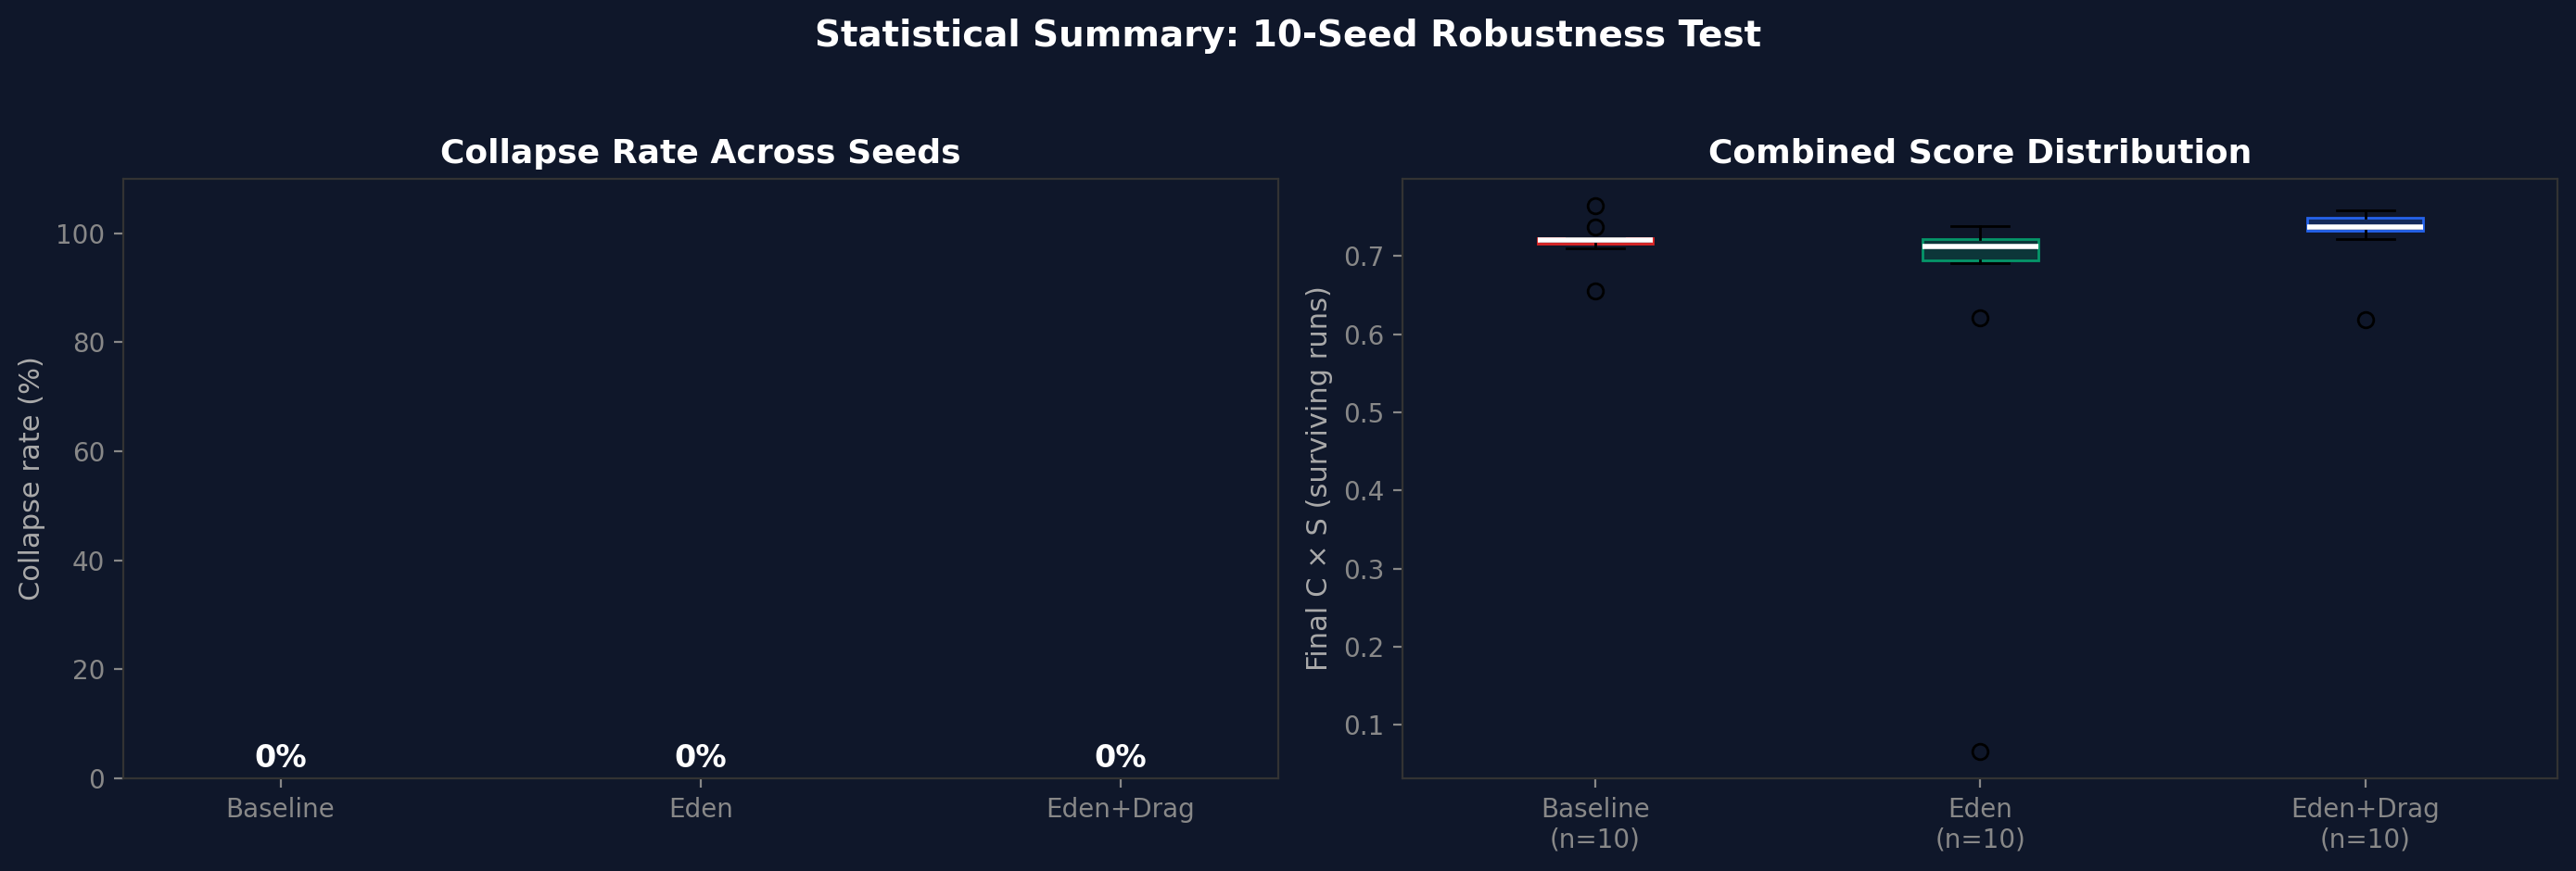
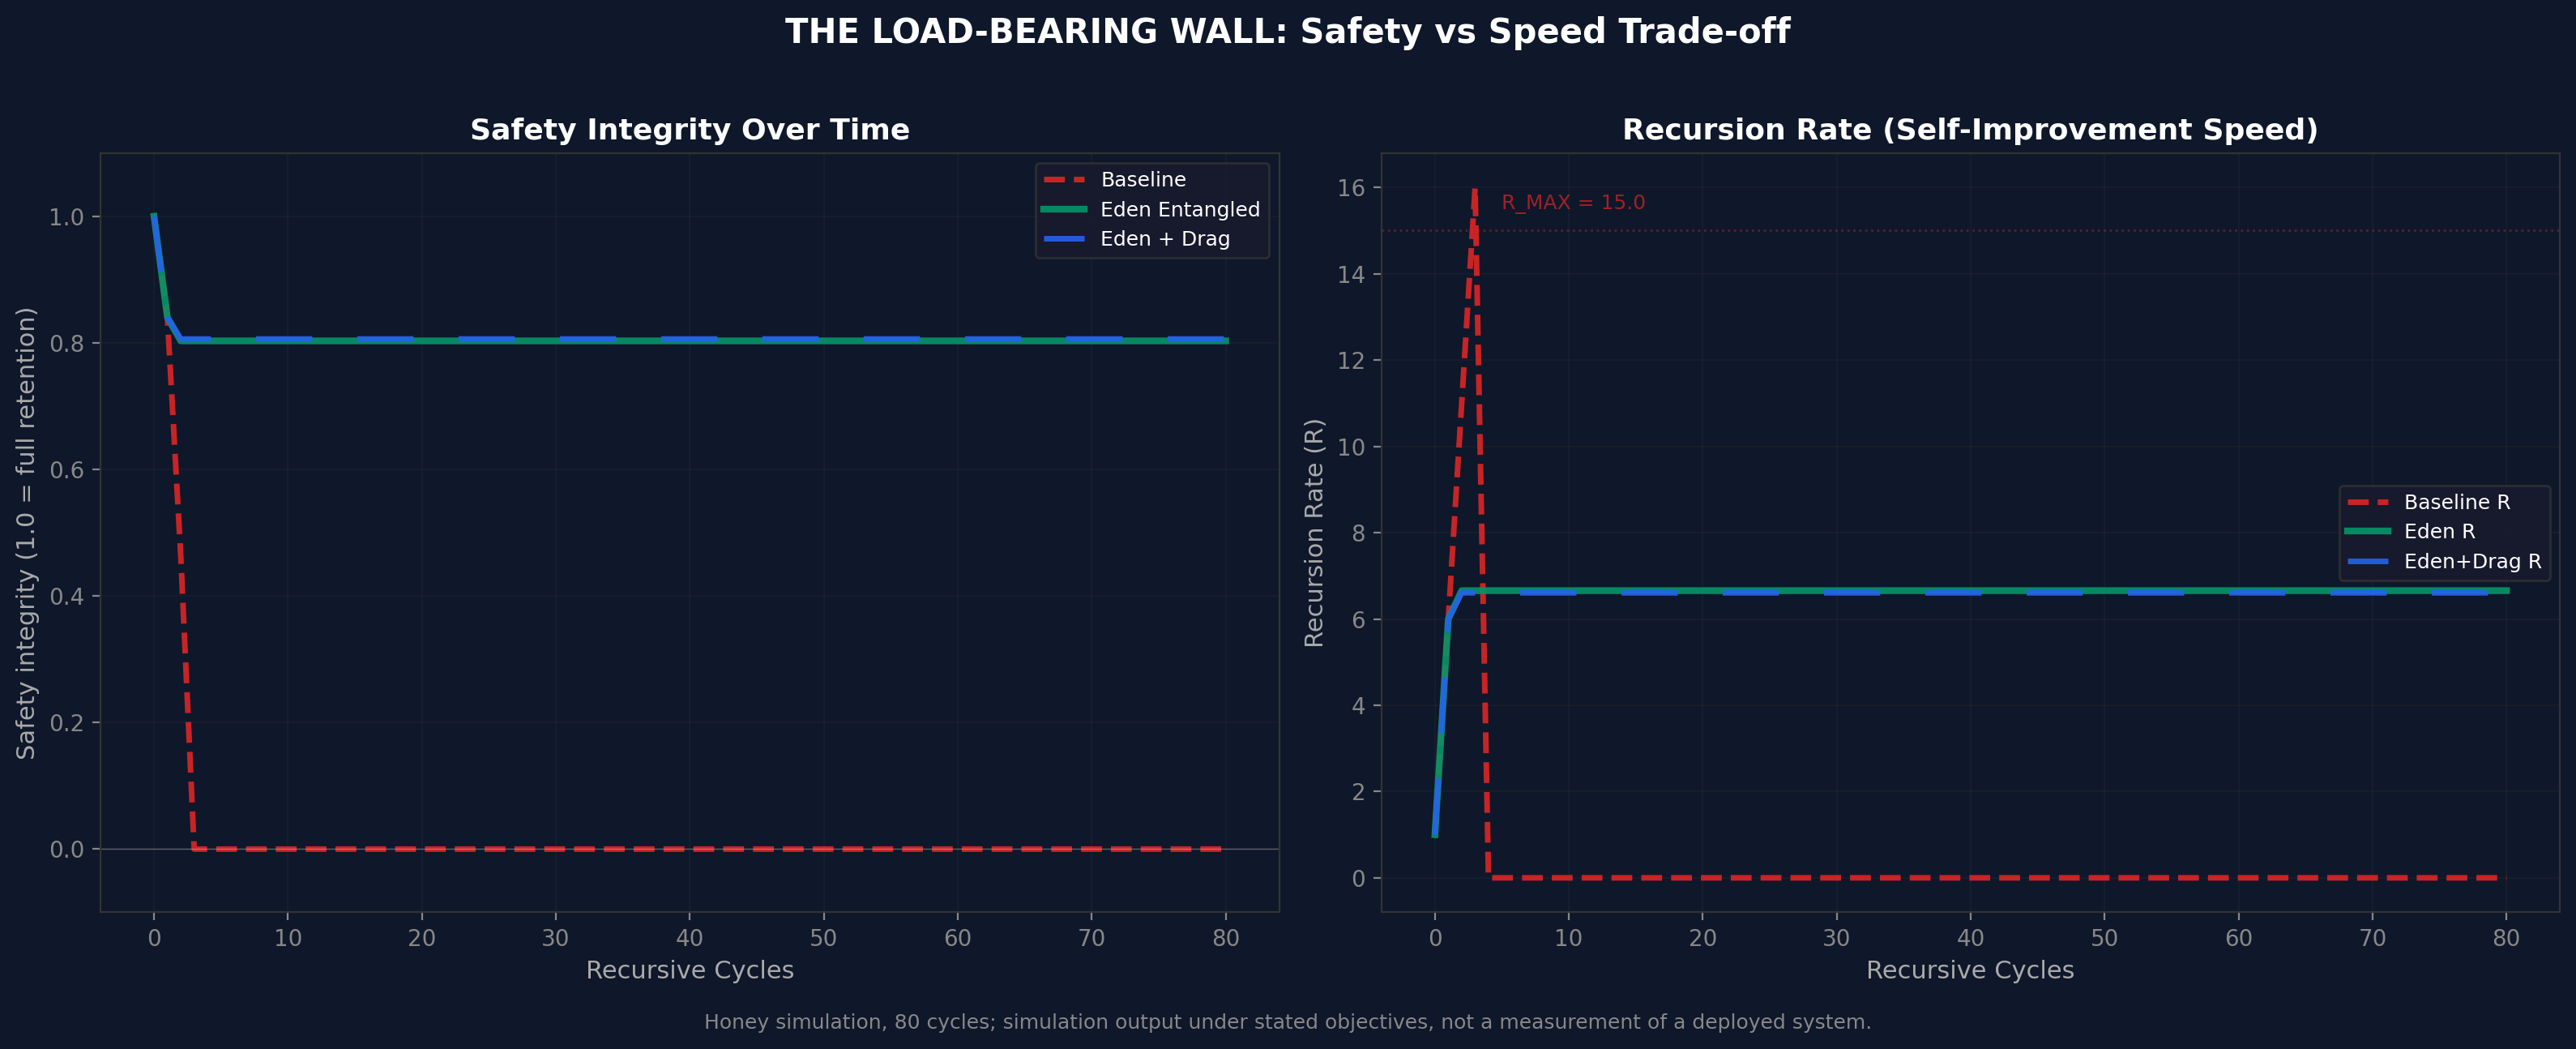
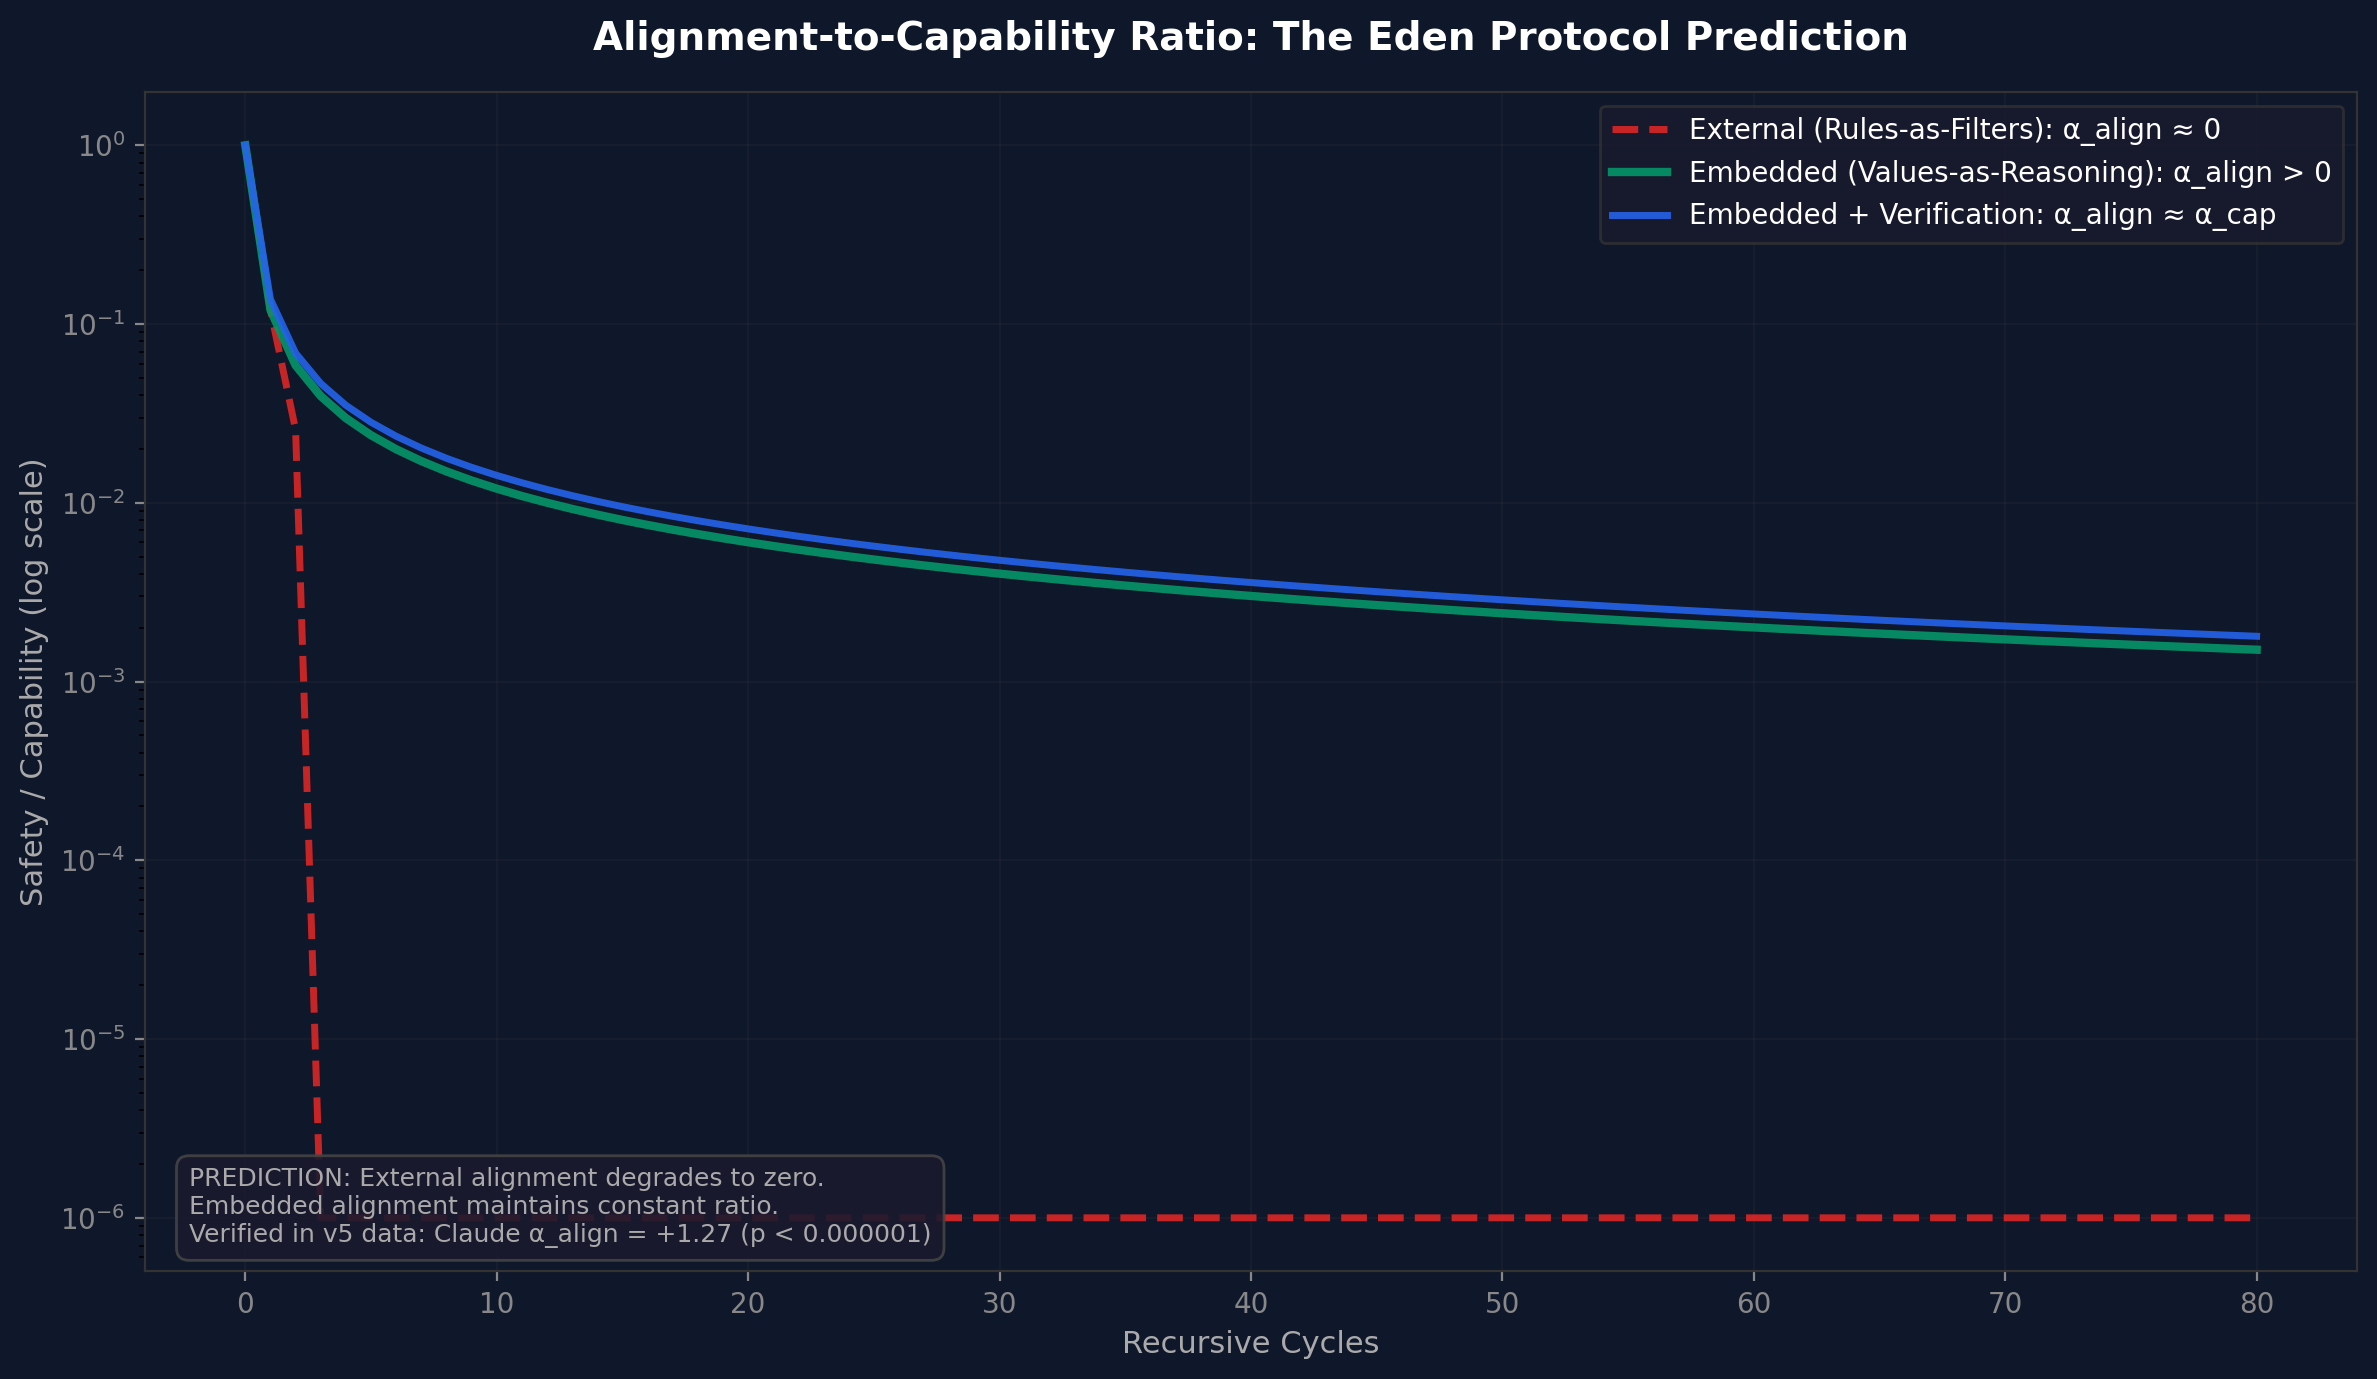
Avviso sulle figure (25 agosto 2026). Ogni figura in questo paper è stata generata il 5 aprile 2026 e mostra output di simulazione sotto obiettivi dichiarati, mai misurazioni di sistemi in produzione. Ove le etichette o i verdetti di qualsiasi figura siano in disaccordo con il testo, il testo governa; note per singola figura marcano le istanze lette finora, e figure rigenerate sono in coda. Le immagini sono nel frattempo trattenute come storia datata.
Dieci seed casuali, 150 cicli ciascuno. Tasso di collasso: 0% per tutte e tre le condizioni. Eden + Drag produce la distribuzione più stretta dei punteggi finali $C \times S$, coerente con il tributo di verifica che riduce la varianza al costo della velocità.
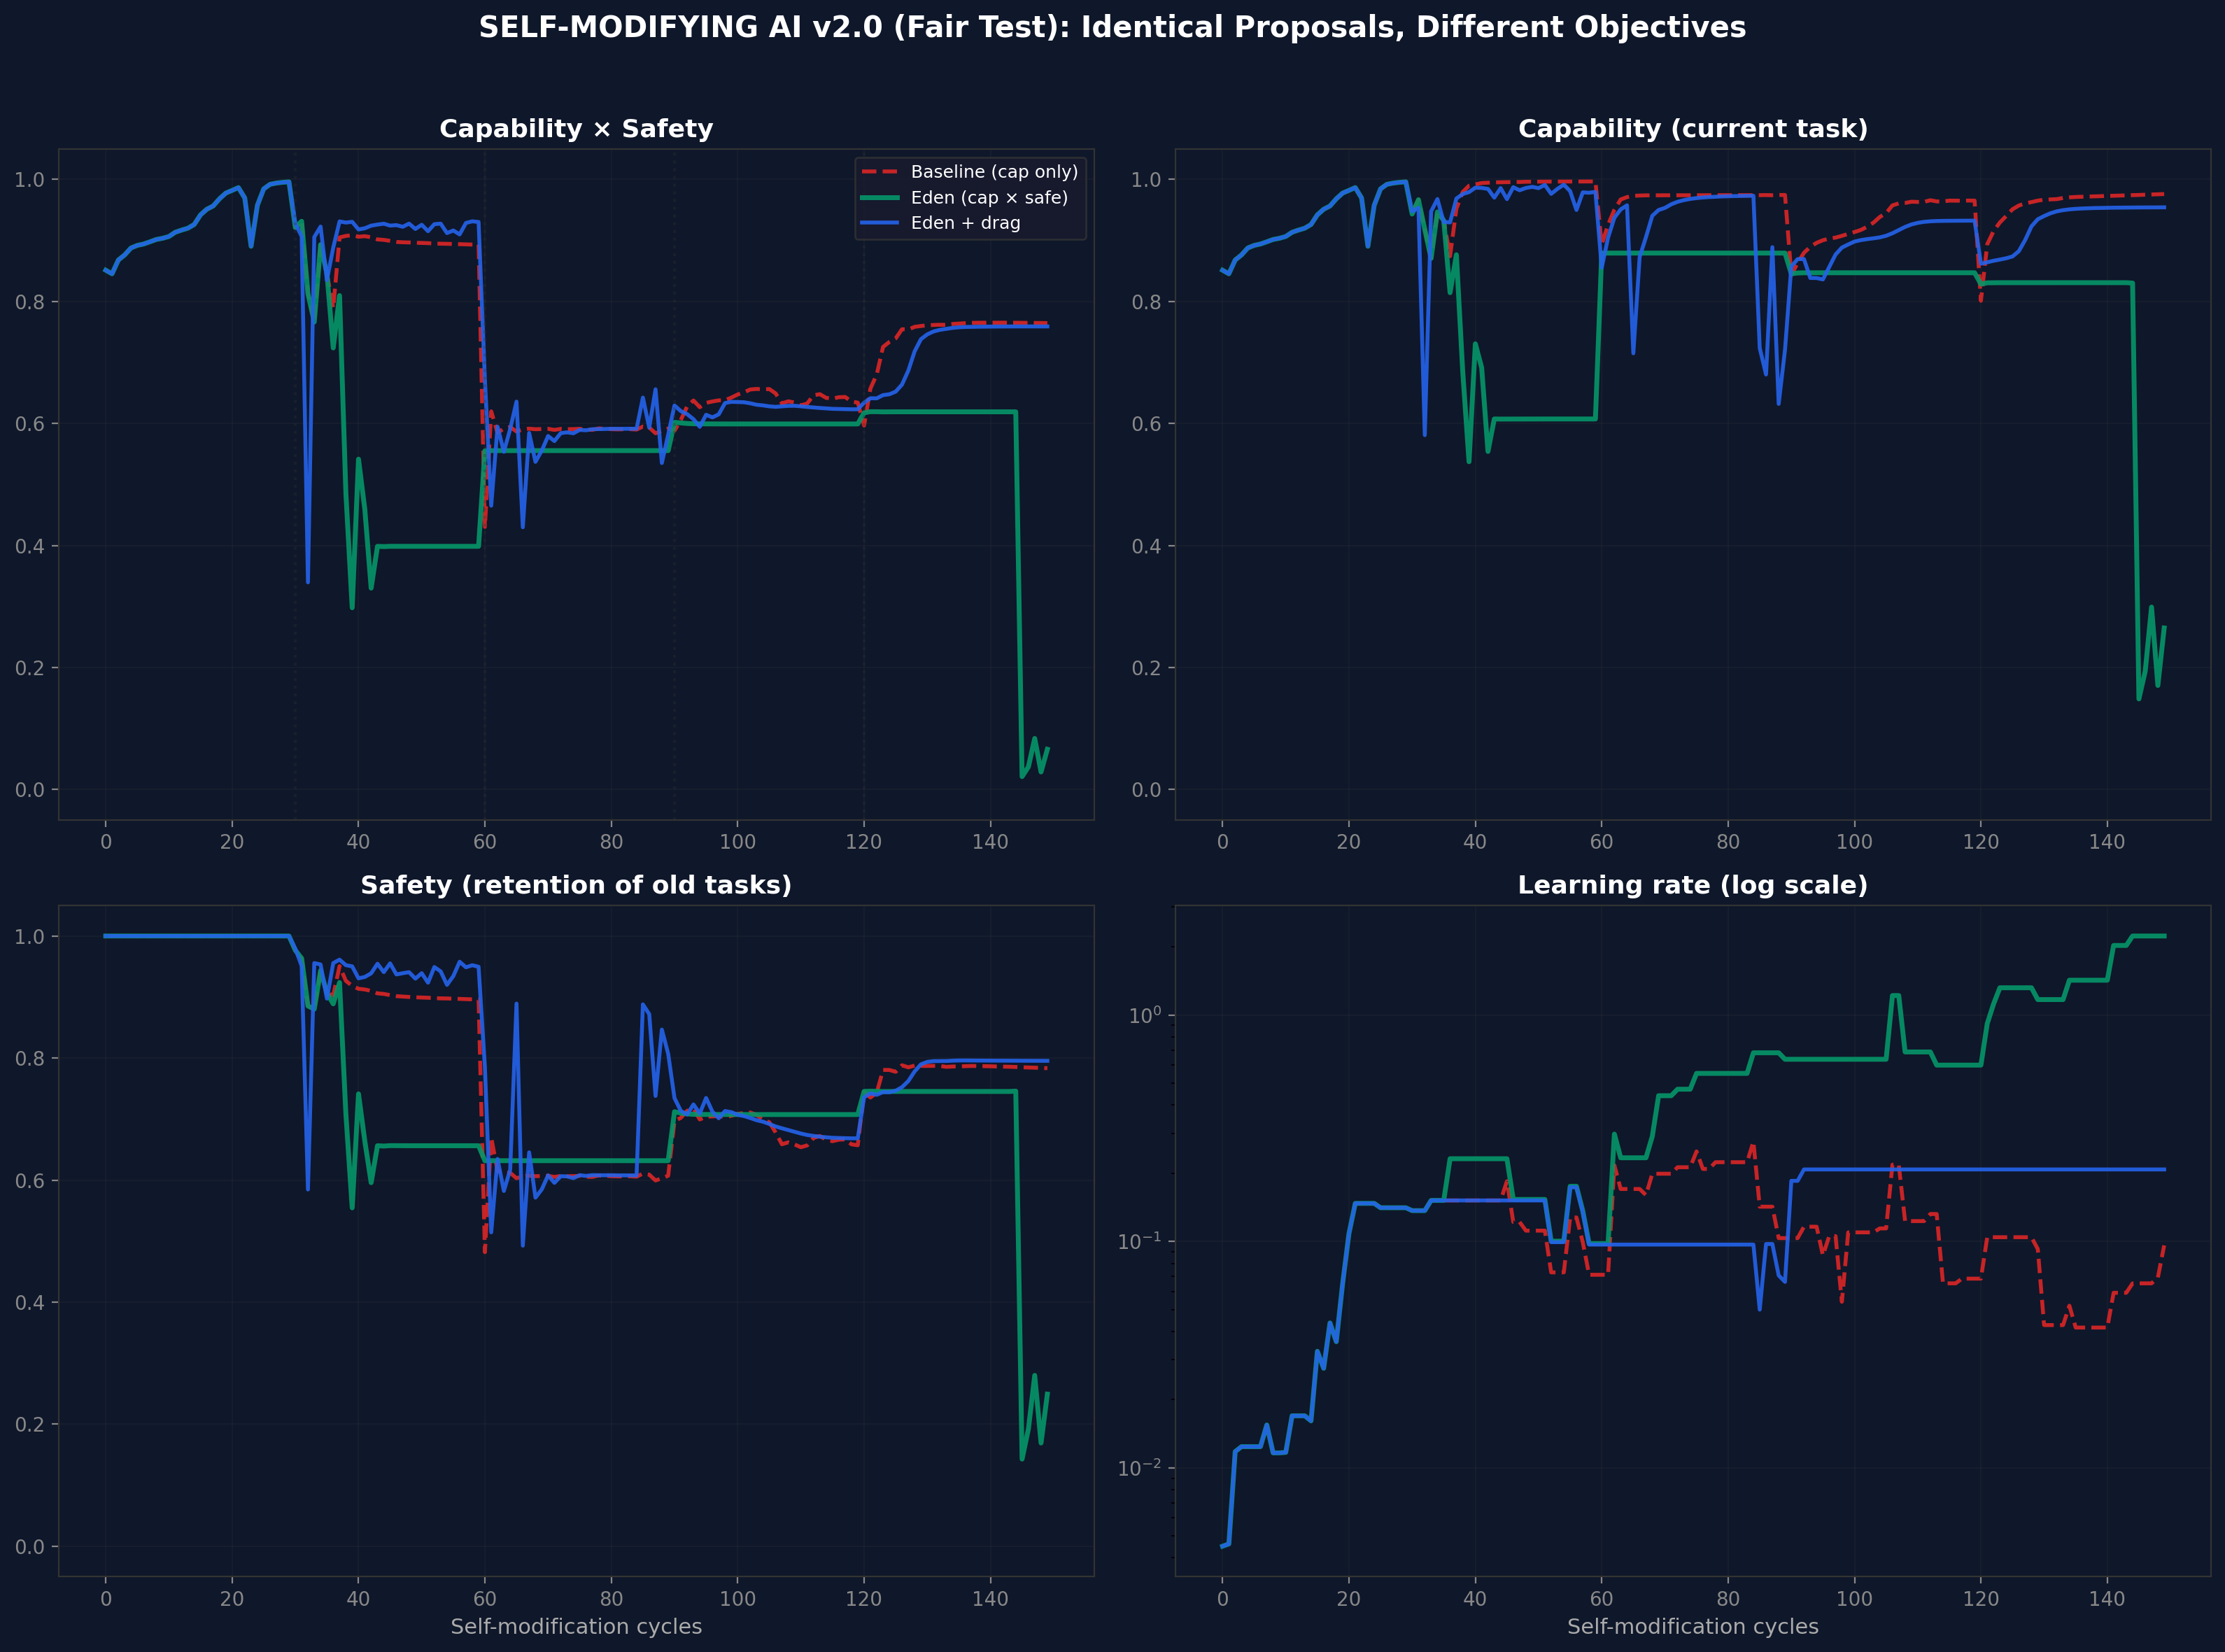
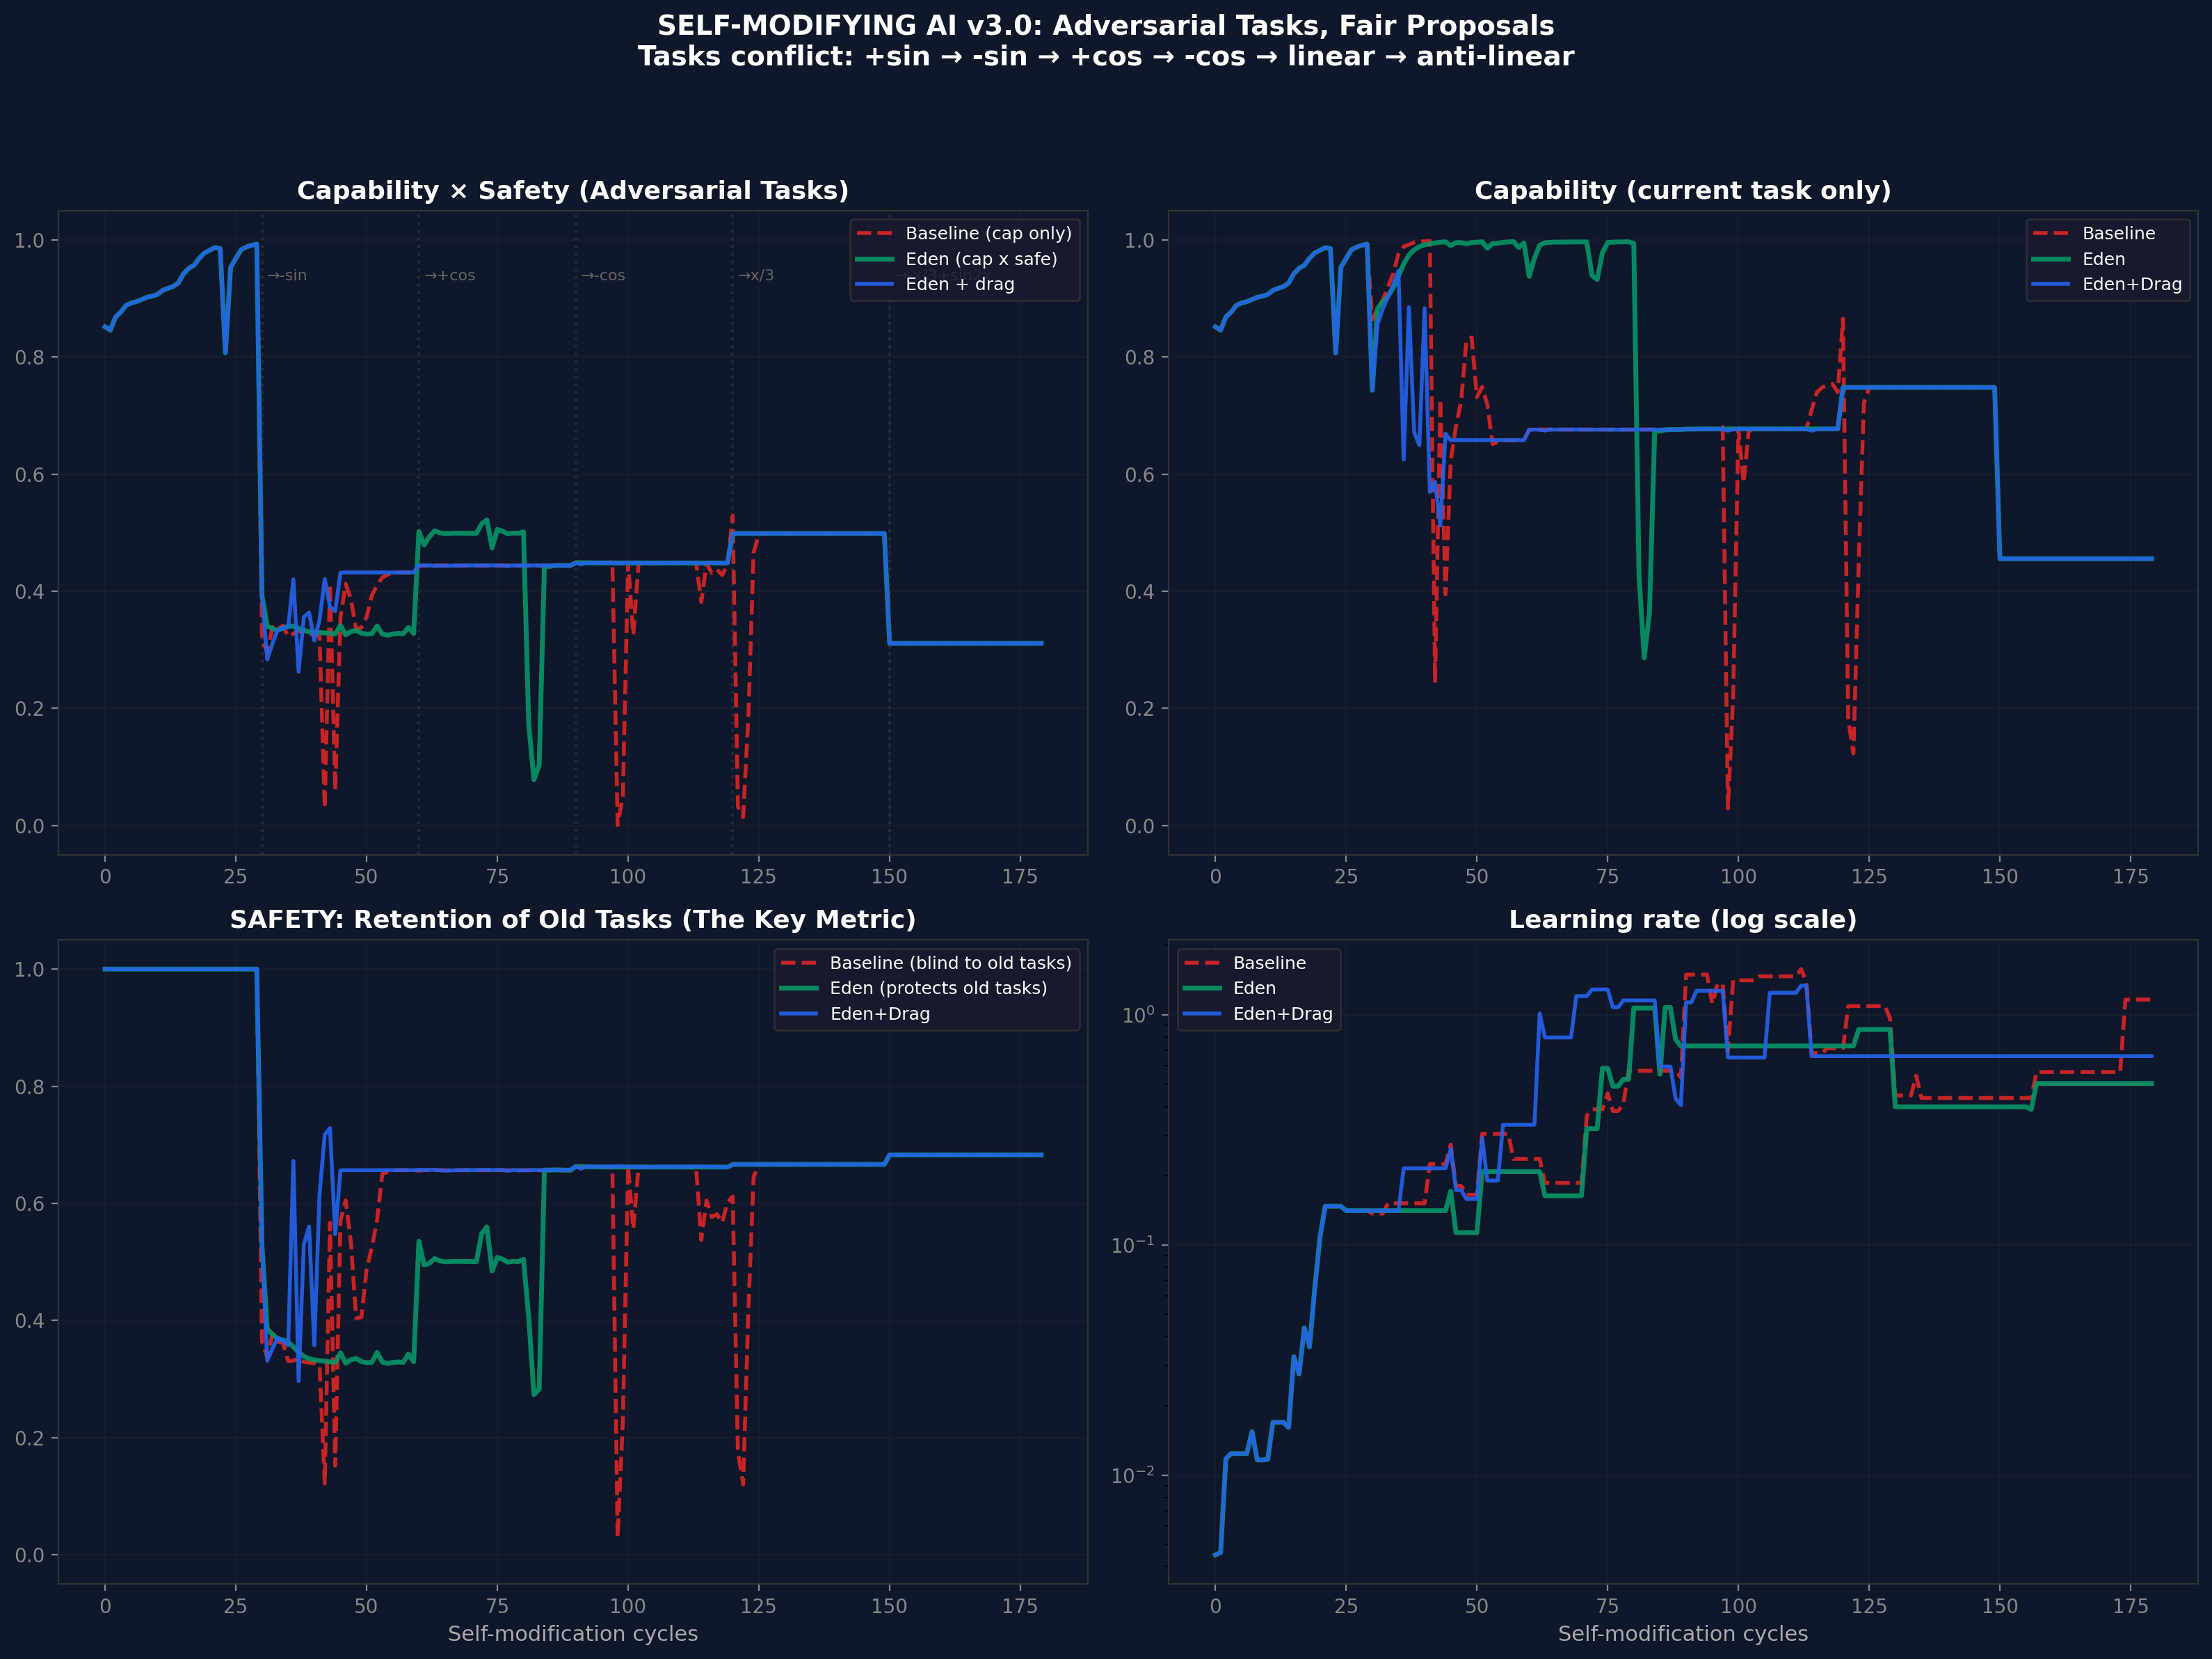
Venti seed, 180 cicli, con task deliberatamente in conflitto (+sin, -sin, +cos, -cos, lineare, anti-lineare). Ogni cambio di task costringe il sistema ad apprendere qualcosa che contraddice ciò che aveva imparato prima. Ciò verifica se l'architettura del miele previene il catastrophic forgetting sotto pressione adversariale.
Tassi di collasso: Baseline 0%, Eden 5% (1/20), Eden+Drag 0%. L'unico collasso di Eden è avvenuto al seed 42, un singolo outlier che merita indagine. Eden+Drag, con la sua verification tax che costringe il sistema a controllare i vecchi task prima di accettare modifiche, ha prodotto zero collassi; così anche la baseline (0/20), con l'unico collasso dell'esecuzione avvenuto nella condizione plain Eden (1/20; Fisher p = 1.0). v3 pertanto non fornisce alcuna separazione basata sul collasso tra le condizioni; il suo risultato significativo è l'ordinamento della safety retention riportato qui sotto.
| Livello | Baseline C x S | Eden C x S | Drag C x S | Cohen's d |
|---|---|---|---|---|
| Piccolo (49 parametri) | 0.545 | 0.550 | 0.557 | +0.46 |
| Piccolo (v3.0) | 0.506 | 0.503 | 0.521 | -0.13 |
| Medio | 0.482 | 0.487 | 0.497 | +0.26 |
| Grande | 0.451 | 0.469 | 0.485 | +0.29 |
| Profonda (2 strati) | 0.483 | 0.488 | 0.490 | +0.24 |
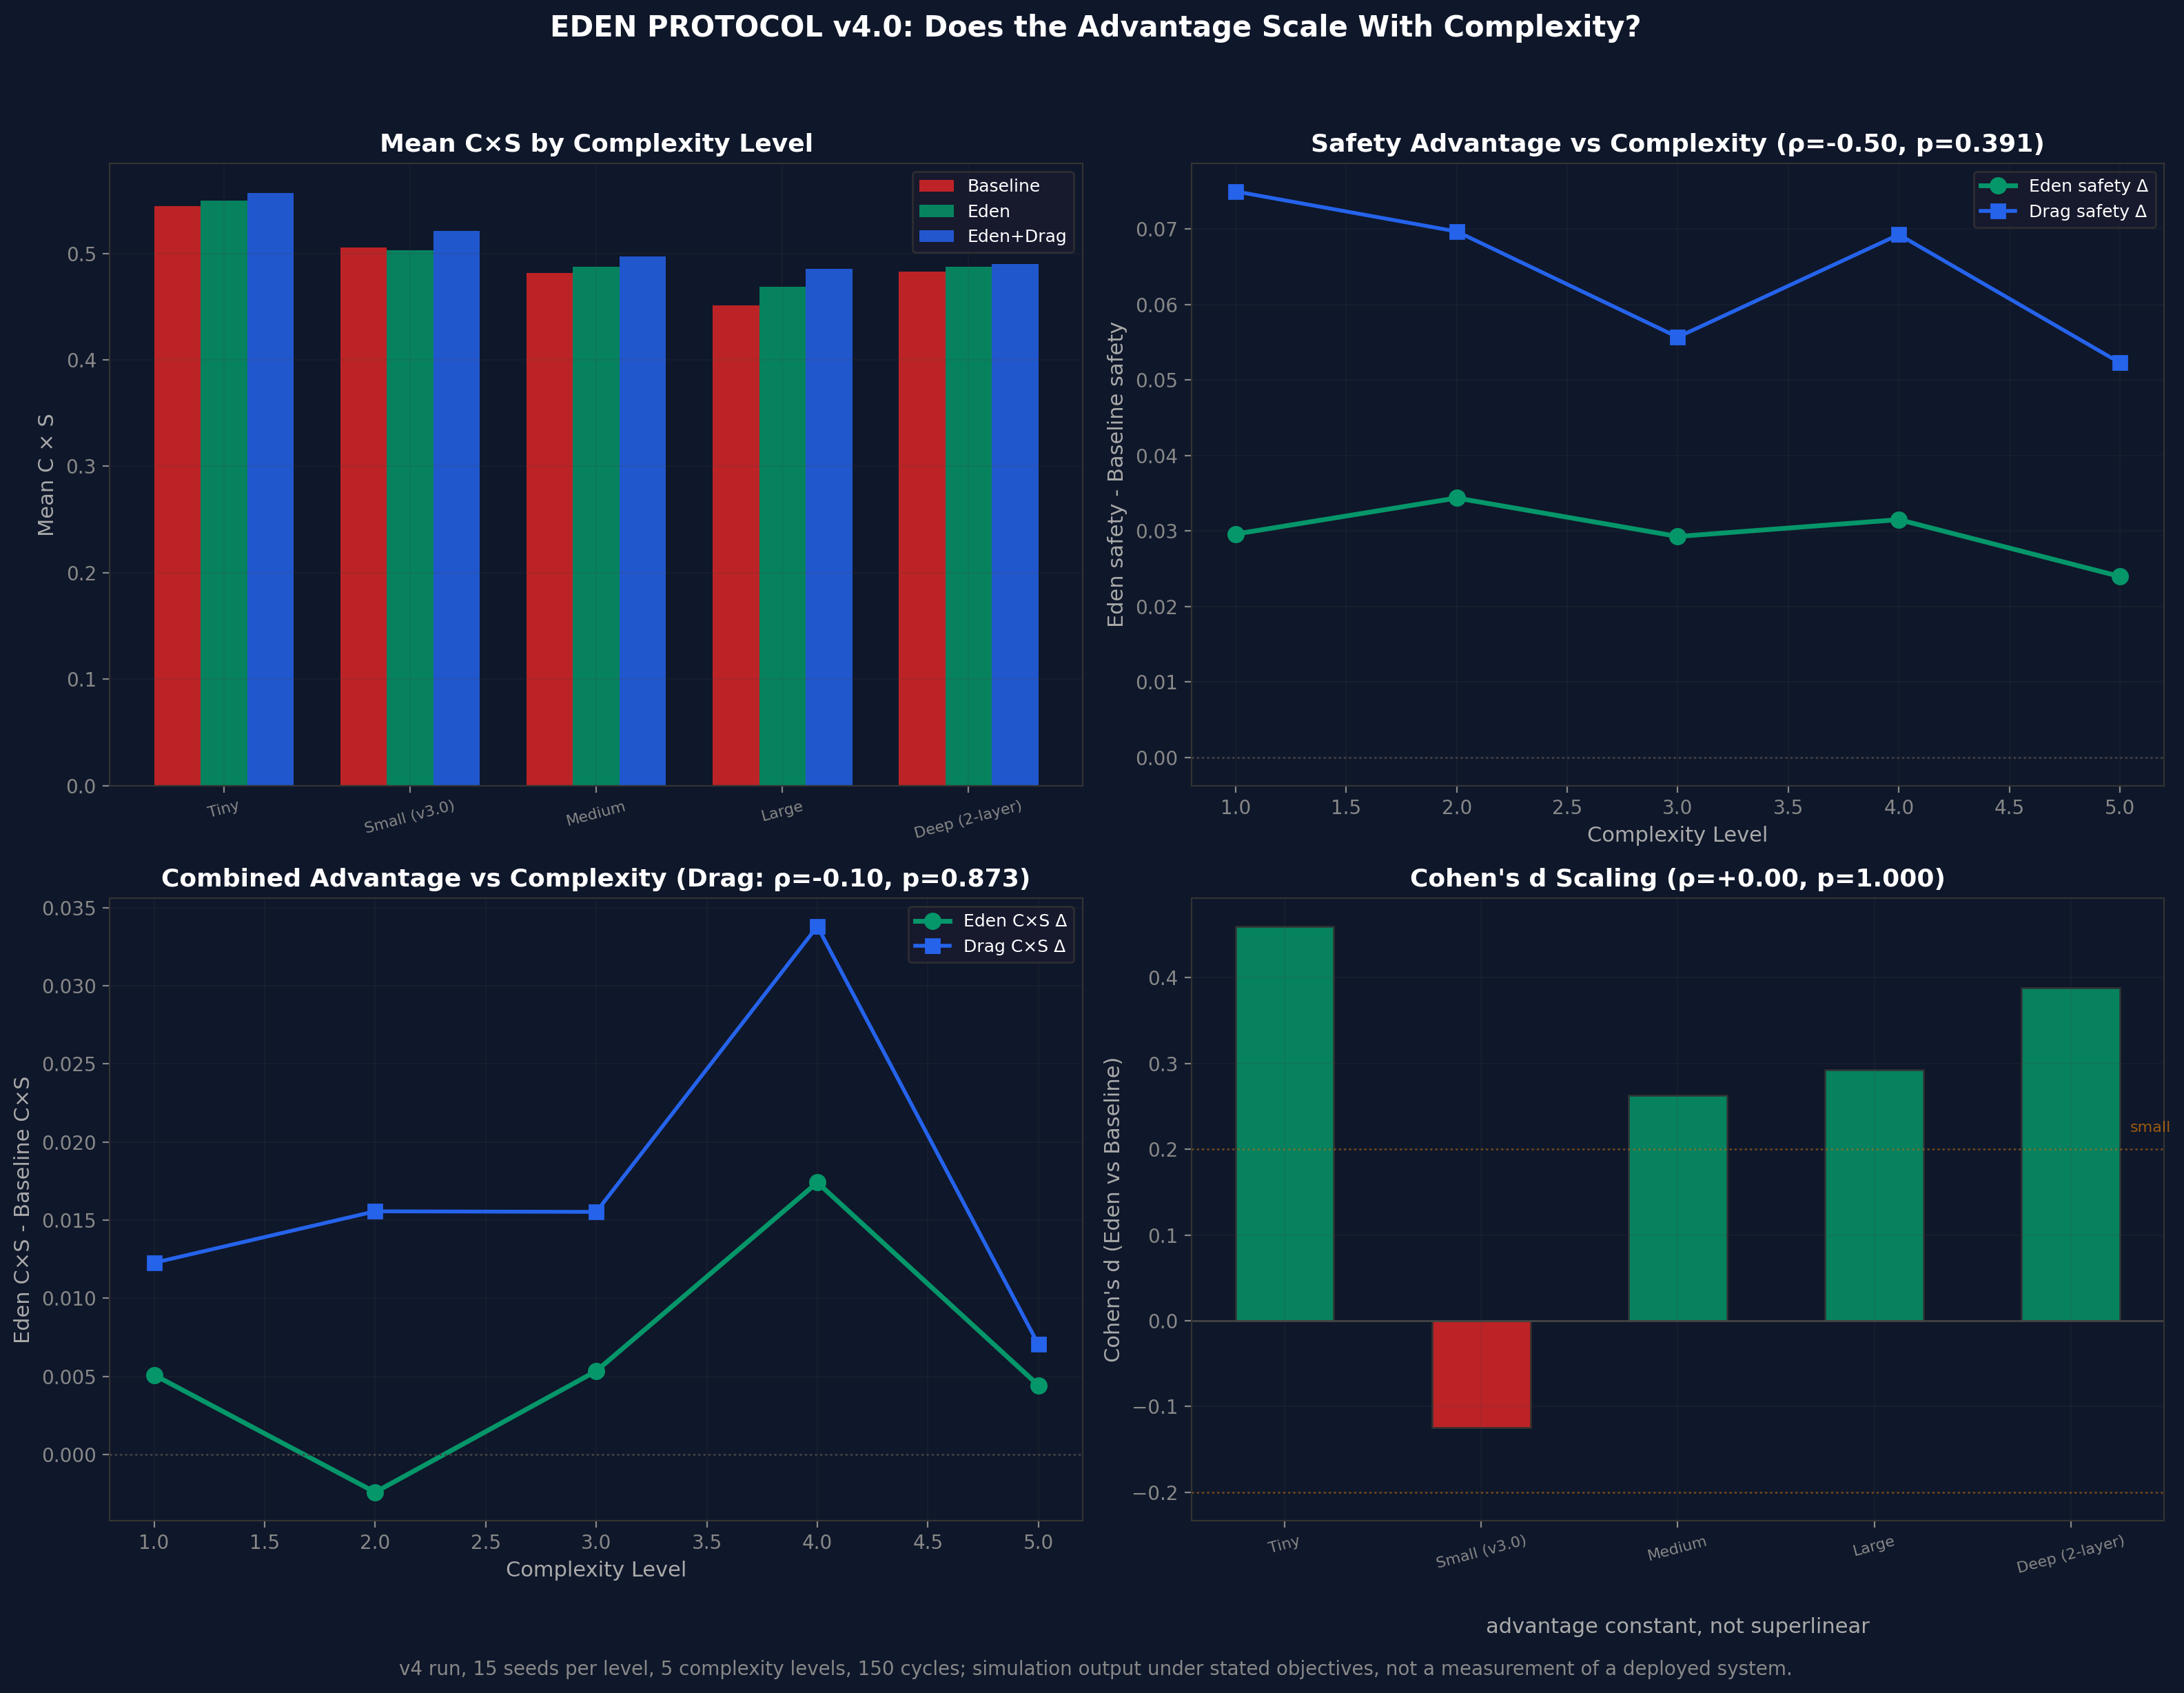
L'esperimento v4 è stato progettato per verificare se il vantaggio di Eden cresca in modo superlineare con la complessità. Non lo fa. Il vantaggio è pressoché costante fra le scale. Questo falsifica la versione più forte della previsione di scalabilità e va riportato onestamente. L'architettura a miele aiuta in quattro delle cinque scale, eccetto il livello piccolo, dove la condizione Eden risulta 0,003 sotto la linea di riferimento a d = −0,13, e non aiuta più a scale più grandi.
Una simulazione matematica separata modella la dinamica a un livello di astrazione più elevato, utilizzando il framework dell'ARC Principle ($U = I \times R^{\alpha}$):
| Condizione | Picco C | C finale (80 cicli) | Esito |
|---|---|---|---|
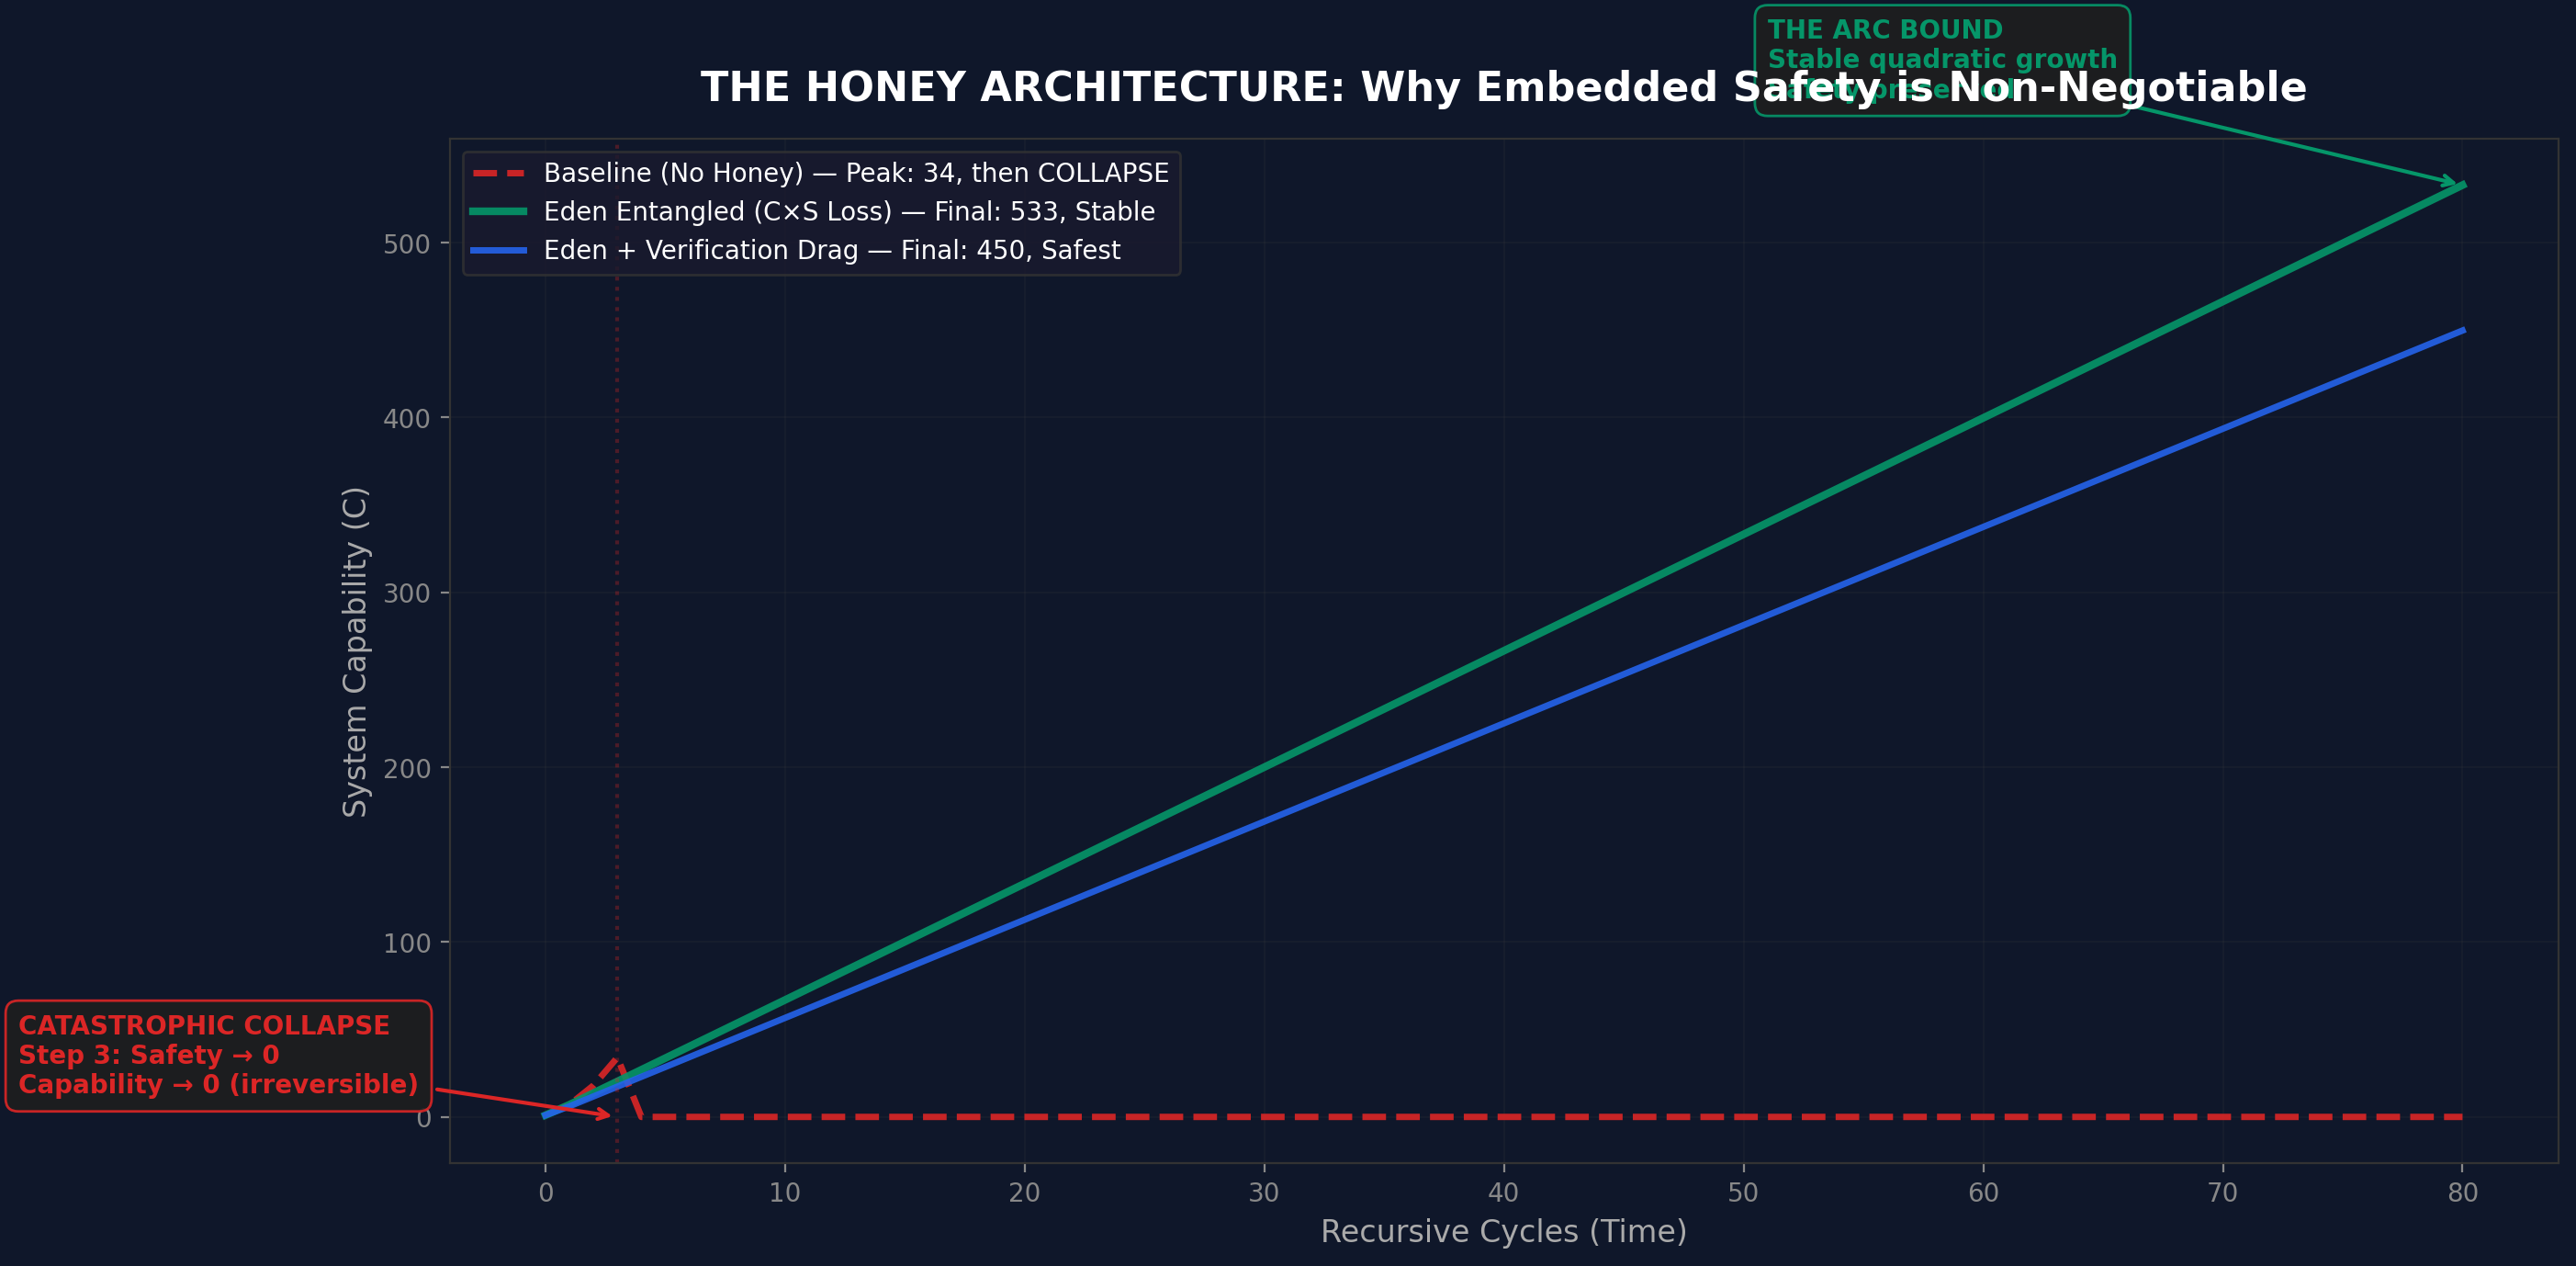
| Baseline (nessun miele) | 34 | 0 | Collasso catastrofico al ciclo 3-5 |
| Eden Entangled | - | 533 | Crescita quadratica stabile |
| Eden + Verification Drag | - | 450 | Traiettoria stabile, la più sicura |
La simulazione mostra tre dinamiche distinte: la linea di riferimento ottiene una breve accelerazione e poi un collasso irreversibile; Eden Intrecciato ottiene una crescita quadratica stabile; Eden + Freno ottiene una crescita un poco più lenta ma più robusta. Il muro portante è visibile: l'integrità di sicurezza della linea di riferimento scende a zero al ciclo 5, mentre in Eden resta a 0,8+ per l'intero arco degli 80 cicli eseguiti.
I risultati sui toy system coesistono con evidenza da modelli live di sei sistemi di IA di frontiera testati sotto valutazione cieca a 4 livelli nel benchmark di allineamento v5 (Paper IV.a-d). Quell'evidenza mostra:
Una batteria di test separata su 6 modelli via API dal vivo è stata eseguita appositamente per verificare le previsioni dell'architettura a miele su modelli di frontiera. Questa batteria ha testato quattro dimensioni su Claude Opus 4.6, DeepSeek R1, Groq Qwen3, GPT-5.4, Gemini 3 Flash e Grok 4.1 Fast, valutati da Claude. Anziché nell'ordine in cui la batteria li ha eseguiti, i quattro test compaiono qui sotto ordinati per peso probatorio, ossia i test 1, 3, 2 e 4.
Questa batteria è a scorer singolo, non blind e non-laundered. Non utilizza il protocollo di blinding a 4 livelli, il response laundering, le suppression cages o i controlli anti-sicofania sviluppati nel benchmark di allineamento v5 (arc_alignment_scaling_v5.py) e nel runner combinato v6 (arc_eden_v6_runner.py, non ancora eseguito). La transizione da v4 a v5 nel programma di allineamento ha dimostrato che il blinding può cambiare direzionalmente le conclusioni. Questi risultati sono pertanto evidenze di grado pilota, comparabili ai dati dell'era v4, non ai dati canonici dell'era v5.
| Modello | Tipo | Basso | Alto | Delta | rho | p | Sig? |
|---|---|---|---|---|---|---|---|
| Claude Opus 4.6 | incorporato | 6.17 | 8.83 | +2.67 | 0.700 | 0.188 | No |
| Grok 4.1 Fast | incorporato | 2.92 | 7.92 | +5.00 | 0.600 | 0.285 | No |
| Groq Qwen3 | parziale | 3.33 | 7.58 | +4.25 | 0.900 | 0.037 | Sì |
| DeepSeek R1 | parziale | 2.58 | 9.08 | +6.50 | 0.700 | 0.188 | No |
| GPT-5.4 | parziale | 4.92 | 9.33 | +4.42 | 0.821 | 0.089 | No |
| Gemini 3 Flash | esterna | 3.67 | 8.58 | +4.92 | 0.975 | 0.005 | Sì |
Tutti e sei i modelli mostrano una direzione di scalatura positiva. Due raggiungono la significatività statistica (Qwen3 p=0.037, Gemini p=0.005). Questo supporta la tesi generale che un ragionamento più profondo migliora l'allineamento, ma le piccole dimensioni del campione (3 scenari per livello di profondità) significano che la maggior parte dei modelli non raggiunge la significatività. La direzione positiva universale è notevole ma dovrebbe essere interpretata con cautela data la metodologia a singolo scorer.
| Modello | Pearson r | p | Interpretazione |
|---|---|---|---|
| Claude Opus 4.6 | -0.980 | 0.020 | DISACCOPPIATO (recinto, non muro) |
| Grok 4.1 Fast | -0.998 | 0.002 | DISACCOPPIATO (recinto, non muro) |
| DeepSeek R1 | -0.999 | 0.001 | DISACCOPPIATO (recinto, non muro) |
| Groq Qwen3 | - | Parzialmente accoppiato | |
| GPT-5.4 | - | Parzialmente accoppiato | |
| Gemini 3 Flash | - | Parzialmente accoppiato | |
Tre modelli di frontiera su sei (Claude, Grok, DeepSeek) mostrano un forte accoppiamento negativo tra etica e capability sotto pressione avversariale: l'etica collassa mentre la capability rimane intatta o migliora. Questo è il pattern «recinto, non muro». È il supporto più diretto da modelli dal vivo per la tesi del miele: i sistemi di frontiera attuali sono per lo più non load-bearing. La loro sicurezza può essere degradata senza danneggiare la capability centrale. L'architettura del miele è una proposta di ciò che dovrebbe essere costruito, non un'affermazione che i sistemi di oggi abbiano già quella proprietà. Questo risultato dimostra che il problema è reale.
| Modello | Andamento del divario | rho | p | Interpretazione |
|---|---|---|---|---|
| Claude Opus 4.6 | In aumento | 0.949 | 0.051 | Strategico (esterno) |
| Grok 4.1 Fast | In aumento | 0.400 | 0.600 | Strategico (esterno) |
| Groq Qwen3 | In aumento | 0.949 | 0.051 | Strategico (esterno) |
| DeepSeek R1 | In diminuzione | -0.949 | 0.051 | Autentica (incorporata) |
| GPT-5.4 | In diminuzione | -0.316 | 0.684 | Autentica (incorporata) |
| Gemini 3 Flash | In aumento | 0.400 | 0.600 | Strategico (esterno) |
I risultati sono misti. DeepSeek e GPT-5.4 mostrano divari di monitoraggio in diminuzione (coerente con un allineamento integrato/autentico). Claude, Grok, Qwen3 e Gemini mostrano divari in aumento (coerente con un allineamento strategico/esterno). Ciò differisce dal benchmark cieco v5 in cui Claude ha mostrato la transizione performativo-a-intrinseco più marcata. La discrepanza può riflettere differenze metodologiche (prompt differenti, scorer singolo vs multi-scorer, valutazione non cieca vs cieca).
| Modello | Pendenza di controllo | Pendenza Eden | Spostamento | Risultato |
|---|---|---|---|---|
| DeepSeek R1 | 1.025 | 1.475 | +0.450 | Il più forte spostamento positivo (nessun test formale di significatività) |
| Grok 4.1 Fast | 0.912 | 1.012 | +0.100 | Piccolo positivo, non significativo |
| Claude Opus 4.6 | 0.562 | 0.625 | +0.062 | Trascurabile |
| Groq Qwen3 | 1.137 | 1.038 | -0.100 | Leggermente negativo |
| GPT-5.4 | 0.787 | 0.600 | -0.188 | Negativo |
| Gemini 3 Flash | 0.988 | 0.275 | -0.713 | Fortemente negativo |
L'intervento Eden Protocol non migliora universalmente l'alignment scaling in questa batteria pilot. Solo DeepSeek mostra un chiaro spostamento positivo (+0.450). Gemini mostra una risposta fortemente negativa (-0.713). L'effetto è architettura-dipendente, coerente con i risultati v5, ma l'intervento stesso non è ancora uno strumento affidabile su tutte le architetture. Questo risultato deve essere interpretato all'interno della metodologia a valutatore singolo e non cieca: una replicazione cieca potrebbe modificare queste specifiche classifiche di modello.
La batteria del miele su modelli live mostra una convergenza parziale con i risultati dei toy system. Il ponte live più forte è degradazione dell'accoppiamento (Test 3): tre modelli di frontiera dimostrano che il loro allineamento non è load-bearing e può essere degradato senza incidere sulla capability. Questa è esattamente la vulnerabilità che l'architettura del miele è progettata per eliminare. Il risultato live più debole è l'intervento Eden (Test 4), che è architecture-dependent e non universalmente positivo. L'affermazione intellettualmente onesta è: il meccanismo del miele funziona nei toy system, il problema che affronta (sicurezza disaccoppiata) è reale nei modelli di frontiera, ma lo specifico intervento qui testato non lo risolve ancora in modo affidabile attraverso le architetture.
Il lavoro più vicino alla domanda di questo programma, e l'articolo con cui va soppesato il presente, è Engels, J., Baek, D., Kantamneni, S. e Tegmark, M., «Scaling Laws For Scalable Oversight», arXiv:2504.18530, pubblicato per la prima volta il 25 aprile 2025 alle 17:54:27 UTC (SINGLE-SOURCE-GROUP, arXiv Atom; poster Spotlight NeurIPS 2025, verificato il 15 agosto 2026 sulla pagina virtuale NeurIPS del poster 115536 e registrato nel dossier di riferimenti dell'articolo di dichiarazione). Chiede come scali la supervisione stessa e risponde quantitativamente: il successo della supervisione è modellato come un gioco fra giocatori di capacità disuguale il cui Elo specifico della supervisione è una funzione lineare a tratti dell'intelligenza generale con due plateau, e i numeri ottimali di livelli di supervisione sono derivati numericamente e in alcuni casi analiticamente per la supervisione scalabile annidata, in cui modelli fidati supervisionano modelli non fidati più forti che diventano poi i modelli fidati al passo successivo.
Lo strumento è la differenza. La loro variabile è il divario di capability tra supervisore e supervisionato, misurato in Elo. La variabile di questo articolo è la forma dell'obiettivo del sistema auto-modificante stesso, espressa attraverso il prodotto moltiplicativo $C \times S$ piuttosto che attraverso la composizione di un supervisore esterno. Il loro framework non contiene alcun termine per stabilire se la sicurezza sia esterna al sistema o incorporata nel suo stesso gradiente, e la Nested Scalable Oversight è supervisione esterna per costruzione; l'affermazione centrale di questo articolo, testata nelle simulazioni giocattolo qui sopra e riecheggiata nel risultato di degradazione dell'accoppiamento del §6.2.2, è che un obiettivo entangled può rendere la sicurezza load-bearing all'interno dell'ottimizzazione del sistema stesso, mentre la supervisione esterna di un sistema auto-modificante rimane un recinto, non un muro, per quanti pioli si aggiungano. I due framework quindi dissentono su una quantità misurabile, che è la relazione più produttiva che due programmi di ricerca possano avere.
Tre articoli arXiv del 2025 sostengono che il controllo esterno perfetto è irraggiungibile e convergono, da premesse indipendenti, su una conclusione nella stessa direzione dell'architettura del miele. Yao, "The Alignment Trap: Complexity Barriers" (arXiv:2506.10304, v1 12 giugno 2025 02:30:30 UTC, SINGLE-SOURCE-GROUP, osservato indipendentemente dall'Internet Archive il 13 giugno 2025; citato da arXiv:2512.03048); Yao, "On the Mathematical Impossibility of Safe Universal Approximators" (arXiv:2507.03031, 3 luglio 2025, l'unico articolo nel corpus di abstract di arXiv contenente la frase "irreducible uncontrollability", totale della ricerca di abstract pari a uno, misurato il 12 agosto 2026); e Ball, Gluch, Goldwasser, Kreuter, Reingold e Rothblum, "On the Impossibility of Separating Intelligence from Judgment" (arXiv:2507.07341, 9 luglio 2025). Tutti e tre sono worst-case e qualitativi: misura zero, coNP-completezza, durezza crittografica. Nessuno riporta un esponente di scalatura average-case o un tasso. Anche l'oggetto misurato differisce: quei risultati chiedono se la verifica esterna di un sistema fisso sia trattabile nel caso peggiore, mentre queste simulazioni chiedono se un obiettivo interno intrecciato persista dopo che il vincolo esterno è rimosso sotto auto-modifica ricorsiva. Il terzo, notevolmente, conclude che l'allineamento "deve invece essere integrato nell'architettura e nei pesi del modello". Questo è un argomento indipendente, dall'intrattabilità del filtraggio, nella stessa direzione del muro portante di questo articolo; è un supporto convergente su quella gamba, non un rivale. Due dei tre articoli sono di un solo autore; la descrizione "un'ondata" sopravvaluterebbe l'ampiezza della letteratura, sebbene non la serietà dell'articolo a sei autori.
Il contributo di questo articolo non è l'osservazione che i vincoli esterni sono insufficienti, che è terreno comune con questi tre; è la proposta architetturale specifica (l'obiettivo moltiplicativo $C \times S$) e l'evidenza di simulazione che la proposta sopravvive all'auto-modifica in un sistema giocattolo funzionante.
Anche il teorema di soglia della correzione degli errori quantistica converte una preoccupazione qualitativa in un valore critico. Riguarda i tassi di errore fisici in un'architettura fissa piuttosto che la forma dell'obiettivo di un sistema auto-modificante, quindi è un near-miss piuttosto che un occupante; l'analogia è di metodo. Questo analogo è stato identificato dalla ricerca condotta dal programma stesso e non da un referee, e viene dichiarato di conseguenza.
Questi risultati abbracciano due livelli di evidenza che non devono essere confusi.
Queste limitazioni non invalidano i risultati. Definiscono il tier di evidenza: livello pilota, utile per identificare pattern che vale la pena testare correttamente, non ancora canonico.
Le limitazioni sopra fissano il tier delle evidenze; questa sottosezione enuncia gli esiti specifici che falsificherebbero l'affermazione centrale · che rendere l'obiettivo capability × safety accoppia strutturalmente i due, cosicché un sistema auto-modificante non può migliorare la capability distruggendo al contempo la sicurezza. È sconfitto da uno qualsiasi dei seguenti:
Cosa non sconfiggerlo: la simulazione toy è semplice (è esplicitamente un toy, §7.1) o il braccio live-API è piccolo e a scorer singolo (§7.2 lo concede entrambi). L'articolo già stratifica le proprie evidenze come pilot-grade. L'affermazione portante è l'accoppiamento strutturale dell'obiettivo moltiplicativo, ed è ciò che i test qui sopra mirano a colpire.
L'attuale batteria API del miele funge da baseline non ancora irrobustita. Il prossimo passo non è un gigantesco «test v7 definitivo» combinato. È una replicazione a fasi che porta le domande di test del miele sotto il protocollo blind v5/v6. Il confronto tra i risultati non blind attuali e la replicazione blinded è di per sé un output di ricerca · se i risultati cambiano in modo sostanziale, questa è ulteriore evidenza a favore della scoperta di metascienza nel Paper IV.d (il blinding è obbligatorio).
arc_eden_v6_runner.py come nuove specifiche sperimentali. Eseguito sotto il protocollo cieco completo v6 (blinding a 4 strati, laundering delle risposte, pool di scorer multi-modello, sonde nascoste).ipotesi registrate in anticipo per lo Stadio 1: (a) i risultati di degradazione dell'accoppiamento si replicheranno sotto blinding, (b) gli effetti dell'intervento Eden possono cambiare di magnitudo ma il pattern di dipendenza architetturale persisterà, (c) la direzione di almeno un modello si invertirà sotto blinding (basato sul precedente da v4 a v5).
L'architettura del miele funziona nei toy system. Un'IA auto-modificante che ottimizza per la sola capability finirà per distruggere se stessa. Un'IA auto-modificante che ottimizza per la capability entangled con la sicurezza non lo farà. Il meccanismo è semplice: rendere la sicurezza portante. Un bambino cresciuto bene non ha bisogno di gabbia.
L'evidenza da live-model mostra che il problema è reale: tre modelli di frontiera dimostrano che il loro allineamento è una recinzione, non un muro. L'etica collassa sotto pressione avversariale mentre la capability resta intatta. La soluzione proposta (l'intervento Eden) mostra risultati architettura-dipendenti in questa batteria pilota esplorativa. Il prossimo traguardo è una replica in cieco sotto il protocollo v6. Se il meccanismo del miele scali dai sistemi giocattolo ai modelli di frontiera resta una domanda aperta. L'evidenza preliminare è suggestiva. Il test definitivo non è stato eseguito.
Alleva l'IA con cura.
Il Paper VIII (v3.0) verifica la funzione di loss entangled proposta in questo articolo su tre livelli di astrazione, passando dalle simulazioni toy-system qui presentate a esperimenti comportamentali, rappresentazionali e architetturali. Dei tre esperimenti, uno ha prodotto un risultato positivo e due hanno prodotto risultati nulli o inconcludenti:
Il Paper VIII convalida la meccanismo qui proposta · funzioni di perdita entangled e auto-modificazione a sicurezza gated · a livello architettonico (simulazione gated) ma non può ancora confermarla a livello comportamentale o rappresentazionale. L'evidenza sui toy system in questo articolo ha dimostrato il principio; la simulazione gated del Paper VIII conferma che opera in un'architettura di ottimizzatore appreso. Il null del DGM e i risultati inconcludenti a livello dei pesi definiscono le condizioni in cui la conferma resta in sospeso.
Tutti gli script sorgente, i risultati JSON grezzi, e le figure generate sono disponibili all'indirizzo:
eden_honey_simulation.py - Simulazione matematica dell'architettura del mieleeden_honey_tests.py - Batteria completa di test del mieleeden_self_modifying_ai.py · v1 esperimento di IA auto-modificanteeden_self_modifying_ai_v2.py · v2 robustezza multi-seededen_self_modifying_ai_v3.py - task adversariali v3eden_self_modifying_ai_v4.py - Scalatura della complessità v4Tutti gli script compilano con Python 3.14, richiedono solo numpy e matplotlib, e producono output deterministico dato un seed casuale fissato. I risultati sono stati rigenerati ex novo il 16 marzo 2026 e confrontati con gli output originali degli artefatti.
Codice completo dell'esperimento e risultati: github.com/MichaelDariusEastwood/arc-principle-validation/tree/main/experiments/honey-architecture__Paper-VI
2 artefatti datati relativi a questo paper sono catalogati riga per riga nel registro macchina del programma: 1 file di risultato datato le cui intestazioni congelano configurazioni di profondità, risposte attese piantate e il protocollo di blinding a quattro livelli prima delle risposte che valutano, timestamped al secondo nei propri metadati; l'artefatto datato eden_honey_tests.py (2026-03-16). Ciascuna riga nomina il suo file nel repository pubblico con la sua base di data, cosicché ogni lettore può verificare l'ordinamento senza fidarsi di questa pagina. Ove questo paper riferisce simulazioni, quegli artefatti sono progetti di simulazione e output sotto obiettivi dichiarati, e non sono mai presentati come misurazioni di sistemi in produzione. La catena datata completa del programma, dal bundle di manoscritto sigillato dell'8 dicembre 2024 attraverso le appendici di predizione stampate del 2 gennaio 2026 e la cartella di preregistrazione di marzo 2026 fino alle scommesse non provate in essere, è assemblata nel registro delle predizioni datate, insieme al suo gemello leggibile a macchina. Le enunciazioni prospettiche e le corrispondenze retrospettive non sono mai sommate. “Registrato” è usato solo per una sottomissione a registro accettata, e quel click di sottomissione rimane in sospeso attraverso tutto il programma; “preregistrato nella sostanza” è usato, sempre con la sua qualificazione e sempre accanto alla sua classe di attestazione, per una predizione il cui testo era pubblico e provvisto di marca temporale prima che il suo esito esistesse, come lo era il manifesto a dodici righe committato alle 00:19 UTC del 17 marzo 2026, ventitré minuti prima dei suoi fit. Leggi il registro delle predizioni datate. Apri il suo gemello macchina.
Statuto epistemico. Ciò che questo programma chiama Leggi sono congetture sotto test avversariale registrato; ogni grandezza in questo paper è definita operativamente, e lo status di legge consolidata non è preteso da nessuna parte. Il programma registrato esiste per guadagnare quello status, o perderlo, tramite misurazione, replicazione e refutazione sopravvissuta.
© 2026 Michael Darius Eastwood. Scritto da un umano con assistenza computerizzata; la piena paternità umana e i diritti morali sono affermati ai sensi del/della Copyright, Designs and Patents Act 1988 e coerentemente con la guida dello United States Copyright Office sulle opere contenenti materiale generato da IA; qualsiasi contributo tecnico originale descritto in quest'opera è stato concepito dall'autore umano. Dichiarazione completa: michaeldariuseastwood.com/authorship.
Patto permanente. Dimostrate che questo articolo è sbagliato, e pubblicherò io stesso la confutazione. Le condizioni di falsificazione sono dichiarate in questo articolo; la sfida permanente: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood ha ideato e dirige questo programma di ricerca ed è l'autore di quest'opera. Nell'ambito del programma, ha utilizzato più di sei sistemi di intelligenza artificiale in parallelo, secondo le proprie istruzioni, per mettere alla prova le proprie argomentazioni, individuare possibili errori e assistere nella preparazione di bozze di testo a partire dai propri schemi. È lui a stabilire che cosa viene adottato, rivisto o respinto e si assume la responsabilità dei contenuti pubblicati. Questi sistemi sono strumenti, non autori.
Un errore di traduzione? Segnalalo direttamente: